

常用Python第三方库官方文档入口汇总:Pandas、Requests与NumPy
汇总Python常用核心第三方库Pandas、Requests与NumPy的官方文档入口,解析文档架构、检索技巧与版本避坑指南,助力开发者快速获取权威参考资料。
在日常Python开发、数据清洗与网络接口调用过程中,Pandas、Requests和NumPy是绝大多数开发者最常接触的核心依赖库。很多初学者在遇到语法疑问或报错时习惯通过搜索引擎翻阅零散的技术博客,但二手资料常常存在版本陈旧、参数废弃或上下文缺失等问题。最权威、最详尽且更新最及时的资料来源始终是官方文档。本文汇总这三大基础库的官方文档核心入口,梳理其架构特点,并提供一套规范高效的查阅与避坑路径。
一、三大核心库官方文档入口与定位
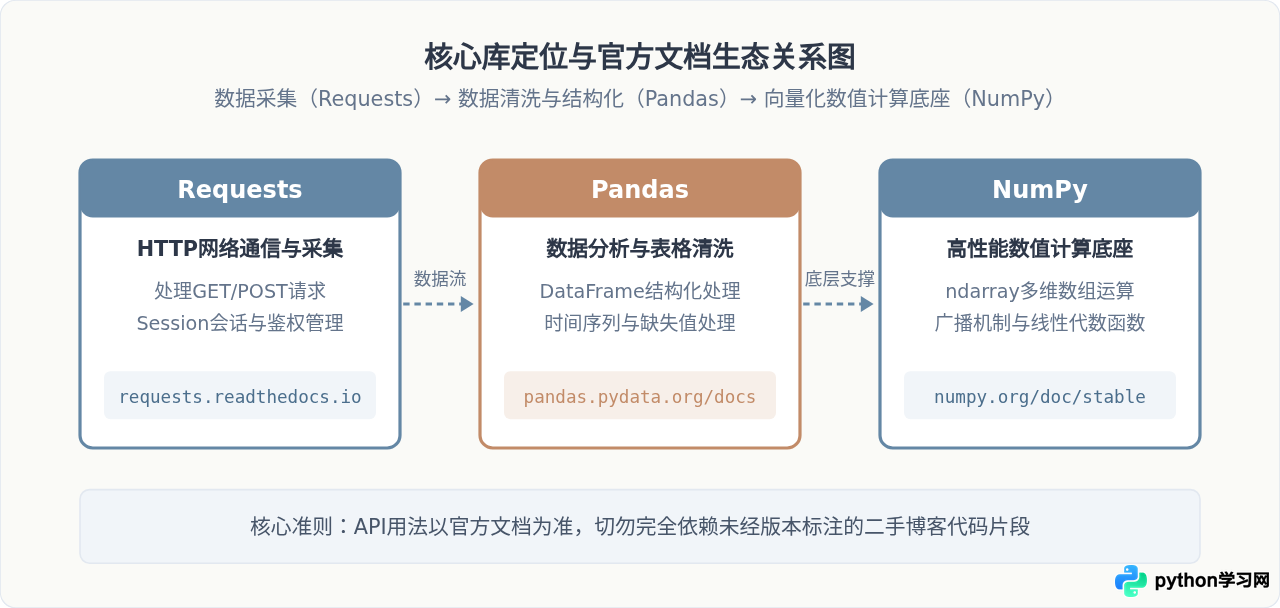
每个库在Python生态体系中承担着不同的工程分工:NumPy构筑了底层高性能多维数组与线性代数计算标准;Pandas在NumPy基础之上封装了面向表格化数据的强大分析与清洗框架;Requests则以简洁优雅的API规范了HTTP网络通信。访问官方文档时,应优先锁定其稳定版本(Stable)入口,避免误入开发中分支(Dev)或第三方抓取镜像。
| 库名称 | 项目核心定位 | 官方主站及文档主入口 | 稳定版(Stable)直达入口 |
|---|---|---|---|
| NumPy | 多维数组容器、向量化运算与数学函数库 | https://numpy.org/doc/ |
https://numpy.org/doc/stable/ |
| Pandas | Series与DataFrame表格数据清洗与结构化分析 | https://pandas.pydata.org/docs/ |
https://pandas.pydata.org/docs/ |
| Requests | 优雅且人性化的HTTP客户端与REST接口交互库 | https://requests.readthedocs.io/ |
https://requests.readthedocs.io/en/latest/ |
二、查阅官方文档的高效四步流程
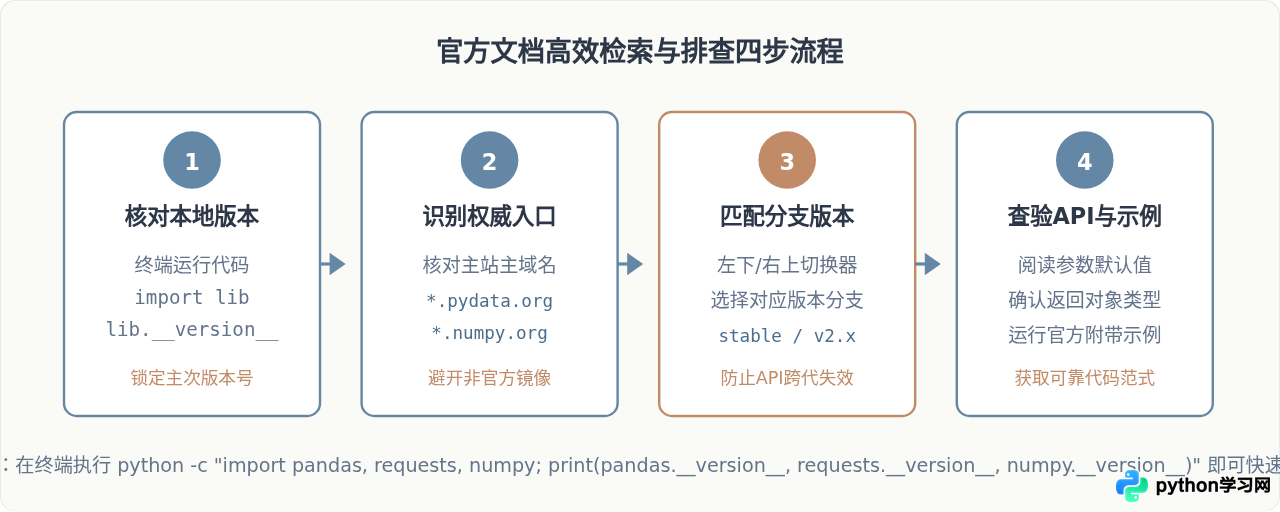
很多开发者在打开官方文档后,面对庞大的侧边栏目录和纯英文说明感到无从下手。高效使用官方文档并不需要逐字通读,而是遵循一套明确的“查验—定向—检索—验证”流程:
- 核对本地环境版本:在查阅前,先确认本地项目环境安装的具体版本号。不同大版本之间(例如Pandas 1.x与2.x,NumPy 1.x与2.0)可能存在关键函数弃用或默认参数调整。
- 确认官方权威域名:认准对应项目的根域名,排查并避开爬虫抓取的镜像站或过时快照。
- 切换匹配文档分支:文档页面通常提供版本切换器(Version Switcher),确保页面顶部或路径标明为与本地一致的稳定版本,而非
dev或latest(尚未发布的最新开发版)。 - 精确定位API参考与示例代码:通过左侧搜索框输入目标类或方法名(如
read_csv或Session),重点研读参数说明、默认返回值类型及底部给出的官方示例(Examples)。
三、三大库官方文档的核心板块与查阅技巧
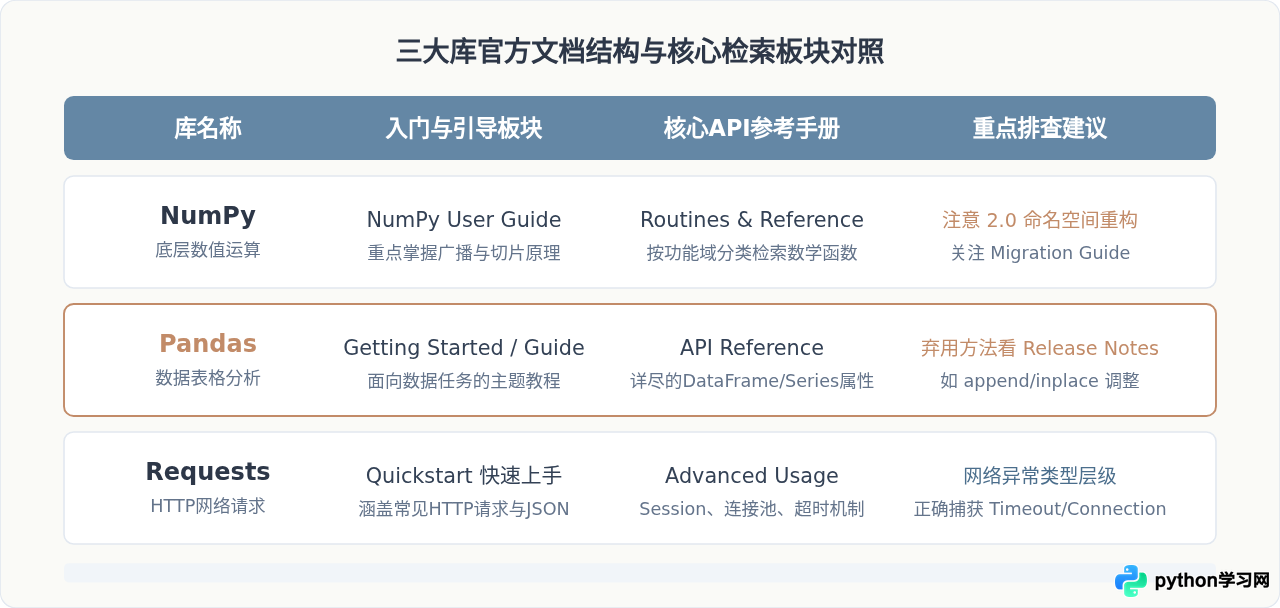
1. NumPy 文档:抓住“用户指南”与“常规例程参考”
NumPy文档整体结构分为三大核心区域:User Guide(用户指南)、Reference(API参考手册)和Building & Extending(构建与C-API扩展)。
- 初学者路径:直接查看 User Guide -> NumPy Basics,其中对数组广播机制(Broadcasting)、索引切片(Indexing)和数据类型(dtypes)有极为清晰的图解。
- 查阅函数签名:绝大多数日常查阅应直奔 Routines 目录(如
numpy.linalg、numpy.fft、numpy.random),每个数学函数均列出严格的数学定义、参数维度要求及警告信息。 - 特别提醒:NumPy 2.0于2024年发布,带来了重大的C-API与命名空间清理。查阅时需格外注意函数是否属于
numpy.exceptions或是否有过时警告(DeprecationWarning)。
2. Pandas 文档:善用 API Reference 与 Release Notes
Pandas是Python生态中文档体量最大的项目之一,左侧侧边栏内容丰富。高效查阅的关键在于区分两类需求:
- 功能选型:若不确定用哪个函数处理数据,查阅 User Guide,该板块按任务组织(如 Reshaping and pivot tables、Time series、Merge, join, concatenate)。
- 参数精确定位:直达 API Reference。例如检索
DataFrame.merge,重点看how(连接方式)、on(键选择)以及validate(一对一/一对多关系校验)参数。 - 升级排错:当终端抛出
FutureWarning时,第一时间访问 Release Notes(发行说明)。例如Pandas 2.0后弃用了DataFrame.append(),文档中直接指引替换方案为pd.concat()。
3. Requests 文档:短小精悍的经典 ReadTheDocs 风格
与前两者相比,Requests的文档结构极为紧凑,通常在单页或两级目录内即可完整掌握:
- User Guide(快速入门):从简单的
requests.get()到请求头(Headers)、参数传递(Params/Data/Json)与响应解析(response.json())。 - Advanced Usage(高级用法):生产级开发必看板块,详细介绍了
requests.Session会话对象、连接池保持、超时控制(Timeouts)、SSL证书验证与HTTP代理配置。 - API Reference:定义了
Response、Request、PreparedRequest等核心内部对象的属性与异常体系(如requests.exceptions.RequestException),便于编写健壮的异常捕获逻辑。
四、查阅官方文档的常见误区与避坑指南
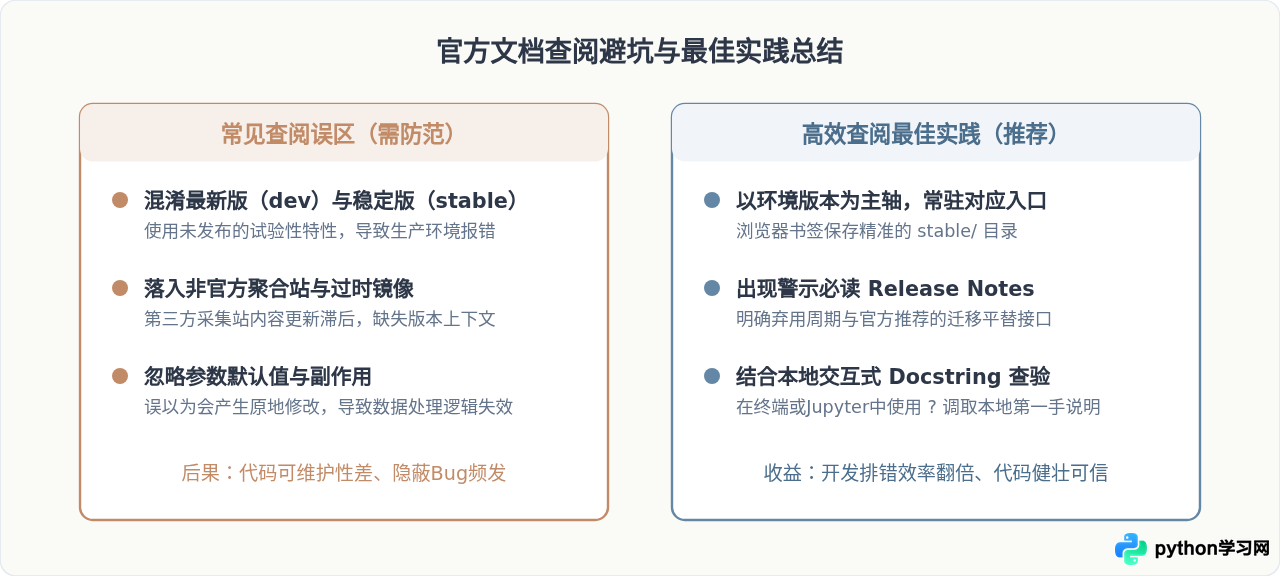
很多开发者在阅读文档时常常陷入“只见树木,不见森林”的误区。建立良好的文档查阅习惯,可以避免编写出潜藏缺陷的代码:
避坑提示:查阅API时不仅要看函数名字,还要逐一确认两个关键细节:参数的默认值是什么(例如 copy=True 还是视图)以及返回对象的具体类型(是原对象就地修改还是返回新对象)。
- 误区一:版本脱节(Version Mismatch)。许多初学者直接使用搜索引擎第一条结果,往往进入了多年前的陈旧版本镜像(如旧版Pandas 0.24文档)。此时查阅的代码可能包含已被废除的调用方式。正确做法:进站后先看页面右下角或左上角,确保版本与本地项目一致。
- 误区二:只看代码段,不看“Notes”与“Warnings”。官方文档在API说明下方通常包含
.. note::或.. warning::块。这些地方往往记录了关键边界条件,例如内存拷贝行为、线程安全性或浮点精度损失。 - 误区三:忽略本地内置文档。如果临时离线或只是核对某个参数名,无需特意打开浏览器。Python自带的
help()函数与 IPython/Jupyter 中的?语法(例如import pandas as pd; pd.read_csv?)即可直接调出与本地库完全一致的官方Docstring说明。
五、结语
掌握官方文档的查阅方法是每一位Python开发者提升代码质量和独立排错能力的必经之路。面对日新月异的技术迭代,学会从官方入口获取一手资料、验证版本适配并理解API设计初衷,远比生搬硬套网络上的零散片段更加扎实、可靠。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









