

常用Python库官网地址汇总:NumPy、Pandas与Requests
全面汇总Python日常开发中最高频使用的NumPy、Pandas与Requests三大核心库官方网站、在线API文档与源码仓库地址,并提供官方文档的高效查阅策略与版本防坑指南。
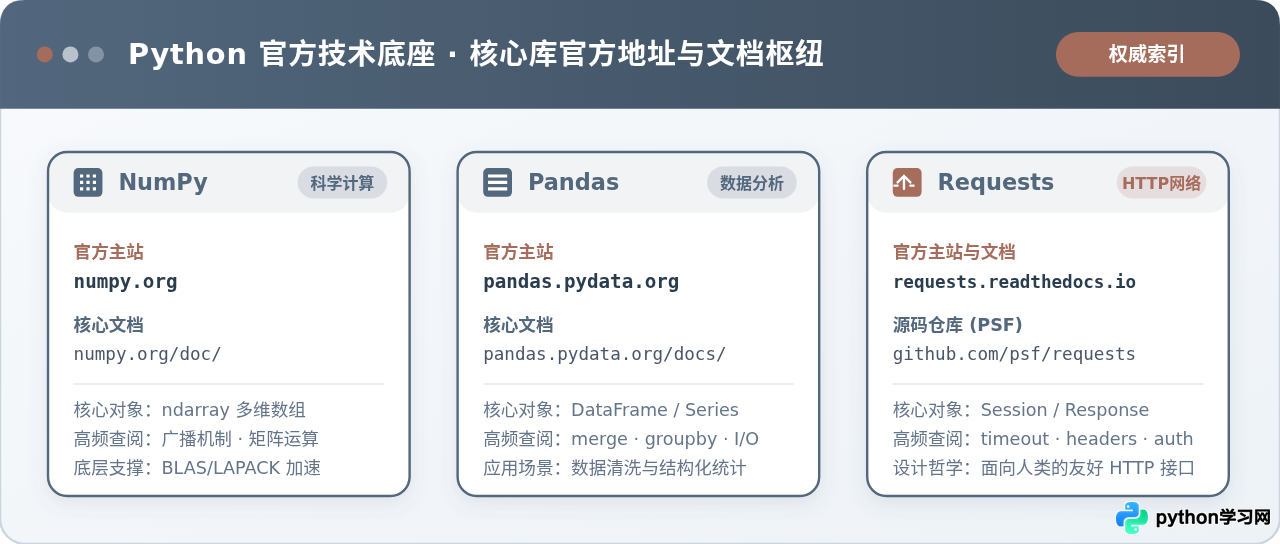
一、核心官网地址清单与职责分工
NumPy、Pandas 与 Requests 分别构成了 Python 科学计算底座、结构化数据分析引擎与 HTTP 网络通信协议层。以下是经过核验的官方权威访问地址:
| 库名称 | 核心职责 | 官方网站主页 | 在线文档地址(Stable) | 源码托管仓库 |
|---|---|---|---|---|
| NumPy | 多维数组(ndarray)与底层矩阵线性代数 | https://numpy.org/ | https://numpy.org/doc/stable/ | numpy/numpy |
| Pandas | 双维表格(DataFrame)与数据清洗重塑 | https://pandas.pydata.org/ | https://pandas.pydata.org/docs/ | pandas-dev/pandas |
| Requests | 面向人类的 HTTP/1.1 与 REST 协议交互客户端 | https://requests.readthedocs.io/ | https://requests.readthedocs.io/en/latest/ | psf/requests |
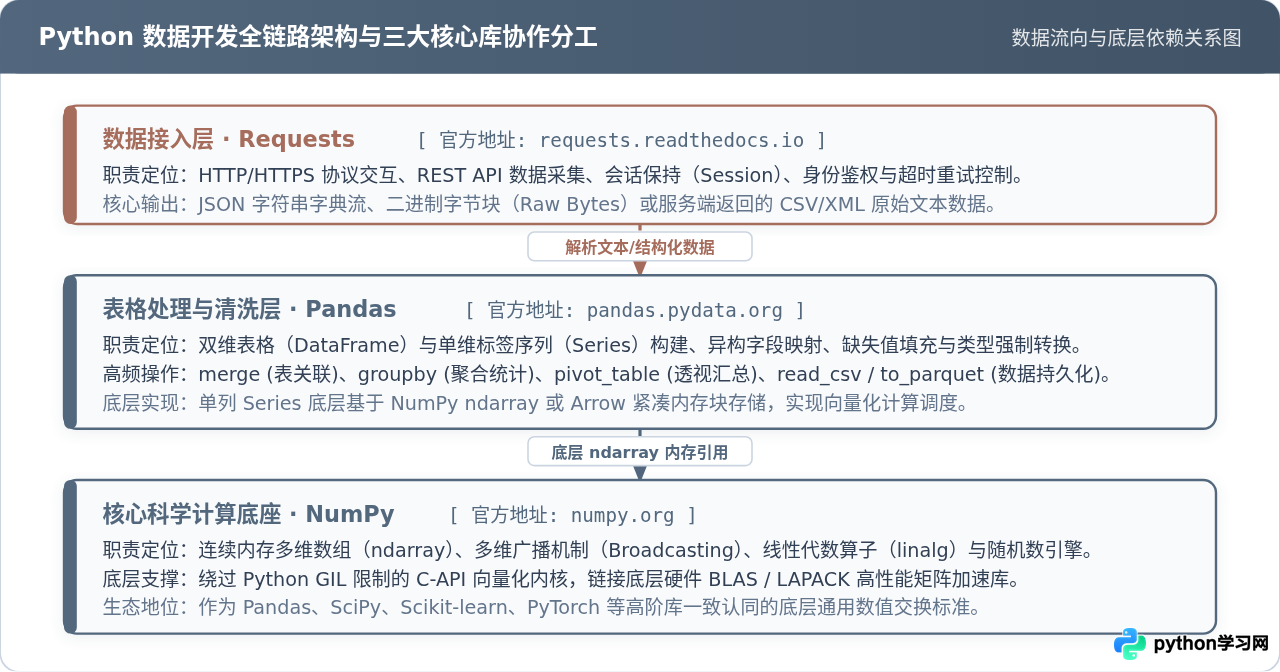
在实际生产中,这三个库并非孤立运行,而是形成了典型的数据流处理管道:Requests 负责向远程服务发送安全网络请求并取回原始数据;Pandas 负责将杂乱的 JSON 或文本解析成整洁的表格结构,执行过滤、对齐与聚合;而底层的数值向量化操作与密集算子计算,则由底座 NumPy 直接调动编译级底层库执行。
二、防范版本脱节:官方文档查阅的 5 步流程
不少开发者通过通用搜索引擎检索某个函数时,容易直接点击进入过时的历史版本网页。例如,Pandas 早期版本广泛使用的 DataFrame.append() 在 2.0 版本后已被彻底移除;NumPy 2.0 移除了 np.float 等过时类型别名;如果对照旧版文档编写代码,在本地现代运行环境中就会直接遭遇 AttributeError。
查阅官方文档的正确做法,应当始终保持“先核验本地环境,再精确跳转对应版本”的工程严谨度:
python3 -c "import numpy, pandas, requests; print(f'NumPy: {numpy.__version__}\nPandas: {pandas.__version__}\nRequests: {requests.__version__}')"
Pandas: 2.2.3
Requests: 2.32.3
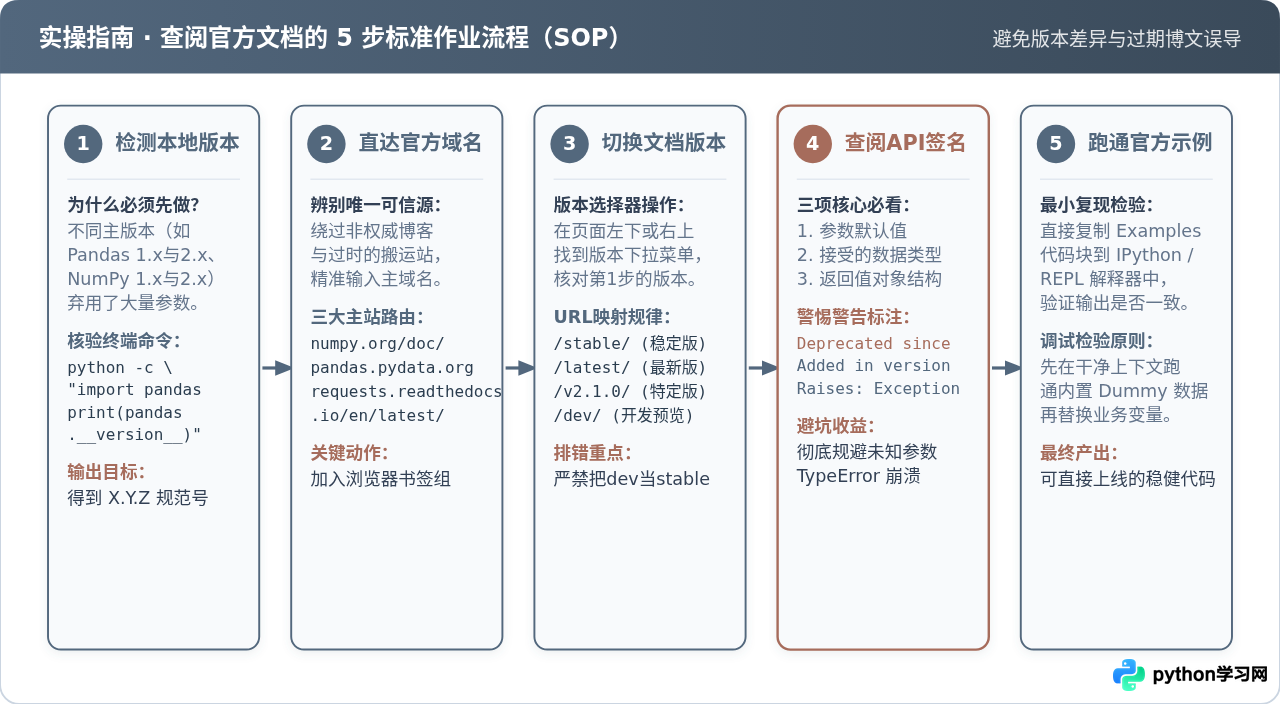
如流程图所示,核验步骤具体拆解如下:
- 检测本地版本:通过解释器执行
library.__version__获取正在执行的精确版本号。 - 直达官方权威域名:优先在浏览器书签栏保存
numpy.org、pandas.pydata.org和requests.readthedocs.io,避免搜索引擎抓取的二次镜像站。 - 检查文档版本指示器:进入文档后,确认页面 URL 是否带有
/stable/(稳定发布版)或者匹配当前主版本号。若本地项目运行在维护性老环境(如 Pandas 1.5.3),必须通过左下角或右上角的版本下拉菜单切换至对应归档版本。 - 仔细审查 API 签名与注解:关注参数的默认值、接受类型以及带红色/黄色高亮标注的
Deprecated since version...警告。 - 执行官方最小示例(MRE):在 Python 交互式命令行(REPL 或 IPython)中粘贴文档中的示例代码,验证预期逻辑后再集成进项目业务代码。
三、三大核心库官方站点关键板块对照
每个库官方站点的组织侧重点与其功能形态紧密相关。NumPy 聚焦于数学理论与内存布局,Pandas 强调表格转换与算子组合,而 Requests 则围绕 HTTP 协议状态与安全网络传输展开。
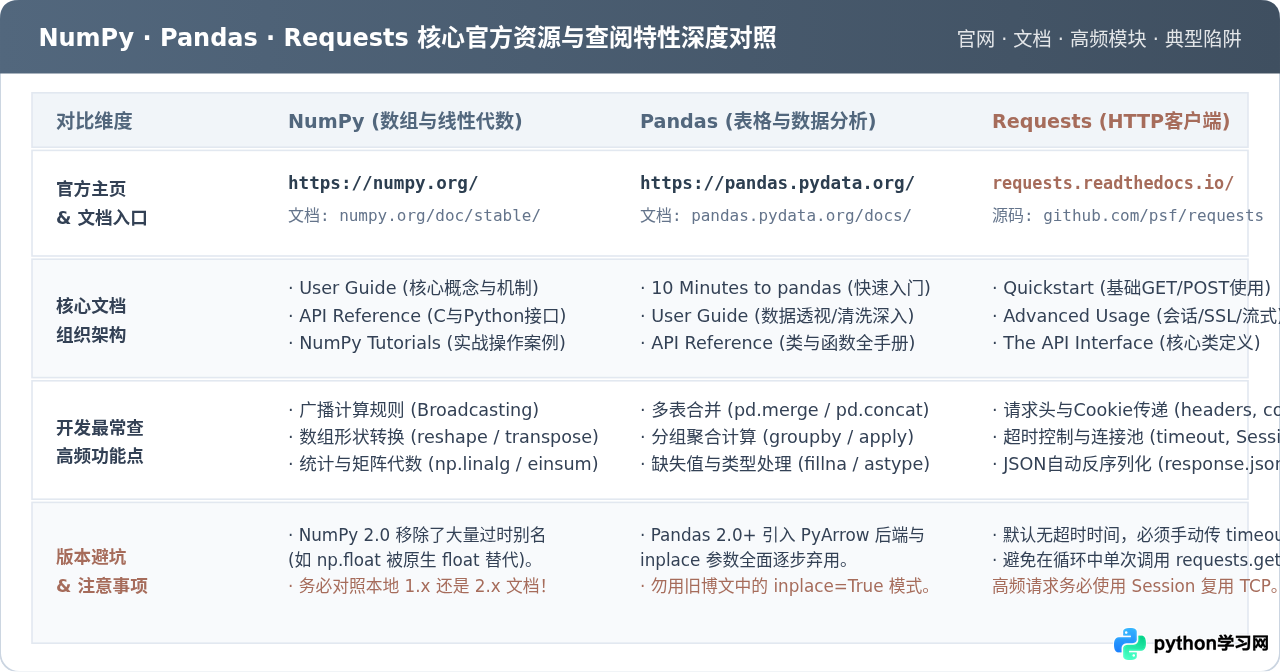
1. NumPy 官网查阅重点(numpy.org)
进入 NumPy 官方文档 时,建议重点研读 User Guide 中的以下核心原理:
- 广播规则(Broadcasting Rules):当不同形状的数组进行算术运算时,NumPy 如何隐式扩展维度以避免数据复制。官方文档给出了详细的维度对齐图解。
- 数组切片与视图(Views vs Copies):了解基础切片
arr[1:5]仅返回共享底层内存的视图,而布尔花式索引arr[arr > 0]会触发内存拷贝。 - 线性代数子模块(numpy.linalg):包含矩阵分解(SVD、QR、Cholesky)、特征值计算及行列式求解的完整参数与异常说明。
import numpy as np

# 创建二维矩阵与一维向量进行广播计算
matrix = np.array([[10, 20, 30], [40, 50, 60]])
vector = np.array([1, 2, 3])

# 触发 NumPy 广播运算机制
result = matrix + vector
print("计算结果 ndarray:")
print(result)
[[11 22 33]
[41 52 63]]
2. Pandas 官网查阅重点(pandas.pydata.org)
在 Pandas 官方文档 中,API Reference 是检索频次最高的章节:
- 数据关联操作(merge 与 join):核对
on、left_on、right_on、how(inner/left/right/outer/cross)以及列名重名时的suffixes处理。 - 分组聚合(groupby 与 agg):重点了解支持命名聚合(Named Aggregation)的现代写法,如
df.groupby('dept').agg(avg_salary=('salary', 'mean'))。 - 缺失值与类型(Missing Data & Nullable Types):Pandas 2.0 推荐的
pd.NA以及 Arrow 扩展类型(如string[pyarrow]),相比传统np.nan能提供更严密的布尔逻辑与内存优化。
import pandas as pd

raw_data = [
    {"dept": "研发部", "member": "张工", "work_hours": 42},
    {"dept": "研发部", "member": "李工", "work_hours": 38},
    {"dept": "运营部", "member": "王工", "work_hours": 40}
]

df = pd.DataFrame(raw_data)
summary = df.groupby("dept", as_index=False).agg(
    total_hours=("work_hours", "sum"),
    headcount=("member", "count")
)
print("分组汇总 DataFrame:")
print(summary)
dept total_hours headcount
0 研发部 80 2
1 运营部 40 1
3. Requests 官网查阅重点(requests.readthedocs.io)
Requests 官方文档 的篇幅相比前两者更精炼,但 Advanced Usage(高级用法) 章节至关重要:
- 超时控制(Timeouts):Requests 默认不设置超时时间,如果不主动指定
timeout=(connect, read),一旦对端无响应,程序将永远阻塞挂起。 - 会话复用(Session Objects):高频调用同一个主机时,通过
requests.Session()跨请求持久化 Cookie、保持底层的 TCP 连接(HTTP Keep-Alive),大幅缩短连接握手耗时。 - SSL 证书校验与重试(SSL Verification & Transport Adapters):工程环境中对自签名 CA 证书的挂载,以及基于
HTTPAdapter配置底层urllib3自动重试策略。
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

session = requests.Session()

# 配置针对瞬时网络波动的自动重试机制
retries = Retry(total=3, backoff_factor=0.5, status_forcelist=[500, 502, 503, 504])
session.mount('https://', HTTPAdapter(max_retries=retries))

# 发送请求时显式设定超时阈值(连接超时 3.05 秒,读取超时 10 秒)
try:
    response = session.get(
        'https://httpbin.org/get',
        params={'source': 'python_hub'},
        headers={'User-Agent': 'CustomClient/1.0'},
        timeout=(3.05, 10)
    )
    response.raise_for_status()
    payload = response.json()
    print("请求成功,远端返回参数:", payload.get("args"))
except requests.exceptions.RequestException as exc:
    print(f"请求失败: {exc}")
finally:
    session.close()
requests.readthedocs.io。历史上的旧网址 python-requests.org 目前已自动重定向,但在生产配置文件与内网防火墙白名单中,应直接配置 requests.readthedocs.io 及 GitHub 官方源码地址 github.com/psf/requests,避免受重定向链路变动影响。
四、构建官方信息检索与知识沉淀的闭环
掌握这三个库的官网入口只是第一步,建立可持续的官方技术查阅习惯才能从根本上提升编码质量。无论库如何升级迭代,官方一手材料始终遵循从浅入深的分层架构:
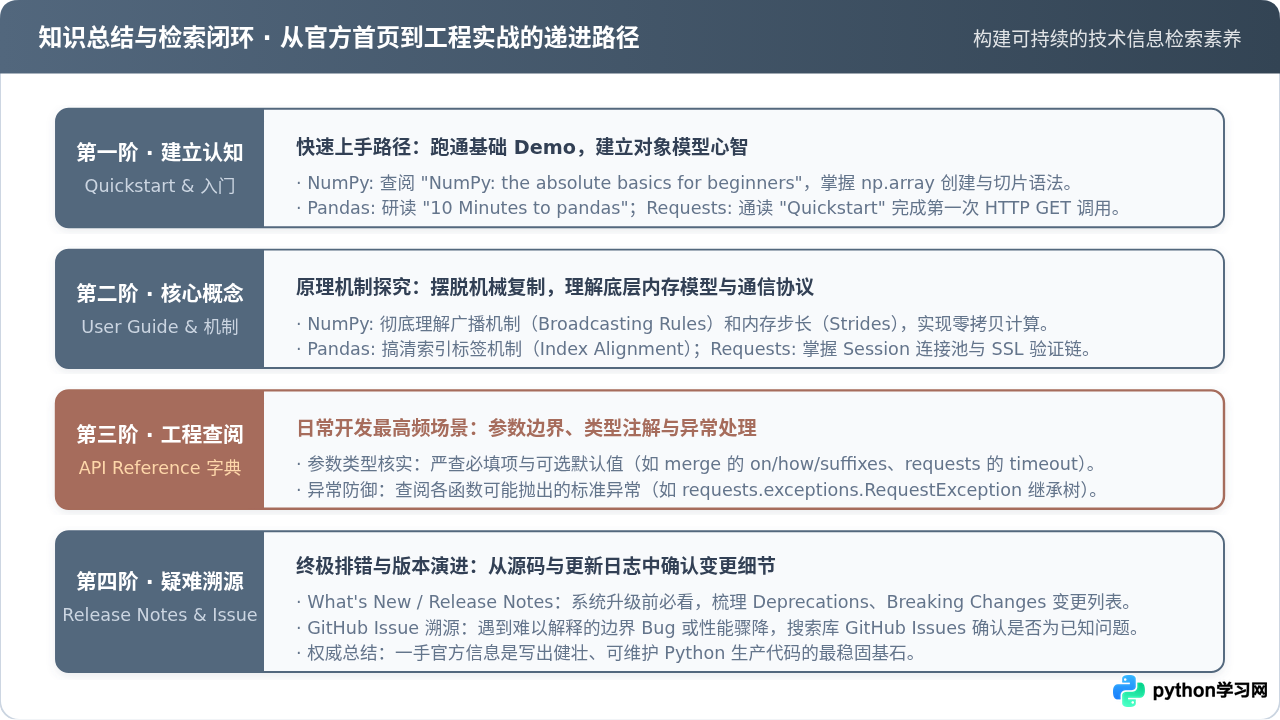
在日常工作中遇到非预期的异常或新功能开发时,建议遵循以下递进检索顺序:
- 快速定位函数签名(API Reference):直接使用官网内置搜索框(快捷键通常为
/或顶部搜索栏),查阅函数参数列表与默认值。 - 核查版本发布说明(What's New / Release Notes):在准备升级某个库或遇到莫名其妙的弃用警告时,直接翻阅 Release Notes。这里会明确列出 Breaking Changes(破坏性改动)以及推荐的替代写法。
- 排查边界 Bug(GitHub Issues):如果官方文档说明与实际执行行为存在不一致,且排除了本地传参错误,可在官方 GitHub 仓库的 Issues 板块按报错关键词过滤,通常能迅速查明是否为已修复的已知问题。
将官方网站、文档稳定版与源码仓库加入日常开发工具链,不仅能让代码更健壮、更符合现代 Python 规范,也能在环境迁移与版本升级中大幅降低维护成本。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









