

Python基础语法核心清单:变量、数据类型与控制流详解

系统梳理Python基础语法的核心清单,涵盖变量命名与对象引用机制、核心内置数据类型特性及可变性、条件分支与循环控制流的执行机制与常见避坑指南。
掌握Python编程的实际操作能力,核心在于理清三个互相衔接的底层支柱:变量的动态引用机制、核心内置数据类型的操作与内存行为、以及由条件分支与循环构成的控制流逻辑。本文将这三部分知识拆解为清晰具体的操作清单与核心规则,结合可运行的代码示例与结构图示,帮助读者准确建立语法认知并规避常见逻辑陷阱。
一、变量定义与对象引用模型
在许多编译型语言中,变量被视作存放特定类型数据的“固定盒子”;但在Python中,变量更像是一个贴在内存对象上的标签名称。理解这一机制是写出正确代码的前提。
1. 变量命名与赋值规则
Python采用动态类型系统,变量在初次赋值时自动创建,不需要提前声明类型。声明变量遵循PEP 8规范:
- 标识符必须以字母(A-Z, a-z)或下划线(_)开头,后续字符可包含数字。
- 变量名对大小写敏感,
total_count与Total_Count代表不同的标识符。 - 采用蛇形命名法(snake_case),例如
user_response_code,避免使用单个易混淆字符(如小写l、大写O)。 - 不能使用Python保留关键字(如
class,def,if,import等)。
# 基础赋值与动态绑定示例
port_number = 8080        # 整数对象绑定到标签 port_number
server_status = "running" # 字符串对象绑定到标签 server_status
is_active = True          # 布尔对象绑定到标签 is_active

# 动态重绑定:将变量名贴到新的对象上
server_status = 200       # 原变量标签改指向整数对象 200
2. 内存引用机制与标识对比(is 与 ==)
当执行 y = x 时,Python并没有复制底层的数据对象,而是创建了一个新的名称标签 y,并让它指向与 x 相同的内存对象。要区分两个变量的关系,需要使用两种不同的比较操作:
==操作符:比较两个变量所引用的对象内容是否相等(Value Equality)。is操作符:比较两个变量是否指向同一个内存地址(Identity Equality),即id(x) == id(y)。
list_a = [1, 2, 3]
list_b = list_a          # 引用复制:两者指向同一列表对象
list_c = [1, 2, 3]       # 新建独立列表对象:内容相同,但内存地址不同

print(list_a == list_c)  # 示例输出:True(内容相等)
print(list_a is list_c)  # 示例输出:False(不同对象)
print(list_a is list_b)  # 示例输出:True(同一对象引用)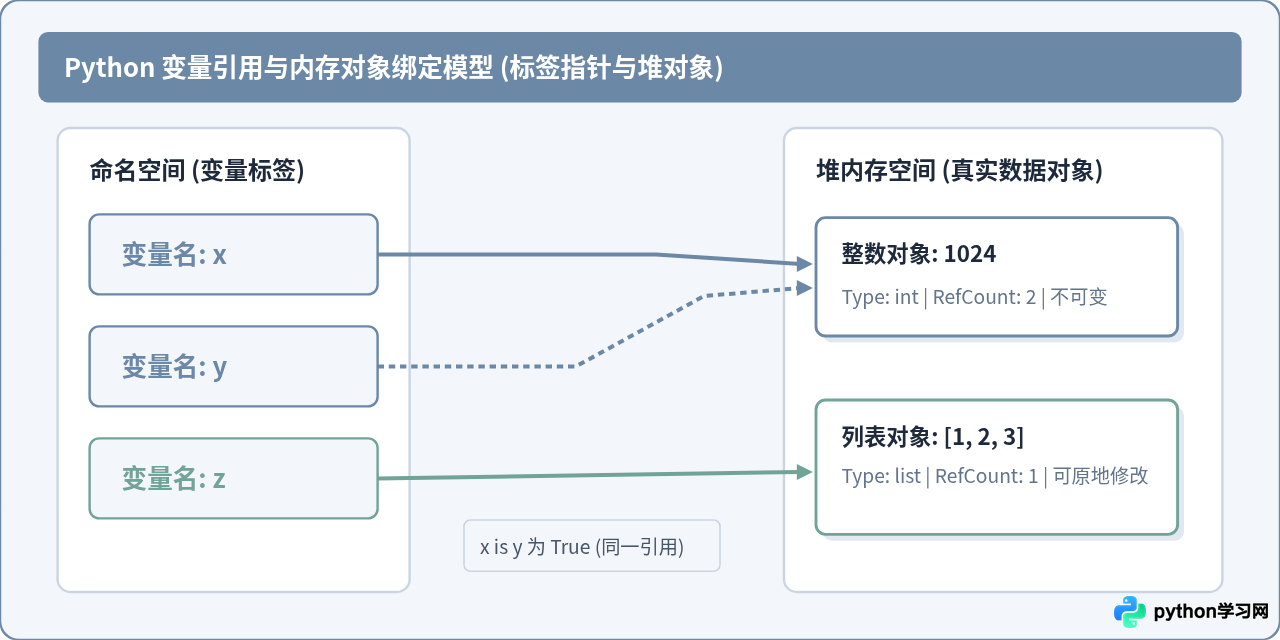
二、核心内置数据类型详解
Python提供了一组丰富的内置数据类型,分为基础单值类型与复合容器类型。理解它们的特征、使用边界以及是否可变,是防止程序出现非预期Bug的核心。
1. 数值与布尔类型
- int(整型):Python 3的整型具备任意精度,不会出现其他语言中的32位或64位溢出问题。
- float(浮点型):底层采用双精度(64位IEEE 754)实现,存在固有的二进制浮点数舍入误差。例如
0.1 + 0.2得到0.30000000000000004。比较浮点数相等时应使用math.isclose(a, b),而非==。 - bool(布尔型):只有两个值
True和False。在Python内部,bool是int的子类,True == 1和False == 0均成立,但在业务逻辑中应保持明确的语义。
2. 文本序列:str(字符串)
字符串是不可变序列,一旦创建无法原地修改内容。字符串支持正向索引(从0开始)、反向索引(从-1开始)以及切片语法 [start:stop:step]。
source_str = "Python-Core"

# 切片获取子串:左闭右开区间 [0:6]
prefix = source_str[0:6]      # "Python"
reversed_str = source_str[::-1] # 反转字符串:"eroC-nohtyP"

# 推荐使用 f-string 进行格式化插值
item_count = 5
total_price = 199.95
summary = f"数量: {item_count:02d}, 总金额: ¥{total_price:.2f}"
# 示例输出:"数量: 05, 总金额: ¥199.95"
3. 核心容器类型特性对比
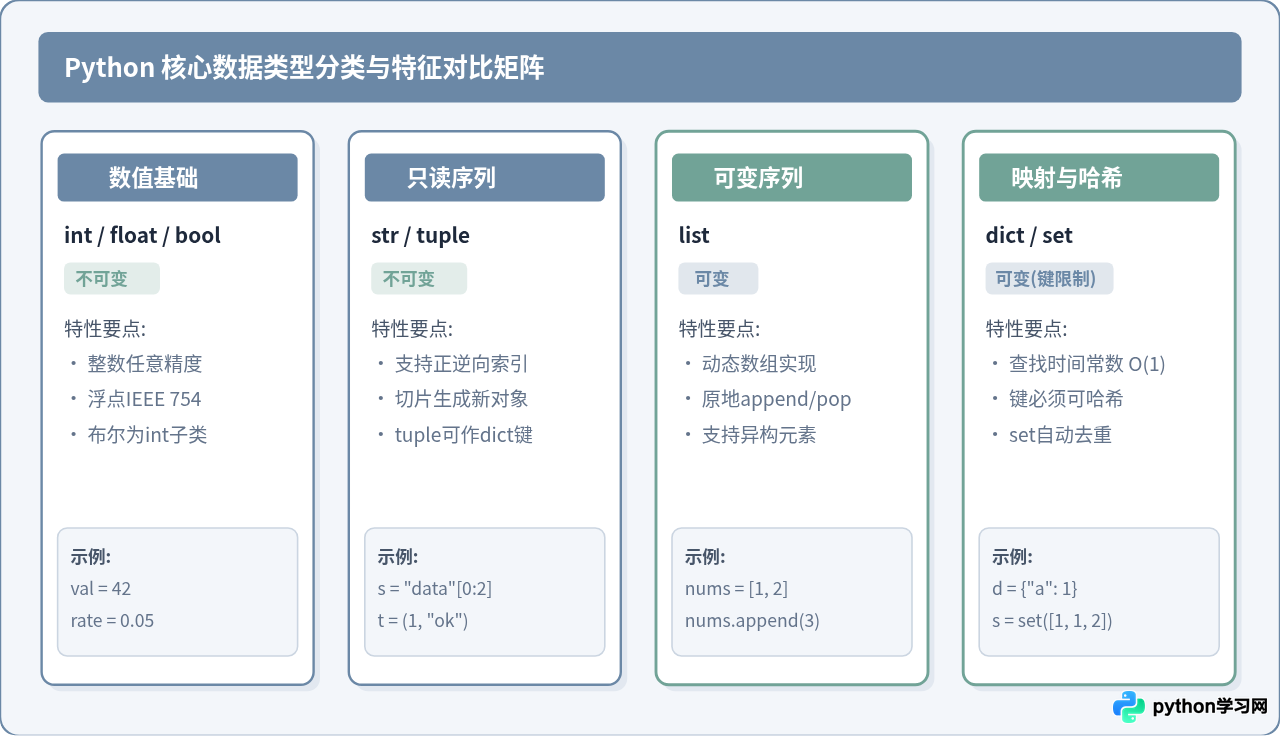
根据数据有序性、是否允许重复以及是否可变,Python的四大容器承担不同职责:
| 类型 | 声明语法 | 是否有序 | 是否可变 | 元素唯一性 | 核心使用场景 |
|---|---|---|---|---|---|
| list | [1, 2, 3] |
是 | 可变 | 允许重复 | 按顺序存储与动态增删数据 |
| tuple | (1, 2, 3) |
是 | 不可变 | 允许重复 | 函数多返回值解包、只读固化记录 |
| dict | {"k": "v"} |
是(保留插入序) | 可变 | 键唯一,值可重复 | 结构化键值映射与快速查找(哈希) |
| set | {1, 2, 3} |
否 | 可变 | 元素全局唯一 | 去重、成员资格测试与交并补集合运算 |
不可变对象(int, float, bool, str, tuple)在被“修改”时,其实是在内存中生成了全新对象,并让变量指向新对象;可变对象(list, dict, set)可以直接在其所在的内存块中进行增删改,所有指向该对象的变量会同步感知到修改。
三、控制流语句与逻辑调度
控制流语句决定了程序的执行路径。Python依靠严格的代码缩进(推荐4个空格)来定义代码块层级,舍弃了大括号 {}。核心控制流包括条件分支(if-elif-else)与循环结构(for/while)。
1. 条件分支与真值测试(Truthy 与 Falsy)
在条件表达式中,Python不仅支持布尔值 True 和 False,还支持任意类型的隐式真值转换。以下对象在布尔上下文中会被判定为 False(即 Falsy):
- 常量:
None、False - 数值零值:
0、0.0、Decimal(0) - 空序列或空容器:
""(空字符串)、[](空列表)、()(空元组)、{}(空字典)、set()(空集合)
# 判空规范:直接依靠容器自身的布尔真值,不要使用 len(container) == 0
user_tokens = []

if not user_tokens:
    # 命中此分支:列表为空
    status_msg = "Token列表未配置"
else:
    status_msg = "Token已加载"

# 条件表达式(单行三元运算符)
priority_level = 1 if len(user_tokens) > 10 else 2
2. for 循环与可迭代协议
Python的 for 循环本质上是一个“迭代器驱动器”,用于逐个遍历可迭代对象(序列、字典、生成器等)。编写循环时常用以下辅助函数:
range(start, stop[, step]):按步长生成不可变整数序列(左闭右开)。enumerate(iterable, start=0):同时获取元素索引与其值。zip(iter_a, iter_b):并行配对遍历多个序列。
servers = ["web-01", "web-02", "db-01"]
ports = [80, 80, 5432]

# 同时获取索引与值
for idx, name in enumerate(servers, start=1):
    print(f"节点 {idx}: {name}")

# 配对并行遍历
for s_name, s_port in zip(servers, ports):
    print(f"服务 {s_name} 监听端口: {s_port}")
3. while 条件循环与跳转控制(break、continue、else)
while 循环在给定条件保持为真时持续运行,常用于事件轮询或未预知迭代步数的场景。Python循环结构支持三个关键跳转语义:
break:强制中断并彻底跳出当前循环体。continue:立即终止当前这一轮迭代,跳过后续语句并进入下一轮条件检查。for...else与while...else:当循环正常耗尽或条件自然变为假(没有被 break 触发中断)时,执行else块。如果循环中途被break终止,则else块不会执行。
target_key = "app_secret"
config_cache = [("db_host", "localhost"), ("app_secret", "9xK#22"), ("timeout", "30")]

for key, val in config_cache:
    if key == target_key:
        print(f"成功找到目标配置: {val}")
        break
else:
    # 仅当遍历全部项且没有触发 break 时才会执行
    print(f"配置项 {target_key} 不存在")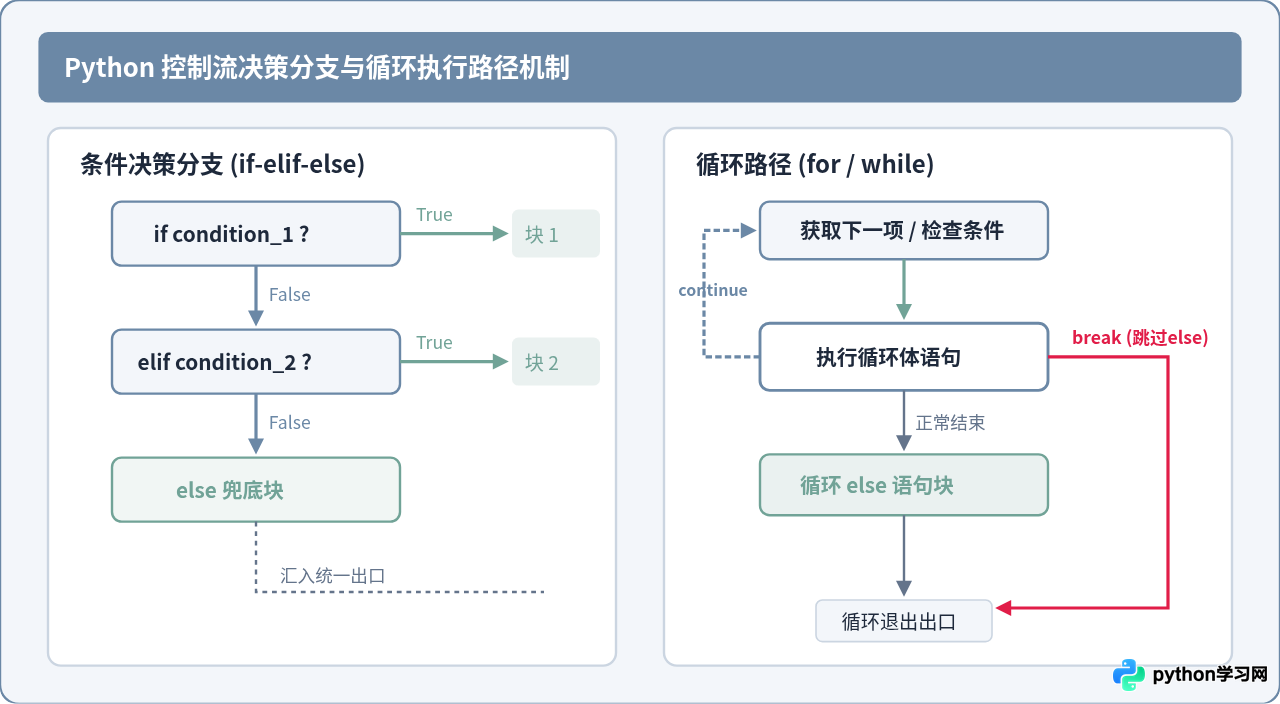
四、综合应用实战与高频避坑清单
为了将变量引用、数据容器与控制流语句串联起来,以下通过一个结构化日志解析与统计处理的完整案例,演示典型写法的落地过程。
1. 综合实战案例:服务响应日志分类统计
# 模拟输入的未清洗访问日志记录
raw_logs = [
    "192.168.1.10 - 200 - /api/v1/user",
    "192.168.1.11 - 404 - /api/v1/unknown",
    "192.168.1.12 - 500 - /api/v1/pay",
    "192.168.1.10 - 200 - /api/v1/order",
    "INVALID_LINE_WITHOUT_DELIMITER",
    "192.168.1.15 - 200 - /api/v1/status"
]

# 统计容器初始化
status_category_count = {"2xx": 0, "4xx": 0, "5xx": 0}
unique_clients = set()
skipped_lines = 0

for line in raw_logs:
    # 拆分并验证字段完整性
    parts = line.split(" - ")
    if len(parts) != 3:
        skipped_lines += 1
        continue  # 格式异常,跳过当前行

    ip_addr, code_str, endpoint = parts
    status_code = int(code_str)

    # 记录去重客户端IP
    unique_clients.add(ip_addr)

    # 控制流分支归类状态码
    if 200 <= status_code < 300:
        status_category_count["2xx"] += 1
    elif 400 <= status_code < 500:
        status_category_count["4xx"] += 1
    elif 500 <= status_code < 600:
        status_category_count["5xx"] += 1

print(f"有效独立IP数: {len(unique_clients)}")
print(f"状态分类统计: {status_category_count}")
print(f"无效记录跳过数: {skipped_lines}")

# 示例输出:
# 有效独立IP数: 4
# 状态分类统计: {'2xx': 3, '4xx': 1, '5xx': 1}
# 无效记录跳过数: 1
2. 常见四大高频语法陷阱
- 使用可变对象(如列表、字典)作为函数默认参数:函数默认参数在定义时被求值一次并保存在函数对象上。如果默认参数为
def append_item(val, target=[]),后续多次无参调用会持续向同一个列表对象追加内容。正确做法:使用None作为默认占位符,并在函数体内通过if target is None: target = []进行初始化。 - 在遍历列表的过程中直接删除元素:在
for item in my_list:循环体内直接执行my_list.remove(item)会导致列表内部索引前移,造成跳项漏删。正确做法:遍历原列表的浅拷贝副本for item in my_list[:]:,或者使用列表推导式生成新列表。 - 混淆
is与==:判断两个对象的内容相同应使用==,只有判断单例对象(如variable is None、variable is True)时才推荐使用is。 - 直接使用
==比较浮点数:因二进制浮点精度舍入,0.1 * 3 == 0.3会返回False。浮点运算结果的等值判断应使用math.isclose(a, b)或指定容差。
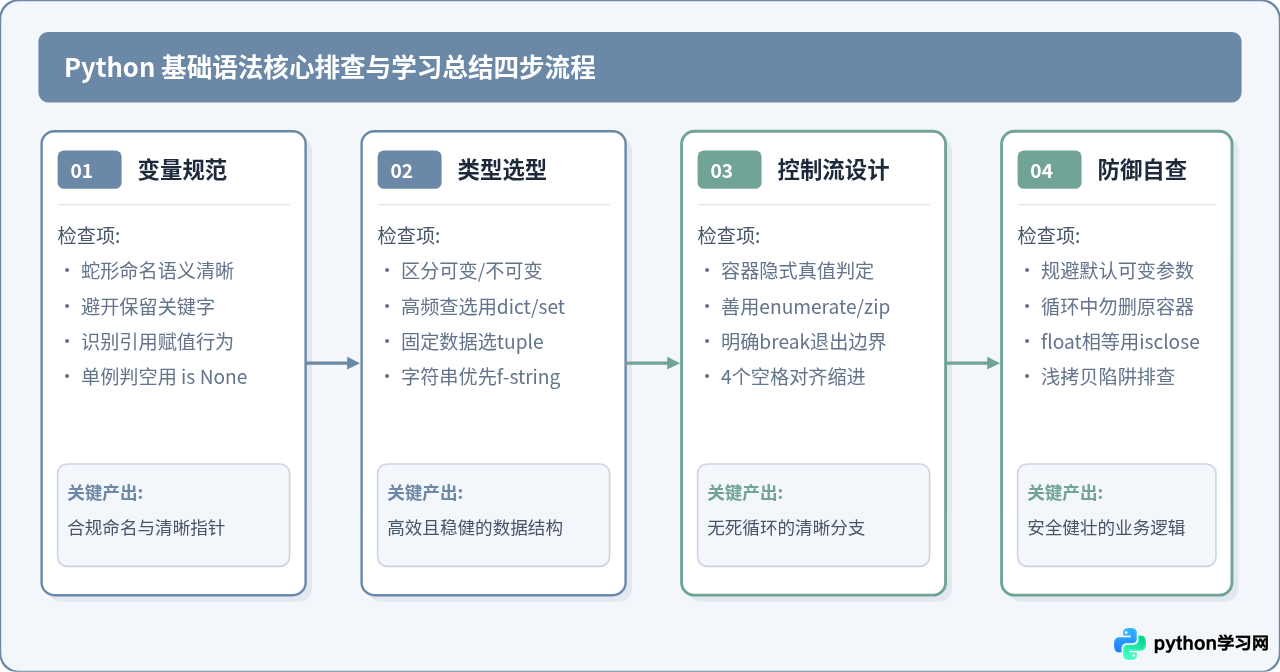
通过掌握变量引用的“标签-对象”模型、理解常用容器的可变性与时间复杂度,并结合真值判定与循环跳转逻辑,开发者即可建立起坚实规范的Python基础,为后续深入面向对象编程、并发编程及工程化项目奠定可靠的技术根基。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









