

__init__.py在Python包类导入中的作用与配置
深入解析Python中__init__.py的核心作用与实用配置技巧,包括目录包标识、类与函数导入路径扁平化、__all__对外接口约束及防范循环导入的最佳实践。
在 Python 项目开发中,__init__.py 文件的核心作用是将一个普通磁盘目录显式声明为可导入的 Python 包(Package),并在该包被首次加载时充当统一的初始化入口。通过在 __init__.py 中合理配置相对导入和 __all__ 白名单,开发者能够将深层子模块中分散的类与函数直接提取到包顶级命名空间,对外提供扁平、直观且具备版本稳定性的调用接口。本文将从包结构识别机制、类导入路径扁平化配置、__all__ 接口约束以及防范循环导入四个维度展开系统讲解。
一、核心机制:标识包与控制初始化流程
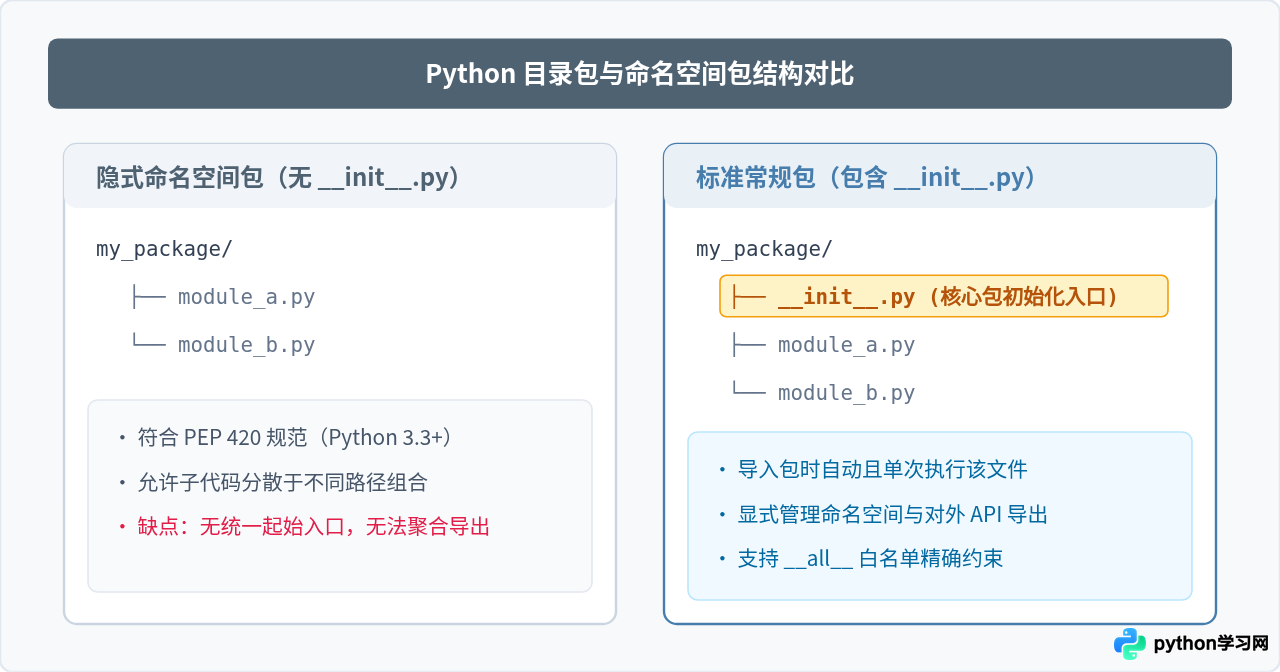
在 Python 3.3 引入 PEP 420 隐式命名空间包(Namespace Packages)之前,任何包含 Python 代码的文件夹都必须存在一个 __init__.py 文件,解释器才会将其识别为包。虽然现代 Python 允许没有该文件的目录作为命名空间包被导入,但在绝大多数实际工程中,包含核心业务类与工具函数的模块依然必须使用标准常规包(Regular Packages)。
当外部代码执行 import my_package 或 from my_package import some_module 时,解释器会首先在内存中创建包命名空间,并立即执行该包目录下的 __init__.py 代码。值得注意的是,该文件的执行具有单例属性:无论在整个进程中该包被导入多少次,其 __init__.py 中的顶层逻辑都仅在首次导入时触发执行一次。
二、类导入路径扁平化:暴露核心对外接口
在一个具有清晰职责划分的 Python 项目中,各个类通常会按领域拆分在不同的子文件内。例如,用户实体类放在 user.py,订单实体类放在 order.py。如果 __init__.py 保持为空,外部调用方必须编写层级很深的导入语句:
# 未在 __init__.py 中配置时的调用方式(层级冗长)
from app.domain.entities.user import UserModel
from app.domain.entities.order import OrderModel
这种写法存在两个显著缺陷:一是调用方必须熟知包内部的具体文件分布,二是未来若对内部文件重命名或拆分,将直接破坏外部所有导入语句。借助 __init__.py,我们可以通过显式相对导入将类提前“挂载”到当前包命名空间中。
实操配置步骤
假设我们拥有如下工程目录:
ecommerce/
├── __init__.py
├── customer.py
└── inventory.py
第一步:在子模块中编写类定义
# ecommerce/customer.py
class Customer:
    def __init__(self, name: str, email: str):
        self.name = name
        self.email = email

    def get_display_name(self) -> str:
        return f"{self.name} <{self.email}>"
# ecommerce/inventory.py
class InventoryItem:
def __init__(self, sku: str, quantity: int):
self.sku = sku
self.quantity = quantity
def is_in_stock(self) -> bool:
return self.quantity > 0第二步:在 __init__.py 中配置相对导入
# ecommerce/__init__.py
"""电商基础核心包,对外导出常用实体类。"""
from .customer import Customer
from .inventory import InventoryItem

# 定义包元信息
__version__ = "1.0.0"
第三步:验证外部调用效果
# main.py
# 此时调用者只需导入包本身,路径大幅缩短且语义清晰
from ecommerce import Customer, InventoryItem

client = Customer("Alice", "alice@example.com")
item = InventoryItem("SKU-9920", 50)

print(client.get_display_name()) # 输出示例: Alice <alice@example.com>
print(item.is_in_stock())        # 输出示例: True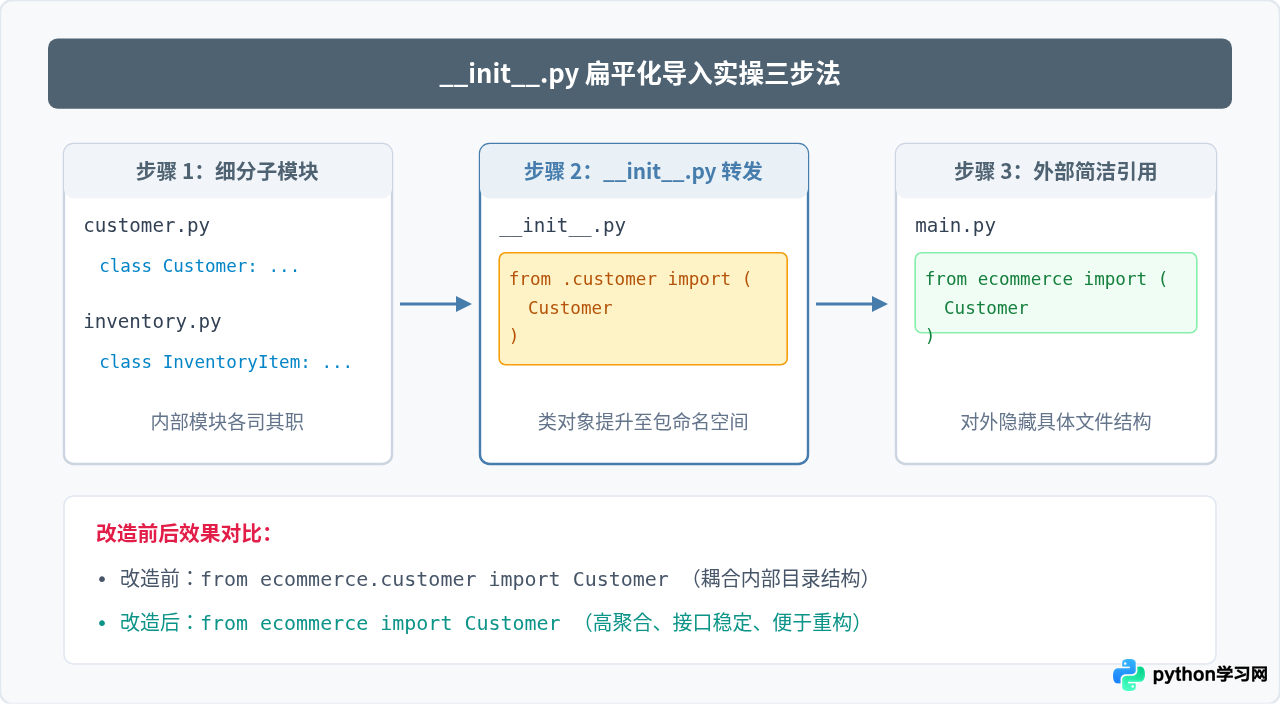
三、规范接口暴露:使用 __all__ 控制公共 API
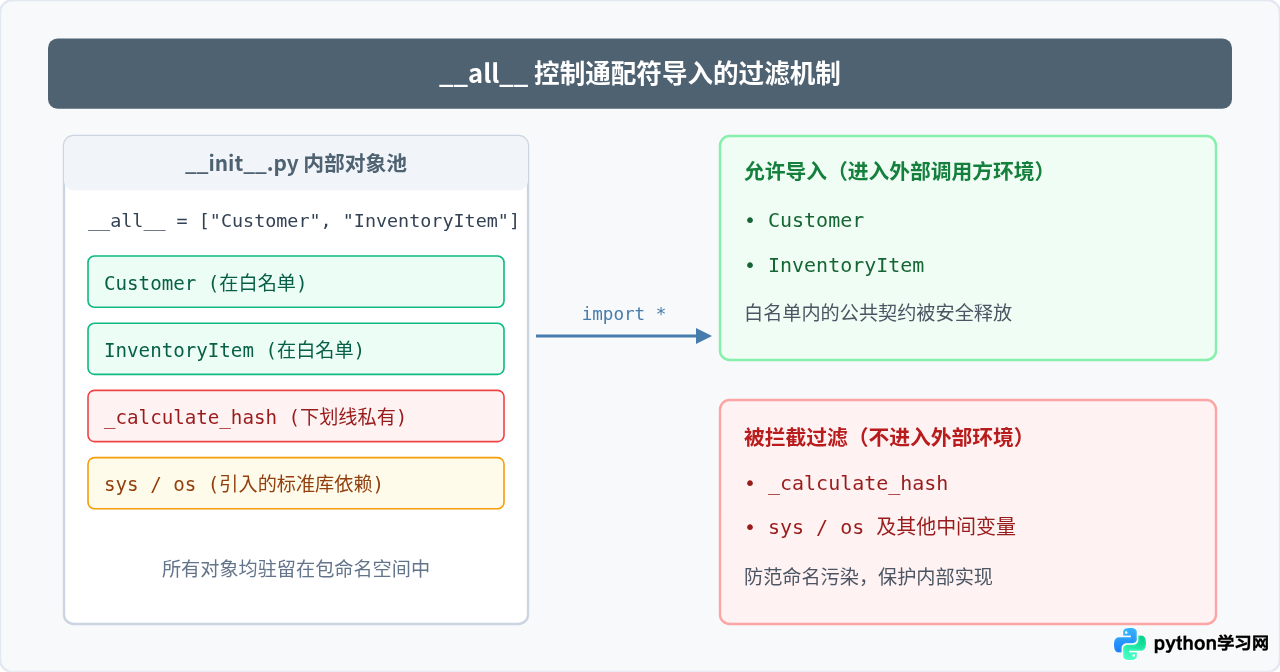
当开发者在 __init__.py 中书写 from .customer import Customer 时,不仅 Customer 类进入了当前包空间,如果在 __init__.py 中还导入了标准库(如 import sys、import os),这些辅助模块同样会挂在该命名空间下。
如果外部用户执行了通配符导入 from ecommerce import *,默认情况下,所有不以下划线开头的对象都会被一股脑导入调用方的当前命名空间,这极易引发命名冲突与变量污染。为了精确界定公共 API 边界,必须在 __init__.py 中显式声明 __all__ 列表。
__all__ 的实际工作机制
- 约束通配符导入:当外部使用
from pkg import *时,Python 严格仅导出__all__列表中列出的字符串名称。未在列表中的模块或类均不会被导入。 - IDE 与代码检查辅助:现代 IDE(如 PyCharm、VS Code Pylance)及 linter 工具(如 flake8、ruff)会根据
__all__来判断哪些未使用的导入是有意对外重导出的,从而避免报出F401 imported but unused警告。 - 文档生成依据:Sphinx 等主流文档工具会优先依据
__all__生成公开 API 页面。
# ecommerce/__init__.py 的规范写法
from .customer import Customer
from .inventory import InventoryItem

# 内部私有工具函数或辅助类(不加入 __all__)
def _calculate_internal_hash(val: str) -> str:
    return f"hash_{val}"

# 显式维护导出白名单
__all__ = [
    "Customer",
    "InventoryItem",
]
四、避坑指南与生产级最佳实践
1. 严禁在 __init__.py 中执行高耗时初始化逻辑
很多开发者容易将数据库连接池初始化、大模型权重加载或复杂网络请求直接写在 __init__.py 的全局作用域中。这是极坏的实践:只要任何子模块被导入,甚至只是运行测试框架收集测试用例时,__init__.py 都会被强制执行,造成项目启动缓慢、资源无谓消耗甚至单元测试无法脱机运行。
__init__.py 应当只做元数据声明、导入转发和轻量对象注册,耗时资源初始化应当封装在显式的 init_app() 或 setup() 函数中由调用方手动触发。
2. 防范子模块间的循环导入(Circular Import)
当包内层级较深时,极易发生循环引用。例如:__init__.py 导入了 customer.py 中的 Customer;而 customer.py 又因为需要获取包版本号或其他同级类,反向写了 from ecommerce import InventoryItem。在初次导入 ecommerce 时,ecommerce 尚未完成初始化,customer.py 尝试从 ecommerce 抓取属性便会抛出 ImportError: cannot import name 'InventoryItem' from partially initialized module 错误。
解决方法:包内子模块之间的相互引用,必须使用相对导入直接指向具体文件(如 from .inventory import InventoryItem),切勿通过包名从尚未加载完毕的父级 __init__.py 反向引用。
3. 超大型包的按需延迟加载(PEP 562)
对于非常庞大的 SDK 或算法库,如果一次性在 __init__.py 中导入成百上千个重量级类,会严重拖慢 CLI 工具等瞬时任务的响应。在 Python 3.7+ 中,可以在 __init__.py 中定义模块级 __getattr__ 函数,实现按需延迟导入:
# ecommerce/__init__.py 延迟导入示例
import importlib

__all__ = ["Customer", "HeavyReportingEngine"]

def __getattr__(name: str):
    if name == "Customer":
        module = importlib.import_module(".customer", __name__)
        return getattr(module, "Customer")
    elif name == "HeavyReportingEngine":
        module = importlib.import_module(".reporting", __name__)
        return getattr(module, "HeavyReportingEngine")
    raise AttributeError(f"module '{__name__}' has no attribute '{name}'")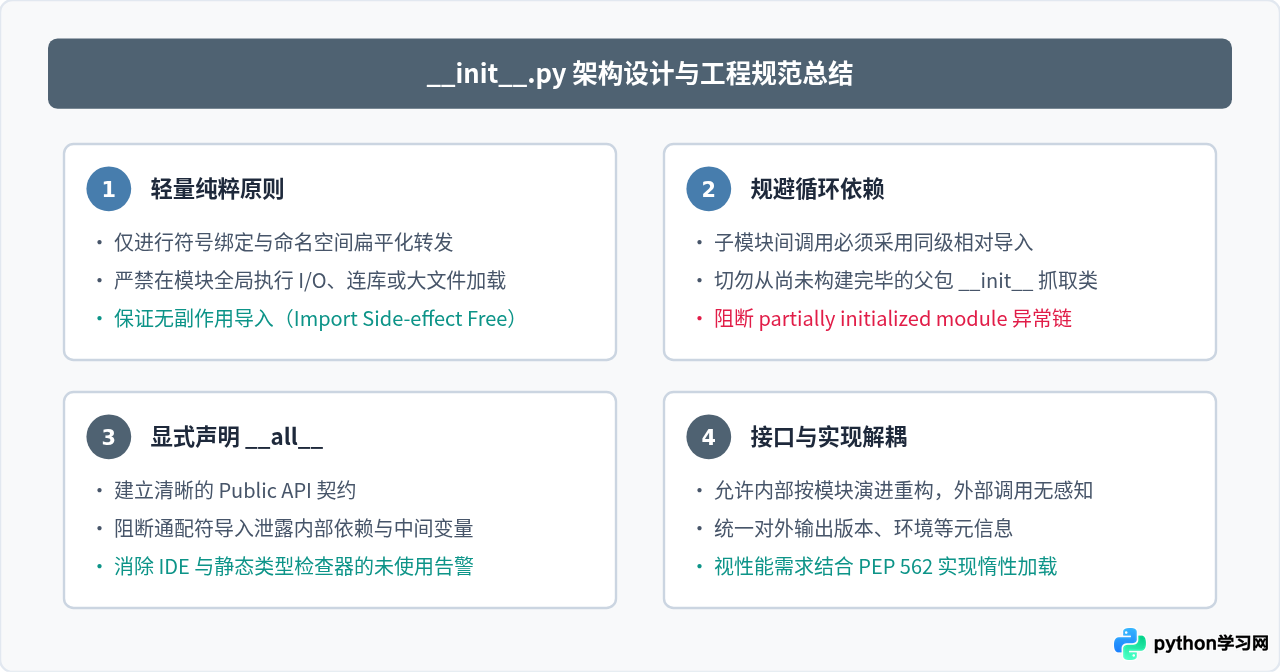
五、核心结论与对照速查
正确配置 __init__.py 是构建健壮、易用 Python 类库的关键基础。下表总结了常见的配置模式与适用场景:
| 配置模式 | 典型代码特征 | 主要收益 | 注意事项 |
|---|---|---|---|
| 空文件 | 仅声明包存在,无任何代码 | 兼容老版本包识别,逻辑绝对安全 | 调用方必须书写长路径,无法实现扁平化导入 |
| 相对导出转发 | from .sub import MyClass |
调用路径扁平化,隐藏内部文件层次 | 需警惕子模块间从父包倒流导入导致循环依赖 |
| __all__ 白名单 | __all__ = ["MyClass"] |
规范公共接口,防止命名污染与泄露 | 新增类需同步维护列表,避免遗漏导致无法导入 |
| 惰性动态载入 | def __getattr__(name): ... |
极大优化大型包的启动速度与内存占用 | 增加排查复杂度,需要 Python 3.7 及以上版本 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









