

Python用NumPy高效生成大规模随机数列表
深入解析如何在Python中利用NumPy现代API高效生成大规模随机数列表,从内存底层机制、接口选型、代码实现到分块流式策略进行全面剖析。
在 Python 研发与数据处理场景中,当需要生成百万甚至千万量级的大规模随机数时,如果直接使用 Python 标准库的 random 模块配合 for 循环或列表推导式,执行时间通常会达到数秒至数十秒,且会伴随严重的内存膨胀。解决这一性能瓶颈的核心路径是利用 NumPy 现代生成器 API(np.random.default_rng):通过 C 语言底层在连续物理内存中直接开辟紧凑数组,瞬间完成向量化随机数填充;如果下游代码严格要求 Python 原生 list 类型,再使用底层高度优化的 .tolist() 方法进行批量转换。本文将详细拆解该方案的底层机制、具体实现代码、内存控制策略以及常见误区。
一、为什么原生 Python 列表生成大规模随机数会变慢
很多初学者在需要大规模随机数列表时,习惯直接写出如下的列表推导式:
import random

# 原生推导式:生成 1000 万个随机浮点数列表
data_list = [random.random() for _ in range(10_000_000)]
这种写法在处理数千或数万个元素时十分直观,但在面对千万级数据时性能会急剧下降,主要原因包括以下三个层面:
- 解释器循环开销:每次迭代都需要通过 Python 虚拟机执行字节码、进行循环变量累加和函数调用解析。1000 万次迭代意味着 1000 万次完整的解释器层开销。
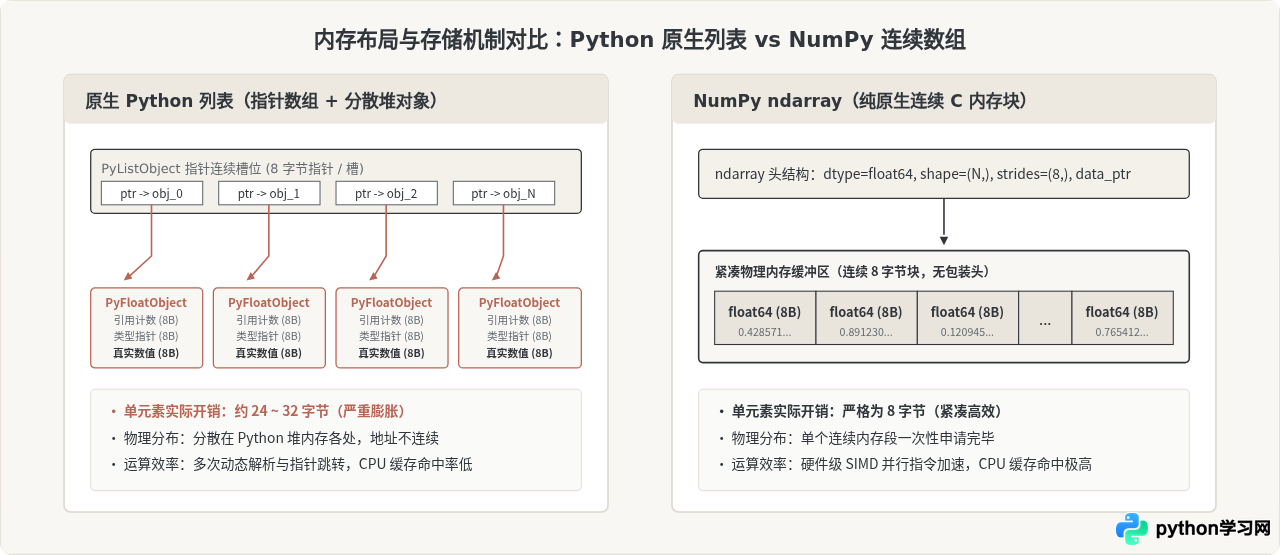
- 对象装箱与指针引用(Boxing Overhead):Python 原生列表本质上是一个“指针数组”,列表本身存储的仅仅是指向具体对象的内存地址。列表中的每一个浮点数都是一个完整的
PyFloatObject堆对象。在 64 位系统下,一个原生浮点对象不仅包含 8 字节的实际数值,还包含类型指针(8 字节)和引用计数(8 字节),再加上指针列表中存储的指针(8 字节),单个浮点数实际耗费 24 至 32 字节。 - CPU 缓存未命中(Cache Misses):由于 1000 万个浮点对象是在堆内存中分散动态分配的,内存物理地址不连续。当 CPU 试图预取数据时,频繁遭遇缓存未命中,严重拖慢后续遍历和处理速度。
二、NumPy 现代生成器 API:default_rng 最佳实践
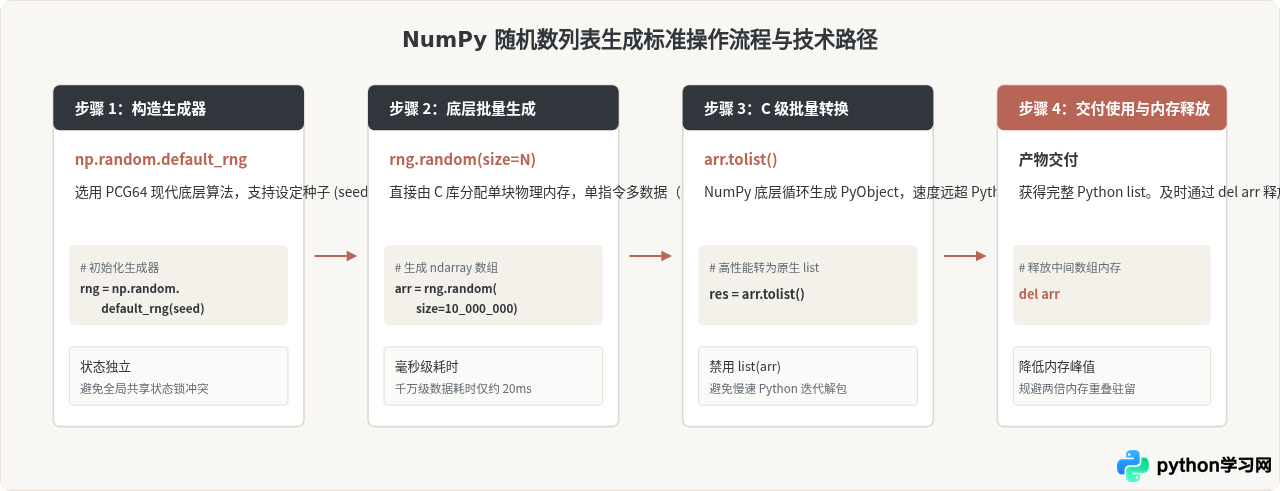
NumPy 在 1.17 版本中重构了随机数子系统,引入了全新的 Generator 架构,用于替代以往传统的 np.random.random() 或 np.random.randint() 等旧接口。现代 API 推荐始终通过 np.random.default_rng() 实例化独立的生成器对象。
技术演变说明:旧接口(Legacy Random)依赖全局隐式状态,底层采用 Mersenne Twister(MT19937)算法,在现代多线程并发及大样本统计质量上存在已知限制。现代 default_rng() 默认搭载 PCG64 基础生成器,统计随机性表现更好,且在 64 位平台上的生成吞吐量显著提高。
1. 常见分布的快速生成语法
现代生成器针对各类常用概率分布提供了统一的向量化参数 size:
import numpy as np

# 初始化推荐的随机数生成器(可指定种子以复现结果)
rng = np.random.default_rng(seed=42)

# 1. 均匀分布浮点数:区间 [0.0, 1.0),生成 1000 万个
arr_uniform = rng.random(size=10_000_000)

# 2. 离散整数:区间 [1, 100],端点闭合包含 100,生成 1000 万个
arr_int = rng.integers(low=1, high=101, size=10_000_000)

# 3. 正态分布浮点数:均值 0.0,标准差 1.0,生成 1000 万个
arr_normal = rng.normal(loc=0.0, scale=1.0, size=10_000_000)
三、从 NumPy 数组到 Python 原生列表:tolist() 转换与选型
生成 NumPy 数组后,如果业务下游接口仅支持原生列表(例如需送入标准库序列化工具、某些原生图算法库或特定 C 扩展),就需要将 ndarray 转为 list。这里存在两种转换途径:
- 推荐:
arr.tolist()—— 这是由 NumPy 底层用 C 语言编写的高性能转换方法。它能直接遍历连续内存,在底层批量构筑 Python 列表,避免了解释器层面的显式循环。 - 不推荐:
list(arr)—— 传入原生内置函数list()会在 Python 层触发迭代协议,导致每次迭代都通过 Python 接口解包一次元素,耗时通常是arr.tolist()的数倍。
2. 性能实测与方法对比
为了直观展现差异,我们在相同硬件环境(Python 3.10 / NumPy 1.24 / 64位系统)下测试生成 1000 万个 [0.0, 1.0) 浮点数的耗时与内存开销:
| 实现方式 | 生成 1,000 万浮点数耗时 | 内存占用峰值 | 产物类型 | 相对基准加速比 |
|---|---|---|---|---|
原生列表推导式 [random.random() for _ in range(N)] |
约 1.25 秒 | 约 380 MB | list |
基准 (1x) |
NumPy 纯生成 default_rng().random(N) |
约 0.022 秒 (22 ms) | 约 76 MB | ndarray |
56.8x |
NumPy 生成 + .tolist() 转换 |
约 0.28 秒 | 约 456 MB (含转换峰值) | list |
4.5x |
NumPy 生成 + list(arr) 迭代转换 |
约 1.10 秒 | 约 460 MB | list |
1.1x |
从实测数据可以得出明确结论:如果后续计算流程支持 NumPy 原生结构,强烈建议保持 ndarray 状态使用,不仅耗时缩短至百分之一,内存占用也仅有列表的五分之一;如果必须输出原生列表,default_rng().random(N).tolist() 依然比原生推导式快 4 倍以上,且比错误的 list(arr) 快将近 4 倍。
四、超大规模场景下的内存瓶颈与分块生成策略
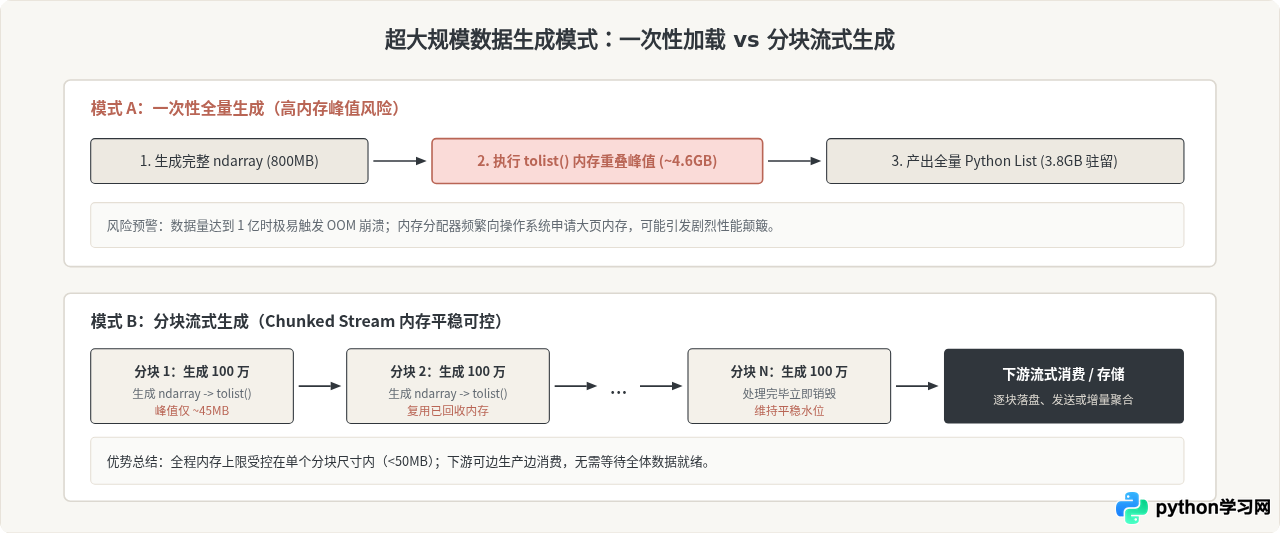
当生成规模进一步提升到 5000 万或 1 亿以上时,直接执行 arr.tolist() 会面临严重的内存峰值问题。在调用 .tolist() 的瞬间,内存中会同时存在完整的 NumPy 连续数组(1 亿个 float64 约 800 MB)和正在构建的原生 Python 列表(1 亿个 PyFloatObject 及指针约 3.8 GB),瞬间峰值接近 5 GB,普通开发机容易遭遇内存耗尽或触发系统交换区(Swap),导致系统卡顿。
针对超大规模随机数列表生成,最健壮的方案是分块生成(Chunking)或生成器流式产出(Streaming Generator)。
1. 分块流式生成的代码实现
通过 Python 的生成器函数(yield),可以非常优雅地实现分块生成:
import numpy as np

def generate_random_chunks(total_size: int, chunk_size: int = 1_000_000, seed: int = None):
    """
    分块生成大规模随机数列表的生成器。
    每轮生成一个大小为 chunk_size 的 Python list 并通过 yield 产出。
    """
    rng = np.random.default_rng(seed)
    generated = 0

    while generated < total_size:
        current_chunk = min(chunk_size, total_size - generated)
        # 底层快速生成并在 C 级别转为 Python list
        yield rng.random(size=current_chunk).tolist()
        generated += current_chunk

# 使用示例:流式消费 5000 万个随机数,峰值内存始终维持在几十兆字节
for chunk in generate_random_chunks(total_size=50_000_000, chunk_size=1_000_000, seed=2026):
    # 下游逐块消费(如写入数据库、发送网络套接字或增量统计)
    pass
2. 若必须聚合成单个全量 list 的拼装技巧
如果最终必须交付一个包含数千万元素的完整原生列表,且内存受限,不要使用 + 运算符反复拼接列表(每次拼接都会重新分配新列表并复制旧元素,导致 $O(N^2)$ 的灾难级开销)。应当在外部先创建大列表或者通过 list.extend() 方式追加:
def build_large_list_in_chunks(total_size: int, chunk_size: int = 1_000_000):
    rng = np.random.default_rng()
    result = []
    for _ in range(0, total_size, chunk_size):
        current_size = min(chunk_size, total_size - len(result))
        # 用 extend 避免重复分配多余的完整中间镜像
        result.extend(rng.random(size=current_size).tolist())
    return result
五、数据结构与方案选型总结
在面对“Python 生成大规模随机数”这一任务时,开发者需要结合具体业务上下游的需求,在**执行速度**、**内存占用**与**兼容性**之间做出明智的技术选型:
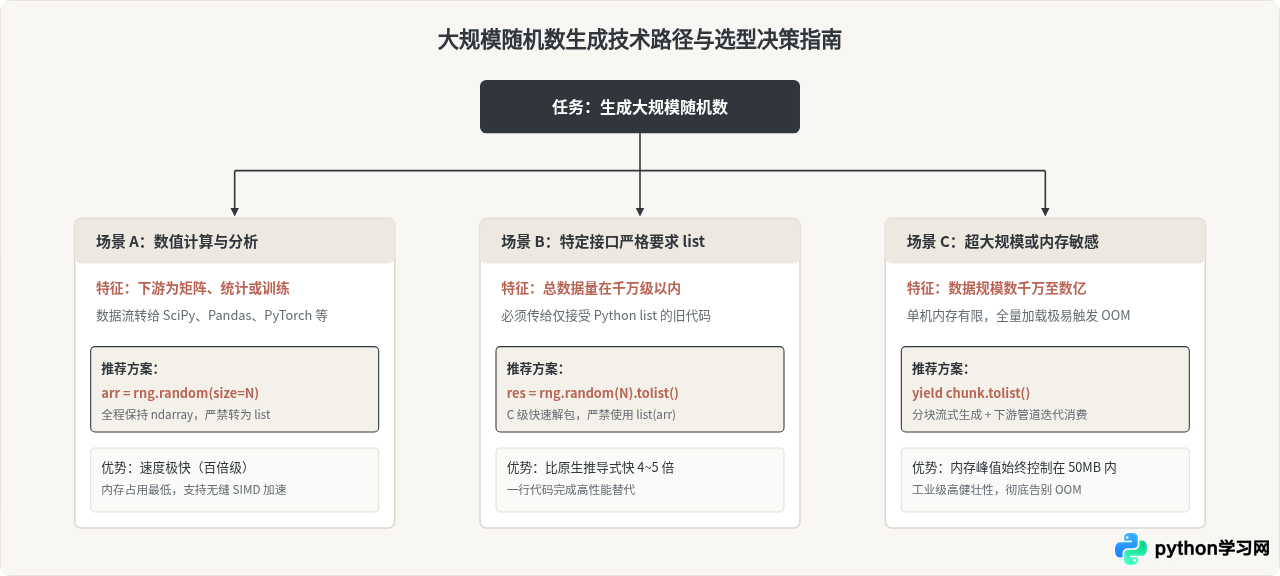
核心要点总结
- 弃用旧模块与慢推导:对于超过 10 万级别的随机数生成任务,坚决避免使用标准库
random配合循环或列表推导式。 - 拥抱现代 API:统一采用
np.random.default_rng()代替废弃的np.random.rand(),兼具优秀的统计随机质量与底层硬件加速。 - 转换方法务必用
.tolist():如果必须得到 Python 原生list,严格使用arr.tolist(),绝不要写成list(arr)。 - 留意双倍内存峰值:在千万级以上规模转换时,牢记
ndarray和list会短暂并存,必要时果断采用分块生成器进行流式解耦。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









