

Python遍历目录查找重复文件名的基础实现
详细讲解在Python中递归遍历目录查找重复文件名的基础实现方案,涵盖os.walk与pathlib两种核心实现、数据结构设计、代码示例及常见边界问题排查。
在日常文件整理、代码仓库重构或多磁盘归档检索时,相同的文档、图片或资源往往会散落在不同的子文件夹中。在 Python 中查找指定目录下重复文件名的基础解决思路十分明确:通过递归遍历指定目录下的所有文件,提取每个文件的纯文件名作为键(Key),并将文件的完整访问路径追加存入对应的列表(List)中;遍历结束后,筛选出路径列表长度大于 1 的项,即可输出所有发生重名的文件及其所在位置。
一、核心思路与数据结构设计
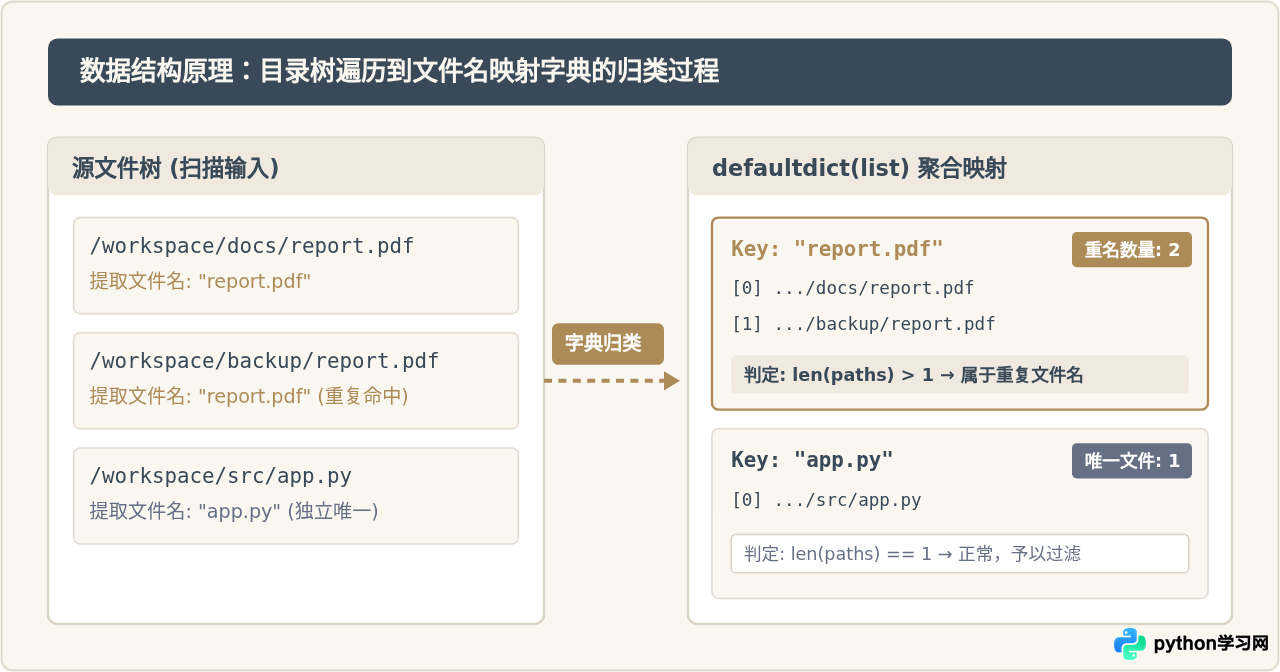
实现重复文件名检索的关键在于如何组织内存中的索引数据。如果在遍历时对每个文件都去与其他已扫描文件做全量对比,时间复杂度将达到 $O(N^2)$,在文件数量较多时会产生明显的卡顿。而利用哈希表(在 Python 中即 dict 字典)的键值映射特性,可以在平均 $O(1)$ 的时间复杂度内完成查找与路径归类,使得整套遍历流程的时间复杂度保持在 $O(N)$ 的线性水平。
在具体数据结构上,使用标准库 collections.defaultdict(list) 是最规范的选择。字典的键定义为文件名(例如 report.pdf),值则为记录该文件名出现过的所有路径列表。当某个键对应的列表长度大于 1 时,意味着该文件名在不同子路径下出现了多次,构成了文件名重复。
二、方案一:基于 os.walk 的基础代码实现
os.walk 是 Python 标准库中处理目录树递归遍历最成熟、最通用的底层接口。该函数接受一个起始目录路径,并以生成器形式逐层递归返回一个包含三个元素的三元组:(root, dirs, files)。其中 root 是当前正在扫描的文件夹路径,dirs 是当前文件夹下的子目录列表,而 files 则是当前文件夹包含的文件名列表。
我们只需针对 files 列表中的每个文件名,通过 os.path.join(root, file_name) 拼出其完整的绝对或规范化路径,并将其追加到对应的字典列表中。遍历完成后,通过字典推导式快速筛选出重复项。
import os
from collections import defaultdict

def find_duplicate_filenames_os_walk(target_dir):
    """
    使用 os.walk 遍历目录并查找所有重名文件
    :param target_dir: 待检索的目标目录绝对或相对路径
    :return: 仅包含重复文件名的字典 {文件名: [绝对路径1, 绝对路径2, ...]}
    """
    target_dir = os.path.abspath(target_dir)
    if not os.path.isdir(target_dir):
        raise ValueError(f"目标路径不是有效目录: {target_dir}")

    # 以文件名作为键,存储对应的全部路径列表
    name_to_paths = defaultdict(list)

    # 递归遍历目录树
    for root, _, files in os.walk(target_dir):
        for filename in files:
            full_path = os.path.join(root, filename)
            name_to_paths[filename].append(full_path)

    # 筛选出路径数大于 1 的重复项
    duplicates = {name: paths for name, paths in name_to_paths.items() if len(paths) > 1}
    return duplicates

if __name__ == "__main__":
    scan_path = "./test_directory"
    if os.path.exists(scan_path):
        results = find_duplicate_filenames_os_walk(scan_path)
        print(f"找到 {len(results)} 个重复文件名:")
        for name, paths in results.items():
            print(f"\n文件名: {name} (共 {len(paths)} 处重复)")
            for path in paths:
                print(f"  - {path}")
示例输出(仅用于展示格式):
找到 2 个重复文件名:

文件名: config.ini (共 2 处重复)
  - /data/workspace/config.ini
  - /data/workspace/backup/config.ini

文件名: logo.png (共 3 处重复)
  - /data/workspace/assets/logo.png
  - /data/workspace/static/img/logo.png
  - /data/workspace/temp/logo.png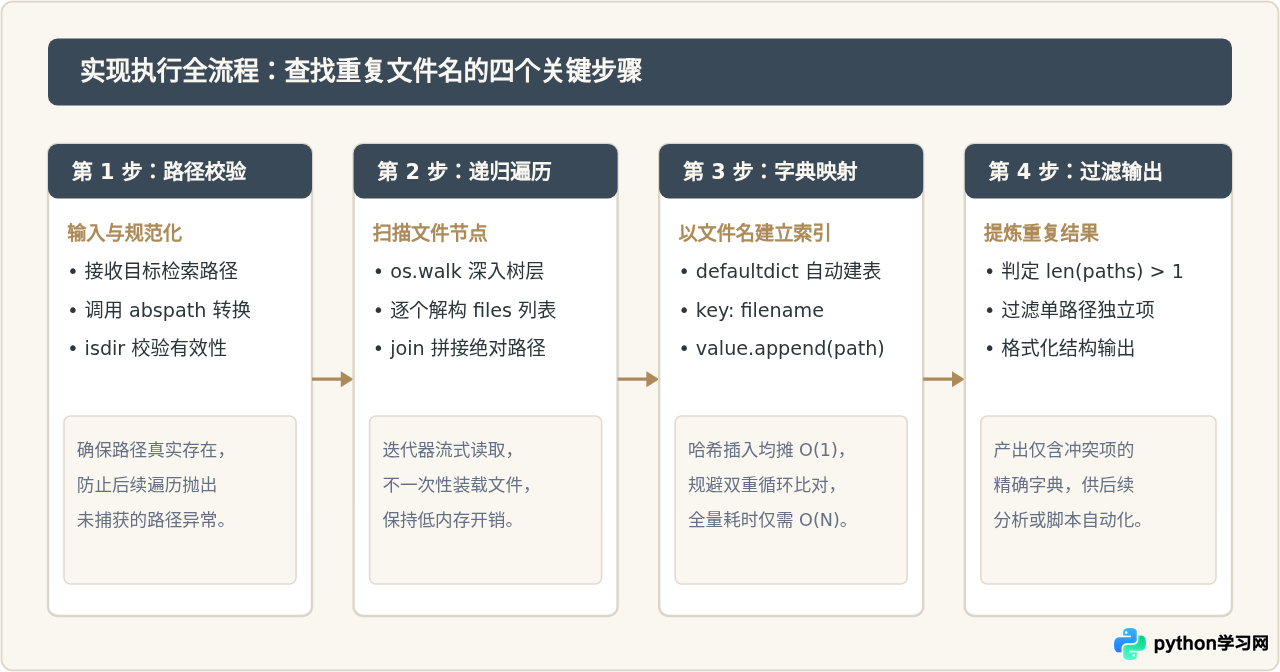
三、方案二:基于 pathlib 的面向对象实现
自 Python 3.4 引入 pathlib 模块后,面向对象的文件系统操作方式逐渐成为现代 Python 代码的首选。相较于 os.walk 返回的纯字符串元组,pathlib.Path 对象将路径操作(如解析后缀、判断是否为文件、取绝对路径等)全部封装为对象方法,代码表达更为简洁直观。
通过调用 Path.rglob('*') 方法,可以快速对目标路径下的全部子项进行递归匹配。需要特别注意的是,rglob('*') 会同时匹配子目录本身,因此在追加到聚合字典前,必须通过 item.is_file() 显式过滤掉目录,仅处理具体文件。
from pathlib import Path
from collections import defaultdict

def find_duplicate_filenames_pathlib(target_dir):
    """
    使用 pathlib.Path 递归查找目录下的重名文件
    :param target_dir: 目标检索目录路径
    :return: 包含重名文件及 Path 对象列表的字典
    """
    base_path = Path(target_dir).resolve()
    if not base_path.is_dir():
        raise NotADirectoryError(f"指定的路径不是有效目录: {base_path}")

    name_to_paths = defaultdict(list)

    # rglob('*') 递归匹配所有层级的文件和文件夹
    for item in base_path.rglob('*'):
        # 必须排除目录节点,仅收集文件
        if item.is_file():
            name_to_paths[item.name].append(item)

    # 过滤出重复文件
    return {name: paths for name, paths in name_to_paths.items() if len(paths) > 1}

if __name__ == "__main__":
    scan_dir = "./test_directory"
    target = Path(scan_dir)
    if target.exists():
        dups = find_duplicate_filenames_pathlib(target)
        for filename, paths in dups.items():
            print(f"文件名: {filename}")
            for p in paths:
                print(f"  -> {p.as_posix()}")
四、关键转折与常见边界条件排查
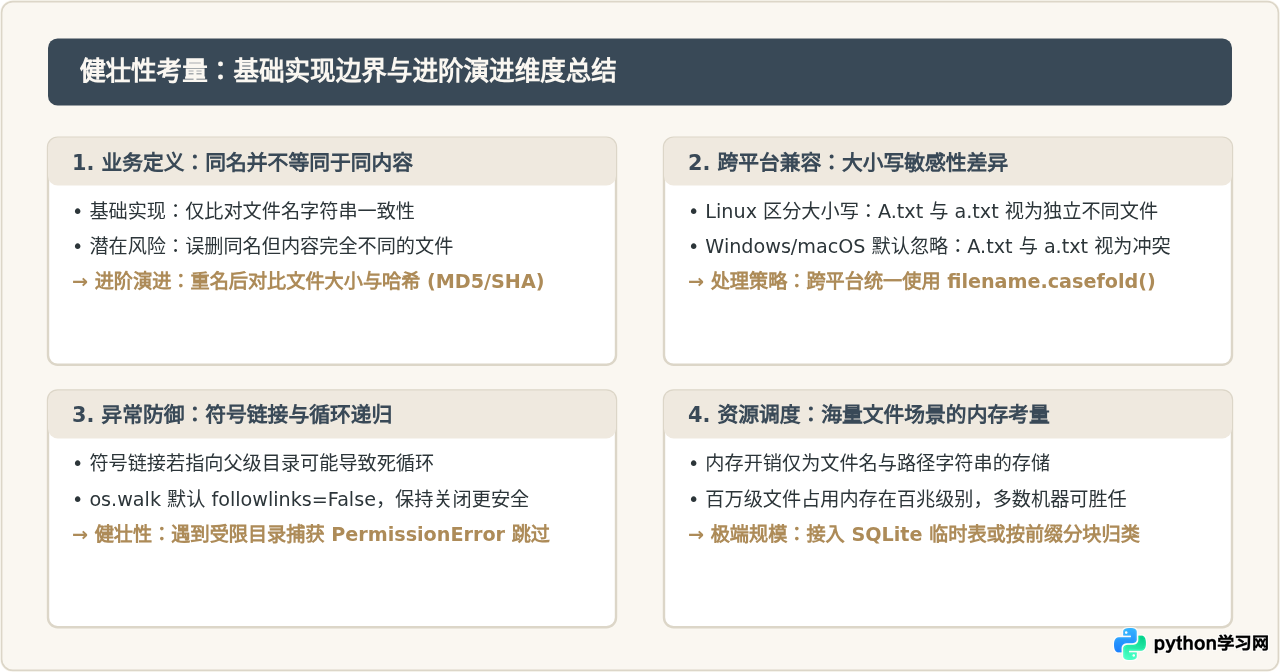
虽然基础实现的核心逻辑只有十几行,但在实际操作中,文件系统往往伴随特殊属性和复杂环境。若忽略这些边界条件,可能导致程序抛出异常、结果不准甚至陷入无限递归。
1. 重复“文件名”不等于重复“内容”
本文解决的核心问题是文件名重复(Name Collision)。两个文件即便完全同名,其内部存储的内容、版本或修改时间可能完全不同(例如两个独立的 __init__.py 或不同版本分支的 config.json)。在进行批量清理或删除前,若需要确认文件内容是否完全相同,通常需在查出重名后增加两步过滤:先对比文件字节大小(os.path.getsize),若大小一致再通过 hashlib.md5 或 sha256 进行内容哈希校验。
2. 文件系统的大小写敏感性(Case Sensitivity)
不同操作系统对文件名的处理存在显著差异:
- Linux:严格区分大小写,
photo.jpg与PHOTO.JPG是两个完全独立的物理文件。 - Windows / 默认 macOS:文件系统大小写保留但不敏感(Case-Preserving, Case-Insensitive),同目录下不能并存
photo.jpg与PHOTO.JPG。
如果希望在跨平台检索中把仅大小写不同的文件名也视作重复,可以在存入字典时统一调用 filename.casefold() 作为标准化的字典键,并在值中记录原始文件名与完整路径。
3. 符号链接(Symlinks)导致的递归死循环
在 Linux 或 macOS 系统中,目录之间可能存在软链接(Symbolic Links)。如果软链接指向了自身所在的祖先目录,递归遍历就会陷入死循环。os.walk 默认参数为 followlinks=False,即默认不跟进符号链接,能够安全规避死循环;如果手动改为 True,必须自行维护 visited_inodes 集合检测重复 inode。
4. 权限受限与异常跳过
当遍历系统级目录或包含权限保护的文件夹时,可能会触发 PermissionError。在 os.walk 中可以通过传入 onerror 参数指定错误处理回调函数(例如记录日志并忽略),确保单个目录的权限受限不会导致整个检索任务中断。
五、全文总结
通过 Python 查找目录下的重复文件名,本质上是一个“递归枚举 + 哈希聚合 + 条件筛选”的标准数据处理过程。两种基础实现方案的技术要点总结如下:
| 比对维度 | os.walk 实现方案 | pathlib.Path 实现方案 |
|---|---|---|
| 模块引入 | import os, collections.defaultdict |
from pathlib import Path, collections.defaultdict |
| 递归方法 | os.walk(target_dir) |
Path(target_dir).rglob('*') |
| 文件识别 | 遍历 files 列表(天然排除了目录) |
显式调用 item.is_file() 筛选 |
| 路径拼接 | os.path.join(root, filename) |
无需拼接,对象自带完整解析路径 |
| 时间复杂度 | $O(N)$,一次线性遍历 | $O(N)$,一次线性遍历 |
| 推荐使用场景 | 目录体量极大、系统资源紧张或追求最高速度的场景 | 追求代码简洁、现代化语义及后续需进行 Path 链式操作的脚本 |
掌握这套基础实现后,不仅可以迅速定位硬盘或工程目录下的重复命名资源,还能以此为基础轻松扩展大小比对、哈希校验或自动去重备份等更高级的文件管理功能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









