

Python常用内置函数速查表:print、len、range等
系统梳理Python常用核心内置函数,涵盖print、len、range、enumerate、zip、sum等高频工具的参数说明、底层机制、应用示例与避坑指南。
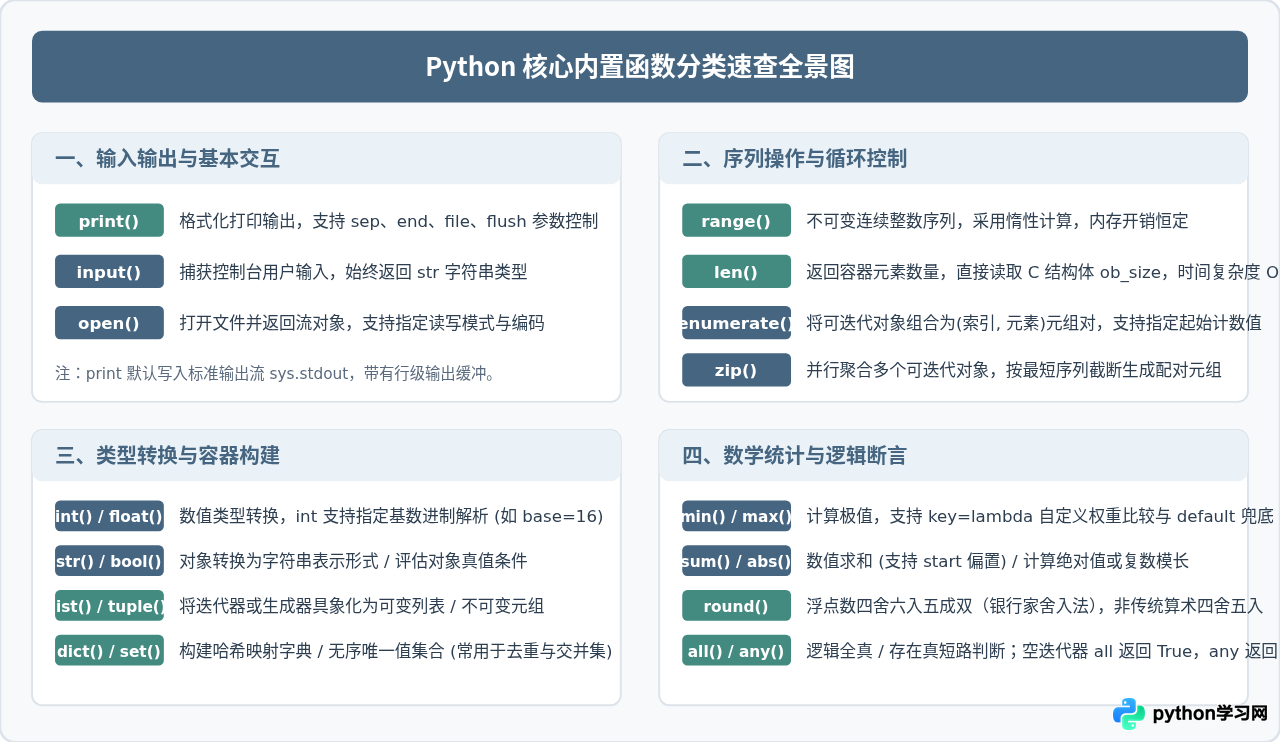
Python 在启动解释器时会自动加载 builtins 模块,提供数十个无需额外导入即可直接调用的内置函数(Built-in Functions)。这些函数经过底层 C 语言深度优化,构成了 Python 编写控制台交互、循环迭代、类型转换与基础运算的最核心构件。本文将常用内置函数归纳为输入输出、序列操作、类型构建、数学统计和逻辑筛选五大板块,系统梳理每个函数的调用签名、核心参数、底层工作机制以及高频易错点,帮助读者建立清晰、系统的内置函数知识网络。
一、输入输出与控制台交互:print 与 input
print() 和 input() 是 Python 程序的交互入口与信息输出管道。理解它们的参数配置与底层缓冲机制,是编写健壮脚本和调试代码的基础。
1. print() 函数签名与高级参数
print() 的完整定义为:print(*objects, sep=' ', end='\n', file=sys.stdout, flush=False)。多数开发者仅习惯传入位置参数,而忽略了关键字参数所提供的强大格式控制能力:
- sep(分隔符):默认值为单空格
' '。当打印多个对象时,解释器会自动在相邻对象之间插入该字符串。 - end(终止符):默认值为换行符
'\n'。将其替换为空字符串''或其他标记即可实现单行就地刷新或连续打印。 - file(目标文件流):默认为标准输出
sys.stdout。可以传入任意具有.write(string)方法的文件句柄,直接将内容重定向至磁盘文件或错误流sys.stderr。 - flush(强制刷盘):布尔值,默认
False。当为True时,立即强制刷新系统流缓冲区,无需等待填满或遇到换行符。这在实时进度条显示及长时间批处理监控中尤为关键。
import sys
import time

# 1. 自定义分隔符与行尾符号
print("2026", "10", "24", sep="-")
# 输出示例: 2026-10-24

# 2. 进度条单行就地刷新 (结合 \r、end 与 flush)
for step in range(1, 4):
    print(f"\r正在同步任务进度: [{step}/3]", end="", flush=True)
    time.sleep(0.1)
print("\n同步完成。")

# 3. 输出重定向到错误流
print("严重错误: 配置文件缺失", file=sys.stderr)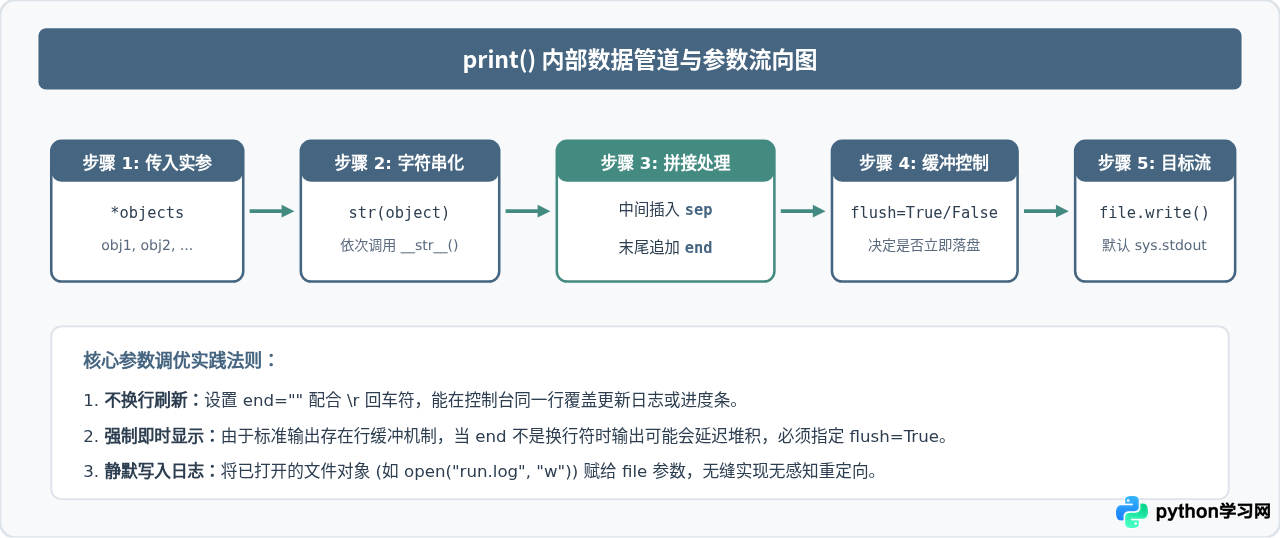
2. input() 函数的行为边界与数据转换
input([prompt]) 用于暂停程序执行并等待用户在终端键入内容。核心规则是:无论输入纯数字、布尔词还是 JSON 文本,input() 永远返回纯字符串 str。
如果后续需要进行数值运算或逻辑分支,必须紧接使用 int()、float() 或 json.loads() 进行显式转换。若未做类型转换直接与整型比较(例如 input() > 18),Python 3 会直接抛出 TypeError: '>' not supported between instances of 'str' and 'int'。
二、序列操作与循环控制:len、range、enumerate 与 zip
在 Python 核心语法中,遍历、计数和多序列协同处理几乎全部依赖这组内置工具。掌握它们的时间复杂度与内存特征,是写出高性能 Python 代码的关键。
1. len() 的底层 O(1) 机制
很多初学者误以为 len() 会从头到尾遍历集合并累加计数(O(n) 复杂度)。但在 CPython 实现中,对于内置类型(如 list、tuple、dict、set、str、bytes),其结构体头部均直接维护着表示元素总数的字段 ob_size。因此调用 len() 只是读取内存地址中的一个数字,其时间复杂度始终为稳定的 O(1)。
对于用户自定义类,len(instance) 会自动触发其 __len__() 魔法方法。如果自定义类返回负数或非整型,解释器将引发异常。
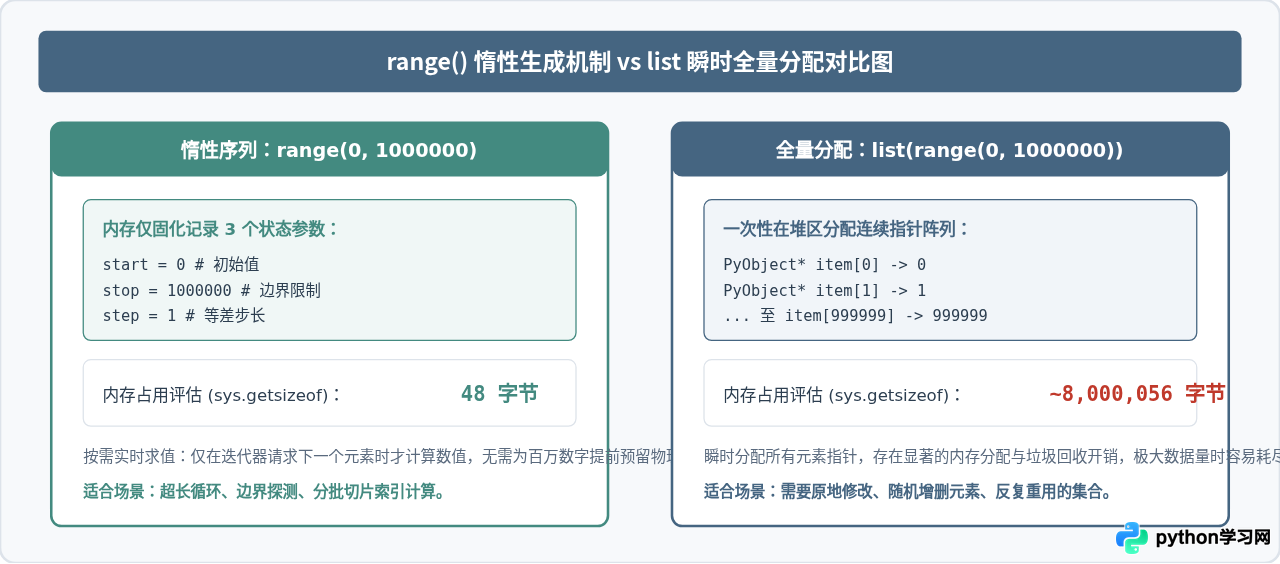
2. range() 的惰性计算与内存差异
range() 用于生成不可变的等差连续整数序列,具备三种调用形式:
range(stop):从 0 开始,到stop - 1为止,步长默认为 1。range(start, stop):从start开始,到stop - 1为止,步长默认为 1。range(start, stop, step):从start开始,步长为step,不包含stop。支持负步长实现逆向递减。
在 Python 3 中,range 对象是一个纯粹的惰性序列类(不可变序列)。它并不会在内存中真正实例化一个巨大的整数列表,而是仅保存 start、stop 和 step 三个属性值。无论设定的范围是 10 还是 10 亿,其占用的内存大小始终恒定为 48 字节。
3. enumerate() 与 zip():更优雅的高效循环
在遍历列表并需要同步记录索引序号时,避免使用 for i in range(len(arr)) 这种反模式,改用 enumerate(iterable, start=0) 能够直接生成 (index, item) 元组对,代码更具表达力且避免了多次下标寻址。
当需要并行遍历多个序列时,zip(*iterables) 会返回元素配对的迭代器。若各序列长度不一致,默认以最短序列为准自动截断;如需按最长序列填充对齐,可配合 itertools.zip_longest 使用。
fruits = ["苹果", "香蕉", "西瓜"]
prices = [8.5, 5.0, 3.2]

# 1. enumerate 优雅带序号遍历 (指定从 1 开始编号)
for index, fruit in enumerate(fruits, start=1):
    print(f"序号 {index}: {fruit}")

# 2. zip 多序列同步打包
for fruit, price in zip(fruits, prices):
    print(f"{fruit} 零售单价: {price} 元/斤")
三、高频内置函数全面速查清单
为了在实际开发中快速定位所需工具,下表汇总了 Python 最核心的内置函数,涵盖签名、主要作用及关键使用注意事项:
| 分类 | 函数签名 | 返回值类型 | 核心功能与参数说明 | 注意事项与避坑建议 |
|---|---|---|---|---|
| I/O 交互 | print(*obj, sep, end, file, flush) |
None | 将对象以字符串形式格式化输出到流目标 | flush 默认为 False,长循环打点应设为 True 避免缓冲积压 |
| I/O 交互 | input([prompt]) |
str | 从标准输入中读取一行并剥离行尾换行符 | 返回值始终为 str,数值计算必须先进行显式类型转换 |
| 序列计数 | len(s) |
int | 返回容器中的元素项数量或字符串字符数 | 时间复杂度为 O(1),直接读取 C 结构体中的 ob_size |
| 序列迭代 | range(start, stop[, step]) |
range | 生成不可变等差数字序列对象 | 采用惰性求值,内存恒定为 48 字节,避免盲目包裹 list() |
| 序列迭代 | enumerate(iterable, start=0) |
enumerate | 返回索引下标与元素组成的二元组迭代器 | 推荐用它替代手动维护 count 变量或 range(len(s)) 循环 |
| 序列迭代 | zip(*iterables) |
zip | 将多个序列同一位置的元素打包成元组 | 默认采用“短板效应”截断,对齐较长序列需用 zip_longest |
| 序列迭代 | reversed(seq) |
iterator | 返回反向遍历的迭代器对象 | 要求目标序列支持双向索引或实现 __reversed__() 方法 |
| 类型转换 | int(x, base=10) |
int | 将字符串或数字转换为整型,可指定进制 | 转换带小数点的字符串(如 "3.14")会抛异常,应先 float() |
| 类型转换 | float(x) |
float | 将字符串或整数转为双精度浮点数 | 支持识别 "inf"、"-inf" 与 "nan" 等特殊科学计数字符串 |
| 类型转换 | str(object='') |
str | 将目标对象转换为适合人眼阅读的字符串 | 优先调用对象的 __str__(),缺失时回退到 __repr__() |
| 类型转换 | list(iterable) / set(iterable) |
list / set | 将任意可迭代对象构筑为新列表或唯一集合 | set 用于去重极快,但会打乱原始数据项的顺序 |
| 数学聚合 | sum(iterable, start=0) |
int / float | 对可迭代序列中的数字元素求和 | 严禁用于拼接字符串(效率极低),字符串拼接请用 ''.join() |
| 数学聚合 | max(iterable, *[, key, default]) |
任意类型 | 提取序列中的最大值,支持自定义排序权重 | 当输入序列可能为空时,务必提供 default 参数以防抛出 ValueError |
| 数学聚合 | min(iterable, *[, key, default]) |
任意类型 | 提取序列中的最小值,支持 key 提取键 | 与 max 逻辑相同,可通过 key=lambda 指定按嵌套字段比较 |
| 数学聚合 | abs(x) |
int / float | 计算实数的绝对值或复数的模长 | 若传入复数对象(如 3+4j),将直接计算欧几里得距离 5.0 |
| 数学聚合 | round(number[, ndigits]) |
int / float | 对浮点数进行指定精度的舍入取整 | 遵循银行家舍入(四舍六入五成双),2.5 舍入为 2,3.5 舍入为 4 |
| 逻辑断言 | all(iterable) |
bool | 当序列中所有元素真值均为 True 时返回 True | 具有短路求值特性;当传入空序列时,返回值始终为 True |
| 逻辑断言 | any(iterable) |
bool | 序列中只要存在任意一个真值元素就返回 True | 具有短路求值特性;当传入空序列时,返回值始终为 False |
| 排序组织 | sorted(iterable, key, reverse) |
list | 对任意可迭代对象排序并返回全新列表 | 底层采用 Timsort 算法,原列表保持不变;对比 list.sort() 原地修改 |
四、内置函数综合实战:端到端数据清洗与统计流水线
在实际场景中,内置函数往往组合协作,构建精炼而高效的数据流处理链条。以下展示一个典型业务案例:从控制台接收一组未清洗的用户打分字符串,通过内置函数完成格式清理、类型校验、聚合汇总并格式化输出统计报告。
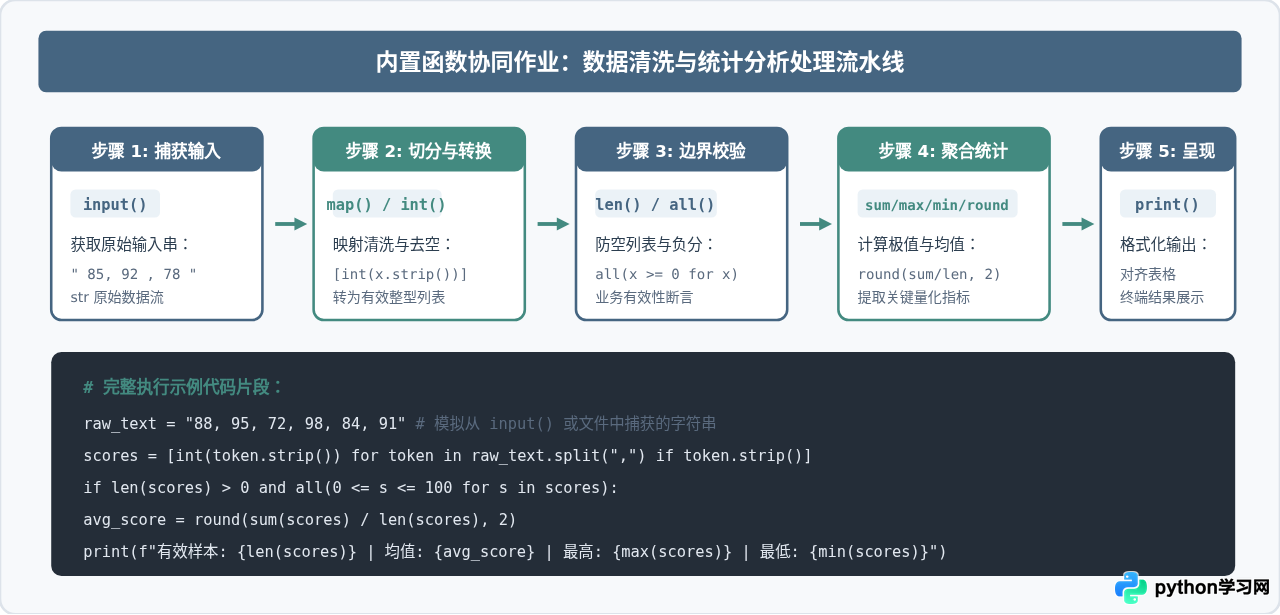
五、开发者高频踩坑与防御性编程指南
内置函数虽然简单,但在命名冲突、循环优化以及特殊算法语义上极易出现隐蔽的缺陷。以下是生产环境中三个最高频的典型陷阱及对应解决方案:
初学者常常为了方便,直接将变量命名为
list = [1, 2, 3]、str = "hello" 或 sum = 100。这种赋值会直接覆盖当前作用域内的内置函数符号,导致后续在同一模块中调用 list() 或 str() 时抛出 TypeError: 'list' object is not callable。修复方案:重命名变量(如
score_list、total_sum)。如果不慎在交互式环境中覆盖了内置函数,可通过 del list 将本地命名从当前命名空间中删除,从而恢复对 builtins.list 的访问。
虽然
len() 是 O(1) 复杂度,但在不可变循环内部反复计算相同对象的长度并无必要。而更严重的性能陷阱是利用 sum() 拼接字符串列表,如 sum(string_list, ""),这会导致二次方的字符串重新分配与拷贝(时间复杂度恶化为 O(n²))。修复方案:字符串拼接永远使用
"".join(string_list),它在底层会预先计算总字符长度并一次性分配内存,性能提升数个数量级。
很多开发者直觉上认为
round(2.5) 会得到 3。但在 Python 3 中,round() 遵循的是 IEEE 754 推荐的“银行家舍入法”(Round half to even,即“四舍六入五成双”):当待舍入小数恰好为 0.5 时,总是舍入到距离最近的偶数。因此:round(2.5) -> 2(2 是偶数)round(3.5) -> 4(4 是偶数)修复方案:如果财务金融或特定业务逻辑严格要求传统的“绝对四舍五入”(即逢 5 必进),应使用标准库
decimal 模块中的 Decimal.quantize() 配合 ROUND_HALF_UP 舍入模式。
结语
Python 内置函数是构建更高级数据结构与算法的基石。熟练掌握 print() 的输出流调度、range() 的惰性内存设计、len() 的直接内存寻址以及各个类型转换与数学统计函数的参数细节,能够让日常编写的代码更加简洁、运行效率更高。建议在日常编码中多查阅 Python 官方的内置函数清单,结合实际业务场景选择最适宜的内置工具。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









