

Python内置函数大全:按功能分类的完整清单与速查
全面系统的Python内置函数速查清单与使用指南,覆盖数学计算、类型转换、序列迭代、对象自省、文件IO与动态执行等全部分类,配详实代码示例与核心避坑要点。
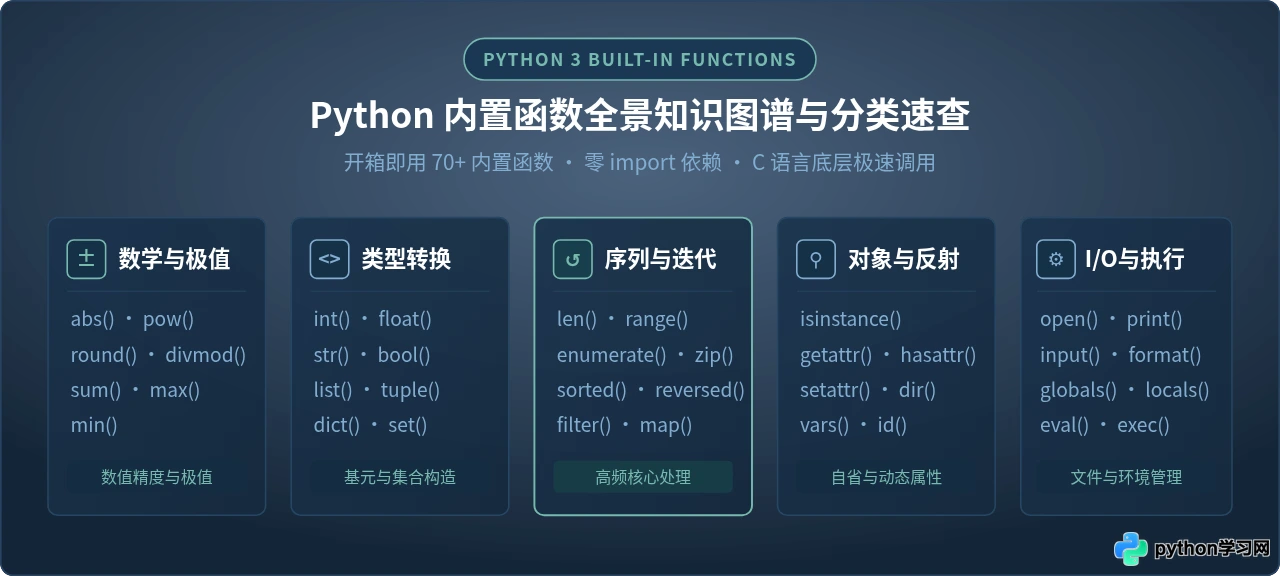
图 0:Python 官方内置函数全景知识图谱与核心功能域分布
在编写 Python 代码或审查已有项目时,很多开发者常会手写冗长逻辑去实现元素去重、多序列配对、类型校验或安全提取对象属性,却忽略了 Python 运行环境中开箱即用的内置函数(Built-in Functions)。Python 解释器在启动时会将 builtins 模块中的函数直接注入全局命名空间,调用时无需编写任何 import 语句,且底层主要由 C 语言原生实现,具备显著的速度优势。掌握这些函数的完整体系不仅能够减少重复造轮子,更能写出符合 Pythonic 规范的高效程序。本文将 Python 官方内置函数按功能划分为七大维度,提供系统清单、代码示例与进阶避坑说明,方便开发日常速查与选型参考。
一、数学运算与极值计算
数学计算类内置函数覆盖了基础绝对值、求商与余数、幂运算、浮点舍入以及集合元素求和与最值检索。此类函数性能经过底层高精度优化,远比自行在 Python 层遍历累加或比较更加快速。
| 函数原型 | 核心功能与参数说明 | 典型调用范式 |
|---|---|---|
abs(x) |
返回数值的绝对值;若入参为复数,则返回该复数的模长。 | abs(-5) # 5 |
divmod(a, b) |
同时计算商与余数,返回元组 (a // b, a % b)。非常适合用于分页逻辑计算与时间秒数换算。 |
divmod(100, 30) # (3, 10) |
pow(base, exp[, mod]) |
计算 base ** exp。若提供第三个参数 mod,则执行快速模幂运算 (base ** exp) % mod,效率远高于手动求模。 |
pow(2, 3) # 8 |
round(number[, ndigits]) |
对浮点数进行舍入保留 ndigits 位小数。注意其遵循“四舍六入五成双”(Banker's Rounding)原则。 |
round(2.5) # 2 |
sum(iterable[, start]) |
计算可迭代对象中所有数值元素的总和,可指定起始累加底数 start(默认为 0)。 |
sum([1, 2, 3], 10) # 16 |
min(iterable, *[, key, default])min(arg1, arg2, *args[, key]) |
求一个或多个参数中的最小值。支持自定义比较键函数 key 以及空序列兜底值 default。 |
min([], default=0) # 0 |
max(iterable, *[, key, default])max(arg1, arg2, *args[, key]) |
求一个或多个参数中的最大值。规则与 min() 对称。 |
max([12, 45, 9]) # 45 |
Python 3 的 round() 并非传统数学上的“四舍五入”,而是采用 IEEE 754 标准推荐的“偶数舍入”策略:当遇到末尾刚好为 5 时,舍入到最近的偶数(例如 round(2.5) == 2,而 round(3.5) == 4)。若业务要求严格的商业四舍五入,应使用标准库中的 decimal 模块。
二、数据类型转换与基础容器构造
Python 提供了丰富的内置类型构造器。它们既可以用于将现有对象显式转换为指定类型,也可以作为空容器或默认实例的初始化函数。理清标量数据与容器之间的转换拓扑,是编写整洁数据流的关键。
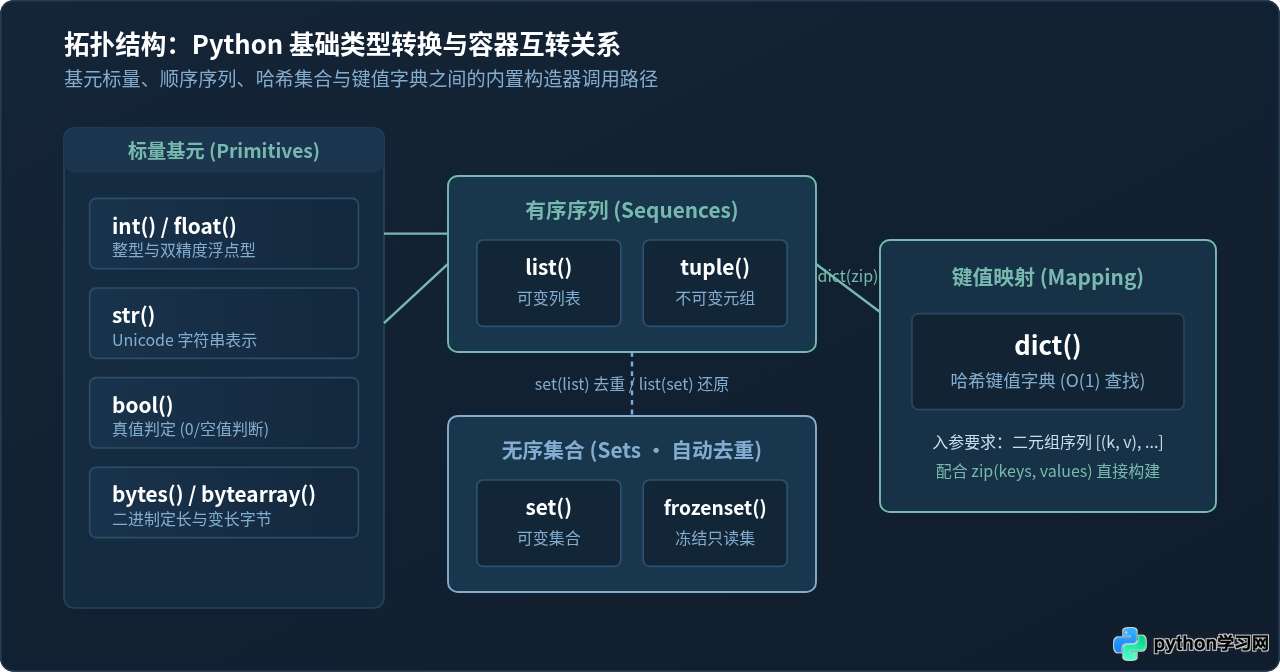
图 1:Python 基础数据类型与容器互转关系拓扑图
1. 标量基元与布尔型
int(x=0, base=10):将数字或字符串转为整数。支持指定进制基数(如int("1f", 16)输出 31)。float(x=0.0):将字符串或数值转为双精度浮点数,支持科学计数法字符串(如float("1e-3"))。complex(real=0, imag=0):构造复数对象(如complex(2, 3)得到(2+3j))。bool(x=False):根据 Python 官方真值测试规则判断真伪。注意:任何非空字符串转换后均为 True,例如bool("False")的返回值是True。str(object=''):将对象转化为适合人类阅读的 Unicode 字符串形式。
2. 序列、哈希集合与字典容器
list(iterable=()):由任意可迭代对象构建可变列表。常用作消耗迭代器并一次性缓存数据。tuple(iterable=()):构建不可变元组。常用于作为字典的复合键或不可变入参。set(iterable=()):构建无序且不重复的可变哈希集合。是实现集合求交(&)、并(|)、差(-)及高频去重的最佳选择。frozenset(iterable=()):构建不可变的冻结集合。因为不可变且具备哈希值,因此可以作为集合元素或字典的 Key。dict(**kwargs)/dict(mapping, **kwargs)/dict(iterable, **kwargs):构造键值字典。可直接接收二元组键值对列表或与zip联合使用。
3. 底层二进制缓冲区与类型根节点
bytes(source=b''):不可变二进制字节序列(如bytes([65, 66]) == b'AB')。bytearray(source=b''):可变二进制字节数组,支持原地切片与修改,适用于高性能网络通信与协议解析。memoryview(obj):创建共享底层内存的缓冲区切片视图,避免大数据块在大内存处理时产生冗余数据拷贝(零拷贝技术)。type(object):单参数时返回对象所属类型;三参数type(name, bases, dict)时可动态元编程创建类。object():Python 所有类的基类,生成一个没有任何属性的纯净空对象,常用于多线程加锁哨兵或单例占位符。
# 容器快速组装与去重实战
raw_tags = ["python", "ai", "web", "python", "backend", "ai"]
unique_tags = list(set(raw_tags))  # 快速去重(不保序)
print("去重标签:", unique_tags)

# 双序列对齐构建映射字典
field_keys = ["id", "username", "role"]
row_values = [1001, "dev_admin", "maintainer"]
user_record = dict(zip(field_keys, row_values))
print("用户记录:", user_record)
# 示例输出:用户记录: {'id': 1001, 'username': 'dev_admin', 'role': 'maintainer'}
三、序列操作与迭代流处理
序列和迭代是 Python 语言设计的核心精髓。熟练运用内置的迭代函数,能够以优雅、声明式的语法完成复杂的数据流转换,而无需深层嵌套的 for 循环与下标计数器。
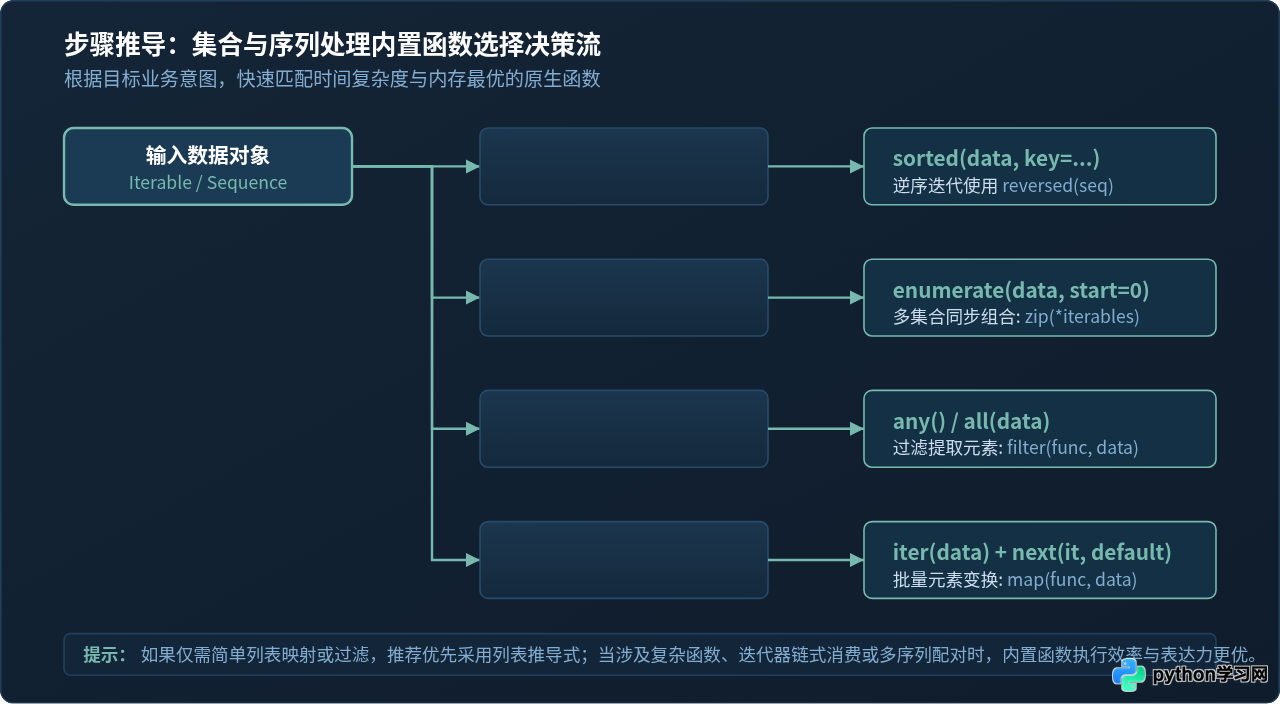
图 2:集合与序列处理内置函数选择决策流程图
| 函数原型 | 功能描述与关键特性 | 典型场景示例 |
|---|---|---|
len(s) |
返回对象的元素个数。内部直接读取 C 结构体中的 ob_size 字段,时间复杂度为 \(O(1)\)。 |
len([1, 2, 3]) # 3 |
range(stop)range(start, stop[, step]) |
生成不可变的等差整数序列。占用恒定的小内存,只在按需迭代时生成对应数值。 | list(range(0, 10, 2)) |
enumerate(iterable, start=0) |
将可迭代对象包装为生成 (index, item) 元组的枚举迭代器,彻底避免手写递增索引。 |
for i, v in enumerate(seq, 1): |
zip(*iterables, strict=False) |
并行聚合多个可迭代对象。在 Python 3.10+ 中推荐加入 strict=True,当长度不等时抛出 ValueError,防止静默丢弃尾部数据。 |
list(zip([1, 2], ['a', 'b'])) |
sorted(iterable, *, key=None, reverse=False) |
使用稳定的 Timsort 算法返回排序后的全新列表,原数据保持不变。 | sorted([-3, 1, -2], key=abs) |
reversed(seq) |
返回序列的反向迭代器。要求对象实现 __reversed__() 或具有索引与 __len__()。 |
for x in reversed([1, 2, 3]): |
filter(function, iterable) |
构造迭代器,仅保留使 function(item) 为真的元素。若函数为 None,则过滤掉所有假值。 |
list(filter(None, [0, 1, False, "ok"])) |
map(function, *iterables) |
对一个或多个输入序列逐项应用 function 并生成新值的惰性迭代器。 |
list(map(str.upper, ['a', 'b'])) |
all(iterable) |
判断所有元素是否均为真值。支持短路特性(遇到 False 即停)。注意:空可迭代对象返回 True。 | all([x > 0 for x in [1, 2, 3]]) |
any(iterable) |
只要有一个元素为真值即返回 True,同样具备短路特性。空可迭代对象返回 False。 |
any([False, 0, "has"]) |
iter(object[, sentinel]) |
获取迭代器。双参数形式时,会反复调用无参函数 object() 直到返回值等于哨兵值 sentinel。 |
iter(file_obj.readline, '') |
next(iterator[, default]) |
从迭代器中拉取下一项。若已无元素且提供了 default 则返回默认值,避免抛出 StopIteration。 |
val = next(it, None) |
slice(stop)slice(start, stop[, step]) |
创建切片对象,可用于在自定义类中统一提取或在多个序列中复用切片规则。 | s = slice(1, 4) |
aiter(async_iterable)anext(async_iterator[, default]) |
Python 3.10+ 新增的异步内置函数,用于提取异步迭代器与异步拉取下一项。 | item = await anext(async_it) |
四、对象自省与动态属性管理
自省(Introspection)是指程序在运行时探知对象的类型、状态、方法和属性的能力。Python 通过内置函数提供了完备的反射支持,这构成了众多主流框架(如 FastAPI、Django、Pytest)动态调度与依赖注入的基础。
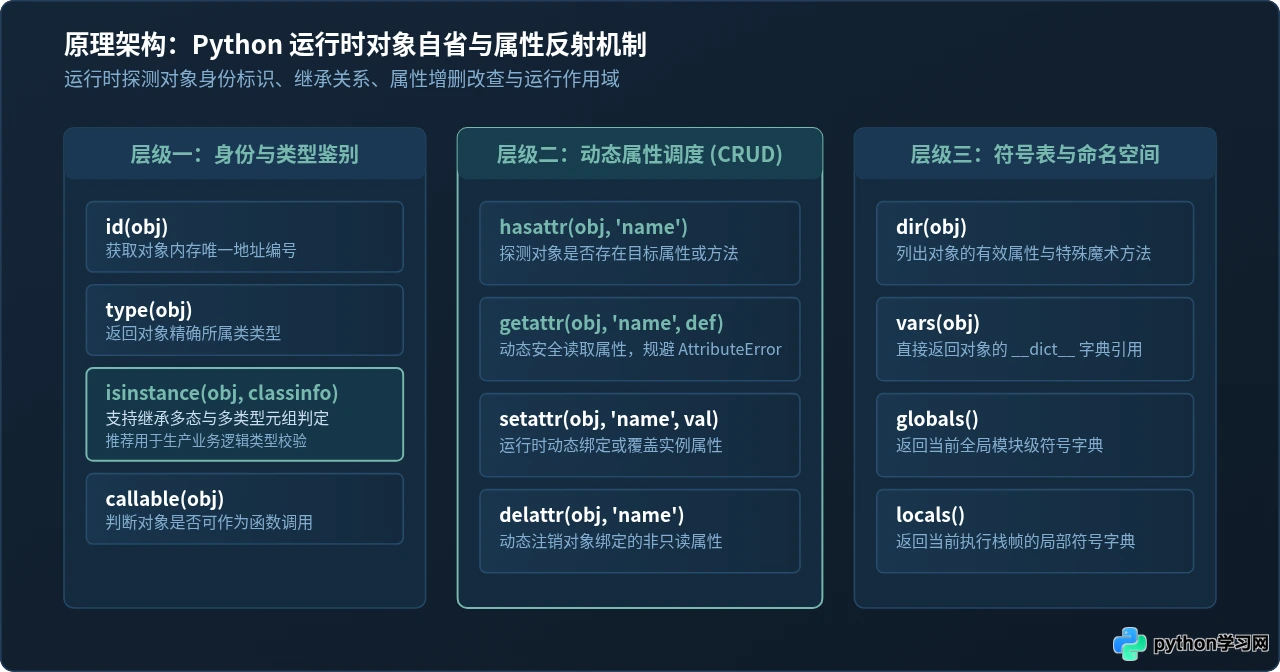
图 3:Python 运行时对象自省与属性反射机制三层架构
class ServiceEndpoint:
    def __init__(self, host: str, port: int):
        self.host = host
        self.port = port

    def run(self):
        return f"Listening on {self.host}:{self.port}"

# 实例化对象
endpoint = ServiceEndpoint("127.0.0.1", 8080)

# 1. 探测与反射检查
print("是否包含 run 属性:", hasattr(endpoint, "run"))  # True
print("对象是否可调用:", callable(getattr(endpoint, "run")))  # True

# 2. 安全读取与动态赋值
timeout_val = getattr(endpoint, "timeout", 30)  # 默认回退 30
setattr(endpoint, "timeout", timeout_val)
print("动态设置后的 timeout:", endpoint.timeout)  # 30

# 3. 类型判定对比
print("isinstance 判定:", isinstance(endpoint, ServiceEndpoint))  # True
print("type 直接对比:", type(endpoint) is ServiceEndpoint) # Truetype(obj) is ExpectedClass 仅做精确指针比对,无法识别派生子类;而 isinstance(obj, ExpectedClass) 支持面向对象的多态性,能够正确识别继承链上的所有子类。此外,isinstance 允许传入类型元组(如 isinstance(val, (int, float))),代码更为灵活健壮。
五、输入输出与环境交互
I/O 类内置函数负责与终端用户、外部文件系统以及内置帮助文档体系进行交互。合理利用参数能极大精简文本格式化与文件读写逻辑。
print(*objects, sep=' ', end=' ', file=sys.stdout, flush=False):格式化输出对象至文本流。通过指定sep可以改变元素间分隔符,指定file可以直接重定向输出到已打开的文件或日志句柄中。input([prompt]):挂起程序等待标准输入,读取一行内容并以去除末尾换行符的str形式返回。open(file, mode='r', buffering=-1, encoding=None, errors=None, newline=None, closefd=True):打开本地文件。强烈建议在读写文本文件时显式声明encoding='utf-8',规避跨平台(Windows / Linux)默认编码不一致引发的乱码崩溃。format(value[, format_spec]):格式化单项数据,是str.format()和 f-string 的底层调用基础(如format(1234.56, ",.1f")返回"1,234.6")。repr(object):返回面向开发者的规范字符串表示形式,通常尽可能满足eval(repr(obj)) == obj的约定。ascii(object):与repr()类似,但将非 ASCII 字符转义为\x、\u或\U序列。breakpoint(*args, **kws):Python 3.7+ 引入的标准断点函数。调用时默认调用sys.breakpointhook()唤起 PDB 调试器,可通过环境变量PYTHONBREAKPOINT全局开启或禁用。help([object]):唤起内置的交互式帮助系统或输出目标对象的详细 docstring 使用文档。
六、作用域、命名空间与动态执行
此类函数直接操作解释器的符号表与底层执行引擎。它们具有强大的表达力,但在生产系统中必须极其谨慎地使用,防止产生隐蔽的作用域副作用与代码执行漏洞。
| 函数名 | 功能原理与运行细节 | 使用边界与安全警告 |
|---|---|---|
globals() |
返回当前模块全局符号表的真实字典。在全局作用域修改此字典会直接影响全局变量。 | 适合用于框架中动态注册全局路由或查找已导入组件。 |
locals() |
返回当前局部作用域的符号字典。注意:在函数内部修改 locals() 字典不会改变局部变量本身(因为 CPython 局部变量优化为数组槽位存储)。 |
仅用于只读调试或模板参数上下文解包。 |
eval(expression[, globals[, locals]]) |
解析并求值单个 Python 表达式并返回计算结果。 | 严禁对不受信任的外部用户输入调用 eval,极易造成远程代码执行漏洞。纯数据解析优先使用 ast.literal_eval。 |
exec(object[, globals[, locals]]) |
动态执行任意合法的 Python 代码块或语句(无返回值)。 | 常用于插件载入器与动态代码编译器,必须配合受限的沙箱作用域字典使用。 |
compile(source, filename, mode) |
将源代码字符串预先编译为代码对象(Code Object),供后续多次调用 eval() 或 exec() 复用,大幅摊平语法解析耗时。 |
高频动态计算任务的核心优化手段。 |
__import__(name, ...) |
被 import 语句底层调用的原生钩子函数。在标准应用开发中,更推荐使用官方推荐的 importlib.import_module()。 |
底层实现定制加载器时使用。 |
七、面向对象与描述符辅助
这些内置函数属于 Python 面向对象高级特性的语法糖与底层构建原语,用于组织清晰的类继承与属性访问控制。
super([type[, object-or-type]]):返回代理对象,用于委托调用父类或兄弟类的实现方法。在 Python 3 中支持零参数调用super().method(),解释器会自动绑定当前类与当前实例,严格遵循方法解析顺序(MRO)。property(fget=None, fset=None, fdel=None, doc=None):将类方法包装为受控属性访问的描述符对象。通常以@property装饰器语法使用,实现只读字段、参数校验和动态计算。staticmethod(function):将函数声明为静态方法。静态方法脱离实例绑定,不隐式接收self或cls参数,逻辑上归属于该类的命名空间。classmethod(function):将函数声明为类方法,隐式接收当前类本身作为第一个参数cls,常用于定义工厂构造方法(Alternative Constructors)。
八、高频场景选型矩阵与综合速查
为帮助读者在实际业务开发中迅速定夺最佳函数,下表总结了高频开发场景中内置函数的选型对比与关键规避原则。
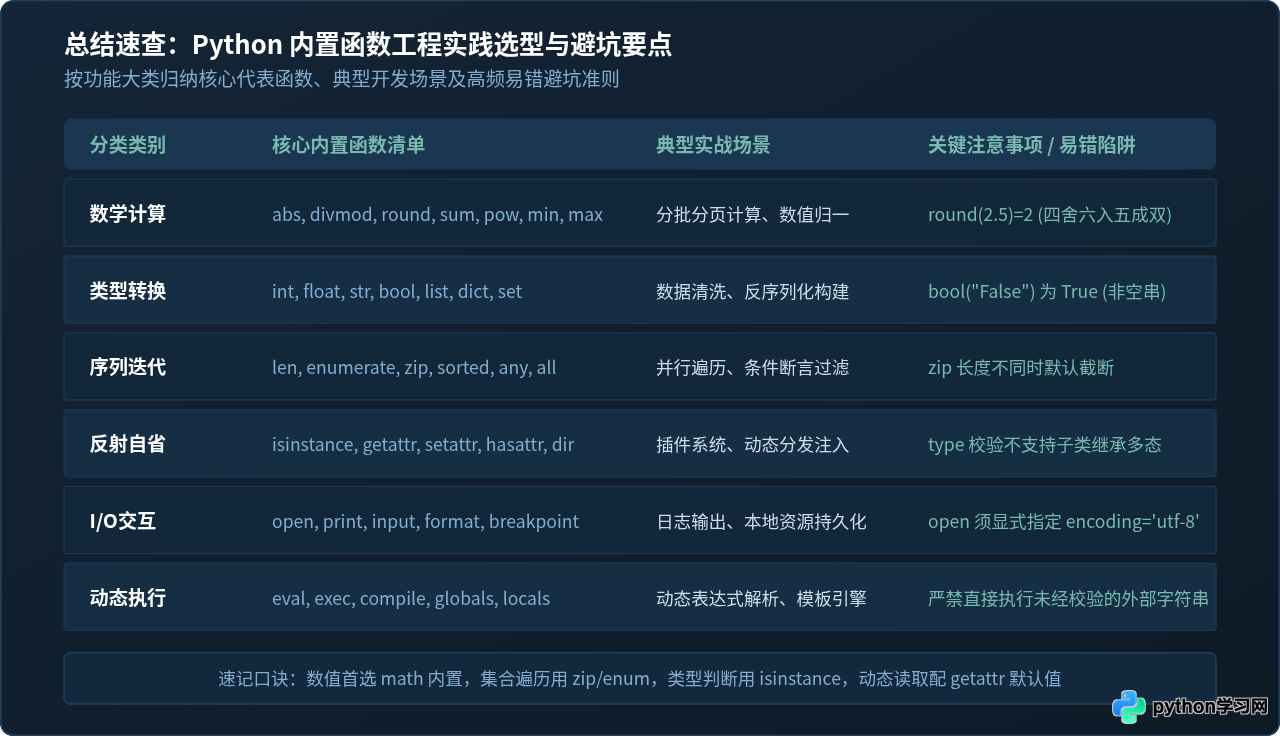
图 4:Python 内置函数工程实践选型与避坑要点速查图
Q1:什么时候用 sorted(),什么时候用列表自带的 .sort()?
list.sort() 是原地修改(In-place mutation),不占用额外内存空间,但仅适用于列表对象且返回值为 None;而 sorted() 可以接受任何可迭代对象(如元组、字典键、生成器),并返回全新的排序列,原数据不受任何影响。
Q2:为什么 all([]) 返回 True,而 any([]) 返回 False?
这是数学逻辑中的“空真”(Vacuous Truth)原则:all() 的语义是“不存在任何元素为假”,在空序列中自然没有假元素,故为 True;any() 的语义是“至少存在一个元素为真”,空序列无法满足该条件,故为 False。在编写动态断言时务必注意边界判定。
Q3:zip() 在两个列表长度不一致时会怎样?
默认情况下,zip() 采取短板原则,以最短的序列耗尽为准,静默截断较长序列的后续元素。如果在业务上要求数据严格成对匹配,请务必传入 strict=True(Python 3.10+)或使用 itertools.zip_longest 显式指定填充默认值。
Q4:id() 返回的地址在变量生命周期内一定唯一吗?
id() 仅保证在对象的生命周期重叠期间具备唯一性。一旦对象被垃圾回收(GC),其占用的内存地址可能被新创建的对象复用。因此不可将已经析构的对象 id 作为长期跨周期的全局唯一标识符。
总结而言,Python 内置函数是标准库皇冠上的明珠。在编写每一个循环、条件过滤或数据转换前,先对照本文的功能分类清单查看是否有原生内置函数能够胜任。善用这 70 余个内置原语,不仅能让你的代码更精简、可读性更高,更能直接享受到 CPython 底层 C 代码带来的极致运行效能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









