

为什么数据科学家偏爱Spyder而开发者首选PyCharm?
深入对比Spyder与PyCharm的设计定位、核心交互机制、工程能力及选型标准,解析为什么数据科学家偏爱Spyder而通用开发者首选PyCharm。
数据科学家偏爱Spyder,核心在于其交互式探索机制让数据状态“看得见、摸得着”;而通用软件开发者首选PyCharm,核心在于其强大的静态分析与工程化工具链能保障大型软件体系的严谨与可维护。工具偏好的分歧,本质上是两种截然不同的工作流心智模型的映射——前者以“快速假设与数据探查”为核心,后者以“稳健构建与系统交付”为目标。
一、两种心智模型:数据探索 vs 工程构建
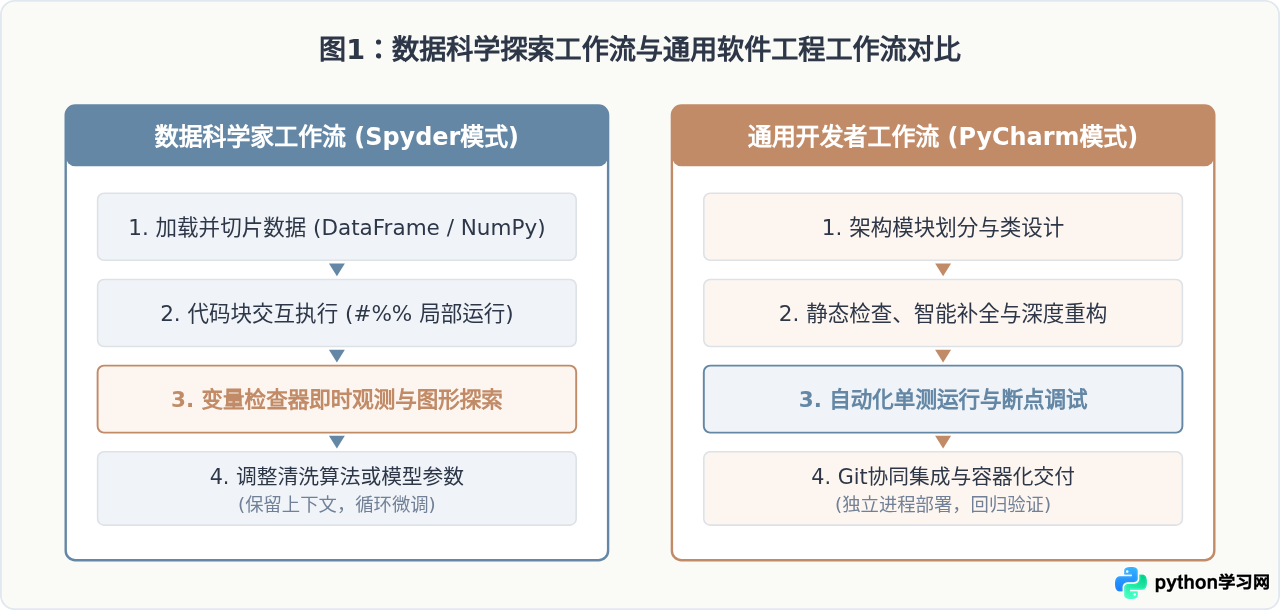
在讨论具体的IDE功能前,需要先看清两者在日常工作中处理代码时的根本差异。这种差异决定了开发者打开开发工具那一刻的预期焦点。
数据科学家的工作起点往往是一堆不确定质量的原始数据。在建模之前,必须反复探索分布规律、排查异常值、调整特征转换逻辑。在这个阶段,写代码的目的不是为了交付一个永续运行的服务,而是为了即时获取计算结果并形成判断。这就要求工具能随时驻留内存环境,让变量和多维矩阵随时可供翻阅,代码可以按块(cell)局部重跑,无需每次从头初始化。
软件工程开发者的任务完全不同。通用开发者通常需要构建高内聚、低耦合的应用模块,定义清晰的类接口与异常处理,并协调成百上千个源文件。代码一旦编写完成,主要通过自动化测试套件与持续集成流程进行回归,直接依赖交互环境查看中间变量反而是工程规范上的反模式。开发者最需要的是全局符号索引、严密的重构支持、类型推导检查以及对版本控制与容器环境的深度把控。
二、为什么Spyder深度契合数据科学家?
许多数据科学家是从MATLAB、RStudio或统计分析背景迁移到Python生态的。Spyder的设计从一开始就完整沿袭了这套直观的界面范式:左侧编辑区、右上方变量与图形窗格、右下方交互式IPython终端。
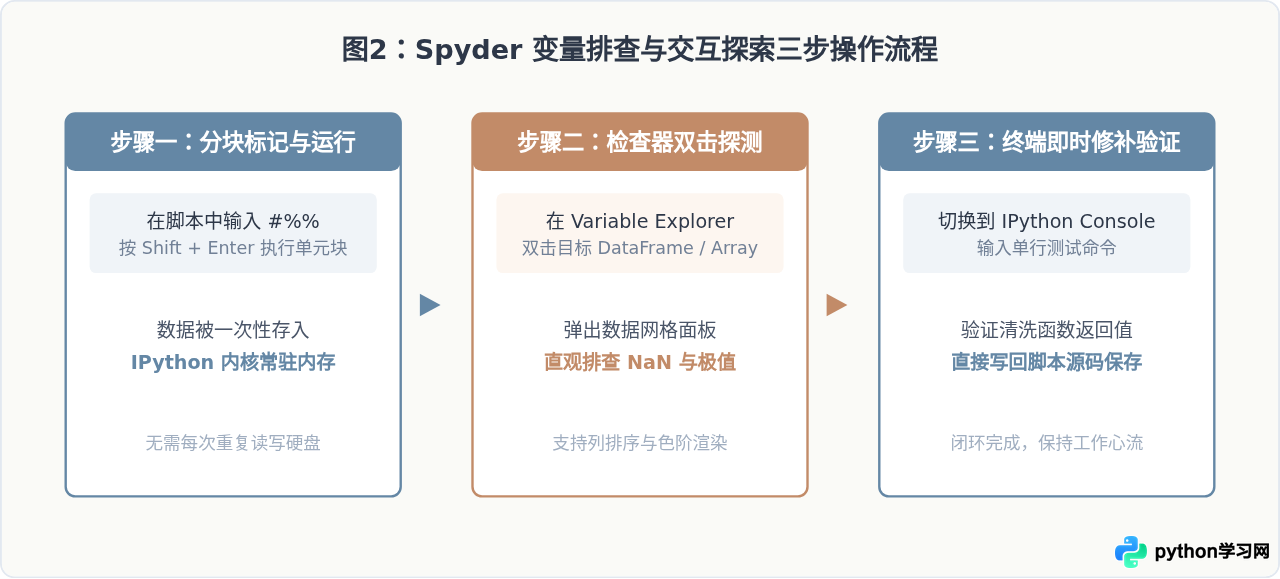
1. 变量检查器(Variable Explorer)的物理级可观测性
在普通文本编辑器中,如果开发者想知道一个经过三步清洗后的 Pandas DataFrame 结构如何,通常需要反复调用 print(df.head())、print(df.info()) 或 print(df.describe())。这种方式不仅打断代码逻辑,而且在面对成千上万行数据时输出极为局限。
Spyder 的变量检查器会常驻在界面侧边。一旦代码执行,内存中的所有变量(数字、字符串、Series、DataFrame、NumPy Array、字典)都会以表格形式罗列。点击任意 DataFrame,即可直接唤起类似 Excel 的可视化查看面板,不仅支持按列排序、数值筛选,甚至能用颜色深浅直接展示矩阵数值的梯度分布。
[:, :, 0])查看具体平面的数值投影,极大减轻了计算机视觉与物理建模调试时的心理负担。
2. 代码分块与交互式执行(Cell Execution)
在 Spyder 中,只需在注释中写下 #%%,即可将代码划分为可独立运行的单元格(Cell)。开发者通过快捷键 Shift + Enter 就能仅执行当前高亮的这一小块逻辑。
# 示例:Spyder 中的典型交互式数据处理块
import pandas as pd
import numpy as np

#%% 数据加载与初始观测
raw_data = pd.DataFrame({
    'user_id': range(1001, 1006),
    'score': [88.5, np.nan, 92.0, 75.5, 60.0],
    'department': ['IT', 'HR', 'IT', 'Sales', 'HR']
})

#%% 异常值填充与聚合(在Spyder中可单独反复执行本块,无需重新加载数据)
cleaned_data = raw_data.copy()
cleaned_data['score'] = cleaned_data['score'].fillna(cleaned_data['score'].mean())
summary = cleaned_data.groupby('department')['score'].mean()
当加载的数据集体量超过数个GB时,重新启动一次Python脚本可能耗时数分钟。通过分块执行,数据加载一次后始终驻留在内存,分析师可以反复对清洗与统计模块进行实验修改,大幅提升探索迭代效率。
三、为什么PyCharm是通用开发者的工业级利器?
当项目从“个人数据探索”演变到“生产系统开发”时,关注的重心从“数据看起来对不对”变成了“代码组织是否稳健、各模块契约是否满足、多人协作是否安全”。在这个维度上,PyCharm 展现出了难以替代的工业级工程能力。
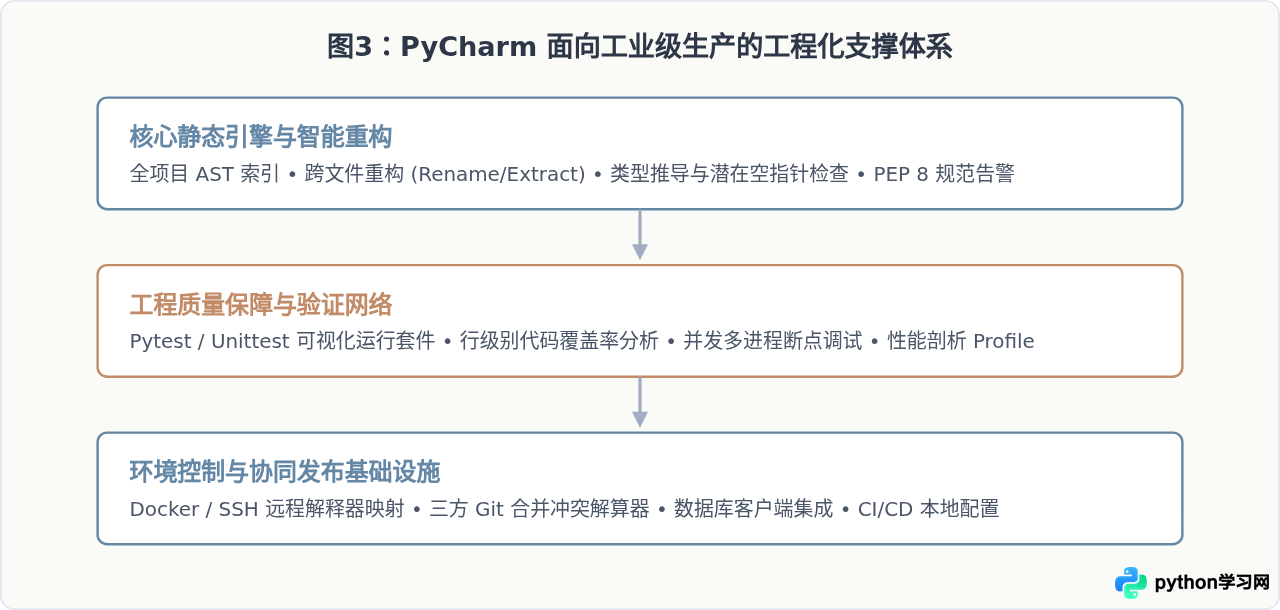
1. 抽象语法树(AST)级别的深层静态分析
PyCharm 在后台维护着庞大而精确的项目索引。即使在没有给 Python 代码添加完全类型注解的情况下,它的类型推导引擎也能分析函数参数在上下游所有被调用的上下文,从而指出潜在的 AttributeError、未闭合的资源句柄或未使用的全局引用。
更重要的是跨文件的重命名(Refactor -> Rename)与函数提取。当开发者修改一个核心类名或公共接口签名时,PyCharm 能在整个项目(包括单元测试文件、配置文件、字符串文档引用)中安全同步更新,并给出改动影响树供开发者逐一审核。这种可靠性对于几万行甚至几十万行代码的软件项目至关重要。
2. 严密的软件交付工具链整合
软件开发者需要处理的远不止 Python 语法本身:
- 环境一致性:原生集成 Poetry、Pipenv、Conda 以及 Docker Remote Interpreter。开发者可以在本地 IDE 中直接使用部署在远程服务器或 Docker 容器内的环境进行单步调试。
- 测试体系集成:原生提供针对 pytest、unittest 的可视运行器,支持点击函数左侧箭头单独跑某一个用例、自动计算代码测试覆盖率(Coverage),并高亮标出漏测分支。
- 复杂版本协同:PyCharm 内置了被公认为业界顶级的三路分支合并(3-Way Merge)冲突解决器,极大降低了团队多人协作时合并代码的失误风险。
四、核心特性横向对比与技术开销
选择哪款工具并不是“非黑即白”的优劣评判,而是收益与系统开销的权衡:
| 对比维度 | Spyder | PyCharm (Professional/Community) |
|---|---|---|
| 初始上手与生态 | 随 Anaconda 一键安装即用,开箱自带科学计算库与轻量环境。 | 需要建立工程概念,配置解释器与虚拟环境,配置项繁多。 |
| 变量与数据洞察 | 深度内建,提供类似 Excel 的 DataFrame/NumPy 检查面板与绘图输出。 | 社区版较弱;专业版提供 SciView 工具窗,但对系统内存要求较高。 |
| 代码重构与分析 | 基础语言服务器(LSP)提示,跨模块重构能力有限。 | 行业顶尖的 AST 语法分析,支持深层跨文件批量重命名、方法抽取。 |
| 测试与持续集成 | 主要依靠控制台脚本与手动调用,工程化测试套件集成度低。 | 原生支持完整单测运行、测试失败追溯树、代码覆盖率统计。 |
| 资源占用与启动 | Python+PyQt 开发,启动快,日常内存占用通常在数百 MB 内。 | 基于 IntelliJ 平台(JVM),大项目初次建立索引耗 CPU,常驻内存 1.5GB+。 |
五、选型决策指南与协同演进方案
在实际团队或个人技术栈中,如何明智地在两者之间做选择?可以通过项目当前所处的生命周期阶段与核心目标进行决断:
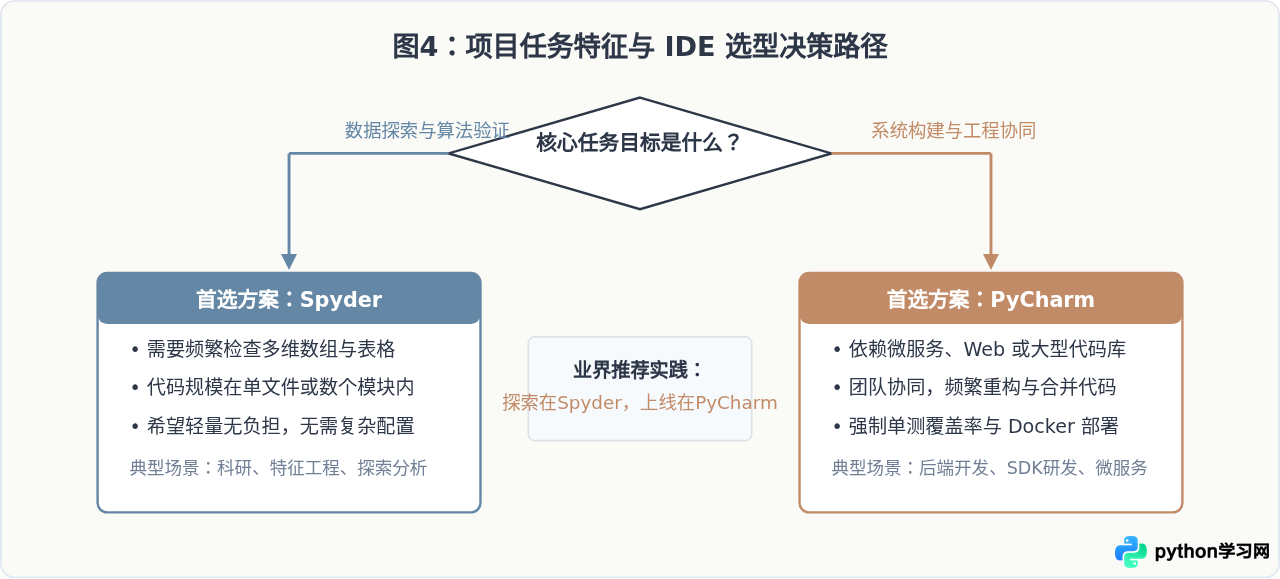
现代工业界的协同演进范式
在成熟的数字化团队中,很多数据科学家与算法工程师采取“阶段性切换工具”的模式:
- 阶段一:探索与实验(使用 Spyder 或 Jupyter):在前期清洗数据、验证特征有效性、调整损失函数时,保持高频交互,借助 Spyder 快速得出业务结论。
- 阶段二:工程化封装与上线(切换至 PyCharm):当模型结构确立后,需要将其打包为标准化推理模块或微服务 API。此时打开 PyCharm,将散落的代码块重构为标准的类与函数,编写自动化测试用例,配置 Docker 运行环境,并通过 Git 提交至持续集成流水线中。
综上所述,Spyder 满足的是“理解数据”的速度,PyCharm 保障的是“交付软件”的质量。看清两者的设计靶心,就能根据当前代码所承载的任务阶段,选出最高效的开发利器。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









