

使用SQLAlchemy ORM简化Python对MySQL的增删改查操作
深入讲解如何使用 SQLAlchemy 2.0 ORM 简化 Python 对 MySQL 数据库的增删改查(CRUD)操作。涵盖模型定义、连接池与会话管理、数据状态流转机制及生产避坑实践。
一、ORM 解决的核心痛点与架构模型
直接编写原生 SQL 字符串最让人困扰的问题在于“业务对象与关系表结构的割裂”。例如,在插入或查询一条记录时,开发者必须在 Python 的字典或元组中逐一匹配数据库列索引,代码缺乏类型提示,一旦数据库表增加或重命名字段,就必须在散落各处的 SQL 语句中排查变更。如果拼接变量时不慎疏漏了参数化格式化,还极易引发严重的 SQL 注入漏洞。
SQLAlchemy ORM 通过分层架构解决了这一矛盾。在上层,它提供声明式类定义与会话上下文;在下层,它内置了针对 MySQL 的特定 SQL 表达式编译器与 QueuePool 连接池,通过 PyMySQL 等驱动与 MySQL 服务器稳定通信。
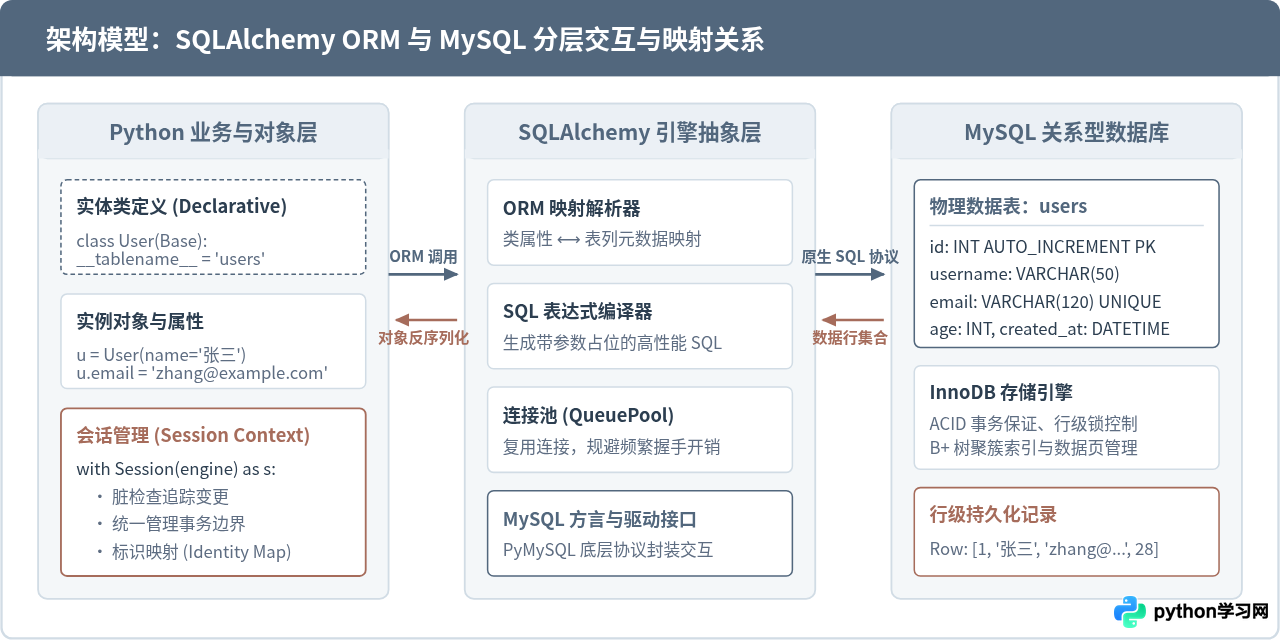
如图 1 所示,开发者在业务逻辑中只需与高层的 Python 对象及 Session 会话交互:
- 类与表的映射(Class to Table): Python 数据模型类对应 MySQL 中的物理数据表,类中的属性对应表中的字段名与约束条件。
- 实例与数据行的映射(Instance to Row): 每一个由模型实例化生成的 Python 对象,对应数据表中的具体一行持久化记录。
- 表达式编译与驱动协议: ORM 运行时接收到对象的增删改查操作后,由底层的 SQL 编译器生成严格带参数占位符的 MySQL 原生 SQL,再交由 PyMySQL 驱动执行,从源头保证了执行效率与安全性。
二、环境准备与数据库引擎配置
在开始编码之前,需要确保 Python 环境中已安装 SQLAlchemy 以及与 MySQL 通信所需的底层 DBAPI 驱动 pymysql。这里推荐使用 SQLAlchemy 2.0 及以上版本,该版本提供了更清晰的现代类型提示语法与更严谨的执行模型。
pip install sqlalchemy pymysql cryptography示例输出:Successfully installed sqlalchemy-2.0.x pymysql-1.1.x cryptography-42.x
连接 MySQL 的关键入口是 create_engine 函数。连接字符串的标准格式如下:
mysql+pymysql://<用户名>:<密码>@<主机地址>:<端口>/<数据库名>?charset=utf8mb4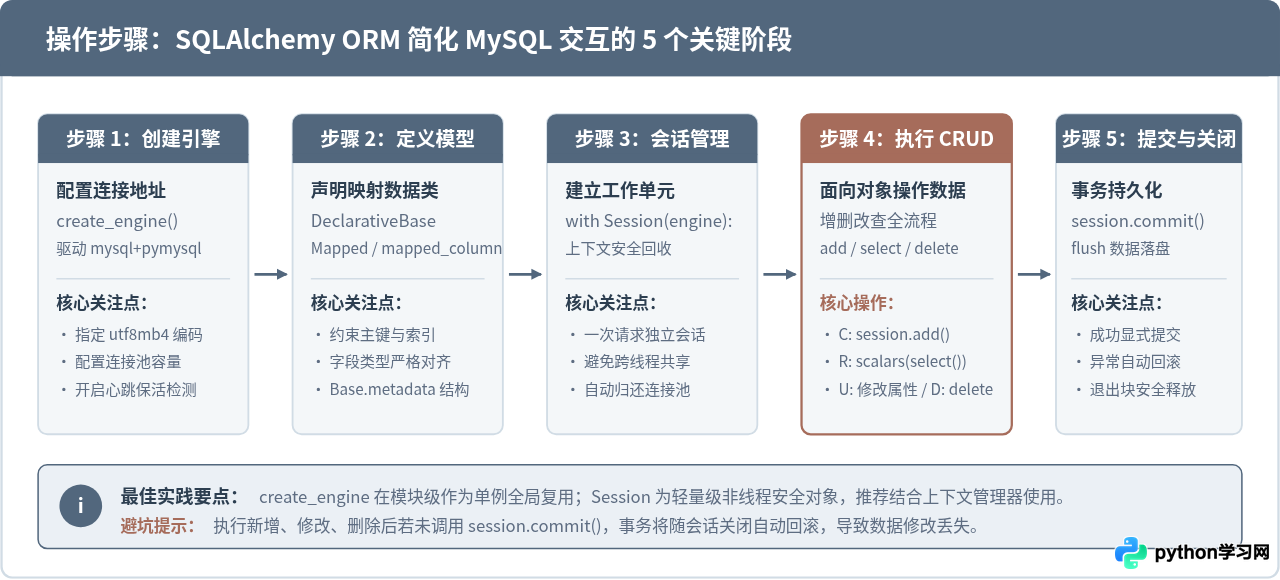
遵循图 2 的标准化开发步骤,我们先创建全局唯一的数据库引擎(Engine)。引擎本质上是连接池和方言(Dialect)的协调中枢,在实际调用执行之前并不会立即连接数据库:
from sqlalchemy import create_engine

# 构建 MySQL 连接 URL,注意必须指定 charset=utf8mb4 以完整支持中文及 Emoji
DATABASE_URL = "mysql+pymysql://app_user:SecurePass123@127.0.0.1:3306/shop_db?charset=utf8mb4"

# 创建 Engine 单例
engine = create_engine(
    DATABASE_URL,
    echo=False,              # 生产环境设为 False;调试阶段设为 True 可在终端打印原生 SQL
    pool_size=10,            # 连接池维持的长连接数量
    max_overflow=20,         # 峰值并发时允许临时超出创建的最大连接数
    pool_recycle=3600,       # 1小时自动回收连接,防止 MySQL 服务端因 8 小时空闲超时断开
    pool_pre_ping=True       # 每次借出连接前发送轻量心跳(PING),自动检测并剔除僵死连接
)
三、使用现代语法定义数据模型
在 SQLAlchemy 2.0 中,定义模型推荐继承 DeclarativeBase,并配合 Mapped 类型标注与 mapped_column 函数。这样不仅能让代码获得现代 IDE 的精准代码补全,还能对字段类型与数据库约束进行强类型对齐。
from datetime import datetime
from typing import Optional
from sqlalchemy import String, Integer, DateTime
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column

# 1. 声明基类
class Base(DeclarativeBase):
    pass

# 2. 声明业务数据表模型
class User(Base):
    __tablename__ = "users"

    # 主键自增 ID
    id: Mapped[int] = mapped_column(Integer, primary_key=True, autoincrement=True)
    # 用户名,长度 50,不允许为空,建立索引
    username: Mapped[str] = mapped_column(String(50), nullable=False, index=True)
    # 电子邮箱,唯一约束
    email: Mapped[str] = mapped_column(String(120), unique=True, nullable=False)
    # 年龄,允许为空(Optional)
    age: Mapped[Optional[int]] = mapped_column(Integer, nullable=True)
    # 创建时间,默认取当前时间
    created_at: Mapped[datetime] = mapped_column(DateTime, default=datetime.utcnow)

    def __repr__(self) -> str:
        return f"<User(id={self.id}, username='{self.username}', email='{self.email}')>"

# 3. 自动同步数据表结构(如果 MySQL 中尚无此表,则执行建表)
Base.metadata.create_all(engine)Base.metadata.create_all(engine) 会自动检测 MySQL 中是否存在同名表。如果表已存在,它不会强制修改现有表结构;如果是大型项目或持续演进的生产系统,建议结合 Alembic 工具进行数据库版本迁移。
四、核心实战:增删改查(CRUD)操作
在 SQLAlchemy ORM 中,所有数据库操作均在一个称为 Session(会话)的工作单元内展开。为了确保连接不会因未正确关闭而发生泄漏,我们始终采用 Python 的上下文管理器(with Session(engine) as session:)。
1. 插入数据(Create)
新增数据仅需实例化 Python 模型对象,并调用 session.add() 或批量添加的 session.add_all()。调用 session.commit() 之后,MySQL 将执行 INSERT 语句,并且新插入行的自增 id 会被自动回填到 Python 对象中。
from sqlalchemy.orm import Session

# 打开会话执行写入
with Session(engine) as session:
    # 单条插入
    new_user = User(username="李华", email="lihua@example.com", age=26)
    session.add(new_user)

    # 批量插入
    users_list = [
        User(username="王敏", email="wangmin@example.com", age=31),
        User(username="赵雷", email="zhaolei@example.com", age=22),
    ]
    session.add_all(users_list)

    # 显式提交事务
    session.commit()

    # 事务提交后,自增主键自动回填
print(f"新增用户成功,生成的主键 ID: {new_user.id}")2. 查询数据(Read)
SQLAlchemy 2.0 统一采用 select() 构造型查询,配合 session.scalars() 解析单实体结果集。这种模式让过滤条件、关联查询与排序分页的表达非常直观。
from sqlalchemy import select, desc

with Session(engine) as session:
    # 示例 A:按主键或唯一键查询单条数据
    stmt_single = select(User).where(User.email == "lihua@example.com")
    user = session.scalars(stmt_single).one_or_none()
    if user:
        print(f"查找到单条记录:{user.username}, 年龄:{user.age}")

    # 示例 B:多条件组合过滤与排序(年龄大于等于 25,按 ID 倒序排列)
    stmt_multi = (
        select(User)
        .where(User.age >= 25)
        .order_by(desc(User.id))
    )
    results = session.scalars(stmt_multi).all()
    print(f"满足条件的用户数量: {len(results)}")
    for u in results:
        print(f" - ID: {u.id}, 姓名: {u.username}, 邮箱: {u.email}")

    # 示例 C:分页查询(跳过 0 条,最多取 10 条)
    stmt_page = select(User).order_by(User.id).offset(0).limit(10)
page_data = session.scalars(stmt_page).all()3. 修改数据(Update)
在 ORM 中更新数据有两种常见方式:一种是基于实例对象的属性变更(利用 ORM 的自动脏检查机制);另一种是直接构建批量更新语句 update()。对于常见业务,直接修改对象属性最为便捷。
with Session(engine) as session:
    # 方式一:查出对象后直接修改属性(推荐,自带生命周期保护)
    stmt = select(User).where(User.username == "李华")
    user_to_update = session.scalars(stmt).first()

    if user_to_update:
        # 修改属性,此时实体对象在 Session 内部被自动标记为 Dirty
        user_to_update.age = 27
        user_to_update.email = "lihua_updated@example.com"

        # 提交事务时,SQLAlchemy 自动编译并执行 UPDATE 语句
        session.commit()
        print(f"用户更新完成,新年龄: {user_to_update.age}")

    # 方式二:直接执行高性能条件批量更新(无需先将实体全部载入内存)
    from sqlalchemy import update
    session.execute(
        update(User)
        .where(User.age < 20)
        .values(age=20)
    )
session.commit()4. 删除数据(Delete)
删除操作同样支持基于查出对象的 session.delete(),以及基于条件的 delete() 批量语句。
from sqlalchemy import delete

with Session(engine) as session:
    # 方式一:删除已加载的实例对象
    user_to_delete = session.scalars(select(User).where(User.username == "赵雷")).first()
    if user_to_delete:
        session.delete(user_to_delete)
        session.commit()
        print("指定用户已从数据库中成功移除")

    # 方式二:按条件批量删除
    session.execute(
        delete(User).where(User.email.like("%@temp.com"))
    )
session.commit()五、深入理解:Session 状态转换与事务机制
初学者在使用 ORM 时最容易产生疑惑的地方是:“为什么有时修改了属性会自动更新,有时却报错说对象 Detached?”这背后是 SQLAlchemy 的工作单元(Unit of Work)和对象状态机在起作用。
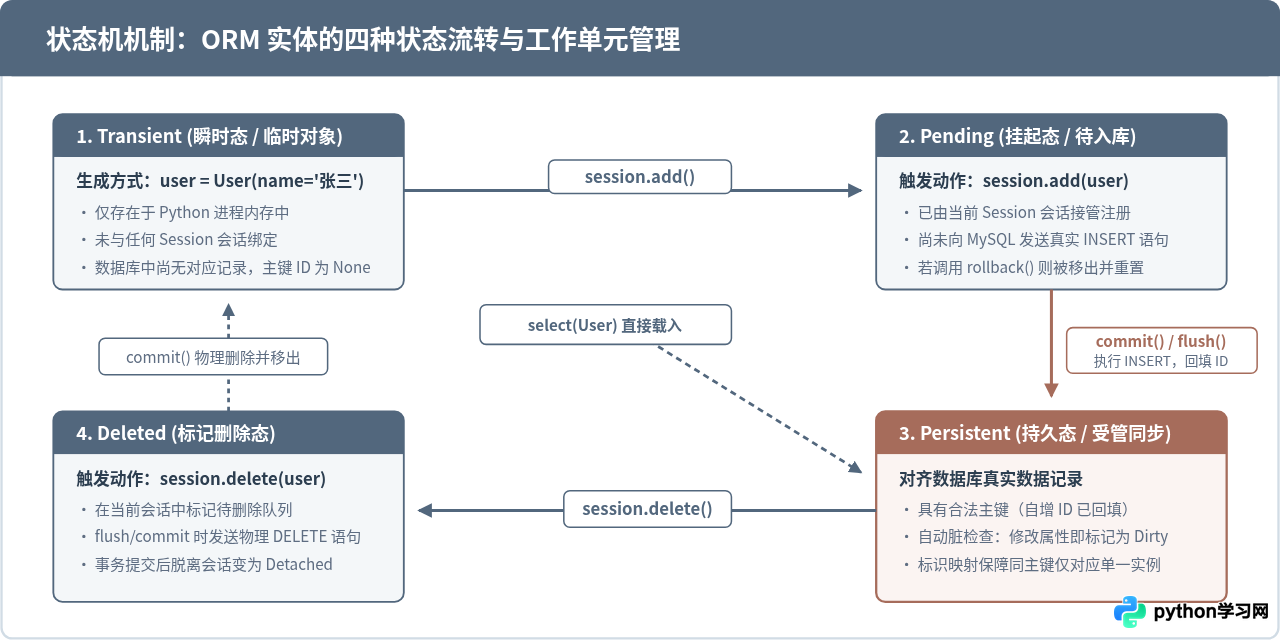
如图 3 所示,实体对象在 Python 运行生命周期内会在四种状态之间切换:
- Transient(瞬时态):刚通过
User(...)在内存中实例化的对象。此时它完全脱离会话,无主键 ID,数据库也没有对应记录。 - Pending(挂起态):执行
session.add(user)后,对象进入当前会话的挂起队列。尚未向 MySQL 发送真正的INSERT。 - Persistent(持久态):当调用
commit()或flush()、或者直接通过select()从数据库查出对象时,对象处于持久态。对象拥有数据库主键,且受到 Session 的自动脏检查监控。任何对属性的赋值修改,都会在下一次提交时自动触发相应的UPDATE。 - Deleted(标记删除态):调用
session.delete(user)后,对象被标记为待删除,在事务提交时由数据库执行物理DELETE。
Session 对象绝不能在多线程之间共享,也不要在一个全局长生命周期里使用同一个 Session。标准的最佳实践是“短生命周期模式”:每次 HTTP 请求或后台离线任务开启一个独立的 with Session(engine) as session: 块,用完即随上下文自动销毁并归还数据库连接。
六、原生方式与 ORM 综合对比及避坑实践
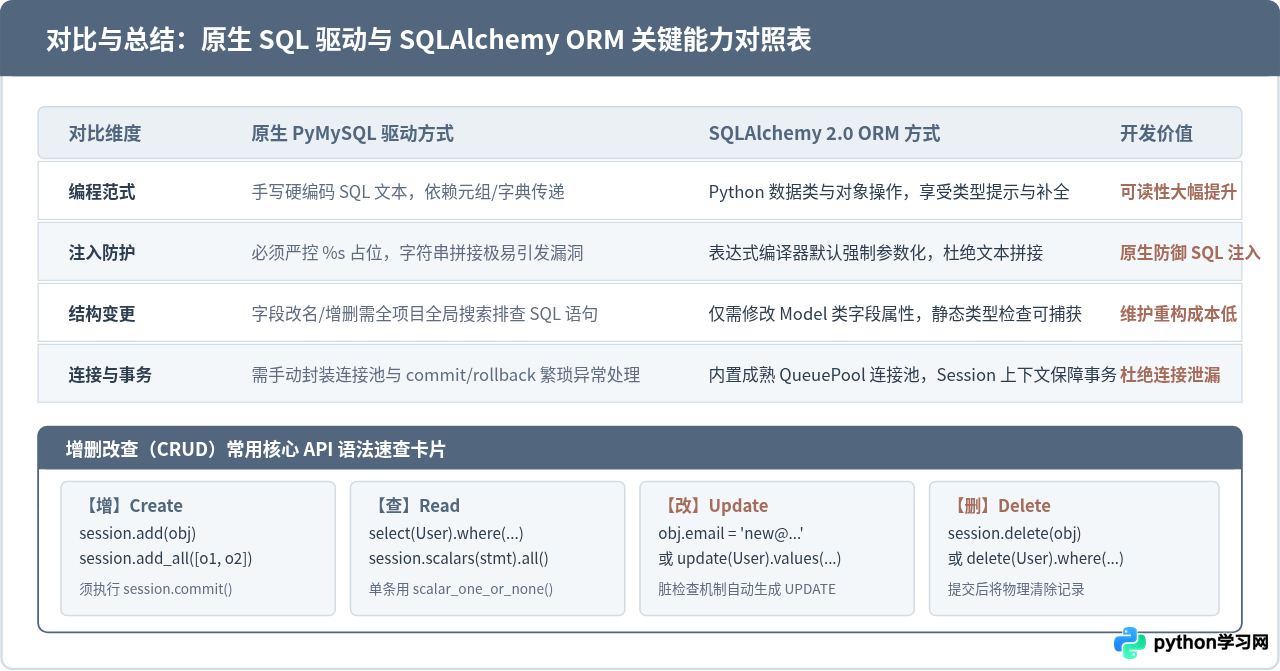
为了帮助读者系统掌握两者的区别与选择依据,我们将原生 PyMySQL 驱动方式与 SQLAlchemy ORM 在实际工程中的表现整理为对照矩阵。
常见易错问题排查
-
1. 中文或 Emoji 写入报错
Incorrect string value:
原因在于 MySQL 数据库字符集或连接驱动未启用完整的 4 字节 utf8 支持。必须确保连接 URL 明确带有?charset=utf8mb4,同时 MySQL 中数据表字符集设置为utf8mb4、排序规则为utf8mb4_unicode_ci。 -
2. 运行一段时间后出现
MySQL server has gone away:
MySQL 默认的wait_timeout为 8 小时,长时间没有查询的空闲连接会被 MySQL 主动掐断。在create_engine中必须配置pool_pre_ping=True(借出前探活)以及pool_recycle=3600(定期回收老化连接)。 -
3. 执行新增或修改操作后,MySQL 表中却没有数据变化:
这是初学者最常见的问题:ORM 的所有写操作默认均在事务中,未显式调用session.commit()时,退出with代码块会触发隐式回滚(Rollback)。排查代码中是否遗漏了session.commit()即可解决。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









