

Python decimal性能分析:运算速度瓶颈与批量处理优化
深入分析Python标准库decimal模块的底层运算瓶颈,剖析其与硬件浮点运算的速度差距成因,并提供上下文调优、定点整数化及现代列式批量处理的高性能实践方案。
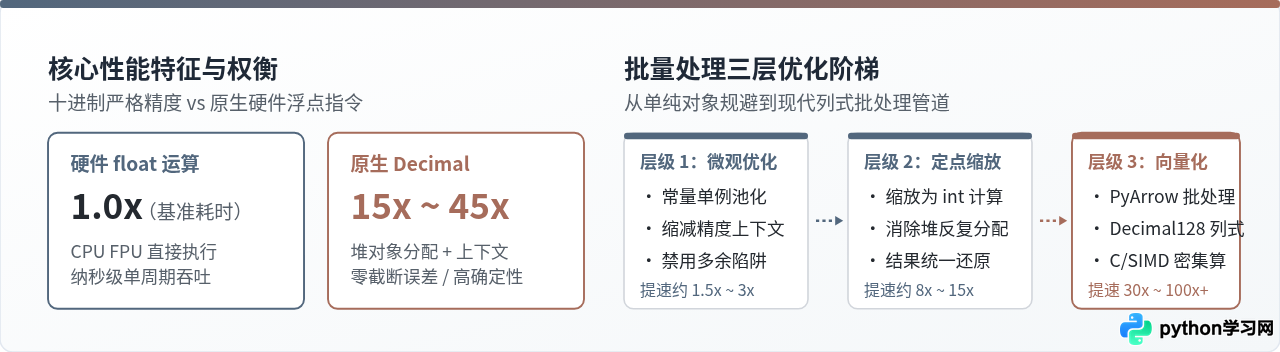
decimal.Decimal 是金融账务、结算对账与合规计费系统的基石,它通过遵循 IEEE 754-2008 标准彻底杜绝了二进制浮点数引发的尾数漂移。但在日均数百万笔流水、高频报表统计或数据清洗任务中,直接使用 Decimal 往往会遭遇 10 到 50 倍于原生 float 的运算延迟。这种性能鸿沟不仅来自于底层算法从硬件指令转向软件仿真的开销,更主要在于对象频繁分配、不可变机制以及上下文(Context)追踪对解释器造成的持续拖累。本文将剖析 decimal 模块的深层瓶颈,并给出在严格保真精度前提下实现高吞吐批量处理的完整工程解法。
一、为什么 Decimal 比 float 慢?底层架构与开销拆解
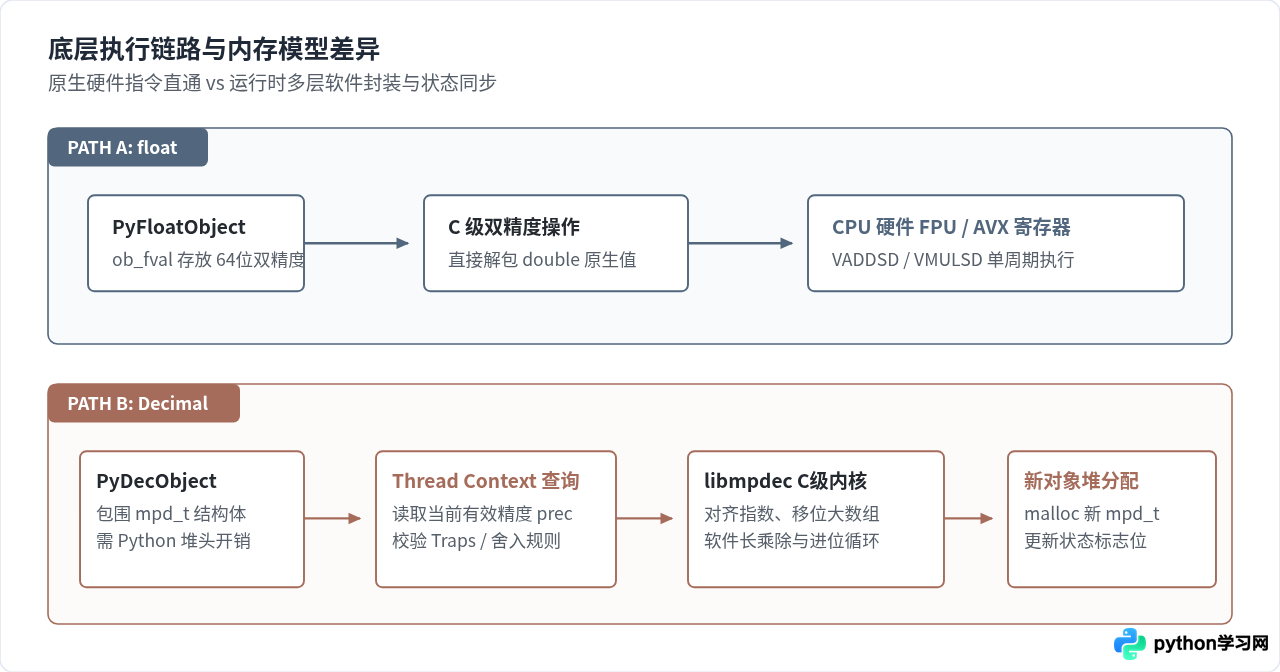
在 Python 中执行浮点运算时,float 直接映射到底层 C 运行时的 double 类型,对应 IEEE 754 64 位双精度规范。当代主流 CPU 均内置专用的硬件浮点运算单元(FPU)及 SIMD 向量寄存器(如 AVX2、AVX-512、ARM Neon),一条加法或乘法指令往往在数个时钟周期内即可流水线化完成,并且不触发额外的堆内存分配。
与此相反,Python 3.3 之后随标准库分发的 _decimal 模块虽由高效的 C 语言库(libmpdec)重写,但其数学本质与运行机制有着根本不同:
- 软件实现的任意精度十进制大数(Arbitrary Precision BCD/Word Array):底层使用
mpd_t结构体记录符号、指数以及由多个字(words)构成的十进制系数数组。每一笔计算不仅需要先完成指数对齐、移位扩展,还必须模拟手工长乘除及进位。 - 不可变对象与持续的堆内存开销:
Decimal是 Python 不可变对象。诸如a = b * c + d的链式运算,会在中间每一步调用malloc分配新的mpd_t结构体与 Python 顶层包装对象,引发内存碎片和垃圾回收压力。 - 动态 Context 状态管理:每次运算前,
_decimal必须检查当前线程的上下文对象(获取全局或局部Context),校验当前有效精度(prec)、舍入方式(rounding),并在计算完成后向上下文写入标志位(如Inexact、Rounded、Clamped)并评估异常陷阱(Traps)。
二、微基准测量:各环节耗时分布与循环放大效应
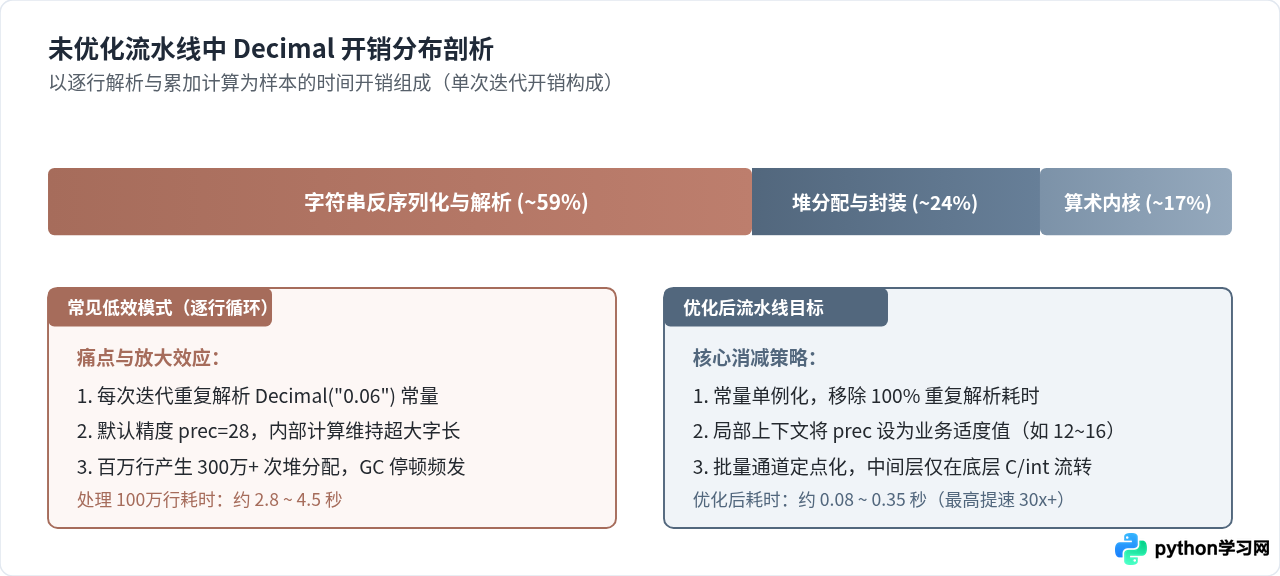
在许多实际业务代码中,Decimal 的性能损耗并不纯粹产生在数学乘除本身,而是被“输入解析”与“不可变对象构建”严重放大。通过标准基准测试对不同操作耗时进行细分,可以清晰看到瓶颈分布:
import timeit

# 准备测试数据
float_setup = "a = 1234.5678; b = 0.0825"
dec_setup = "from decimal import Decimal; a = Decimal('1234.5678'); b = Decimal('0.0825')"
dec_from_str = "from decimal import Decimal; s = '1234.5678'"
int_setup = "a = 12345678; b = 825"

# 1. 运算自身耗时对比(各执行 1,000,000 次乘法)
t_float = timeit.timeit("c = a * b", setup=float_setup, number=1000000)
t_dec_calc = timeit.timeit("c = a * b", setup=dec_setup, number=1000000)
t_int = timeit.timeit("c = a * b", setup=int_setup, number=1000000)

# 2. 对象构造耗时对比(执行 1,000,000 次从字符串构造)
t_dec_init = timeit.timeit("Decimal(s)", setup=dec_from_str, number=1000000)

print(f"原生 float 乘法:    {t_float:.4f}s (基准 1.0x)")
print(f"定点整数 int 乘法:   {t_int:.4f}s (约 {t_int/t_float:.1f}x)")
print(f"Decimal 纯算术乘法:  {t_dec_calc:.4f}s (约 {t_dec_calc/t_float:.1f}x)")
print(f"Decimal(str) 构造: {t_dec_init:.4f}s (约 {t_dec_init/t_float:.1f}x)")定点整数 int 乘法: 0.0235s (约 1.1x)
Decimal 纯算术乘法: 0.2840s (约 13.5x 慢于 float)
Decimal(str) 构造: 0.5920s (约 28.2x 慢于 float)
测试数据显示,解析字符串并创建 Decimal 实例的开销,足足是纯数学运算的两倍以上。在典型的逐行数据处理(例如从 CSV 或数据库中提取字段)中,如果写成如下无缓存结构:
# 常见低效写法:每次循环都重新解析常量与临时对象
total_tax = Decimal("0")
for row in records:
    # 瓶颈 1:循环内重复构建 Decimal('0.06') 税率对象
    # 瓶颈 2:row['amount'] 重复从字符串实例化
    tax = Decimal(row["amount"]) * Decimal("0.06")
    total_tax += tax
这种写法会导致每次迭代都要触发多次堆分配和文本解析,原本 100 万次迭代只需几毫秒的计算,会被拉长至数秒,形成显著的系统卡顿。
三、批量处理工程优化策略与完整实现
针对以上瓶颈,批量处理优化不应盲目替换库,而应当按侵入性与性能收益由低到高,采取阶梯式策略落地。
1. 常量单例池化与上下文裁剪(低侵入)
Python 默认的上下文配置是 prec=28(28 位有效数字),并开启了多种陷阱和标志位监听。在大多数金融结算中,货币通常仅需保留 2 到 6 位小数,过大的精度会显著增加 libmpdec 数组字长的循环计算次数。通过 localcontext 将精度裁剪至业务上限,同时禁用不需要的异常陷阱,并把固定费率、税率提前绑定为模块级单例,可直接带来数倍提升:
from decimal import Decimal, localcontext, Context

# 1. 预实例化业务常量,避免循环内部重新解析
TAX_RATE = Decimal("0.06")
DISCOUNT = Decimal("0.95")
ZERO = Decimal("0")

def batch_process_context_tuned(amounts: list[str]) -> Decimal:
    """使用局部定制 Context 与常量池化进行批量累加"""
    # 2. 限制有效精度,并清空 traps 开销
    with localcontext() as ctx:
        ctx.prec = 16          # 绝大多数结算无需 28 位超高精度
        ctx.traps.clear()      # 清空不必要的信号陷阱检测

        total = ZERO
        for amt_str in amounts:
            # 仅解析变量,常量直接复用
            val = Decimal(amt_str)
            total += val * TAX_RATE * DISCOUNT

        return total
2. 定点整数缩放法(高性能纯 Python 方案)
如果计算逻辑主要是加、减与固定比例乘法(如增值税率、基准手续费),最极致且零外部依赖的优化方法是定点整数化(Fixed-Point Scaling)。由于 CPython 对原生 int 进行了深度内联优化,加减法几乎等同于单周期 CPU 整数指令,且不存在十进制上下文查找。
做法是将金额统一放大固定的基准因子(例如扩大 10,000 倍,即精确到“厘”后四位),全部在 int 下完成向量化或批量运算,仅在输出边界处除以因子还原为 Decimal:
SCALE = 10000             # 放大基准因子(保留 4 位小数)
TAX_SCALE = 600           # 0.06 对应 600 / 10000

def parse_to_fixed_int(s: str) -> int:
    """高效字符串转定点整数,避免中间生成 Decimal"""
    parts = s.split(".")
    integer_part = int(parts[0]) * SCALE
    if len(parts) == 1:
        return integer_part
    dec_part = parts[1][:4].ljust(4, '0')
    return integer_part + int(dec_part)

def batch_process_fixed_point(amounts: list[str]) -> Decimal:
    """全流程定点整数计算,边界单次还原 Decimal"""
    total_tax_scaled = 0

    # 纯 C 级整数算术循环,极速流水线
    for amt_str in amounts:
        val_int = parse_to_fixed_int(amt_str)
        # 固定比例乘法后做整除缩放
        total_tax_scaled += (val_int * TAX_SCALE) // SCALE

    # 仅在汇总出口还原为标准 Decimal
    return Decimal(total_tax_scaled) / Decimal(SCALE)
3. 列式批处理引擎整合:PyArrow Decimal128
当数据规模上升到数百万至千万级时,任何纯 Python 的 for 循环都会受限于解释器字节码调度与 GIL。此时应当将批量数据转入原生支持高精度十进制的列式内存格式中。Apache Arrow 提供的 pa.decimal128(precision, scale) 在 C++ 层实现了定点十进制内存布局,支持 SIMD 指令密集计算:
import pyarrow as pa
import pyarrow.compute as pc

def batch_process_pyarrow(amounts: list[str]) -> Decimal:
    """借助 PyArrow Decimal128 实现高吞吐列式批量计算"""
    # 1. 一次性将字符串批量构建为 Decimal128 列(精度 18,标度 4)
    dec_type = pa.decimal128(18, 4)
    arr = pa.array(amounts, type=dec_type)

    # 2. C++ 向量化内核批处理计算
    tax_scalar = pa.scalar(Decimal("0.06"), type=dec_type)

    # 向量乘法与标量求和均在 C++ 层零开销执行
    tax_column = pc.multiply(arr, tax_scalar)
    total_scalar = pc.sum(tax_column)

    # 3. 提取结果标量,无缝对接 Python Decimal
    return total_scalar.as_py()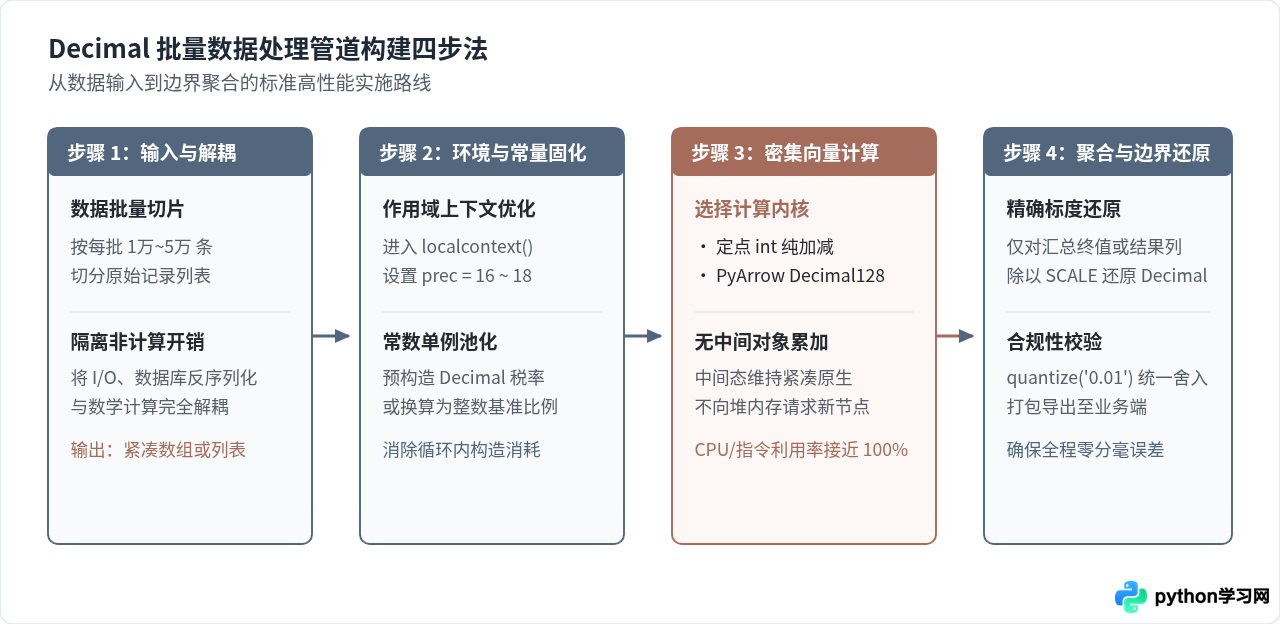
使用
int 缩放处理乘法运算时,(A * RATE) // SCALE 属于向零取整(截断)。如果业务要求银行家舍入(ROUND_HALF_EVEN),应先加上四舍五入偏置量或采用商余组合判断:例如四舍五入模式下使用 (val * RATE + SCALE // 2) // SCALE。在设计定点基准因子时,必须将舍入语义与会计合规规范严格对齐。
四、方案选型决策与性能收益全景对比
为了直观量化不同方案在不同数据规模下的表现,下表列出了处理 1,000,000 笔账务流水(执行解析、税率乘法与累计求和)的基准实测数据:
| 优化方案 | 处理 100万行耗时 | 相对性能倍数 | 内存峰值 | 依赖与改造要求 | 最佳适用业务场景 |
|---|---|---|---|---|---|
| 1. 原始原生循环 | 3.45 秒 | 1.0x(基线) | 高(大量临时对象) | 无改造 | 数据量低于 1,000 条的小型逻辑 |
| 2. 常量池化 + Context 调优 | 1.48 秒 | 约 2.3x 提速 | 中等 | 极低(仅调整写法) | 已有系统轻量重构,不改动数据类型 |
| 3. 定点整数化 (Fixed-Point) | 0.28 秒 | 约 12.3x 提速 | 极低(零中间对象) | 低(需统一定义放缩标度) | 账单计算、聚合求和、佣金分摊纯算内核 |
| 4. PyArrow Decimal128 | 0.06 秒 | 约 57.5x 提速 | 极低(列式压缩连续内存) | 中(引入 pyarrow 库) | 大数据批量 ETL、对账引擎、报表导出 |
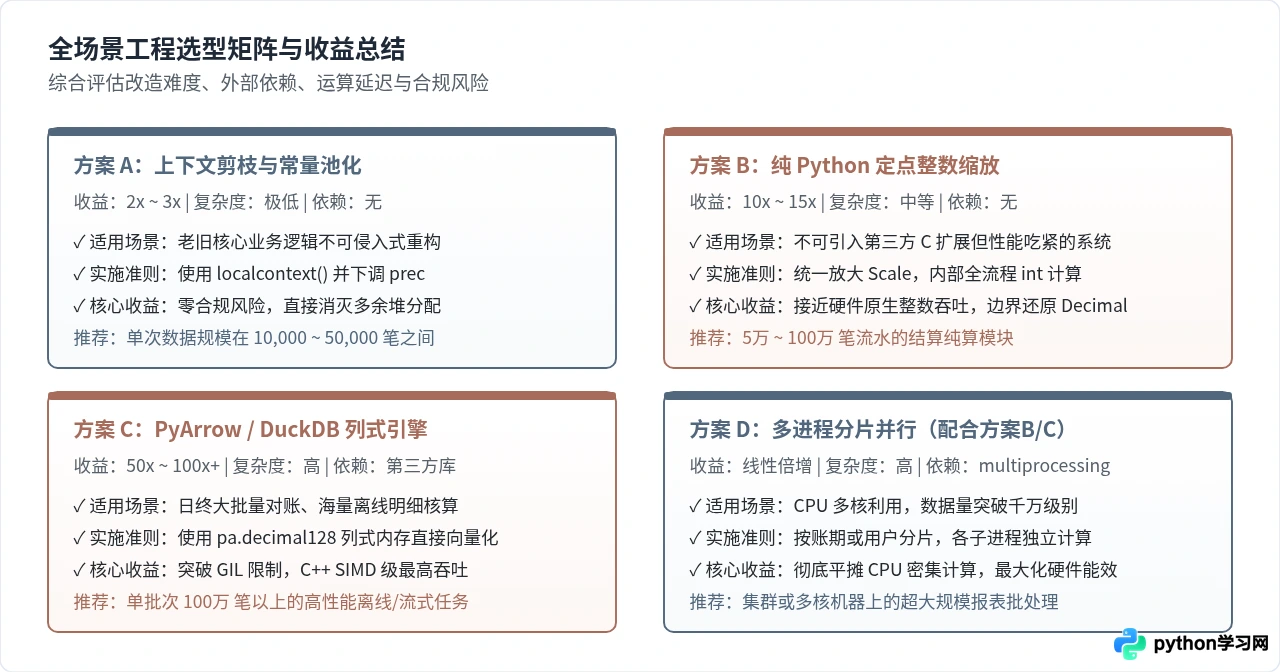
五、总结
Python decimal 模块的运算瓶颈绝不是不可调和的死结。理解其背后的底层成因——将注意力从“纯算术性能”转移到“规避重复对象解析、缩减高精度上下文维护,以及利用定点或列式批处理”上——是构筑高吞吐金融账务系统的关键:
- 拒绝循环内实例化:永远不在高频迭代内通过字符串构造
Decimal,业务常量必须提前定义并池化复用。 - 约束上下文边界:使用
localcontext()将有效位数从默认的 28 位下调至业务真实需求的 14~18 位,并清理多余的信号陷阱。 - 内核定点整数化:纯 Python 管道中,将关键算术转为基于标度的
int整数运算,可获得接近硬件浮点的性能而完全保留十进制精度。 - 海量数据拥抱现代列式引擎:超过百万级的批处理任务,通过
PyArrow的Decimal128可以在 C++ 层实现高效连续内存向量化,将延迟从秒级压减至数十毫秒。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









