

Python交互式Shell与Jupyter Notebook的代码执行区别
深入解析Python官方交互式Shell与Jupyter Notebook在代码解析粒度、架构通信机制、状态管理与执行时序、富媒体输出等维度的本质区别与实践建议。
一、从交互细节切入:为什么相同代码的执行反馈截然不同?
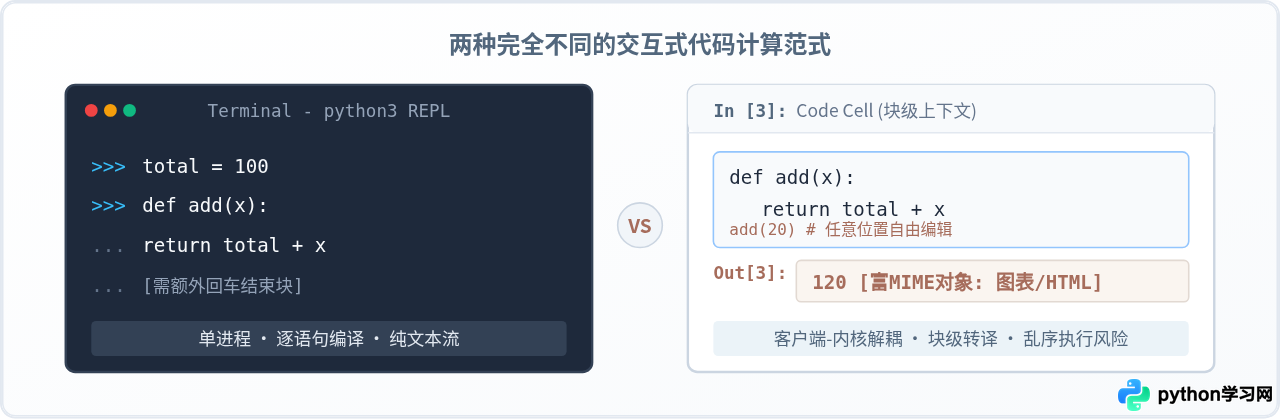
很多初学者在从终端转到Jupyter Notebook时,最先感受到的往往是一个看似微小却令人困惑的语法交互细节:在终端运行 python 命令进入交互环境后,若想定义一个多行函数,敲击回车并不会立即运行,而是会出现三点提示符 ...;当缩进代码输完后,必须再次敲击一次纯空行回车,Python才会真正执行这一段定义。
不仅如此,如果你在终端Shell中敲错了一行代码并按下了回车,已经输入的上一行就无法通过光标直接移上去修改,只能忍痛按 Ctrl+C 中断整个输入块重新来过。但在Jupyter Notebook中,你可以像在普通代码编辑器中一样自由折行、删改任意一行,然后按下 Shift + Enter 将整个单元格提交。
这个现象的根本原因在于:输入解析的边界单位不同。Python官方交互式Shell是由解释器内部的 PyRun_InteractiveLoop 驱动的,它采用的是严格的逐行/单一复合语句(Single Interactive Statement)语法分析;而Jupyter Notebook接收的是完整的文本块(Cell),在提交给执行内核(Kernel)之前,会由专用的AST转换器先进行一次全局包装与转译。
二、架构差异:单进程阻塞循环 vs 客户端-内核网络解耦
要透彻理解代码执行的区别,必须看清二者在操作系统层面的运行拓扑。
在标准Python交互式Shell中,终端就是进程本身。你的键盘输入直接写入标准输入流(stdin),终端将字符串送入当前Python解释器主进程。解释器解析、编译字节码、在当前进程的主线程中执行,并直接将字符串结果输出到标准输出(stdout)。整个过程完全发生在一个单一的本地进程中,读、算、写三者严格同步阻塞。
而Jupyter Notebook完全抛弃了这种单体架构,采用三层解耦体系:
- 前端客户端(Browser UI):仅负责捕捉键盘事件、管理单元格DOM,并通过WebSocket发送JSON指令。
- Jupyter Server(Web中间件):处理文件持久化(.ipynb格式)与路由转发。
- IPython Kernel(后台计算核心):独立的Python进程,专门负责维护运行环境与变量字典。
两者之间所有的代码提交、状态轮询和结果回调,均通过高性能异步消息总线 ZeroMQ(ZMQ) 传递。
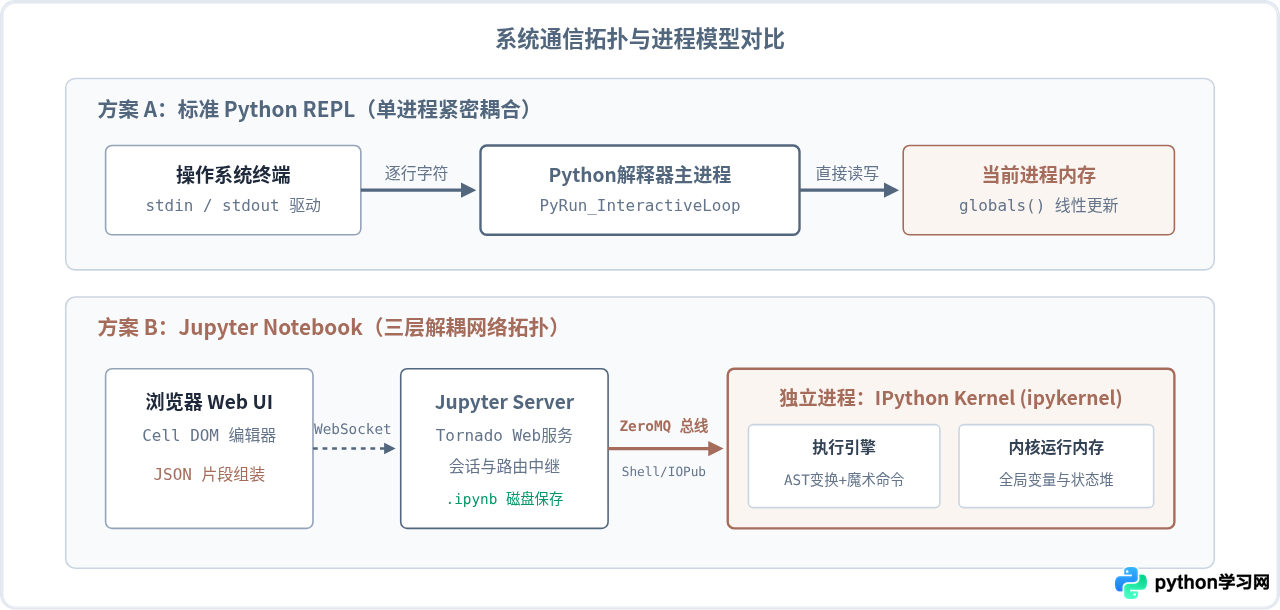
由于存在网络解耦,在Jupyter中,哪怕你的浏览器崩溃、标签页意外关闭,远端的Kernel依然安然无恙地继续计算;而一旦终端Shell所在窗口被关闭,进程便会收到 SIGHUP 信号立即夭折,所有内存对象荡然无存。
三、执行生命周期:语句级解释 vs 块级预处理与富对象渲染
当我们在两个环境中写下并执行一段代码时,解释器内部经历的步骤有着本质不同。我们以包含魔术语法和标准语句的代码为例:
1. Shell的“单语句”编译机制
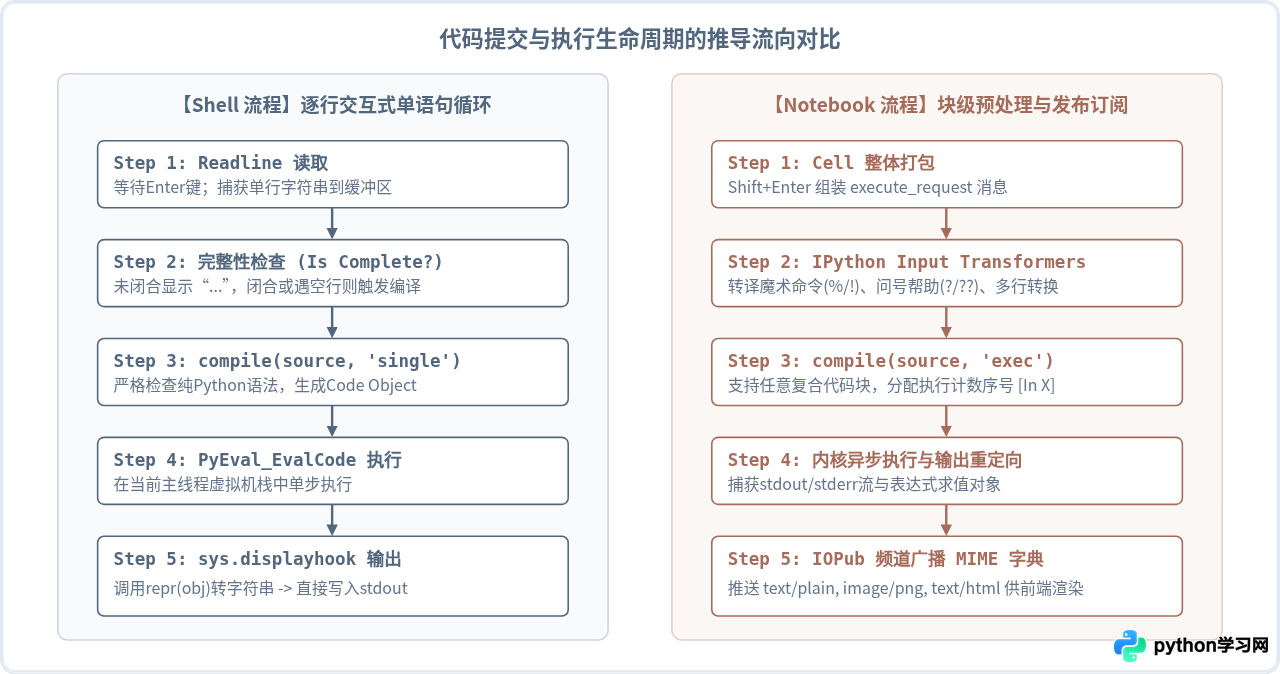
标准Shell内部调用的是内置函数 compile(source, '<stdin>', 'single')。在 single 模式下:
- 编译器要求输入的必须是一条完整语句。如果输入的是简单语句(如
a = 1),按下回车立刻编译执行。 - 如果是复合语句(如
if、for、class),它必须等待一个空行来判定语法树闭合。 - 无法直接识别非Python原生语法:如果在Shell中输入
!ls或%timeit,Python解析器会直接抛出SyntaxError: invalid syntax。
2. Notebook的块级预处理管线
当用户在Jupyter中按下 Shift + Enter,当前Cell的内容被打包成一个 execute_request 消息发送至Kernel。IPython Kernel并不会直接将其扔给底层的C编译器,而是先启动一个代码预处理转换管线(Input Transformers):
- 词法清理与魔术命令转译:将以
%开头的行魔术和以%%开头的单元格魔术解析为对应的Python函数调用(例如将!ls替换为get_ipython().system('ls'))。 - 自动补充与AST修改:在代码末尾插入显示钩子,若最后一行是一个求值表达式,自动调用
IPython.display.display。 - 块编译模式:调用
compile(source, '<ipython-input-X>', 'exec'),以exec模式编译整个单元格的代码块。
四、状态管理与时序陷阱:线性单调性 vs 乱序执行风险
如果说架构和预处理决定了“能输入什么”,那么运行时的状态时序则直接决定了计算结果的可靠性。这是两类工具最关键的逻辑分水岭。
1. Shell的绝对线性时序
在终端Shell中,代码的执行历史与时间完全重合:
- 时间轴严格单调递增:命令 $T_1$ 必然在命令 $T_2$ 之前完成。
- 屏幕上自上而下的每一行输出,都如实反映了内存变量
globals()的真实演进轨迹。你不需要担心上面的一行会在不经意间被修改或“幽灵更新”。
2. Notebook的“非线性乱序”陷阱(Out-of-Order Execution)
Jupyter Notebook将代码拆分成了在视觉上看似独立的单元格(Cells)。但请记住:所有单元格共享同一个内核的同一个全局命名空间。而单元格在页面中的上下物理位置,并不代表执行时间顺序。
考虑以下典型灾难现场:
# 物理位置在最上方的 Cell 1 (实际第三次执行)
In [3]: count = 100

# 物理位置在中间的 Cell 2 (实际第一次执行)
In [1]: count = 0

# 物理位置在下方的 Cell 3 (实际第二次执行)
In [2]: count += 5
        print("count is:", count)
# 此时打印 count is: 5In [3],内存中的 count 已经变成 100。但屏幕下方的 Cell 3 依然停留在 In [2] 的旧视觉结果上。如果用户接着在下方写一个依赖 count == 5 的逻辑,程序就会立刻产生隐蔽的逻辑崩溃。
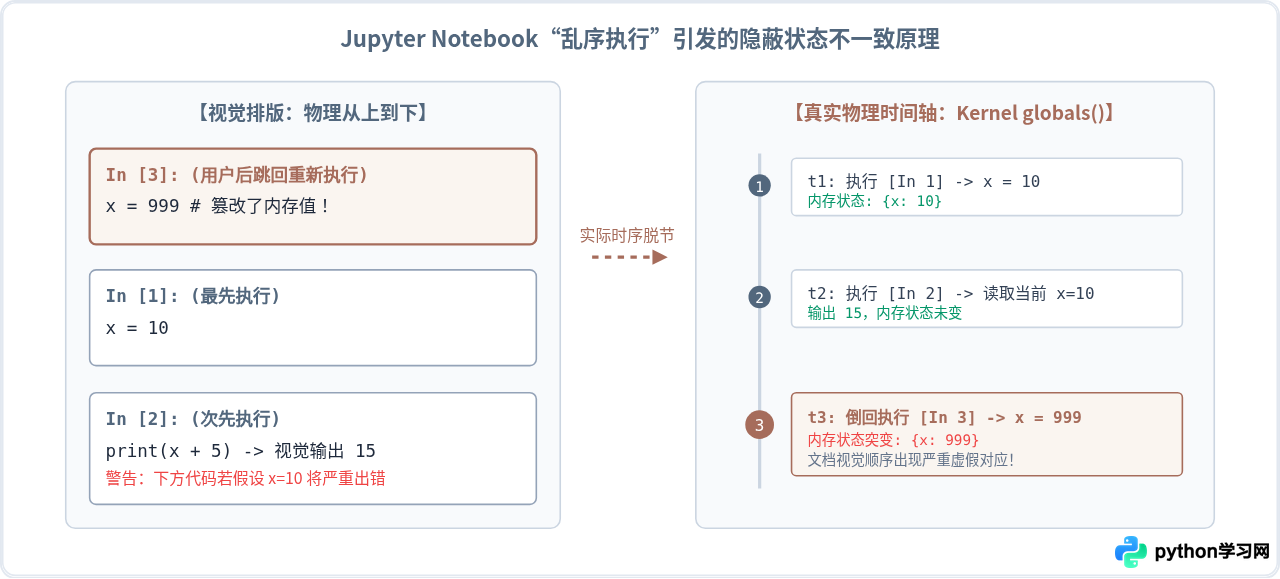
In [N],绝对不能迷信界面的上下排布顺序。这也是为什么团队协作与学术复现中,提交Notebook前强制要求执行一次“Kernel -> Restart & Run All(重启内核并从头运行全部)”。
五、输出流捕获与富媒体管道:纯文本Repr vs MIME Bundle
执行代码后产生的数据如何被展示,同样体现了两个系统在设计目标上的分化。
1. Shell的单一文本流机制
终端的物理限制决定了它只懂得 ASCII/UTF-8 字符流。当你在Shell中执行一个表达式(例如 df.head()):
- 解释器调用内部的
sys.displayhook(obj); - 若
obj is not None,执行builtins.repr(obj)将其强行转换为字符文本; - 通过标准文件句柄写入控制台。无法直观展示任何位图、可交互图表或动态表格。
2. Notebook的富显示协议(Rich Display Protocol)
Jupyter将输出定义为一个 MIME Bundle 字典。当一个自定义对象被求值时,IPython会按照优先级依次检索该对象是否实现了以下特殊钩子方法:
_repr_html_():返回HTML片段(例如Pandas优雅的高亮表格);_repr_svg_():返回矢量图形SVG代码;_repr_png_()/_repr_jpeg_():返回Base64编码的图片字节;_repr_latex_():返回数学公式LaTeX源码;__repr__():兜底的纯文本描述。
Kernel将包含上述多种格式的字典通过 ZeroMQ 的 IOPub 频道推送到前端,浏览器自动挑选它能支持的最优呈现形式。这种执行输出通道的本质升级,使得Jupyter成为了数据探索与算法可视化无可争议的统治级工具。
六、综合总结与实践选型指南
理解了两者的技术差异后,开发者在实际工作流程中应当建立起清晰的分工策略,而非盲目替代:
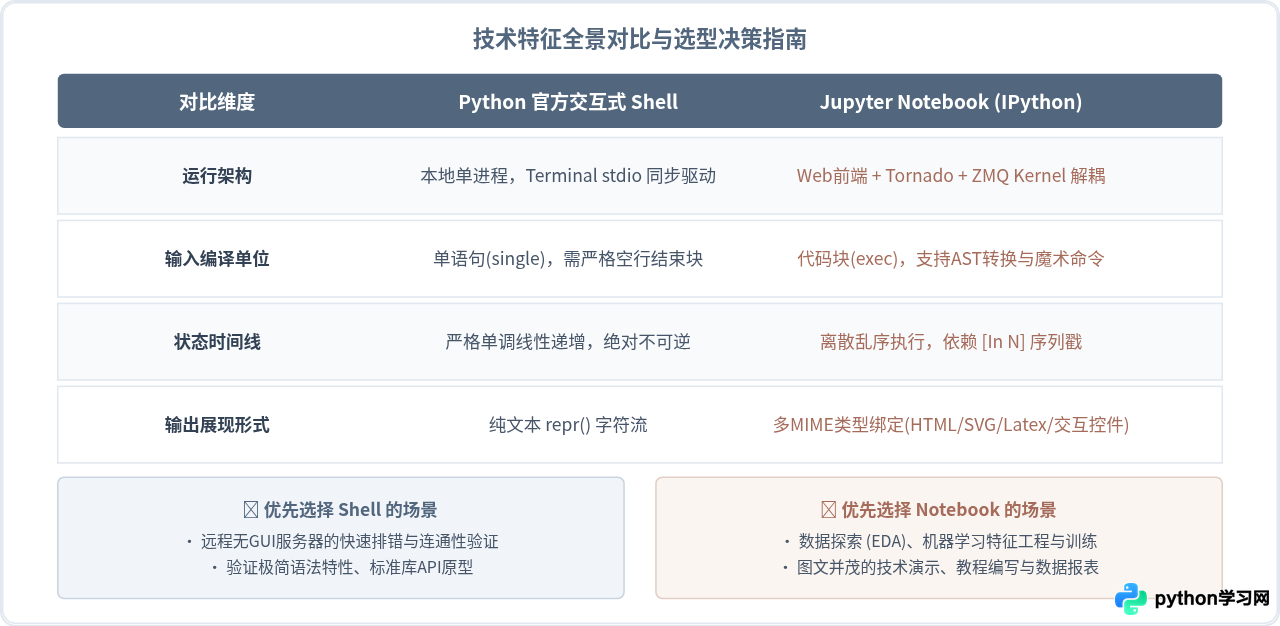
| 最佳实践准则 | 面向环境 | 操作指南与防御性措施 |
|---|---|---|
| 环境快速抽检 | Python Shell | 直接键入 import sys; print(sys.executable),无额外依赖,1秒内确认当前虚拟环境绑定与依赖路径。 |
| 状态线性保证 | Jupyter Notebook | 完成逻辑调试后,务必点击 Restart & Run All,确保整篇计算在纯净线性时序下依然成立,杜绝变量残留。 |
| 工程化代码沉淀 | 混合工作流 | 在Notebook完成算法探索与可视化后,及时将稳定函数与类抽象并剥离到 .py 模块中,避免巨型单文件Notebook堆积。 |
综上所述,Python交互式Shell是一把直接触达解释器心脏的轻便解剖刀,干净、纯粹、时序确定;而Jupyter Notebook则是一座高度现代化的交互实验室,通过网络解耦与多媒体协议极大拓展了人机交互的边界。深刻理解它们底层的代码执行逻辑,是每个Python开发者写出更稳健、更可复现代码的必经之路。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









