

Python装饰器怎么写:基础语法与带参数示例
全面解析Python装饰器的编写方法与运行原理,从无参基础装饰器的闭包机制与语法糖演进,到支持通用参数与返回值的封装,再到带参数装饰器的三层函数嵌套范式,并提供functools.wraps的最佳实践与避坑指南。
编写 Python 装饰器的核心方法并不复杂:它的本质是一个接收原函数作为参数并返回新函数(包装器)的高阶函数。要在不改变原函数源码和调用方式的前提下扩展功能,基础装饰器仅需使用两层嵌套函数;若需要支持像 @repeat(times=3) 那样向装饰器本身传递配置参数,则需在外层再包裹一层函数,形成“接收参数 ➔ 接收函数 ➔ 包装调用”的三层函数结构。本文将从基础闭包与 @ 语法糖讲起,结合完整可运行的代码与时序图示,带你掌握标准装饰器与带参数装饰器的编写范式及关键避坑细节。
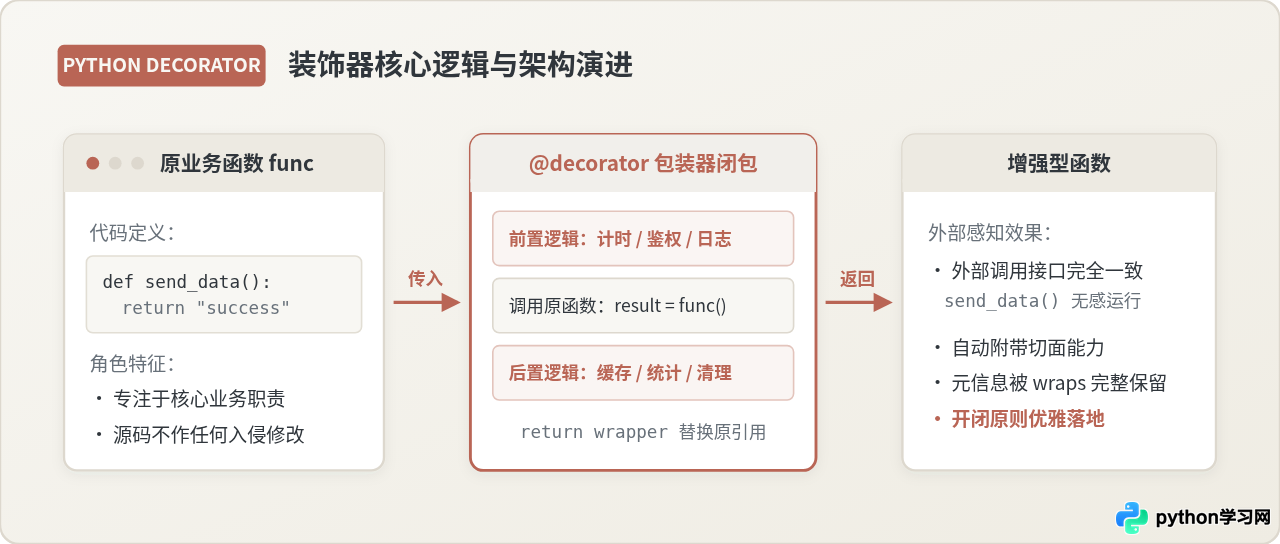
缩略图概览:Python 装饰器在原函数外侧构建闭包包装层,实现非侵入式的能力增强
一、装饰器的本质:函数即对象与闭包调用
在 Python 中,函数是一等公民(First-Class Object)。这意味着函数可以像普通变量一样被传递、赋值给其他变量、作为返回值从函数中返回。理解这一点,是理解装饰器运作机制的关键。
所谓装饰器,实质上就是一个以函数为入参、并在内部定义一个新函数来“包装”该入参的高阶函数。我们可以先脱离 @ 语法糖,看一个最纯粹的手工包装过程:
def my_decorator(func):
    def wrapper():
        print("[前置操作] 正在检查执行环境...")
        func()  # 执行传入的原函数
        print("[后置操作] 执行完成,清理临时资源。")
    return wrapper  # 返回组装好的新函数对象

def say_hello():
    print("Hello, Python Decorator!")

# 手工实现装饰:把原函数传给装饰器,再将返回的 wrapper 重新赋值给 say_hello 变量
say_hello = my_decorator(say_hello)

# 此时调用 say_hello,实际调用的是 wrapper
say_hello()Hello, Python Decorator!
[后置操作] 执行完成,清理临时资源。
当执行 say_hello = my_decorator(say_hello) 时,变量名 say_hello 已经不再指向最初定义的函数体,而是指向了 my_decorator 内部返回的 wrapper 闭包。在闭包内部,原函数的引用被完好地保存在自由变量中,因此在调用 wrapper 时依然能够顺利执行原函数。
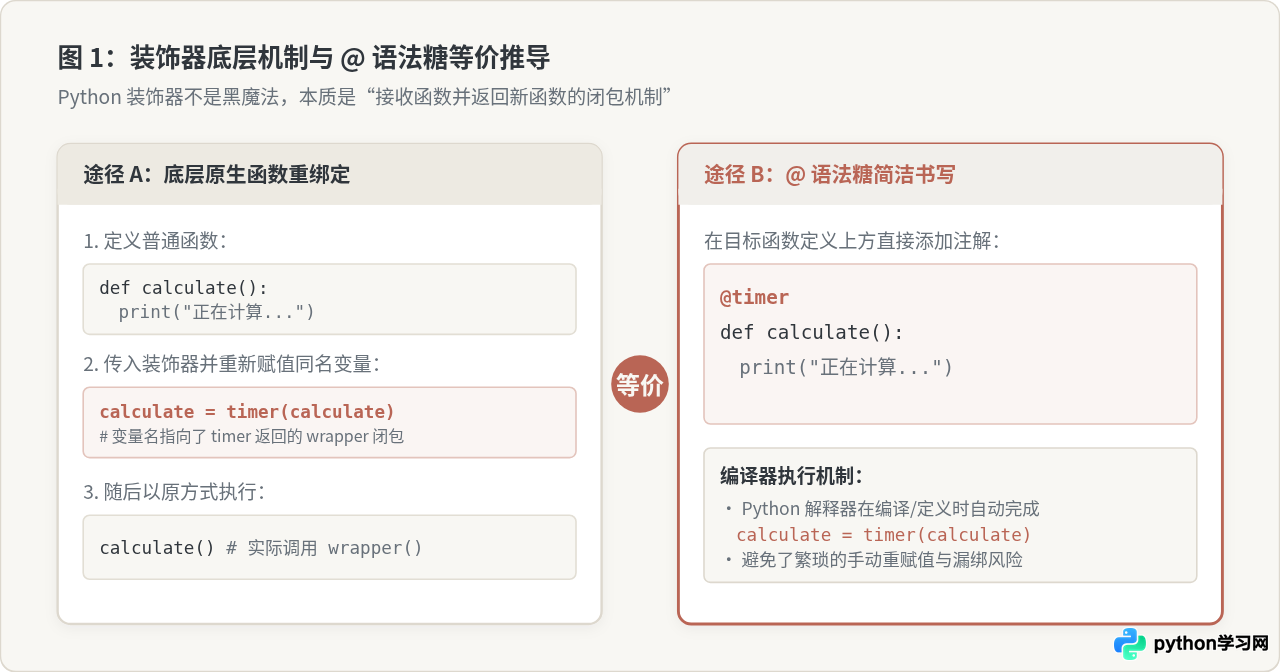
图 1:Python 装饰器底层机制与 @ 语法糖等价推导图
Python 引入的 @ 符号,只是对这一手动赋值过程的语法糖。在函数定义上方写下 @my_decorator,等价于在函数定义完成后立刻自动执行了 say_hello = my_decorator(say_hello)。
二、基础装饰器怎么写:通用参数、返回值与元信息保留
上一节的简单包装器存在明显限制:如果原函数带有入参或有返回值,直接调用 wrapper() 就会发生参数报错或丢失返回数据。一个能够在生产环境中通用的标准基础装饰器,必须解决以下三个核心问题:
- 通用参数支持:使用
*args, **kwargs接收任意位置参数和关键字参数,并原样透传给原函数。 - 完整保留返回值:使用变量接收原函数执行的返回值,并在包装器末尾通过
return显式返回。 - 保护原函数元信息:引入标准库
functools.wraps,防止装饰后函数名__name__、文档注释__doc__被篡改成"wrapper"。
标准基础装饰器模板
下面以一个测量函数执行耗时的计时装饰器 timer 为例,展示工业级基础装饰器的标准写法:
import time
import functools

def timer(func):
    @functools.wraps(func)  # 关键:将 func 的 __name__、__doc__ 等属性复制到 wrapper
    def wrapper(*args, **kwargs):
        start_time = time.perf_counter()
        # 1. 执行原函数并务必接收返回值
        result = func(*args, **kwargs)
        end_time = time.perf_counter()
        elapsed = end_time - start_time
        print(f"[耗时监控] 函数 {func.__name__} 执行耗时: {elapsed:.6f} 秒")
        # 2. 将原函数结果返回给外部调用者
        return result
    return wrapper

@timer
def calc_sum(n):
    """计算 1 到 n 的累加和"""
    return sum(range(1, n + 1))

# 测试调用
total = calc_sum(100000)
print(f"计算结果: {total}")
print(f"函数原名: {calc_sum.__name__}")
print(f"文档注释: {calc_sum.__doc__}")计算结果: 5000050000
函数原名: calc_sum
文档注释: 计算 1 到 n 的累加和
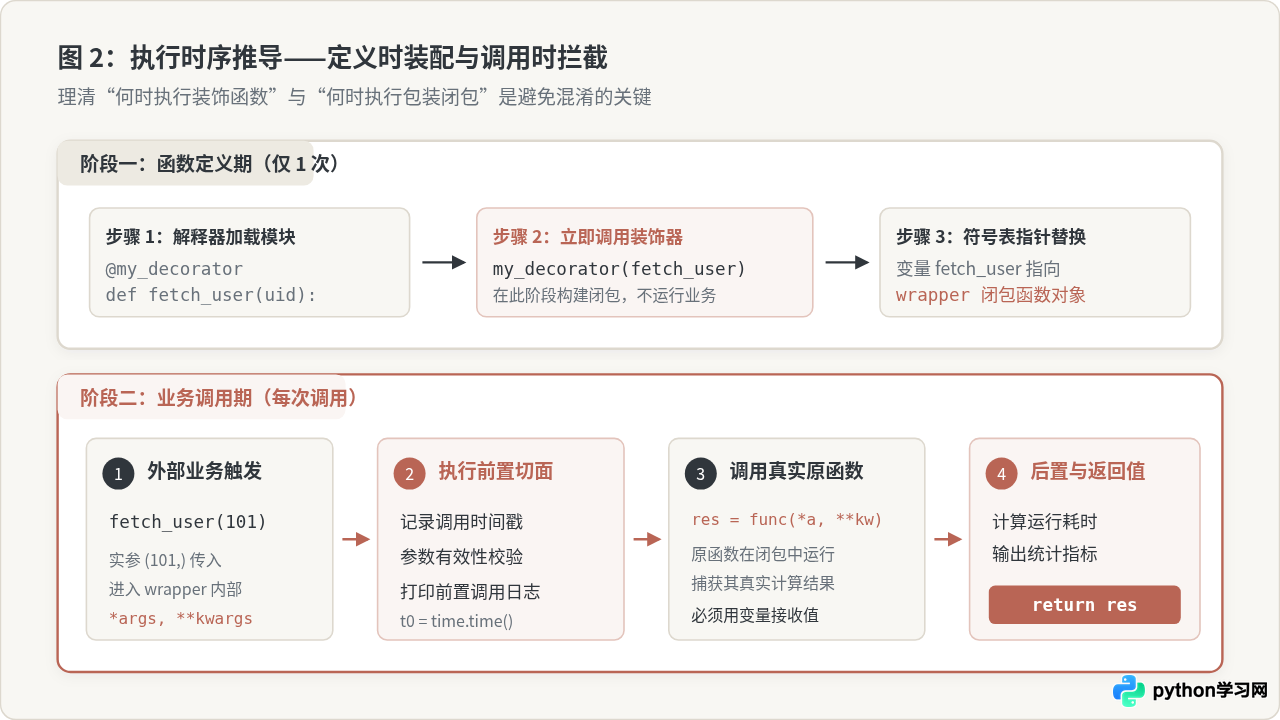
图 2:装饰器生命周期与调用执行时序图(定义期只装配一次,运行期每次拦截并透传数据)
装饰器外层函数(即 timer 本身)是在模块导入或函数被解释定义的时刻立即执行的,且仅执行一次;而内层的 wrapper 函数则是在每一次业务调用时才被激活运行。因此,不要在 timer 内部写每次调用都需要动态计算的逻辑。
三、带参数装饰器怎么写:拆解三层函数结构
在实际开发中,我们经常遇到需要根据外部配置改变装饰行为的需求。例如:
- 重试装饰器:指定失败重试次数
@retry(max_retries=3, delay=1) - 权限校验装饰器:指定角色要求
@require_role("admin") - 限流装饰器:指定时间窗口与频次
@rate_limit(calls=10, period=60)
思考一个问题:标准的 @decorator 接收的原函数作为参数。如果我们在装饰器后面加上了括号 @repeat(num=3),Python 解释器会怎么做?
解释器的规则非常明确:如果装饰器后面有括号,Python 会先执行这个带括号的函数调用,然后用这个函数调用的返回值作为真正的装饰器,再去修饰后面的目标函数!
也就是说,@repeat(num=3) 的完整执行过程等价于:
# 第一步:调用 repeat(num=3),返回真正的单参装饰器函数 actual_decorator
actual_decorator = repeat(num=3)

# 第二步:将原函数传入 actual_decorator,返回最终执行的 wrapper
target_func = actual_decorator(target_func)因此,要写出支持传参的装饰器,必须写三层嵌套函数:
- 第 1 层(最外层):普通函数,接收装饰器的配置参数(如
times、prefix),返回第 2 层装饰器。 - 第 2 层(中间层):标准装饰器,接收被修饰的目标函数
func,返回第 3 层包装器。 - 第 3 层(最内层):实际运行的
wrapper闭包,接收业务调用的*args, **kwargs,执行具体切面与原函数调用。
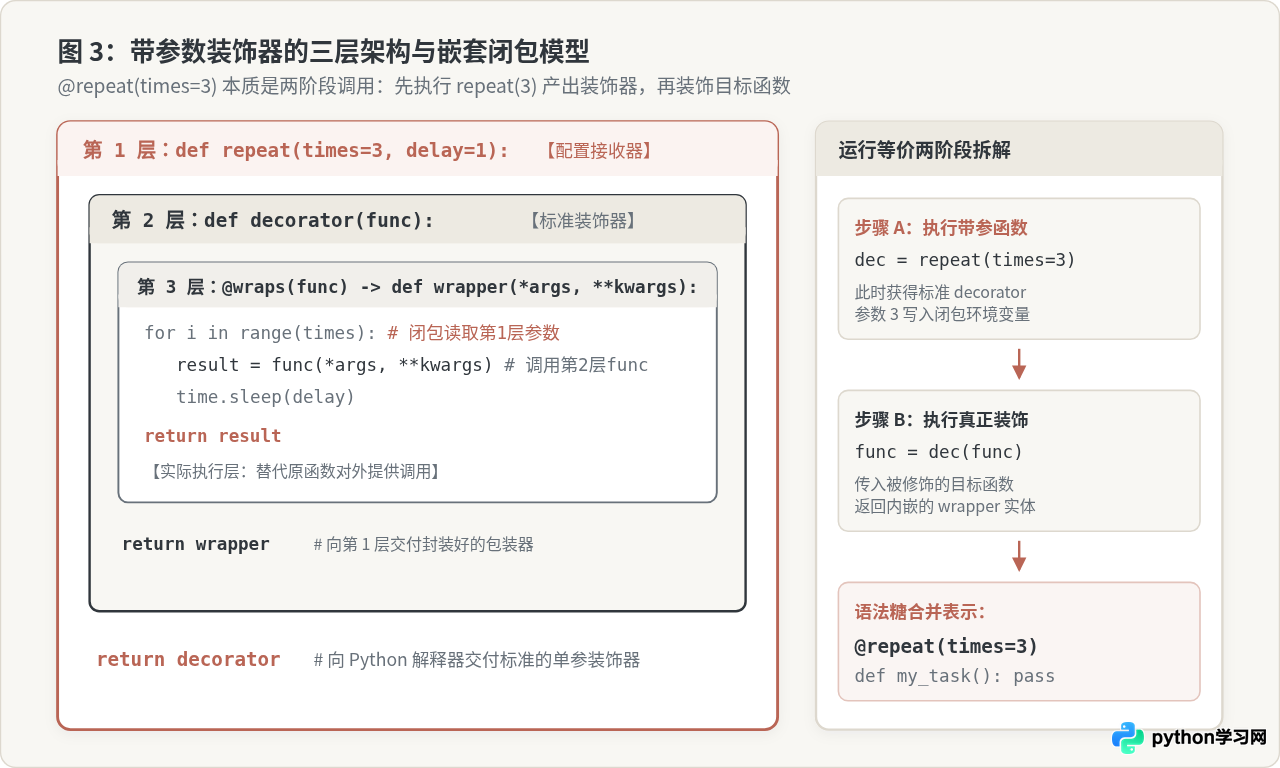
图 3:带参数装饰器的三层架构与嵌套闭包模型
带参数装饰器完整可运行示例:重复执行机制
下面的代码实现了一个带参数装饰器 repeat,允许开发者自定义函数执行的重复次数与打印标签:
import functools

def repeat(num=2, tag="INFO"):
    """第 1 层:接收装饰器配置参数"""
    def decorator(func):
        """第 2 层:接收被装饰的原函数"""
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            """第 3 层:接收原函数的实际调用参数"""
            last_result = None
            for i in range(1, num + 1):
                print(f"[{tag}] 第 {i}/{num} 次执行 {func.__name__}...")
                last_result = func(*args, **kwargs)
            return last_result
        return wrapper
    return decorator

# 使用带参装饰器:配置重复 3 次,标签为 'JOB'
@repeat(num=3, tag="JOB")
def sync_database(table_name):
    print(f"  -> 正在同步表: {table_name}")
    return f"{table_name}_ok"

# 触发业务执行
status = sync_database("user_orders")
print(f"最终执行状态: {status}")-> 正在同步表: user_orders
[JOB] 第 2/3 次执行 sync_database...
-> 正在同步表: user_orders
[JOB] 第 3/3 次执行 sync_database...
-> 正在同步表: user_orders
最终执行状态: user_orders_ok
通过闭包机制,最内层的 wrapper 可以毫无阻碍地访问来自第 1 层的配置变量 num、tag,以及来自第 2 层的函数对象 func,从而兼顾了灵活性与代码复用性。
四、常见误区与避坑清单
在编写装饰器时,有几个看似微小但极容易引发隐蔽 Bug 的典型错误,务必在编写后进行对照检查:
1. 包装器内部漏写 return
这是新手最常犯的错误。在 wrapper 内部虽然调用了 func(*args, **kwargs),但没有把这个结果返回出来。外部调用代码接收到的返回值将永远是默认的 None。无论原函数内部返回什么数据,都会被装饰器无声吞噬。
2. 忘记使用 @functools.wraps
如果不加 @functools.wraps(func),原函数的 __name__ 会变成 "wrapper",帮助文档 __doc__ 会变成 wrapper 的文档甚至为空。这不仅影响调试、日志输出和 Sphinx 文档自动生成,还会在使用 Flask、FastAPI 等基于函数名进行路由注册的框架时引发严重的函数名覆盖或路由冲突异常。
3. 混淆有参和无参装饰器的调用括号
无参装饰器 @timer 是直接将函数对象传入,绝不能写成 @timer();而带参装饰器 @repeat(num=3) 是先执行工厂函数,必须加括号。如果带参装饰器设置了默认参数且希望全部使用默认值,也必须保留空括号,写成 @repeat(),否则解释器会将目标函数当成 num 参数传入,导致抛出参数类型异常。
4. 多个装饰器的堆叠顺序
当一个函数上方同时应用多个装饰器时:
@decorator_a
@decorator_b
def target():
    pass
其装配顺序等价于 target = decorator_a(decorator_b(target))。即:自下而上装配(先执行 b 后执行 a),但在业务调用时是自上而下进入(先穿过 a 的包装层,再穿过 b 的包装层,最后进入原函数)。涉及鉴权与数据转换时,务必根据依赖关系正确排列顺序。
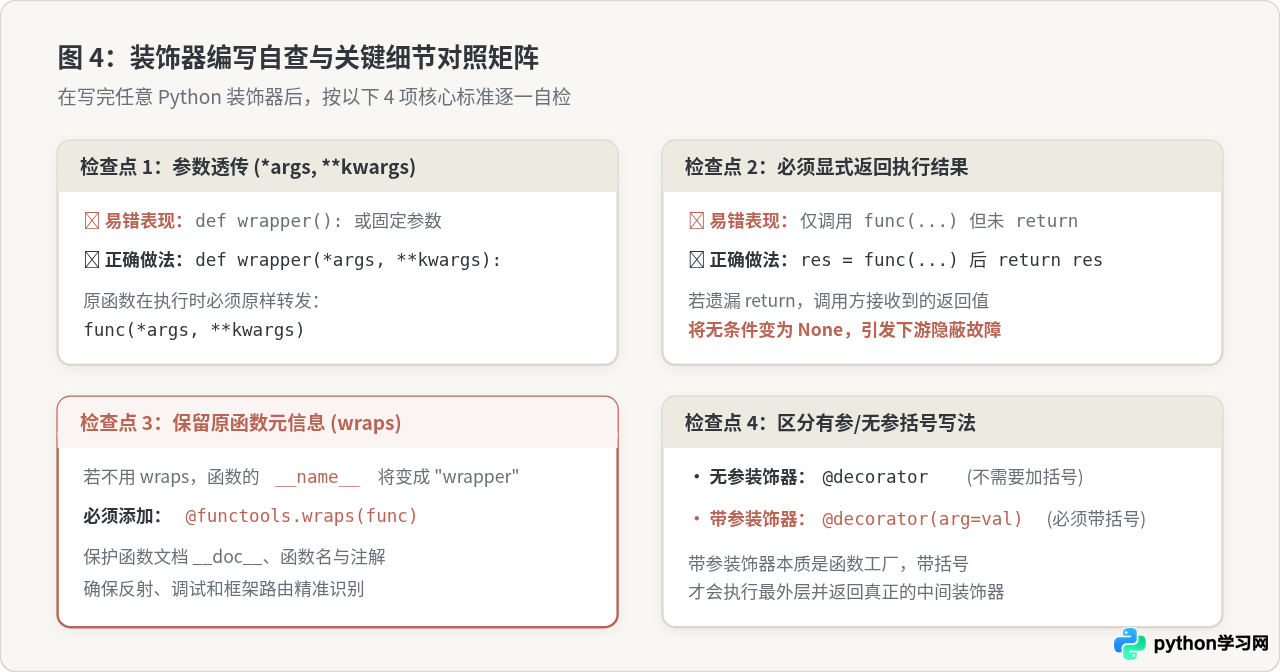
图 4:Python 装饰器自查与关键细节对照矩阵
五、总结与自查备忘
编写 Python 装饰器的核心技巧,归纳起来就是“两套模板”与“四项检查”:
| 分类 | 函数层级 | 书写形态 | 核心口诀 |
|---|---|---|---|
| 基础无参装饰器 | 两层嵌套 | @decorator |
外层收原函数,内层收实参,wraps 护名牌,千万记得 return |
| 带参数装饰器 | 三层嵌套 | @decorator(args) |
最外层造工厂,中间收函数,内层办业务,带参必须加括号 |
只要掌握了闭包捕获外部变量的本质,遵循 *args, **kwargs 透传与 functools.wraps 规范,就能写出结构严谨、维护方便的高质量 Python 装饰器。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









