

Python第三方库分类概览:主流领域库数量分布情况
全面梳理Python官方包索引PyPI中第三方库的分类机制与主流领域的数量分布格局,解析Web开发、数据科学、人工智能、系统运维等领域的规模特征与选型依据。
一、PyPI 分类机制与总量分布概况
要客观统计Python第三方库的数量分布,必须依赖统一的分类标准。Python打包与发布标准通过 Trove Classifiers(分类器标签系统)对包进行语义归类。开发者在 pyproject.toml 或 setup.py 中声明 Topic :: ... 属性,指明该库面向的技术应用场景。
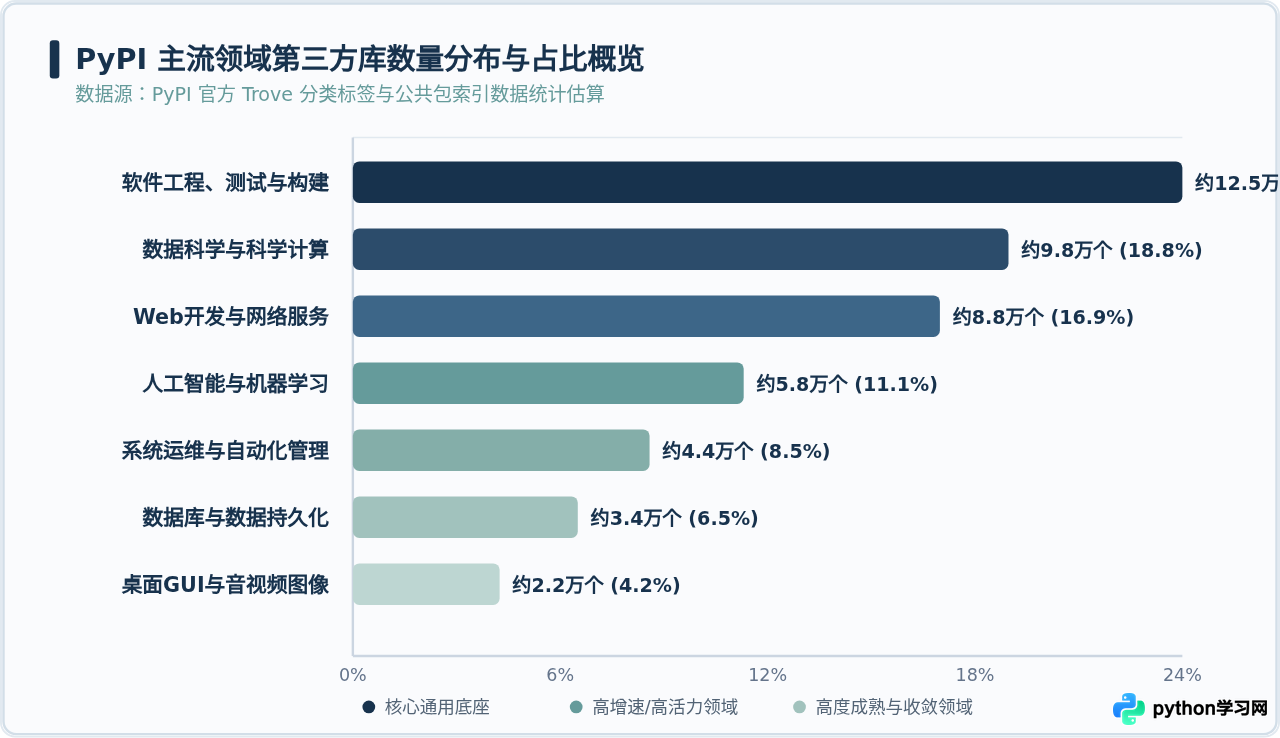
在全量收录的50余万个项目中,库的数量分布并不等同于其实际生产使用率。统计分析表明,所有库中有约35%到40%属于持续活跃维护状态(近两年内有版本更新),其余则属于功能已经完备稳定封版、教学实验样例,或随时间沉淀的非活跃归档包。各技术领域由于业务需求规模、开发参与门槛以及底层依赖复杂度的差异,在库的总量累积上表现出明确的梯队划分。
二、主流领域生态层级与库分布特征
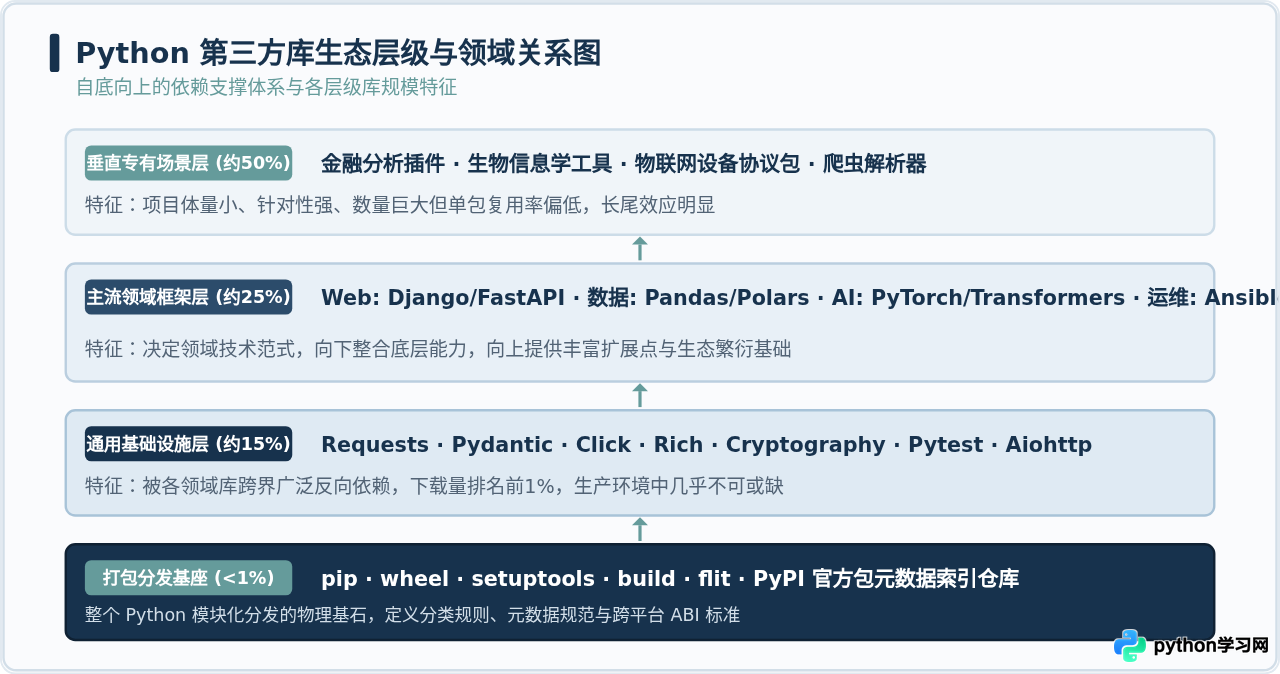
深入剖析各个主流领域的内部结构可以发现,Python 第三方库不仅在总体数量上有梯次,在生态垂直分层上也表现出各自鲜明的生命力与依赖特征。
| 主流领域 | 预估库数量 | 主要代表性库 | 生态演进与分布特征 |
|---|---|---|---|
| 软件工程、测试与构建 | 约 12.5 万 | pytest, flake8, black, click, pydantic | 基数极大,衍生插件丰富,周边扩展包占比高。 |
| 数据科学与科学计算 | 约 9.8 万 | numpy, pandas, scipy, polars, matplotlib | 核心算法重度依赖底层编译,上层垂直分析包繁荣。 |
| Web开发与网络服务 | 约 8.8 万 | django, fastapi, flask, requests, aiohttp | 框架生态高度成熟,包含大量中间件、鉴权与接口适配器。 |
| 人工智能与机器学习 | 约 5.8 万 | torch, tensorflow, scikit-learn, transformers | 新库发布最密集,大语言模型与智能体框架拉动新一轮井喷。 |
| 系统运维与自动化管理 | 约 4.4 万 | ansible, paramiko, supervisor, psutil | 以设备操作、批处理脚本与基础设施对接工具为主。 |
| 数据库与数据持久化 | 约 3.4 万 | sqlalchemy, pymongo, psycopg2, redis | 关系型、文档型及缓存数据库驱动与ORM层标准分明。 |
| 桌面GUI与多媒体处理 | 约 2.2 万 | PyQt, PySide, pillow, opencv-python | 技术门槛高,核心库依赖跨平台C++库绑定,数量相对收敛。 |
从依赖关系来看,不同领域的库并不是相互孤立的,而是形成了从“底层打包分发”到“通用基础设施”,再向上延伸至“垂直业务与专有应用”的立体结构。
三、如何自行查询与统计领域库分布
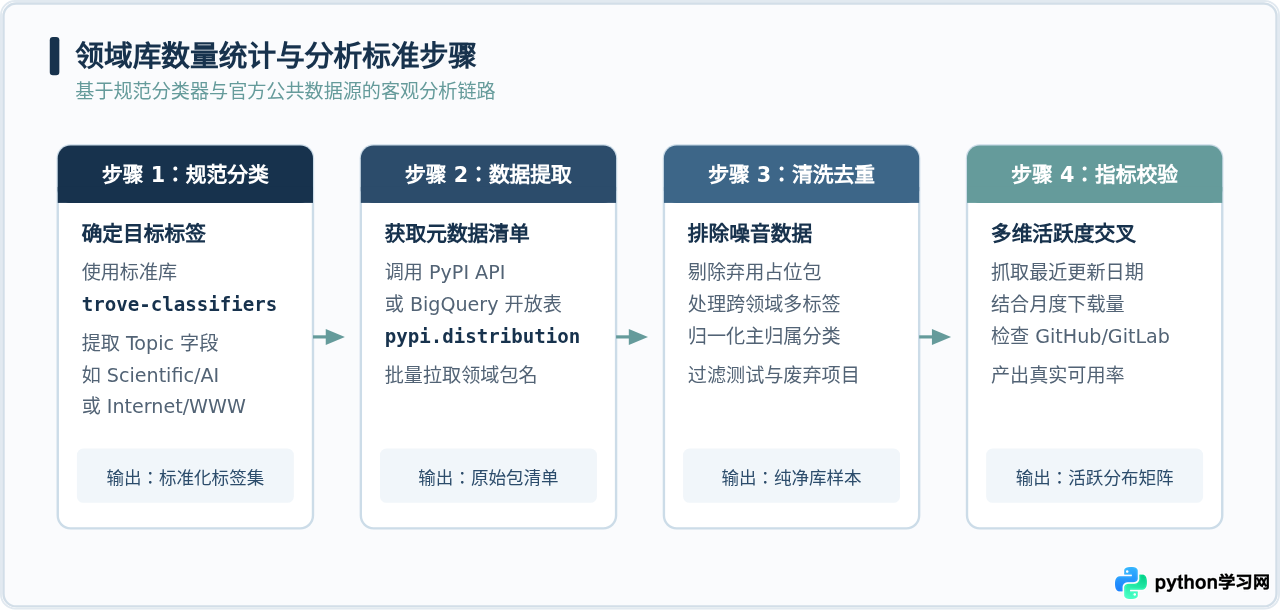
对于工程团队架构师或技术选型负责人,了解某个特定领域的库分布不是靠主观猜测,而是可以通过标准流程进行程序化度量。以下是标准四步排查流程:
代码示例:检索与统计特定主题下的官方分类器
在本地环境中,可以通过安装官方维护的 trove-classifiers 库快速读取所有合法的分类器路径:
# 确保本地已安装分类器工具包
# pip install trove-classifiers

from trove_classifiers import classifiers

# 筛选以 Topic 开头的主题分类器
topic_classifiers = [c for c in classifiers if c.startswith("Topic :: ")]

# 提取主流领域的顶层分类
domains = {}
for item in topic_classifiers:
    parts = item.split(" :: ")
    main_domain = parts[1]
    domains[main_domain] = domains.get(main_domain, 0) + 1

print(f"当前官方支持的主题分支总数: {len(topic_classifiers)}")
for domain, count in sorted(domains.items(), key=lambda x: x[1], reverse=True)[:6]:
    print(f"领域: {domain:<25} 官方预设细分子分类数: {count}")
示例运行输出:
当前官方支持的主题分支总数: 382
领域: Software Development      官方预设细分子分类数: 84
领域: Scientific/Engineering    官方预设细分子分类数: 62
领域: Internet                  官方预设细分子分类数: 48
领域: System                    官方预设细分子分类数: 36
领域: Database                  官方预设细分子分类数: 19
领域: Multimedia                官方预设细分子分类数: 15
一个包可以同时声明多个不同的分类器(例如一个机器学习项目既声明了 Topic :: Scientific/Engineering :: Artificial Intelligence,又声明了 Topic :: Software Development :: Libraries)。如果直接按分类器标签累计求和,结果一定会大于库的总数。因此在跨领域分析时,必须确定是按“包归属去重”还是按“标签命中频次”统计。
四、数量分布规律背后的技术选型决策
了解第三方库的数量分布,最终目的是指导工程实践中的技术选型。库数量的多与少,直接对应着该领域截然不同的生态特征与决策依据:
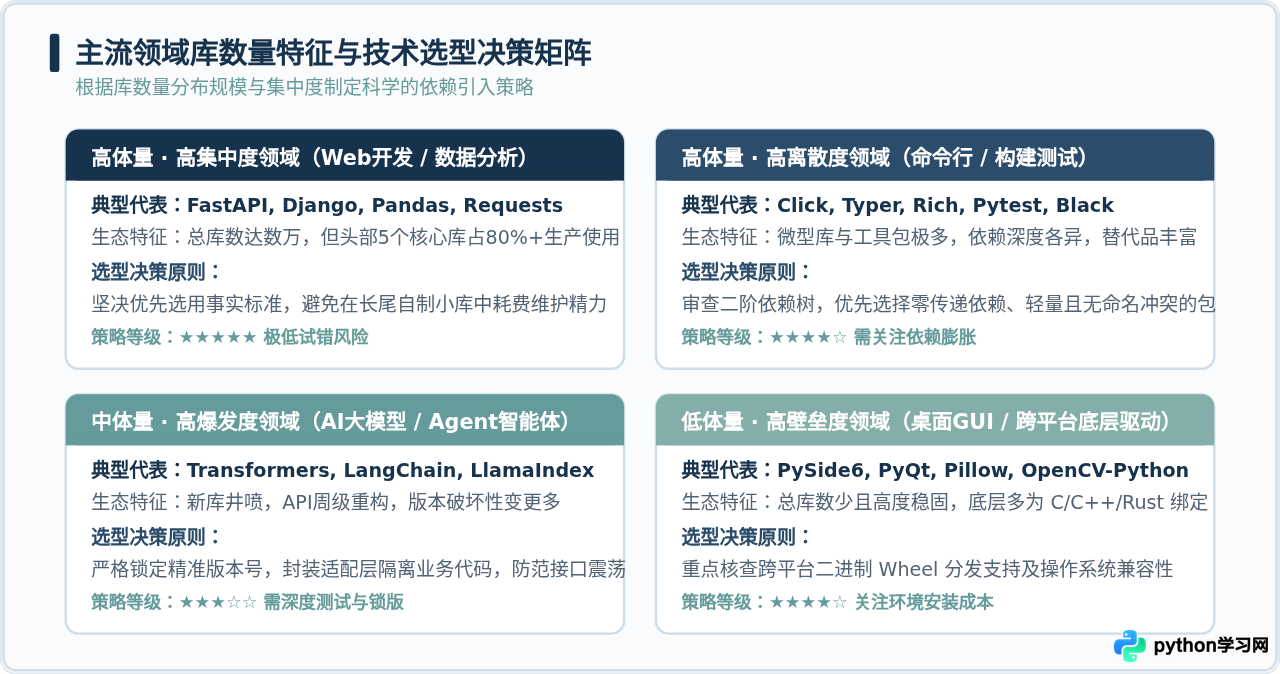
- 成熟高集中度领域:拥抱事实标准。 在 Web 框架与常规数据分析领域,虽然存在数以万计的库,但绝大多数为冷门适配包。选择核心库(如 FastAPI、Pandas)拥有更完善的中文文档、更稳固的安全补丁周期和更丰富的招聘生态。
-
高爆发新兴领域:防御性引入。
在人工智能和大语言模型相关库中,由于技术迭代极快,许多库在半年内停止维护。项目引入时务必评估其 GitHub 提交频次、Issue 关闭率与主要维护组织背景,并必须在
requirements.txt或poetry.lock中固定确切版本。 -
底层硬件与音视频领域:优先二进制分发。
对于图形界面、音频处理或驱动相关的库,数量虽少,但安装常面临 C 编译器缺失或依赖库版本冲突问题。选型时务必优先确认 PyPI 上是否提供针对目标操作系统与架构的预编译
manylinux或universal2Wheel 包。
五、总结与建议
Python 第三方库的数量分布客观反映了近二十年来全球软件工程需求演进的脉络。从早期由 Web 开发、系统脚本主导,到中期由数据科学、数值计算驱动,再到当下全面涌向大模型与自动化智能体,各个领域的库数量在规模与活跃度上呈现梯次分布。
在日常开发和技术架构评审中,应当跳出“库数量越多越好”或“只看下载排行榜”的单一片面认知,结合官方 Trove 分类器的语义规范、生态分层位置以及具体的业务稳定性要求,合理选择处于健康生命周期的第三方依赖。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









