

Python字符串处理基础代码:拼接、切片与格式化
深入解析Python字符串处理的基础代码与核心机制,系统讲解字符串拼接、切片提取、f-string格式化排版等实用方法,并提供完整代码示例、性能分析与避坑指南。
"USER_20261024_9821_PAID"。若想从中提取生成日期、用户编号与支付状态,并重新整理为规范的报表输出,最直接、可靠的工具就是 Python 原生提供的字符串拼接、切片与格式化。本文通过具体代码与原理图示,梳理这三项基础能力的核心语法与选型依据。
一、字符串拼接:实现文本连接与效率权衡
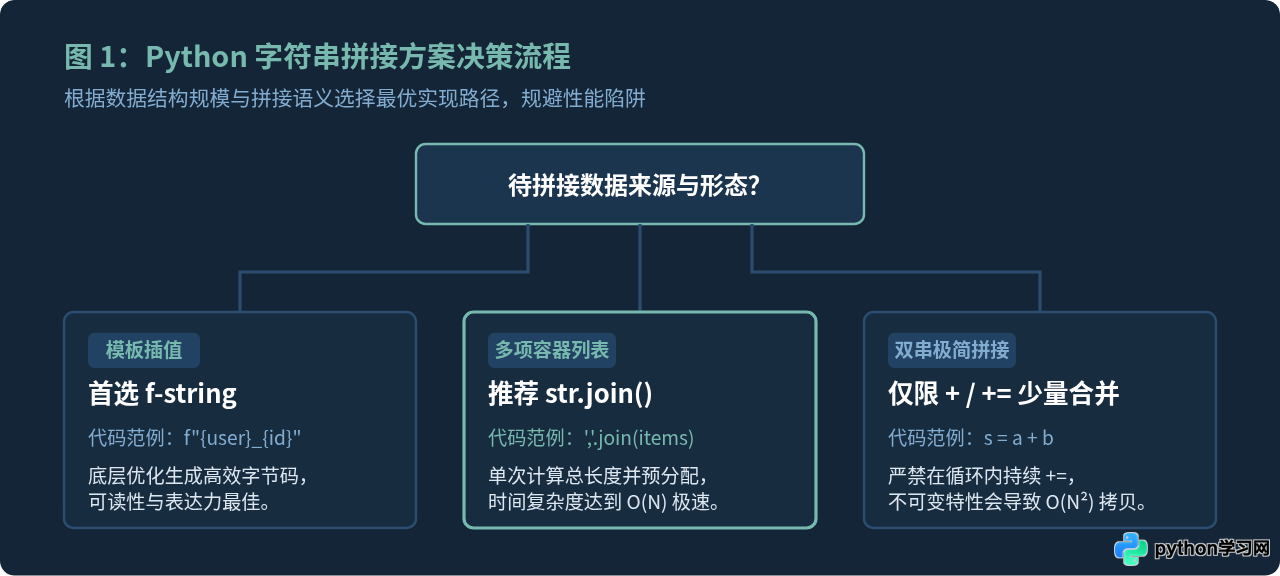
字符串拼接是将两个或多个独立的字符串序列组合成一个新文本的操作。在 Python 中,字符串(str)属于不可变对象(Immutable),任何拼接动作在底层都不会修改原有内存块,而是分配新的内存空间存放合成后的文本。根据待合并数据的规模与场景,主要有三种实现方式。
1. 使用加号运算符(+ 与 +=)
加号运算符适合两三个固定变量或短文本的临时连接,语法直观,符合直觉:
# 示例:基础加号拼接
first_name = "Guido"
last_name = "van Rossum"
full_name = first_name + " " + last_name
print("拼接结果:", full_name)

# 使用 += 累加
status = "Status: "
status += "Ready"
print("状态输出:", status)拼接结果: Guido van Rossum
状态输出: Status: Ready
需要注意的是,加号拼接两端必须均为 str 类型。如果包含整数或浮点数,必须显式调用 str() 进行转换,否则会抛出 TypeError。
2. 使用 str.join() 批量合并序列
当需要把列表、元组或生成器中的大量字符串合并时,必须使用 str.join() 方法。它是处理批量数据的标准做法:
# 示例:列表连接
log_tokens = ["2026-10-24", "10:30:00", "INFO", "Worker-1", "Task Completed"]
# 使用空字符或特定分隔符连接
log_line = " | ".join(log_tokens)
print("日志拼接:", log_line)

# 数字列表先转为字符串再合并
id_list = [101, 102, 103, 104]
csv_row = ",".join(str(i) for i in id_list)
print("CSV行输出:", csv_row)日志拼接: 2026-10-24 | 10:30:00 | INFO | Worker-1 | Task Completed
CSV行输出: 101,102,103,104
for 循环中持续使用 s += token 会导致频繁的内存开辟与整串拷贝,时间复杂度退化至 O(N²)。而 join() 会先在底层遍历一次计算出合并所需的准确内存总量,单次申请空间并完成复制,保证了 O(N) 的线性执行效率。
二、字符串切片:精准抽取与序列反转
切片(Slicing)是 Python 中从有序序列中抽取子片段的核心语法。切片的基本结构为 s[start:stop:step],其中包含三个可选参数,均以冒号分隔。
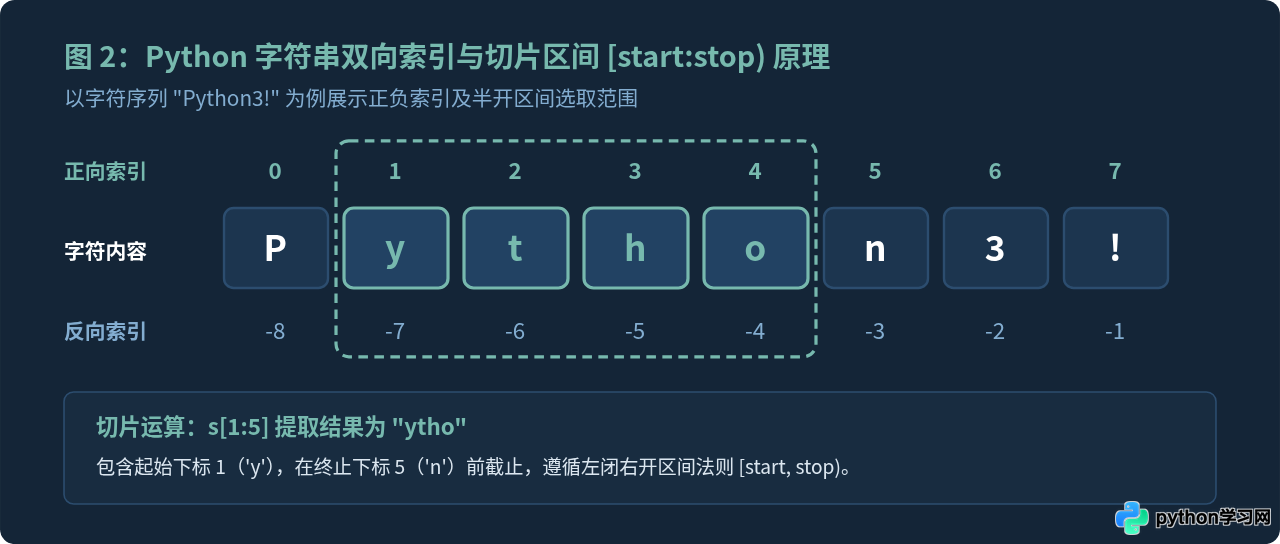
1. 索引体系与半开区间机制
Python 支持正向与反向双向索引:
- 正向索引:从序列最左侧的
0开始递增至length - 1。 - 反向索引:从序列最右侧的
-1开始递减至-length。
切片严格遵循数学上的左闭右开区间 [start, stop),即包含 start 处的元素,但不包含 stop 处的元素:
raw = "Python3!"

# 截取索引 1 到 4(实际在 5 处截止,不含 5)
sub = raw[1:5]
print("s[1:5] 提取结果:", sub)

# 省略 start 表示从头开始,省略 stop 表示截取到末尾
prefix = raw[:6]
suffix = raw[6:]
print("前缀 raw[:6]:", prefix)
print("后缀 raw[6:]:", suffix)s[1:5] 提取结果: ytho
前缀 raw[:6]: Python
后缀 raw[6:]: 3!
2. 步长控制与逆序切片
step 参数决定每次移动的跨度与方向:
step > 0:从左向右步进,默认值为 1。step < 0:从右向左反向步进。最经典的用法是s[::-1],用于原地获得逆序字符串。
digits = "0123456789"

# 步长为 2:提取偶数位数字
evens = digits[::2]
print("偶数位提取:", evens)

# 步长为 -1:完全逆序翻转
reversed_str = digits[::-1]
print("字符串翻转:", reversed_str)

# 倒序截取子片段(注意 start 应大于 stop)
rev_part = digits[8:2:-2]
print("倒序跳跃截取:", rev_part)偶数位提取: 02468
字符串翻转: 9876543210
倒序跳跃截取: 864
s[100] 在越界时会立即抛出 IndexError: string index out of range。但切片操作 s[0:100] 会自动容错并优雅地截断到字符串边界,返回现有内容而不抛错。
三、字符串格式化:从历史演进到 f-string 精准排版
格式化操作用于将变量值填入既定的文本模板中,并根据需要对数字精度、对齐填充、日期时间等进行精密排版。
1. 格式化演进简述
- % 运算符(早前方式):源自 C 语言
printf风格(如"Count: %d" % 10),易用性较低且不支持灵活的字典解构。 - str.format()(Python 2.6+):通过
"{0} is {1}".format(a, b)实现了位置与关键字参数匹配,但在长字符串中较为冗长。 - f-string(Python 3.6+ / PEP 498):格式化字符串字面量(Formatted String Literals),以
f或F开头,支持直接在花括号内编写变量名与 Python 表达式,是目前官方推荐的首选方案。
2. f-string 基础求值与说明符结构
在 f-string 的花括号中,冒号 : 左侧为需要求值的变量或表达式,冒号右侧为格式说明符(Format Specifier):
name = "Alice"
score = 92.4568
rank = 3

# 基础表达式求值
print(f"学员 {name.upper()} 的计算得分: {score * 1.05:.2f}")

# 冒号后指定格式规范:浮点截取与整数补零
print(f"排名编号: {rank:04d} | 最终成绩: {score:.2f}")学员 ALICE 的计算得分: 97.08
排名编号: 0003 | 最终成绩: 92.46
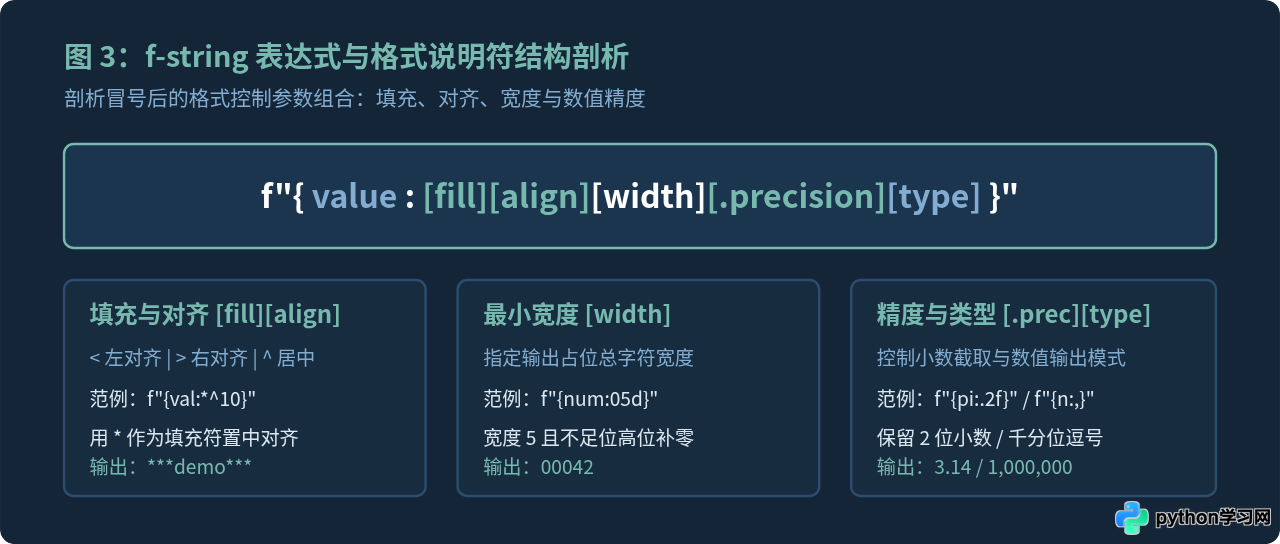
3. 对齐填充与千分位排版
在生成文本报表或对齐终端打印时,对齐说明符极其好用:
# 文本对齐排版
title = "REPORT"
amount = 1258900.5

print(f"{title:=^30}")
print(f"账户金额(带千分位): {amount:>15,.2f}")
print(f"进度标记: {'DONE':.<15}")============REPORT============
账户金额(带千分位): 1,258,900.50
进度标记: DONE...........
四、综合实战:流水日志解析与报表重构
将拼接、切片与格式化协同运用的最佳场景就是处理结构化日志。以下演示一个完整的日志处理脚本:从格式杂乱的单行日志中截取元数据,清洗后格式化输出为排版对齐的财务对账单。
# 综合代码实战:解析原始交易流水并生成标准化报表
raw_records = [
    "TX_20261024_U0921_AMT:00450.80_STATUS:OK",
    "TX_20261024_U1044_AMT:12800.00_STATUS:OK",
    "TX_20261024_U0038_AMT:00015.50_STATUS:FAIL",
]

report_rows = []
header = f"{'交易日期':<12} | {'用户编号':<10} | {'交易金额(元)':>14} | {'状态'}"
separator = "-" * 50
report_rows.append(header)
report_rows.append(separator)

total_valid_amount = 0.0

for line in raw_records:
    # 1. 切片操作:利用固定偏移量抽取数据
    date_str = line[3:11]                          # "20261024"
    formatted_date = f"{date_str[:4]}-{date_str[4:6]}-{date_str[6:]}"
    user_id = line[12:17]                          # "U0921"

    # 2. 切片配合查找定位动态金额
    amt_start = line.find("AMT:") + 4
    amt_end = line.find("_STATUS")
    amount_float = float(line[amt_start:amt_end])

    status = line.split(":")[-1]
    if status == "OK":
        total_valid_amount += amount_float

    # 3. 格式化:对齐与千分位排版
    row_text = f"{formatted_date:<12} | {user_id:<10} | {amount_float:>14,.2f} | {status}"
    report_rows.append(row_text)

report_rows.append(separator)
report_rows.append(f"有效交易总额统计: {total_valid_amount:,.2f} 元")

# 4. 字符串拼接:通过 join 单次输出报表全文
final_report = "\n".join(report_rows)
print(final_report)交易日期 | 用户编号 | 交易金额(元) | 状态
--------------------------------------------------
2026-10-24 | U0921 | 450.80 | OK
2026-10-24 | U1044 | 12,800.00 | OK
2026-10-24 | U0038 | 15.50 | FAIL
--------------------------------------------------
有效交易总额统计: 13,250.80 元
五、关键避坑指南与选型总结
在日常编写字符串处理逻辑时,读者最常遇到的陷阱集中在语法符号冲突与内存边界上:
- f-string 中输出字面量花括号:如果最终文本本身需要包含
{或}(如构造 JSON 或 SQL 片段),需要连续书写两个花括号进行转义,例如f"{{'user': '{name}'}}"输出为"{'user': 'Alice'}"。 - 切片与索引下标的区别:单索引
s[i]必须保证-len(s) <= i < len(s);若处理来源不受控的外部输入,使用切片s[i:i+1]可以在下标越界时安全返回空字符串"",避免脚本中断。 - join() 的入参约束:
str.join()仅接受元素全部为字符串的可迭代对象。若列表包含整数,直接传入会触发TypeError: sequence item 0: expected str instance, int found,必须配合生成器推导式或map(str, seq)。
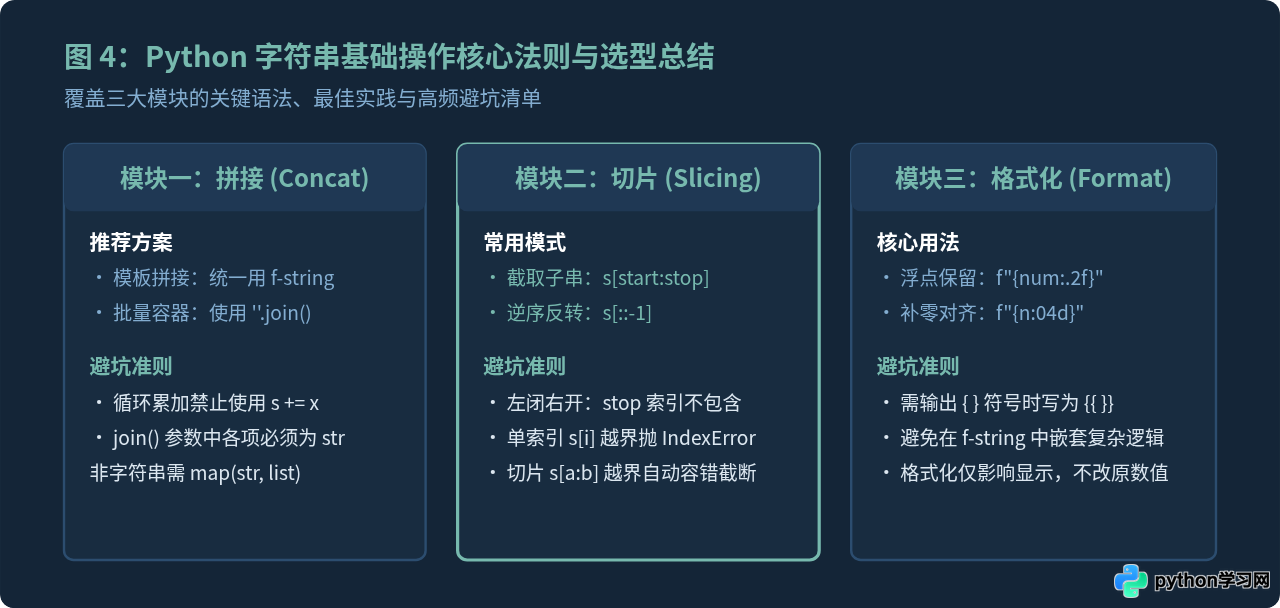
速查对照表格
| 操作分类 | 核心代码模式 | 核心优势 | 主要约束 / 适用场景 |
|---|---|---|---|
| 少量字符串拼接 | s1 + s2 或 f"{s1}{s2}" |
语法简单直观,开发负担小 | 仅适用于固定少量元素;严禁在循环内重复累加 |
| 批量容器合并 | "".join(seq) |
O(N) 极速单次内存分配 | 入参必须均为 str;处理多项列表时的标准手段 |
| 范围截取 | s[start:stop] |
半开区间易计算偏移,越界自动容错截断 | 不包含右端点;若只需单个字符且严查存在性用索引 |
| 步长逆序 | s[::-1] |
单行实现翻转,底层 C 原生循环 | 步长为负时,起始位置应大于终止位置 |
| 精准排版格式化 | f"{val:>10.2f}" |
表达力最强,原生支持内联表达式 | Python 3.6+ 支持;需要转义花括号时写为 {{ }} |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









