

怎么向面试官讲清pandas3.0的CoW解决了什么痛点?
详细拆解如何向面试官讲清 pandas 3.0 默认启用的 Copy-on-Write (CoW) 机制。从老版本的视图与副本薛定谔状态、防御性复制内存膨胀,到 CoW 的引用追踪与写时克隆原理,提供清晰的 4 步应答逻辑与实战代码验证。
在 Python 数据分析或数据工程面试中,当面试官问到“谈谈 pandas 3.0 的 Copy-on-Write(CoW)”时,最忌讳的是直接背诵死记硬背的概念。向面试官讲清这个特性的核心路径非常明确:先用一句话提炼核心矛盾,接着拆解“行为不确定性(薛定谔的切片)”与“防御性复制带来的内存开销”两大具体痛点,然后解释 CoW 如何通过“只读引用与延迟克隆”彻底解除耦合,最后给出规范代码与迁移建议。
一、开篇定调:向面试官交出的“一句话答卷”
在面试中,听到该问题时切忌东拉西扯。首先用沉稳而明确的结论定调:
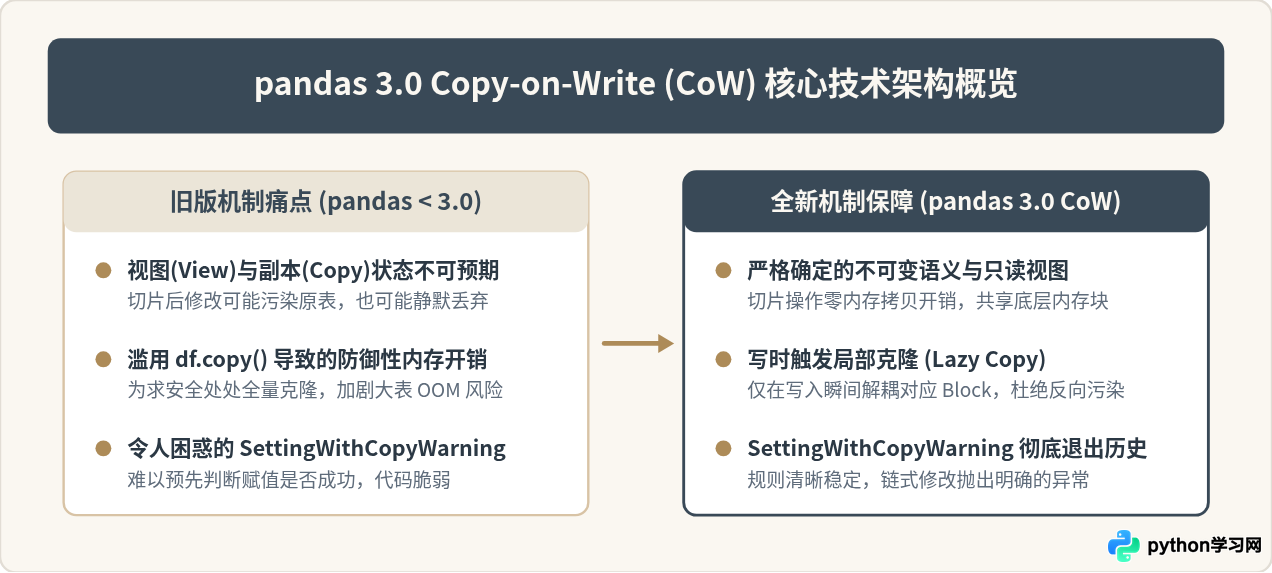
“pandas 3.0 默认启用的 Copy-on-Write(写时复制)机制,本质上是为了终结 pandas 长期以来‘视图(View)与副本(Copy)行为不可预期’的历史包袱。它彻底解决了由此衍生出的静默数据污染风险、令人困扰的 SettingWithCopyWarning 假阳性/假阴性报错,以及为了写出安全代码而被迫滥用
df.copy() 导致的严重内存膨胀与性能损耗。”
这句话交代了机制名称、解决的核心矛盾、引发的表面现象以及深层的性能损失,立刻能向面试官建立起结构化的专业印象。紧接着,便可以根据面试官的反应,逐步切入具体痛点细节。
二、痛点深度剖析:为什么老版本 pandas 让人痛苦?
要讲清 CoW 解决了什么,就必须把老机制的弊端通过具体案例讲透。老版 pandas 在底层内存设计上有两个无法调和的矛盾:
1. 薛定谔的切片:View 还是 Copy 纯凭底层运气
在 pandas 3.0 之前,对一个 DataFrame 进行切片或列提取操作时,返回的究竟是底层 NumPy 数组的引用(View)还是完整的独立副本(Copy),取决于内部极其复杂的内存组织结构(BlockManager)。
- 如果数据是单一类型且内存连续,切片通常是 View;
- 如果涉及跨类型列合并、非连续内存块整合(Consolidation)或条件过滤(布尔掩码),pandas 往往悄悄生成了 Copy;
- 更有甚者,先赋值再修改,底层可能会在 View 和 Copy 之间动态切换。
这种不确定性导致了数据工程中最致命的 Bug:静默数据篡改与赋值丢失。开发者以为自己修改的是子集,结果源数据被意外改写;或者开发者以为修改了源数据,结果改动随着临时副本的销毁凭空蒸发。
# 老版本(无 CoW)下的典型混乱行为示例
import pandas as pd

df = pd.DataFrame({"a": [1, 2, 3], "b": [10, 20, 30]})

# 场景 A:开发者做切片后修改
sub = df[["a"]]        # 某些情况下是 view,某些情况下是 copy
sub.iloc[0, 0] = 999 # 此时是否修改了 df['a']?无法直观保证,且弹出警告!SettingWithCopyWarning: A value is trying to be set on a copy of a slice from a DataFrame.
Try using .loc[row_indexer,col_indexer] = value instead
这个经典的 SettingWithCopyWarning 并没有真正解决问题,而是把困惑丢给了用户:即使使用了 .loc,很多链式调用的中间步骤依然可能产生假警告或漏报警告。
2. 防御性复制(Defensive Copying)的资源黑洞
为了规避上述隐式污染问题,几乎所有生产环境中的代码规范、教程和团队代码审查都会强制要求:“只要做切片或传递 DataFrame,立刻显式调用 .copy()”。
这种做法虽然带来了代码安全性,却造成了极其沉重的性能代价。原本一个 2GB 的 DataFrame,经过几个清洗函数或特征工程管道处理后,内存中可能同时存在 4 到 5 个结构完全一致的完全拷贝。内存开销翻倍,极易触发操作系统的 OOM(Out Of Memory),同时也让无谓的内存分配和 CPU 缓存失效严重拖慢处理速度。
三、CoW 的工作原理:只读引用与延迟克隆
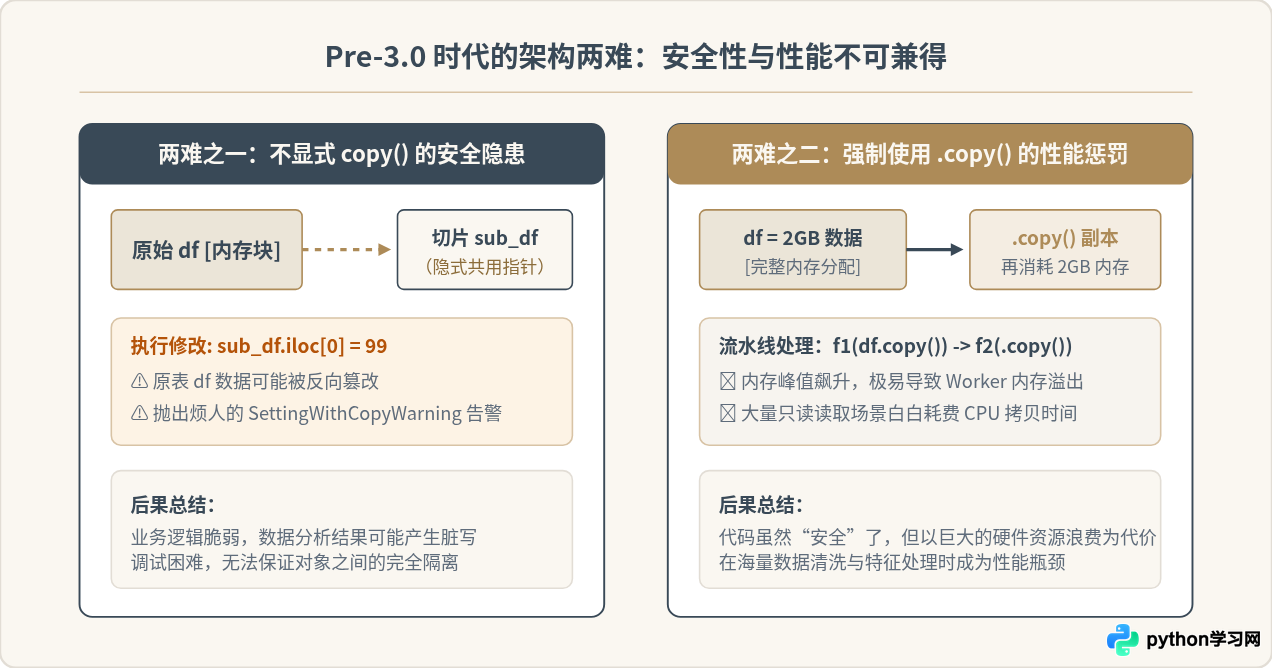
面试官紧接着一定会考察技术底层:“既然不拷贝,又怎么做到修改时互不影响?”这就需要清晰讲出 Copy-on-Write 的底层生命周期。
在计算机操作系统(例如 fork() 进程创建)和现代虚拟内存管理中,Copy-on-Write 是一种经典的设计哲学。pandas 3.0 的核心正是将其引入了 DataFrame 的内存管理中:
- 引用共享(Zero-Copy Slicing):当你对一个 DataFrame 执行切片、提取某些列或通过布尔条件筛选时,pandas 绝不发生深拷贝。新对象仅仅持有一个指向底层相同数据块(Block)的指针,并将底层数据标记为只读共享状态。这一步的内存开销与耗时几乎为零。
- 引用计数追踪(Reference Tracking):底层数据块维护内部引用计数。只要该数据块同时被多个 DataFrame 或 Series 引用,它就处于保护模式。
- 写时触发克隆(Clone on Write):当且仅当某一个对象尝试执行写入操作(如
sub.iloc[0, 0] = 999或sub['col'] = new_val)时,pandas 才会侦测到底层数据处于共享状态。此时,pandas 会在后台自动为这个修改对象单独克隆被修改的对应数据块,完成解耦后再执行写入。 - 原对象绝不被污染:源 DataFrame 依然指向原来的底层数据块,其内容分毫不动。
四、向面试官作答的“四步实战应答框架”
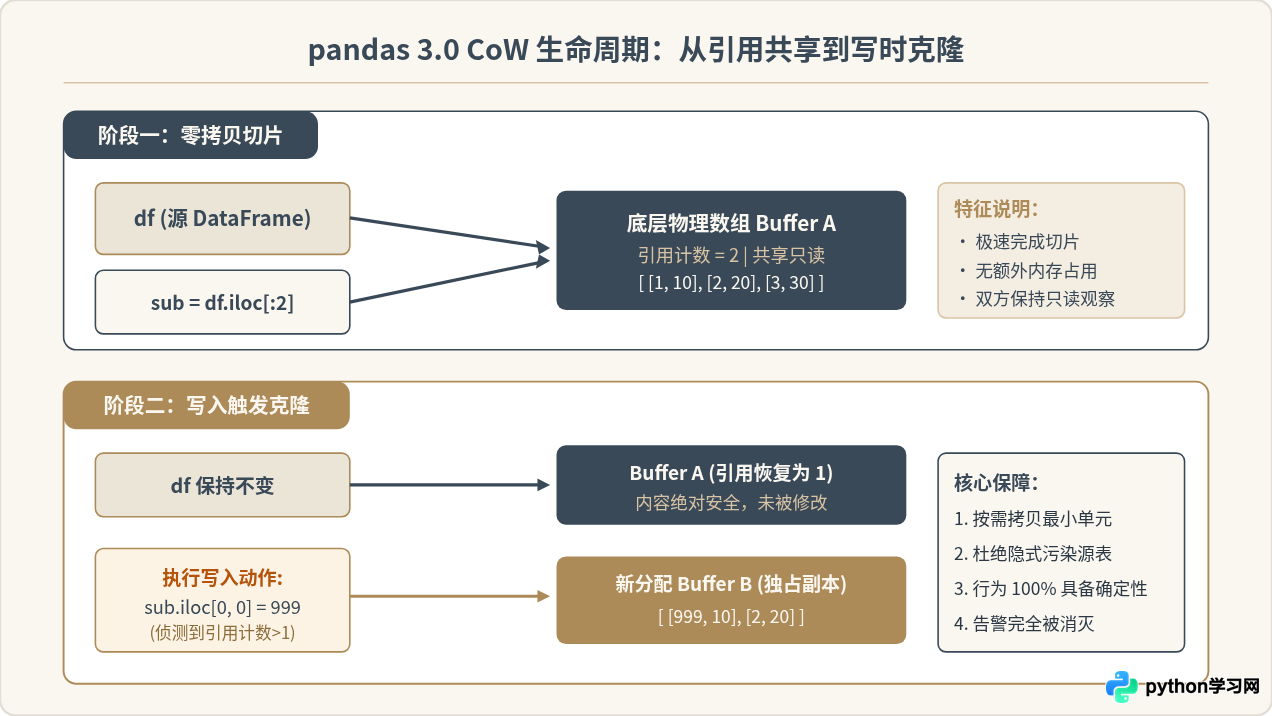
为了让面试官感到你的回答逻辑层次极强、有技术深度且贴近工程落地,推荐采用以下四步推导流程:
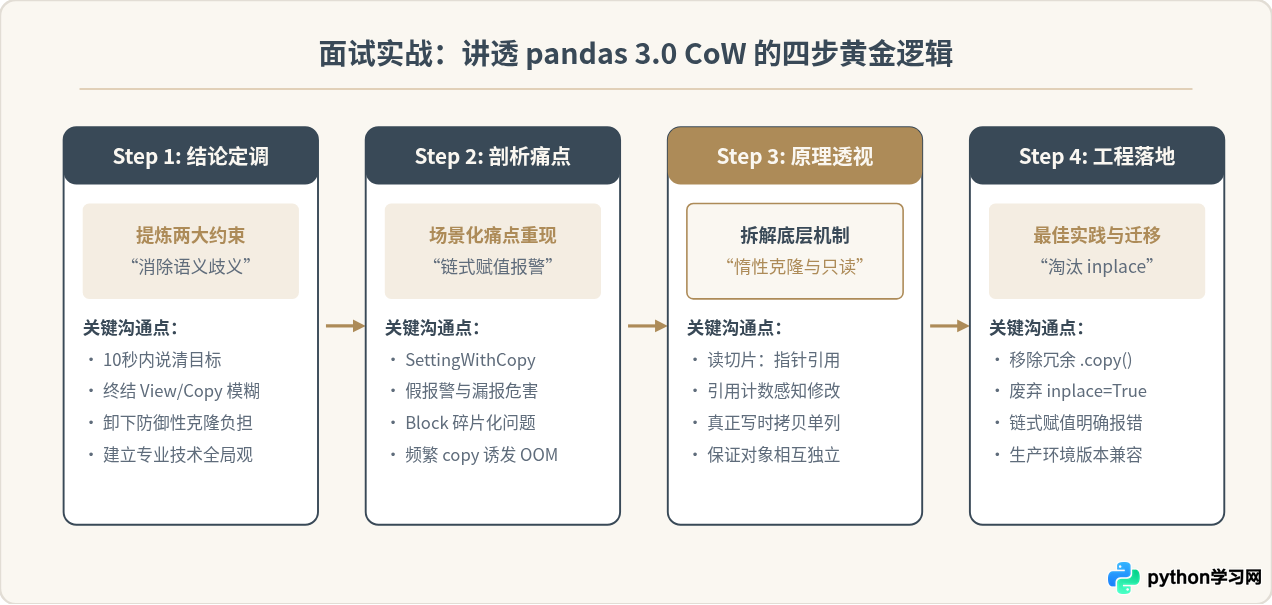
Step 1:结论先行,展现全局把控力
开篇先概括技术定位,说明 pandas 3.0 默认开启 CoW 不是单纯的语法糖,而是底层的颠覆性重构。目标是让“派生出的任何新变量在逻辑上都如同独立对象,但物理上只在写入时才产生成本”。
Step 2:结合 SettingWithCopyWarning 深入剖析老版本历史包袱
向面试官解释老机制让人头疼的根源:NumPy 数组切片是 View,而多列混合类型的 DataFrame 内部是由 BlockManager 管理的一组 Block。切片跨越不同 Block 时,pandas 常常被逼无赖只能复制一份数据。因此,用户根本无法预判 df[df['age'] > 18]['score'] = 100 究竟修改了原表还是修改了临时产生的拷贝。这就是 SettingWithCopyWarning 存在的核心原因。
Step 3:用“引用计数与惰性写入”讲透 CoW 原理
说明 CoW 借鉴了操作系统与现代函数式语言不可变数据结构的思想。在读取和切片时,无论经过多少层函数传递,全部指向同一块物理内存。只有在写入被触发的那一刻,系统检查引用计数,发现引用数大于 1 时,才以最小粒度复制出独立 Block。这既保证了“零开销传递”,又彻底杜绝了“副作用污染”。
Step 4:联系工程落地与代码重构
向面试官展示你在生产实践中的经验:开启 CoW 之后,团队代码可以放心删除掉大量防御性的 .copy() 调用,大幅降低 ETL 管道的内存峰值;同时注意 inplace=True 在很多方法中已经被彻底废弃(因为 inplace 与 CoW 的只读引用哲学相违背),推荐全面采用函数式管道或直接赋值。
五、代码实测:验证 CoW 带来的行为革命
在面试中,如果能随口给出一段能够体现 CoW 机制前后差异的微型代码,会极大增加说服力。在 pandas 2.x 中,可以通过配置项提前开启 CoW 进行验证,而在 3.0 中该配置已成为不可逆转的默认行为:
import pandas as pd

# 在 pandas 2.x 中提前体验 pandas 3.0 的默认行为
pd.options.mode.copy_on_write = True

# 1. 初始化原始 DataFrame
df = pd.DataFrame({"category": ["A", "B", "C"], "val": [10, 20, 30]})

# 2. 提取子集切片(零内存复制,极速完成)
sub = df[df["val"] > 15]

# 3. 对子集进行写入修改
sub["val"] = 999

# 4. 打印验证隔离性
print("--- 派生对象 sub ---")
print(sub)
print("
--- 源对象 df ---")
print(df)--- 派生对象 sub ---
category val
1 B 999
2 C 999
--- 源对象 df ---
category val
0 A 10
1 B 20
2 C 30
[执行完毕,没有任何 SettingWithCopyWarning 告警!]
关键观察点:
- 修改
sub的瞬间,系统仅为sub克隆了对应的列数据块,df内部对应的数据绝对安全,未被修改; - 控制台没有弹出任何
SettingWithCopyWarning,因为行为规则 100% 确定:派生变量的写入绝不影响父变量; - 如果尝试直接执行链式赋值
df[df["val"] > 15]["val"] = 999,在 CoW 模式下会直接抛出明确的ChainedAssignmentError异常,而不是含糊其辞的 Warning。这倒逼开发者使用标准df.loc[条件, "val"] = 999,在语法层面把潜在错误彻底扼杀在萌芽期。
六、全维度对比总结与工程迁移指南
向面试官阐明技术方案时,一张清晰的横向对比能起到一锤定音的效果。在实际工程项目中,理解这些差异也是编写高性能代码的前提:
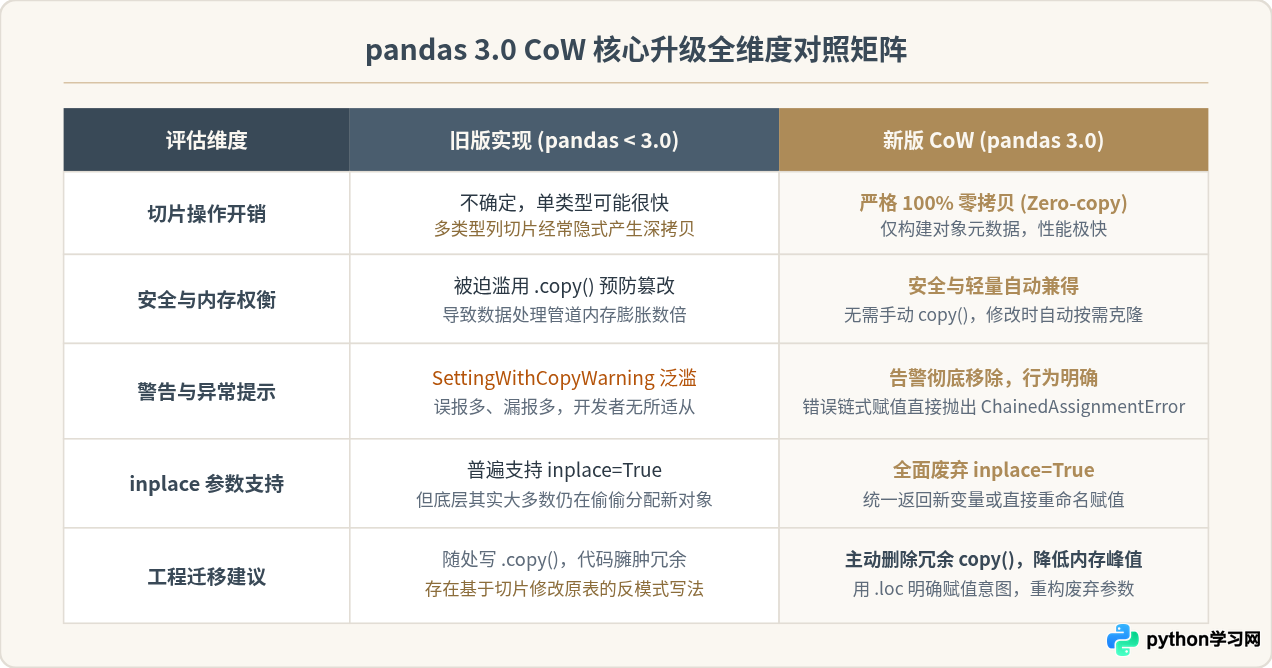
总结而言,在面试官面前阐述 pandas 3.0 的 Copy-on-Write 时,只要牢牢抓住“历史混乱(薛定谔的切片与预警)”、“深层代价(防御性克隆的内存浪费)”、“解决精髓(引用共享与延迟写时克隆)”这三条主线,再配合工程实践中的具体代码与迁移规约,就能既有高屋建瓴的架构理解,又有扎实落地的编码细节,交出一份令技术面试官信服的满分答卷。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









