

Python主要应用领域:数据分析、AI与Web开发场景概览
全面解析Python在数据分析、人工智能与Web开发三大主流领域的应用场景、核心工具链、落地工程架构与技术选型决策,帮助开发者系统掌握Python技术版图。
一、核心领域定位与技术选型拓扑
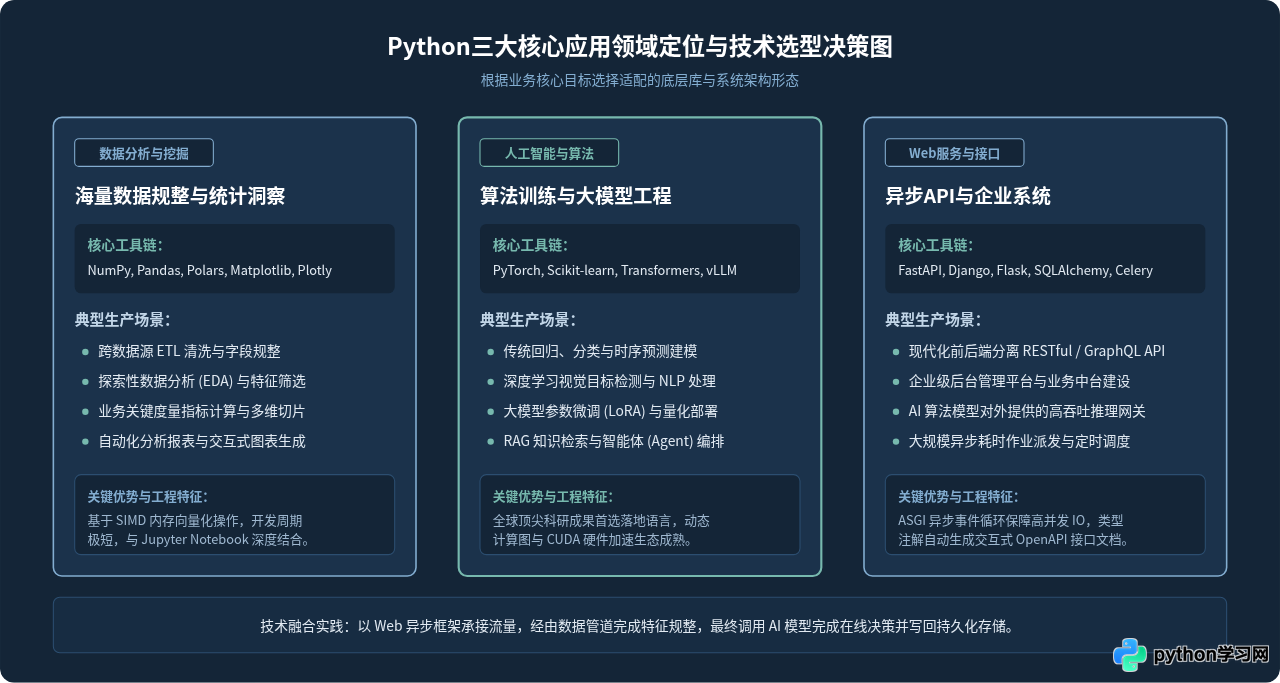
Python 之所以能够在截然不同的业务领域同时保持高生产力,核心在于其生态系统的专业化分工。在数据分析领域,它以内存连续的高性能张量与数据表算子取代慢速解释执行;在人工智能领域,主流深度学习框架均以 Python 作为高层建模表达接口,底层交由 CUDA 及张量加速硬件;而在 Web 开发领域,现代化异步网关接口(ASGI)与静态类型提示的结合,让轻量接口与高并发微服务开发变得高效且易维护。
二、数据分析与挖掘:从原始日志到业务洞察
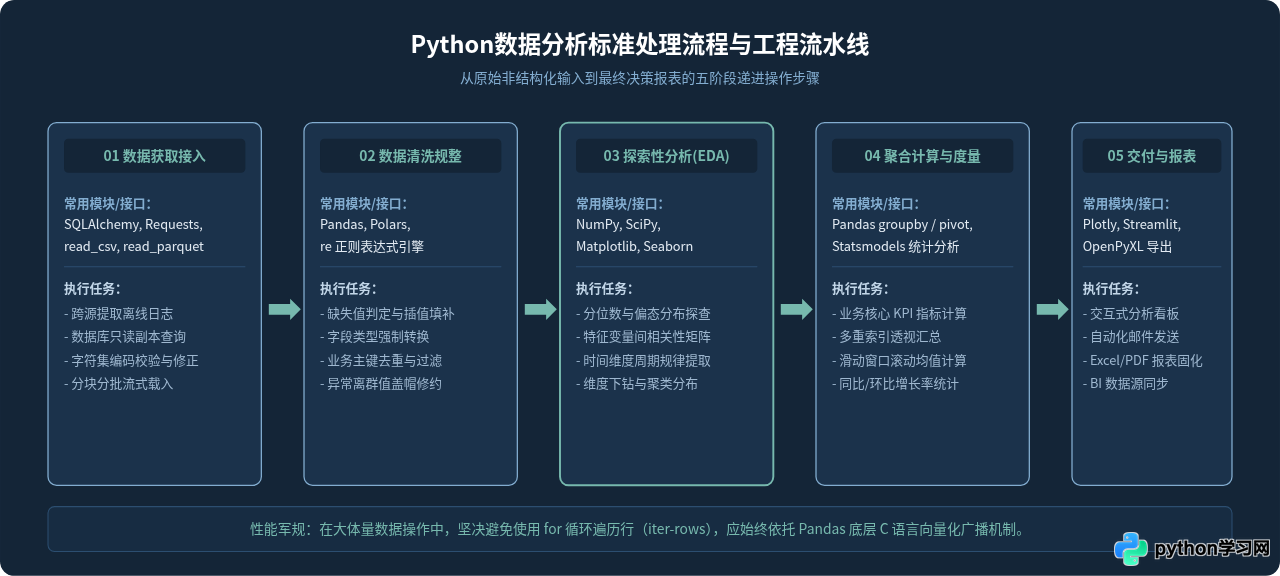
在企业日常运营中,数据往往分散在日志文件、关系型数据库、NoSQL 存储及第三方 API 中。数据分析工程的核心任务,是将这些异构、非结构化或存在脏数据的输入流,转换为规范的分析数据集,进而计算关键业务指标(如留存率、转化漏斗、客单价时序趋势),并输出可视化图表。
1. 核心工具链分工
- NumPy:提供高性能多维数组对象(
ndarray)及底层快速数学计算库,是整个 Python 科学计算的基石。 - Pandas:提供带标签的二维表格数据结构
DataFrame,具备强大的数据切片、对齐、缺失值补全、多表连接与透视聚合能力。 - Polars:基于 Rust 编写的高性能现代化数据分析库,原生支持多线程并行执行与延迟计算(Lazy Evaluation),在大规模内存数据集分析中表现卓越。
- Matplotlib & Seaborn:构建静态分析图表的标准库,涵盖折线图、散点图、箱线图、热力图等常见统计分布表达。
2. 典型业务分析代码范式
在实际数据处理中,开发者通常采用链式方法组合数据清洗与指标聚合。以下展示了一段典型的业务分析代码,演示如何从原始订单数据中筛选有效交易并计算渠道维度的汇总度量:
import pandas as pd
import numpy as np

# 1. 模拟读取业务流水数据集
raw_data = {
    "order_id": [1001, 1002, 1003, 1004, 1005, 1006],
    "channel": ["iOS", "Android", "Web", "iOS", "Android", "Web"],
    "amount": [128.0, np.nan, 256.5, 99.0, 480.0, -10.0],  # 包含脏数据
    "status": ["PAID", "PAID", "PAID", "CANCELLED", "PAID", "PAID"]
}
df = pd.DataFrame(raw_data)

# 2. 清洗与特征过滤:排除异常金额并填补缺失
cleaned_df = (
    df.query("status == 'PAID' and amount > 0")
      .fillna({"amount": 0.0})
      .copy()
)

# 3. 聚合计算渠道指标
channel_summary = (
    cleaned_df.groupby("channel")
    .agg(
        total_revenue=("amount", "sum"),
        avg_order_value=("amount", "mean"),
        order_count=("order_id", "count")
    )
    .reset_index()
)

print(channel_summary)Polars / DuckDB 引擎,利用多核 CPU 并发与推迟计算特性降低内存峰值。
三、人工智能与算法工程:模型研发到大模型落地
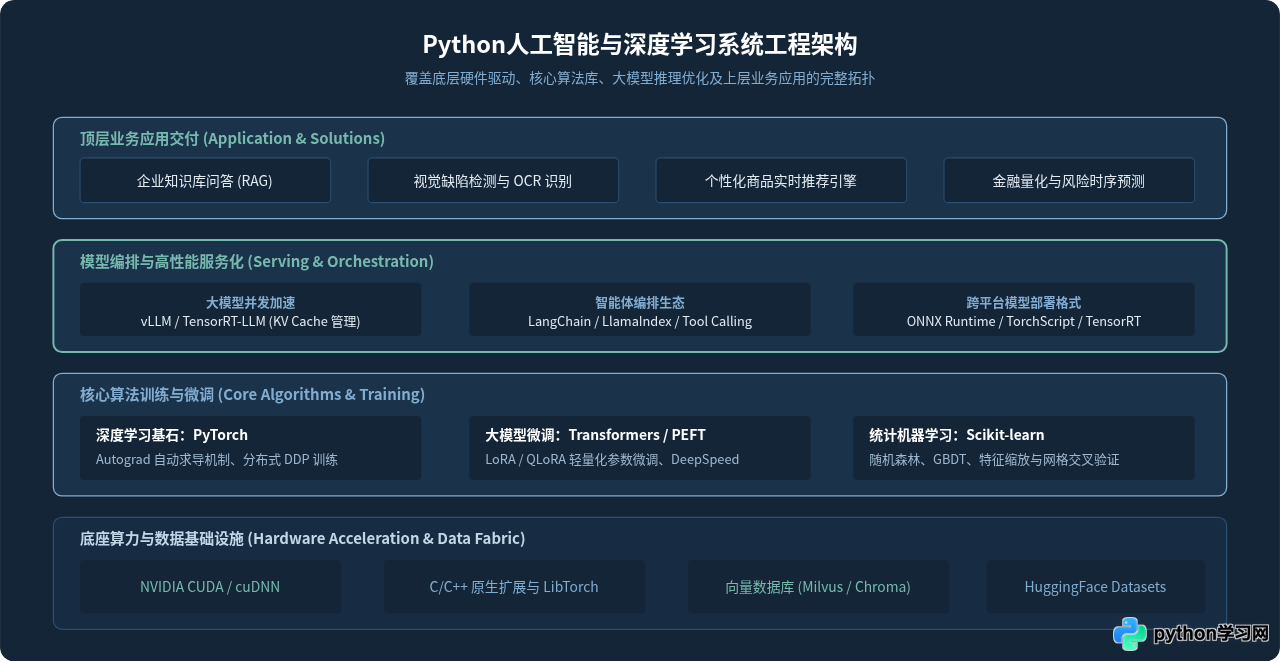
人工智能领域是当前 Python 技术生态最活跃的分支。Python 并不是直接用纯解释器去计算复杂的矩阵乘法,而是充当“胶水调度层”——算法工程师用简洁的 Python 代码定义网络拓扑与训练逻辑,底层则直接调用经过深度优化的 C++ / CUDA 内核(如 cuBLAS、cuDNN)在 GPU 或 TPU 硬件上高速运转。
1. 技术演化分支与适用场景
- 经典机器学习(Scikit-learn):针对结构化表格数据的分类、回归、降维与聚类任务。在信贷风控、用户流失预警、设备故障诊断等业务中,结合 LightGBM / XGBoost 仍具备极高的开发效费比。
- 深度学习系统(PyTorch):学术界与工业界最主流的深度神经网络研发框架,凭借动态计算图(Eager Mode)、直观的调试机制与强大的生态扩展,在计算机视觉(CV)与自然语言处理(NLP)领域占据主导地位。
- 大模型(LLM)工程与 Agent 编排:以 Hugging Face 为模型集市标准,通过
vLLM/TensorRT-LLM实现高吞吐 PagedAttention 显存优化推理,并结合LangChain/LlamaIndex搭建检索增强生成(RAG)和自主智能体。
2. 深度学习模型推理示例
在实际生产部署中,训练好的模型权重通常脱离训练代码,以轻量化推理模式载入。以下展示使用 PyTorch 评估模式完成前向推理的典型规范结构:
import torch
import torch.nn as nn

# 1. 明确定义计算设备(优先选用 GPU 加速)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

# 2. 定义轻量多层感知机 (MLP) 结构
class InferenceClassifier(nn.Module):
    def __init__(self, in_features: int, num_classes: int):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(in_features, 64),
            nn.ReLU(),
            nn.Linear(64, num_classes)
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.net(x)

# 3. 实例化并进入评估模式
model = InferenceClassifier(in_features=10, num_classes=2).to(device)
model.eval()  # 冻结 Dropout 与 BatchNorm 统计量

# 4. 禁用梯度计算上下文以大幅节约显存与计算耗时
with torch.no_grad():
    sample_input = torch.randn(1, 10).to(device)
    raw_logits = model(sample_input)
    predicted_prob = torch.softmax(raw_logits, dim=-1)
    predicted_class = torch.argmax(predicted_prob, dim=-1).item()

print(f"执行环境: {device}, 预测分类类别: {predicted_class}")
四、Web开发与微服务:高内聚服务与现代化异步架构
在很长一段时间里,Python Web 开发曾被误解为“只适合快速写写原型或简单后台”。然而随着 asyncio 异步事件循环的引入,以及 ASGI(Asynchronous Server Gateway Interface)标准的建立,以 FastAPI 为代表的现代框架在 IO 密集型并发请求处理上已达到极高水平。
1. 主流 Web 框架选型对比
| 框架名称 | 架构定位 | 核心优势 | 适用业务场景 |
|---|---|---|---|
| Django | 全功能“全包型”(Batteries-Included) | 开箱即用的 ORM、Admin 运营管理后台、认证鉴权与安全防护机制 | 大型企业中台、SaaS 业务平台、内容管理系统(CMS)、团队协作系统 |
| FastAPI | 现代强类型 ASGI 异步框架 | 基于 Python 3.10+ 类型注解、Pydantic 入参校验、自动生成 OpenAPI 文档、性能卓越 | 微服务系统、移动端后端 API、高并发大模型推理网关、数据集成接口 |
| Flask | 轻量微内核(Micro-framework) | 核心极度轻简,依赖约束少,扩展自由度极高 | 小型单体工具、内部临时验证服务、无状态计算脚本封装 |
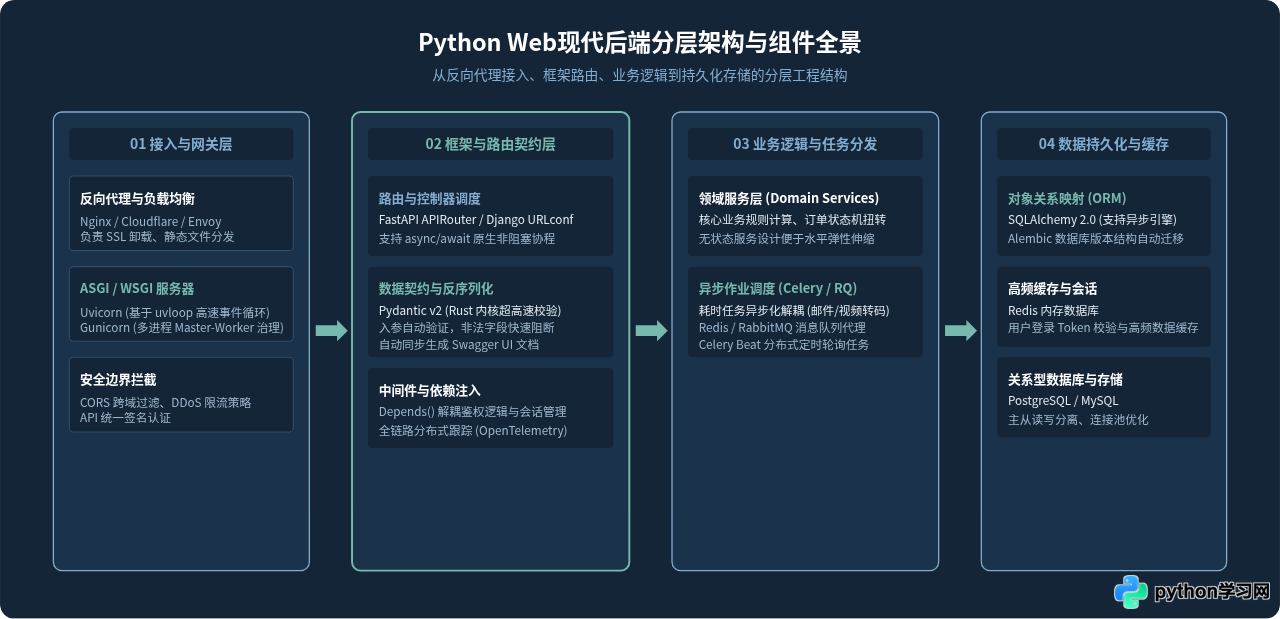
2. FastAPI 现代化异步 API 端点实现
在当今微服务与 AI 落地场景中,使用 FastAPI 包装算法接口是最普遍的做法。以下代码演示了如何使用 Pydantic 校验前端传参,并在非阻塞异步路由中调用预加载的推理逻辑:
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field
from typing import List
import asyncio

app = FastAPI(title="智能分析接口服务", version="1.0.0")

# 1. 定义入参契约与校验规则
class PredictionRequest(BaseModel):
    user_id: int = Field(..., description="业务用户ID")
    features: List[float] = Field(..., min_length=4, max_length=4, description="4维标准化特征输入")

class PredictionResponse(BaseModel):
    user_id: int
    risk_level: str
    confidence: float

# 2. 模拟非阻塞业务分析
async def compute_risk_async(features: List[float]) -> tuple[str, float]:
    await asyncio.sleep(0.01)  # 模拟异步 IO 耗时
    score = sum(features) / len(features)
    if score > 0.5:
        return "HIGH", round(score, 4)
    return "LOW", round(1.0 - score, 4)

# 3. 异步端点绑定
@app.post("/api/v1/predict", response_model=PredictionResponse, status_code=status.HTTP_200_OK)
async def predict_risk_endpoint(payload: PredictionRequest):
    try:
        level, conf = await compute_risk_async(payload.features)
        return PredictionResponse(
            user_id=payload.user_id,
            risk_level=level,
            confidence=conf
        )
    except Exception as e:
        raise HTTPException(status_code=500, detail=f"内部计算异常: {str(e)}")
五、三大领域多维对比与工程落地总结
数据分析、人工智能与 Web 开发并非彼此割裂,而是在同一个现代数据驱动系统中相互协同。例如:Web 模块负责实时采集用户点击流行为并持久化至数据库;数据分析模块进行离线清洗与聚合计算形成用户画像;人工智能模块则基于该画像训练召回模型,最终通过 Web API 实时提供低延迟推荐结果。
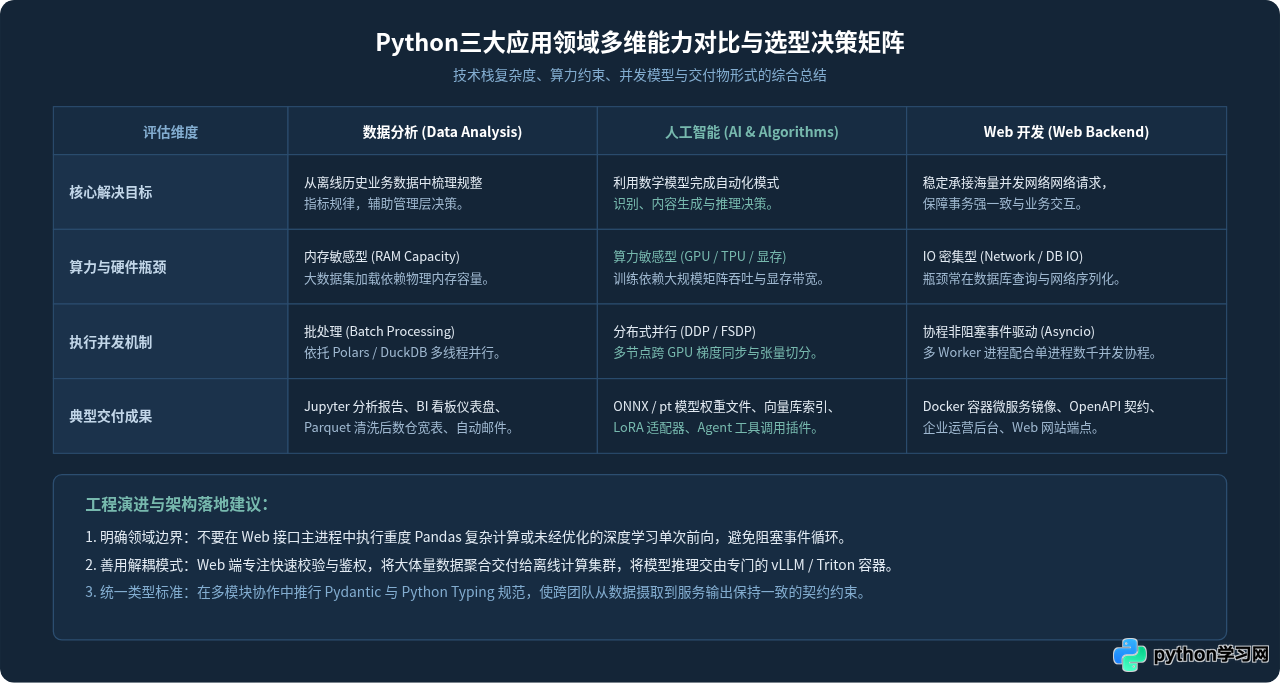
综上所述,Python 之所以在现代软件产业中保持强盛生命力,并不是因为它在某单一运行指标上绝对领先,而是因为它在保持语法高表达力与极低心智负担的前提下,构建了连接底层高性能 C/C++ 硬件内核与高层业务逻辑的完备生态桥梁。理解数据分析、AI 和 Web 后端各自的工程特点与选型边界,能够帮助开发者在面对实际技术架构设计时做出最务实、高效的决策。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









