

学术研究怎么用Python爬虫收集公开数据:社科与科研案例
面向社会科学与跨学科科研人员的Python网络爬虫实践指南。系统讲解学术公开数据采集的伦理合规边界、静态与动态网页技术选型、政策文本与学术社区实战案例,以及支撑学术论文复现(Replication Package)的原始快照与数据治理规范。
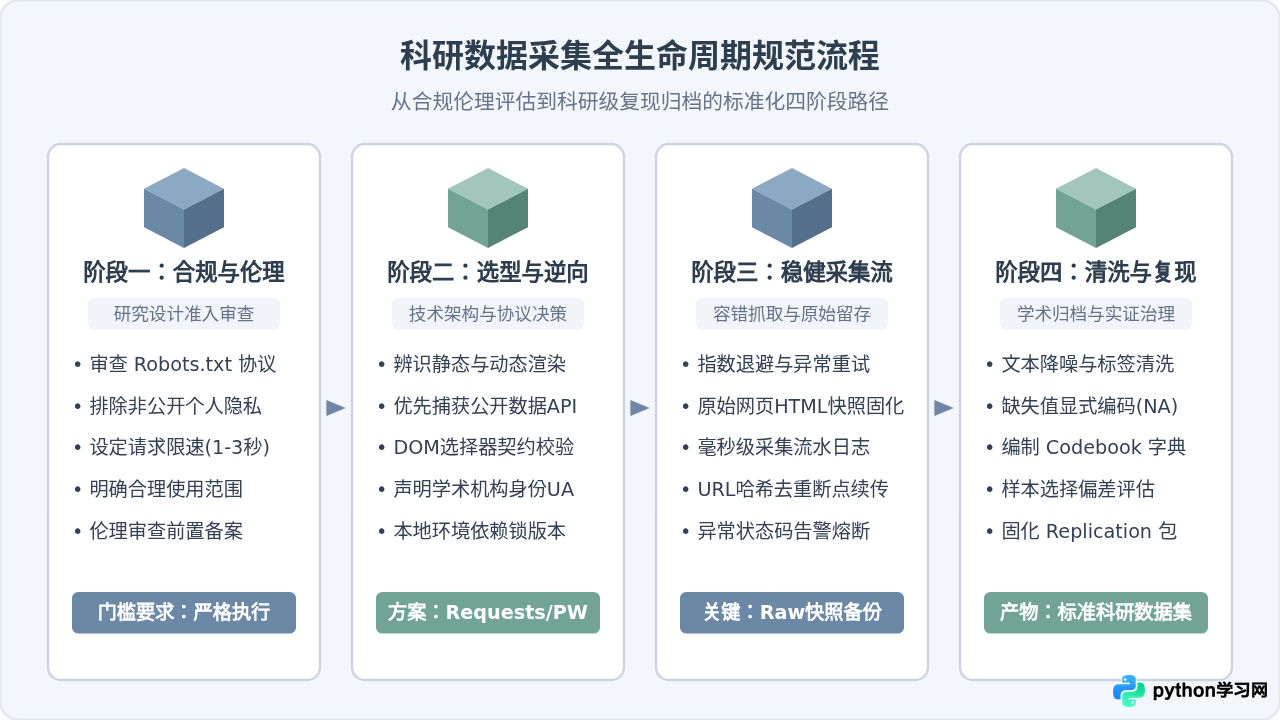
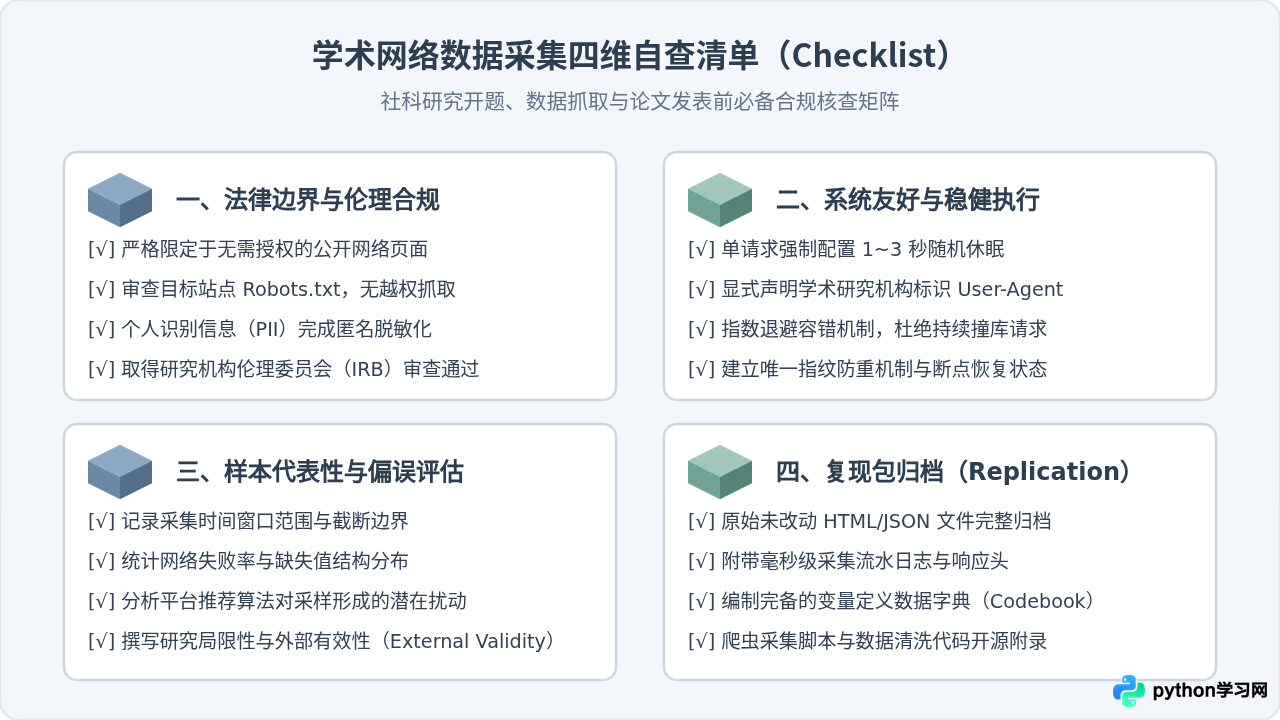
一、学术科研爬虫的核心前提:合规底线与伦理审查
学术研究的数据采集与商业爬虫有着本质的区别。商业爬虫往往偏向业务数据抓取与商业价值变现,而学术科研必须首先接受学术伦理审查与法律法规的制约。任何违反伦理与法律边界采集的数据,即使分析结论再具有洞察力,也无法在严谨的同行评议期刊上公开,甚至会导致研究撤稿或引发版权诉讼。
在启动任何爬虫代码之前,科研团队需要逐一核对以下四项核心原则:
- 公开可访问性原则:仅抓取无需越权认证、不设访问门槛的纯公开页面信息。凡涉及用户账号登录、付费知识库绕过或越权访问的内容,均属于非法侵入或违约,绝对不能作为合法学术数据来源。
- 遵守协议与礼貌原则(Politeness Policy):审查目标站点的
robots.txt协议,尊重其声明的爬取限制路径。在抓取代码中严格配置请求间隔(通常建议为 1 到 3 秒随机延时),严禁使用多线程高并发冲击科研机构或政府服务器。 - 个人隐私与脱敏保护:对于社科调研中涉及个人发言、社交媒体讨论的内容,抓取时必须对用户昵称、IP 地址、个人识别信息(PII)实施单向 Hash 或直接去标识化脱敏,遵守《个人信息保护法》(PIPL)与相关伦理规定。
- 学术合理使用边界:抓取的数据仅用于学术定量与定性研究,不得将清洗后的原始语料库打包转售或公开做商业化再分发。
二、技术栈选型决策:静态解析与动态渲染的分层方案
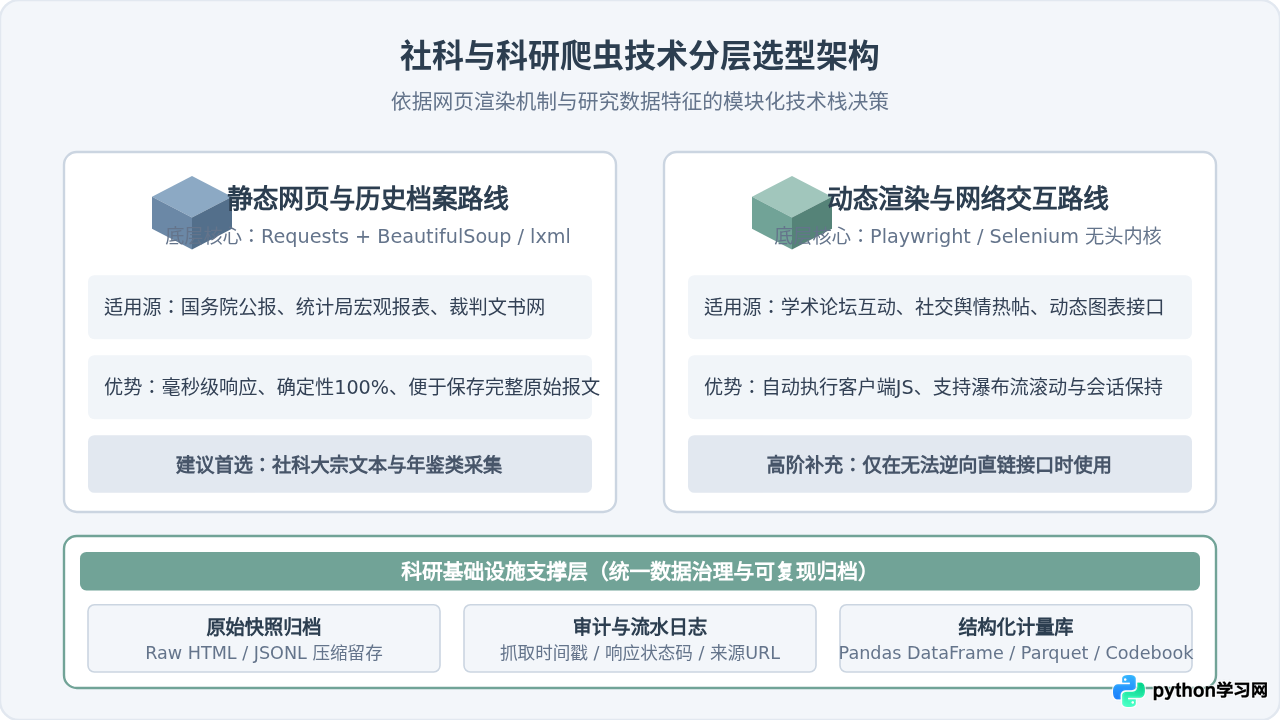
Python 生态中有丰富的网络抓取工具,但科研场景应秉持“奥卡姆剃刀”原则:如无必要,勿增实体。盲目使用无头浏览器(Headless Browser)不仅会消耗巨大的内存和 CPU 资源,还会大幅降低采集确定性,甚至因为动态元素加载延迟导致样本截断。
按照网页渲染机制与社科数据源类型,技术路线通常分为两大流派:
| 技术流派 | 常用工具库 | 典型社科数据源 | 核心优势与适用边界 |
|---|---|---|---|
| 静态文本型 | Requests, urllib3, BeautifulSoup4, lxml | 政府公报、统计局历史数据、法律裁判文书、学术智库研究报告 | 直接请求 HTTP 端点,返回完整 HTML,资源占用极小,高并发可控,执行速度快,可溯源性极强。 |
| 动态交互型 | Playwright, Selenium, httpx | 现代学术论坛(如知乎学术区、学术科研交流社区)、动态图表报表、滚动瀑布流平台 | 完整驱动浏览器内核,自动执行 JavaScript 渲染,支持处理复杂的事件监听、异步数据流与懒加载。 |
三、社科案例实战一:公开政策公报与研究报告抓取
在公共管理与社会政策研究中,研究者常常需要系统收集各级行政机构发布的公报文本、政策通知与解读文件,以便进行主题模型(LDA)、政策演进图谱或词嵌入分析。
本案例展示一个标准的社科政策采集脚本。该脚本具备完整的学术规范特征:
- 显式在
User-Agent中声明学术研究身份与联系邮箱(遵循网络爬虫学术礼仪); - 采用随机睡眠控制请求频次,保护源站性能;
- 将获取的原始网页存盘为独立的 HTML 快照文件,作为未来论文审稿的可核查证据;
- 将元数据提取并规范输出为 CSV 表格。
import os
import time
import random
import hashlib
import csv
import logging
import requests
from bs4 import BeautifulSoup

# 配置科研采集运行日志
logging.basicConfig(
    level=logging.INFO,
    format='%(asctime)s [%(levelname)s] %(message)s',
    handlers=[
        logging.FileHandler("policy_crawler.log", encoding="utf-8"),
        logging.StreamHandler()
    ]
)

# 1. 规范的学术请求头:表明学术用途与回溯联系方式
HEADERS = {
    "User-Agent": "AcademicResearchBot/1.0 (+http://example.edu/research; contact: researcher@example.edu)",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9"
}

# 2. 建立目录:原始快照必须妥善冷归档
SNAPSHOT_DIR = "raw_snapshots"
os.makedirs(SNAPSHOT_DIR, exist_ok=True)
OUTPUT_CSV = "policy_corpus_dataset.csv"

def get_page_with_retry(url, max_retries=3):
    """带指数退避的学术友好型请求函数"""
    for attempt in range(max_retries):
        try:
            # 强制施加 1.5 到 3.0 秒随机延迟,杜绝对服务器形成高频并发压力
            sleep_duration = random.uniform(1.5, 3.0)
            time.sleep(sleep_duration)

            response = requests.get(url, headers=HEADERS, timeout=15)
            # 统一处理中文网页常见编码(处理 GBK / UTF-8 异常)
            if response.encoding.lower() == 'iso-8859-1':
                response.encoding = response.apparent_encoding

            if response.status_code == 200:
                return response.text
            elif response.status_code == 404:
                logging.warning(f"页面不存在 (404): {url}")
                return None
            else:
                logging.warning(f"状态码异常 [{response.status_code}], 尝试重试...")
        except requests.RequestException as e:
            logging.error(f"网络连接异常: {e}, 正在进行第 {attempt + 1} 次重试")
            time.sleep(2 ** attempt)
    return None

def parse_policy_detail(html_content, source_url):
    """解析公报正文并保留学术元数据"""
    soup = BeautifulSoup(html_content, "html.parser")

    # 标题抽取(带默认兜底)
    title_node = soup.find("h1") or soup.find("title")
    title = title_node.get_text(strip=True) if title_node else "NA_TITLE"

    # 发布日期抽取
    date_node = soup.find("span", class_="publish-date") or soup.find("meta", attrs={"name": "pubdate"})
    if date_node:
        pub_date = date_node.get("content") if date_node.name == "meta" else date_node.get_text(strip=True)
    else:
        pub_date = "NA_DATE"

    # 正文段落抽取与标准化拼接
    content_nodes = soup.find_all("p")
    text_paragraphs = [p.get_text(strip=True) for p in content_nodes if p.get_text(strip=True)]
    full_text = "\n".join(text_paragraphs) if text_paragraphs else "NA_CONTENT"

    # 计算文本哈希作为唯一指纹
    content_hash = hashlib.sha256(full_text.encode("utf-8")).hexdigest()

    return {
        "title": title,
        "publish_date": pub_date,
        "source_url": source_url,
        "content_hash": content_hash,
        "text_content": full_text
    }

def run_academic_collector(target_urls):
    """学术批量采集主任务"""
    logging.info(f"启动科研采集任务,待采列表规模: {len(target_urls)}")

    with open(OUTPUT_CSV, mode="w", newline="", encoding="utf-8-sig") as csv_file:
        fieldnames = ["doc_id", "title", "publish_date", "source_url", "content_hash", "snapshot_file", "crawl_timestamp"]
        writer = csv.DictWriter(csv_file, fieldnames=fieldnames)
        writer.writeheader()

        for idx, url in enumerate(target_urls, 1):
            doc_id = f"DOC_{idx:05d}"
            logging.info(f"[{idx}/{len(target_urls)}] 正在抓取: {url}")

            html = get_page_with_retry(url)
            if not html:
                continue

            # 核心学术步骤:落盘原始未经修改的 HTML 快照
            snapshot_filename = f"{doc_id}_{int(time.time())}.html"
            snapshot_path = os.path.join(SNAPSHOT_DIR, snapshot_filename)
            with open(snapshot_path, "w", encoding="utf-8") as f_snap:
                f_snap.write(html)

            # 解析关键指标
            record = parse_policy_detail(html, url)
            record["doc_id"] = doc_id
            record["snapshot_file"] = snapshot_filename
            record["crawl_timestamp"] = time.strftime("%Y-%m-%d %H:%M:%S", time.localtime())

            # 暂不直接写入全部巨量正文到总表,而是保存结构化元数据以保持表格轻量
            del record["text_content"]
            writer.writerow(record)
            csv_file.flush()

    logging.info("科研数据采集完成,数据集已导出至 CSV,原始快照均已固化。")

# 示例调用
if __name__ == "__main__":
    # 在实际研究中,此列表由首页索引页自动遍历获取
    sample_urls = [
        "https://www.example-gov-institute.org/policy/item_101.html",
        "https://www.example-gov-institute.org/policy/item_102.html"
    ]
    # run_academic_collector(sample_urls)
四、社科案例实战二:学术论坛与社交民意文本采集
在社会学、传播学与舆论挖掘研究中,研究人员往往关注公众在社交平台、专业问答社区对热点科技伦理或公共事件的反馈。这类网站普遍采用现代前端框架(如 React、Vue)构建,数据往往通过后台异步接口(XHR/Fetch)动态载入,传统的简单 HTTP GET 请求只能得到一个空的页面框架。
处理动态交互数据有两种严谨的科研路径:
- 优先策略:抓包逆向直接提取 API 响应。打开浏览器开发者工具(F12),切换到“网络(Network)- Fetch/XHR”标签页,定位到真实承载数据的 JSON 接口。直接向该 JSON 接口发起请求,既无需渲染无用的 CSS/JS 资源,又能直接拿到未经 DOM 污染的结构化字典。
- 备选策略:Playwright 自动化无头浏览器。当目标网站拥有高强度的参数签名或加密混淆时,使用 Python 的
playwright库模拟真实浏览器加载。
import time
import json
import logging
import requests

API_ENDPOINT = "https://api.example-academic-community.org/v2/discussions"
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AcademicResearch/2.0",
    "Referer": "https://example-academic-community.org/topics/social-governance"
}

def fetch_community_discussions(topic_id, max_pages=5):
    """
    通过直接消费官方公开 API 接口采集学术社区讨论数据
    采用游标或分页偏移量增量获取,避免渲染整个浏览器上下文
    """
    collected_records = []
    seen_post_ids = set() # 建立哈希集合防止翻页重复

    for page in range(1, max_pages + 1):
        params = {
            "topic_id": topic_id,
            "page": page,
            "page_size": 20,
            "sort_by": "created_time"
        }
        try:
            time.sleep(2.0) # 维持请求礼貌
            resp = requests.get(API_ENDPOINT, headers=HEADERS, params=params, timeout=10)
            if resp.status_code != 200:
                logging.warning(f"接口异常,第 {page} 页获取终止: 状态码 {resp.status_code}")
                break

            data = resp.json()
            items = data.get("data", {}).get("list", [])
            if not items:
                logging.info(f"第 {page} 页已无新数据,采集正常收敛结束。")
                break

            for item in items:
                post_id = item.get("id")
                if post_id in seen_post_ids:
                    continue
                seen_post_ids.add(post_id)

                # 数据脱敏与字段筛选:绝不采集未授权的个人敏感信息
                cleaned_item = {
                    "post_id": post_id,
                    "created_at": item.get("created_time"),
                    "reply_count": item.get("stats", {}).get("replies", 0),
                    "agree_count": item.get("stats", {}).get("upvotes", 0),
                    "text_body": item.get("clean_text", "").strip()
                }
                collected_records.append(cleaned_item)

            logging.info(f"第 {page} 页同步完成,累计入库条目: {len(collected_records)}")
        except Exception as err:
            logging.error(f"处理第 {page} 页出现未捕获异常: {err}")
            break

    return collected_records
五、科研可复现性(Replicability):从网页抓取到学术复现包
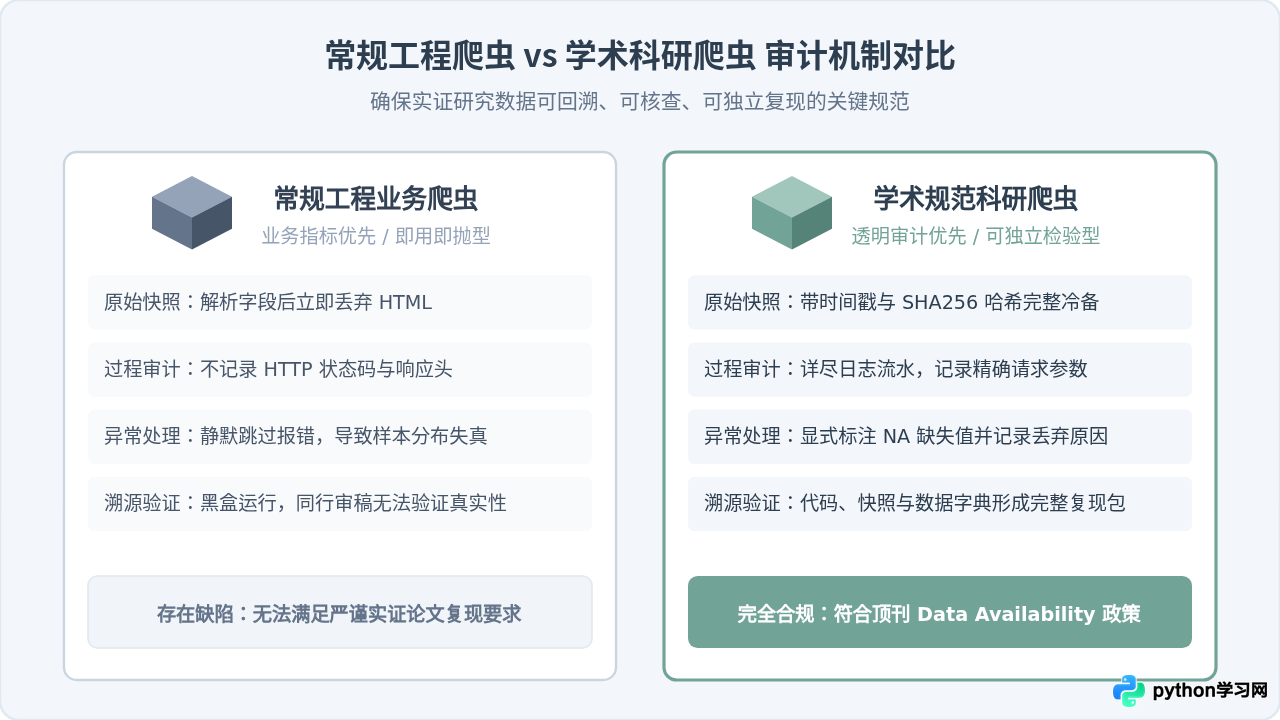
可复现性是实证科学研究的生命线。目前国际顶级社会科学与计算科学期刊(如 Nature Human Behaviour, American Economic Review, PNAS)均严格要求研究者提交完整的数据与代码复现包(Replication Package)。
工程爬虫通常只关注“当前是否跑通”,抓取完字段后直接丢弃网页原始上下文。而学术爬虫必须建立审计机制:如果三年后同行评审专家质疑某条关键数据的真实性,研究者必须能够从冷归档中调出当时抓取的原始 Raw HTML/JSON 快照,并通过时间戳与哈希证明数据未经篡改。
六、数据治理与样本偏差评估:保证学术论证严密性
从网络上爬取下来的原始数据并不能直接塞入计量回归模型或 NLP 管道,必须经历一套严格的数据治理工序。社科研究者需要对网络数据的“生成机理”保持高度警惕。
1. 数据清洗与标准化
清洗阶段应遵循“最小破坏性原则”:
- 去除控制字符与 HTML 残留:使用正则表达式过滤不可见控制符(如
\x00-\x1f)、全角与半角空格归一化、转义字符(如 转换为标准空格)。 - 时间格式标准化:将各异的时间表达(如“前天 15:20”、“2023年5月4日”、“2023-05-04T07:20:00Z”)统一转换为 ISO 8601 标准时间戳(
YYYY-MM-DD HH:MM:SS),并明确记录所属时区(默认 Asia/Shanghai)。 - 缺失值显式编码:对于网络抓取中未能成功定位的字段,切忌填入空字符串或 0,应使用
NA、NaN等标记,并在附属文档中注明该字段属于“页面本身未发布”还是“解析器定位失败”。
2. 样本选择偏差(Selection Bias)评估
网络公开数据极易受到“算法推荐偏差”、“平台幸存者偏差”与“活跃度极化”的扭曲。例如,在分析社会舆论时,网络发帖者往往是具有强烈情绪表达意愿的群体,沉默的大多数并不会在公开网络中发声。
在撰写实证论文的方法论(Methodology)章节时,研究者必须公开披露爬虫的数据收集时间窗口、抓取关键词选取规则、初始种子 URL 的覆盖范围,以及由于网络反爬、网页失效导致的数据丢失率,客观讨论样本局限性。
七、常见问题与排错指南
原因排查:国内许多政府机构与传统学术网站在 HTTP 标头中未正确声明字符集,或者声明了 ISO-8859-1,但实际页面采用 GB2312 或 GBK 编码。
解决办法:在调用 response.text 之前,使用 response.encoding = response.apparent_encoding 自动探测真实编码,或直接显式强制赋值为 response.encoding = 'utf-8' 或 'gb18030'。
解决办法:引入基于本地文件或轻量数据库的“状态机”。在每次成功抓取并落盘快照后,将对应的 URL 及其 MD5 哈希写入一个独立的索引文件(如 crawled_urls.txt 或 SQLite 数据库)。每次程序启动时先读取该集合,使用 set 进行 O(1) 过滤,跳过已完成项,实现幂等断点续传。
解决办法:在清洗逻辑中加入契约式断言检查(Assertion Contract)。每采集 100 篇文档,自动统计关键字段(如标题、时间、正文长度)的空值率。若空值率突然超过预设阈值(例如 5%),程序应触发自动熔断并向控制台输出告警,阻止错误数据污染总体样本库,便于人工核实 DOM 变动并修补解析规则。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









