

python必背源代码单词计数词频统计代码
本文系统讲解Python必背源代码之单词计数与词频统计代码,从原生字典底层逻辑、正则表达式文本清洗、标准库Counter高性能用法到大文件流式解析架构,提供工业级标准代码与详细排错解析。
一、最简必背:3 行代码搞定词频统计
对于绝大多数常规文本处理需求,标准库 collections.Counter 是 Python 官方推荐的首选方案。它在 C 语言扩展层面实现了紧凑的高速哈希计数,同时自带获取前 N 项高频词的 most_common() 方法。
import re
from collections import Counter

text = "Python is powerful and easy to learn. Python is also fast in data processing."

# 必背核心代码:清洗、提取并完成统计
words = re.findall(r'[a-zA-Z]+', text.lower())
word_counts = Counter(words)

# 示例输出:提取出现频次最高的前 3 个单词
print(word_counts.most_common(3))
# 运行输出:[('python', 2), ('is', 2), ('powerful', 1)]
这段代码之所以成为现代 Python 开发的“标准模板”,原因在于它直接避开了初学者最容易踩入的两个误区:直接使用 text.split(" ") 导致标点粘连,以及手工编写 for 循环判断键是否存在。
二、底层拆解:原生字典是如何完成计数的?
在深入高级封装前,理解哈希表(Hash Table)的底层操作逻辑是掌握所有变体的关键。如果脱离标准库,在纯原生字典环境下,最优雅的代码是利用字典的 get(key, default) 方法。
# 原生字典计数标准模板
counts = {}
for word in words:
    # 当 word 存在时返回原有计数值,不存在时返回默认值 0,随后加 1
    counts[word] = counts.get(word, 0) + 1

# 按词频从高到低排序
sorted_counts = sorted(counts.items(), key=lambda item: item[1], reverse=True)
初学者常写 if word in counts: counts[word] += 1 else: counts[word] = 1。这种写法在单词存在时,会触发两次哈希寻址(一次 in 检查,一次 counts[word] 读取与赋值)。而 get() 仅进行一次哈希查询,代码行数更少,在 Python 解释器内部执行效率更高。
三、工程关键:文本清洗流水线的四项规范
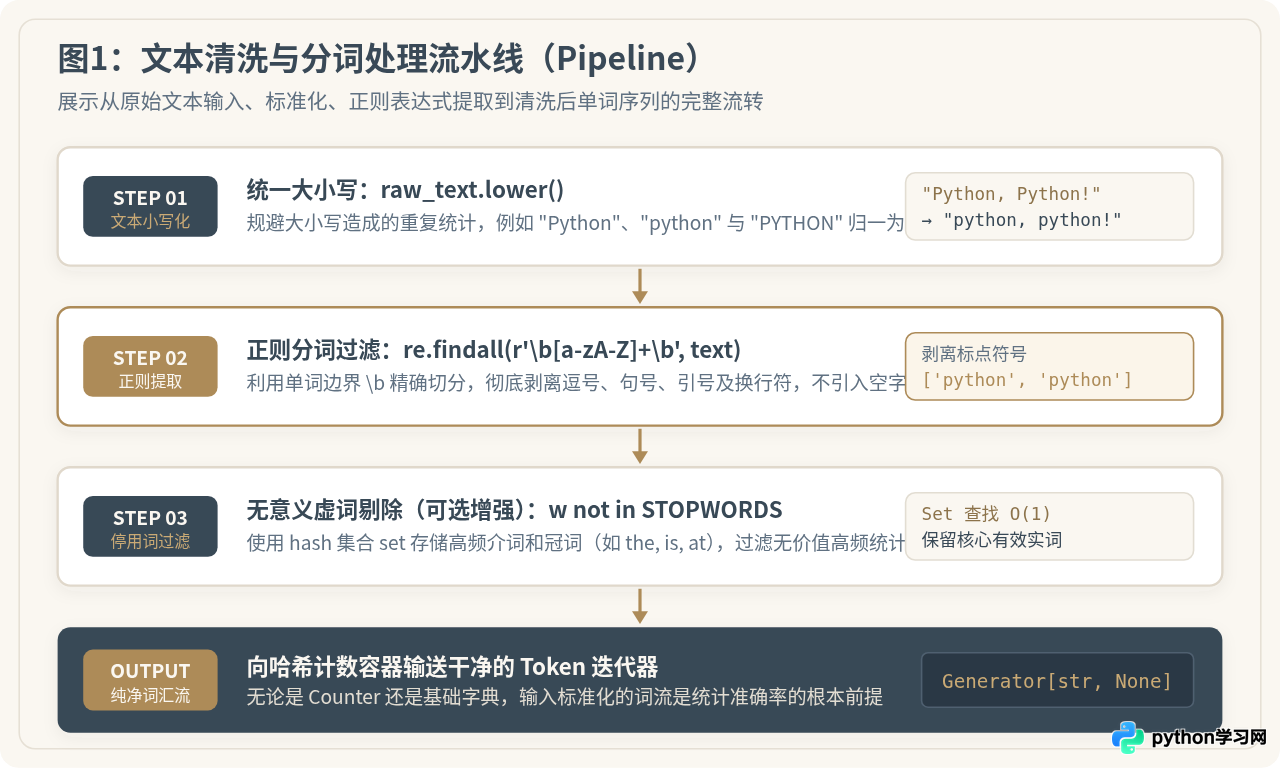
实际工程中的文本往往混杂着大小写、句读标点、转义字符以及所有格缩写。如果预处理不到位,统计结果将出现严重失真。遵循图1所示的清洗流水线,需把控以下四个细节:
-
大小写统一:在英文中,
"Python"出现在句首与句中形态不一。在分词前必须调用text.lower()统一为小写,确保同一实体被聚合至同一个键中。 -
杜绝朴素 split:调用
text.split(" ")会将"world!"连带叹号一起当作单词,导致"world"与"world!"被当成两个不同的词。使用正则re.findall(r'[a-zA-Z]+', text)能精准仅提取英文字符主体。 -
缩写与连字符考量:若文本中包含
don't、user's、state-of-the-art等词汇,可将正则表达式微调为:re.findall(r"[a-zA-Z]+(?:'[a-zA-Z]+)?", text),以防止语义单元被强行拆解。 -
停用词(Stopwords)剔除:在自然语言分析中,高频出现的冠词与介词(如 the, is, at, of)往往占据前排却无信息价值。使用哈希集合(
set)过滤掉停用词,可以显著提升词频分析的有效度。
# 包含停用词过滤的完整函数
STOP_WORDS = {"the", "is", "and", "to", "in", "of", "a", "also"}

def clean_and_tokenize(raw_text: str):
    words = re.findall(r"[a-zA-Z]+(?:'[a-zA-Z]+)?", raw_text.lower())
    # 列表推导式配合 set 集合进行 O(1) 高速过滤
    return [w for w in words if w not in STOP_WORDS]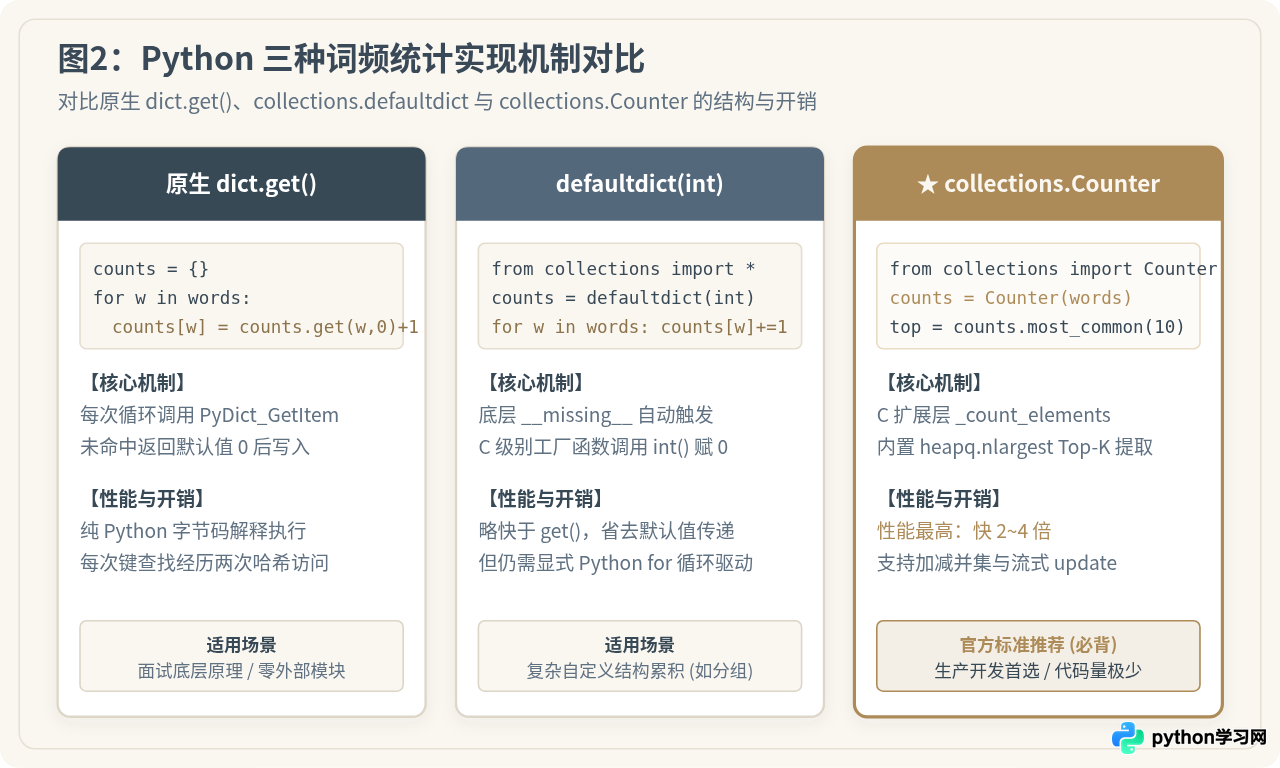
四、技术对比:三种计数容器的选型依据
在 Python 生态中,针对词频统计任务主要有原生字典、defaultdict 和 Counter 三种技术路径。了解各实现方式的优缺点与执行机制(如上图2所示),有助于在不同应用场景下做出合理选型。
| 实现方式 | 代码简洁度 | 底层机制 | Top-K 提取复杂度 | 推荐适用场景 |
|---|---|---|---|---|
| 原生 dict.get() | 3~5 行循环 | Python 字节码层面的默认值查询 | 全量排序 O(N log N) | 算法面试考察、零依赖受限环境 |
| defaultdict(int) | 3~4 行循环 | C 级 __missing__ 工厂赋 0 回调 | 全量排序 O(N log N) | 复杂嵌套结构分组(如词性归类) |
| collections.Counter | 1~2 行 | C 语言底层高速计数循环优化 | 堆排序 O(N log k) | 工业级生产开发首选(必背) |
Counter 在性能层面上不仅比手动 for 循环快 2 到 4 倍,更关键的是它的 most_common(k) 方法在内部基于堆排序(heapq.nlargest)实现。当文本库中有 100,000 个不同词汇、但我们只需要前 10 个热词时,堆排序仅需维护一个大小为 10 的最小堆,避免了对全部 10 万个元素进行昂贵的全量排序。
五、生产实战:大文件逐行流式计数(防 OOM)
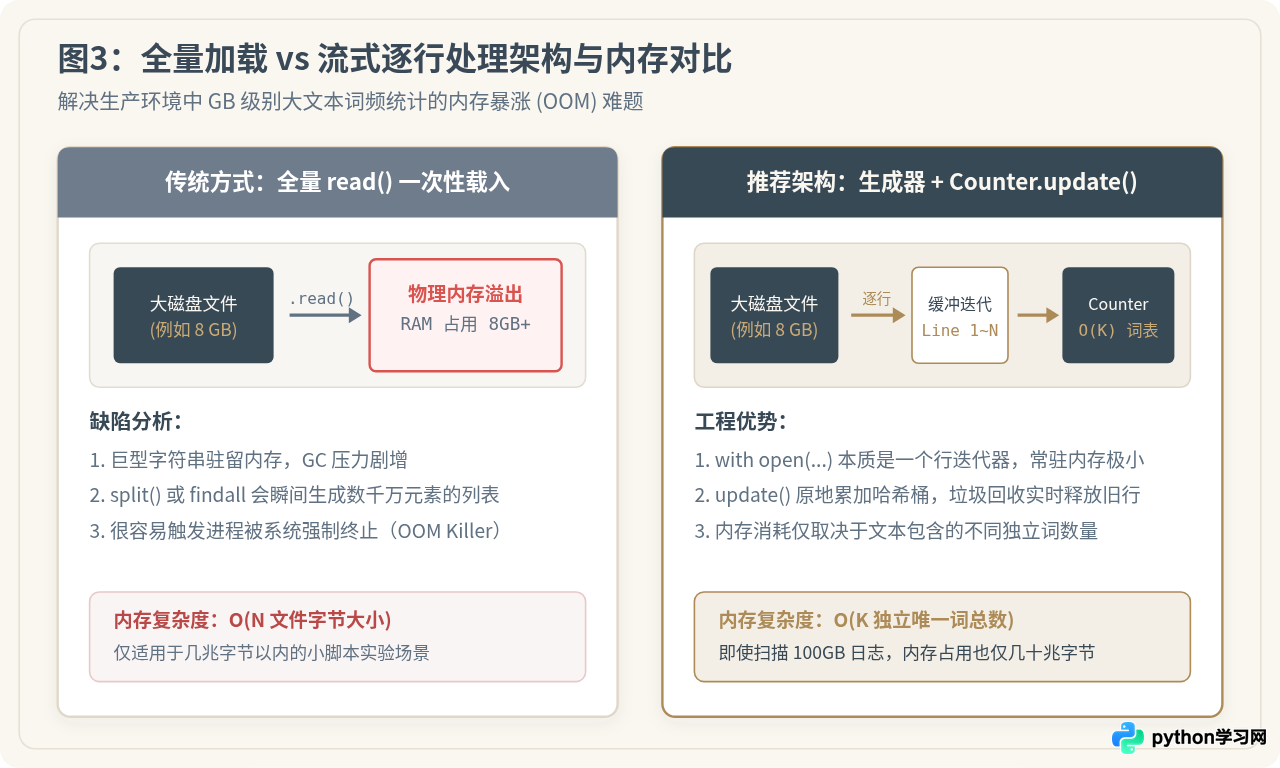
在处理大型日志、电子书库或网页语料时,文件体积常达到数百兆甚至数十吉字节(GB)。如果直接执行 open(path).read(),会将整篇文本一次性载入内存,引发内存急剧暴涨甚至被操作系统内核 OOM Killer 杀掉。
图3对比了全量读取与流式读取的内存表现。在 Python 中,文件对象本身就是一个按行惰性生成的迭代器。结合 Counter.update() 方法,我们可以构建一个内存占用极低且恒定的工业级统计脚本:
import re
from collections import Counter

def count_words_large_file(filepath: str, top_k: int = 10):
    """流式统计大文件词频,内存开销仅与独立词数量有关,不受文件总字节数限制"""
    counter = Counter()
    pattern = re.compile(r"[a-zA-Z]+(?:'[a-zA-Z]+)?")

    # 显式指定 UTF-8 编码,防止跨平台字符解码异常
    with open(filepath, mode='r', encoding='utf-8', errors='replace') as f:
        for line in f:
            # 按行清洗,提取当前行的所有词汇
            tokens = pattern.findall(line.lower())
            if tokens:
                # 原地增量更新哈希桶计数值
                counter.update(tokens)

    return counter.most_common(top_k)

# 使用示例(假设存在 2GB 的 server.log)
# top_words = count_words_large_file('server.log', top_k=5)
# print(top_words)- re.compile() 预编译正则:在每行高频循环中调用正则时,提前编译好
Pattern对象可以免去重复的正则表达式解析与缓存检索开销。 - errors='replace' 容错策略:真实生产日志中常有被截断的非 UTF-8 乱码字节,指定
replace可以防止脚本在半途崩溃退出。 - 垃圾回收及时释放:每一行经过正则提取后,
line字符串即可在下一轮循环被垃圾回收器复用或回收,内存常驻仅为词典本身。
六、拓展与答疑:中文分词与边界场景
初学者在处理多语言与实际业务时,还常常会遇到以下两类扩展场景:
1. 中文文本的词频统计有何差异?
英文单词天然由空格与标点自然分隔,而中文词语之间没有显式空格。因此,处理中文时无法直接依靠正则切分,必须引入分词引擎(如 jieba)。分词后生成的词语列表,可以直接送入 Counter 完成完全相同的统计操作:
# 中文词频统计标准范式
import jieba
from collections import Counter

zh_text = "Python语言是一种解释型的高级编程语言,广泛应用于数据分析与自然语言处理。"
# 使用 jieba.cut 生成词汇流
words = [w for w in jieba.cut(zh_text) if len(w.strip()) > 1]
zh_counts = Counter(words)
print(zh_counts.most_common(3))
2. Counter 的算术与集合操作
Counter 是 dict 的子类,除了普通字典的功能外,它还支持计数器之间的数学运算,这在比较两份文档的词频差异时极为便利:
c1 + c2:合并两个计数器,频次对应相加。c1 - c2:频次相减(自动剔除结果小于等于 0 的项)。c1 & c2:求交集,取两者中计数值较小的项。c1 | c2:求并集,取两者中计数值较大的项。
七、总结与必背代码卡片
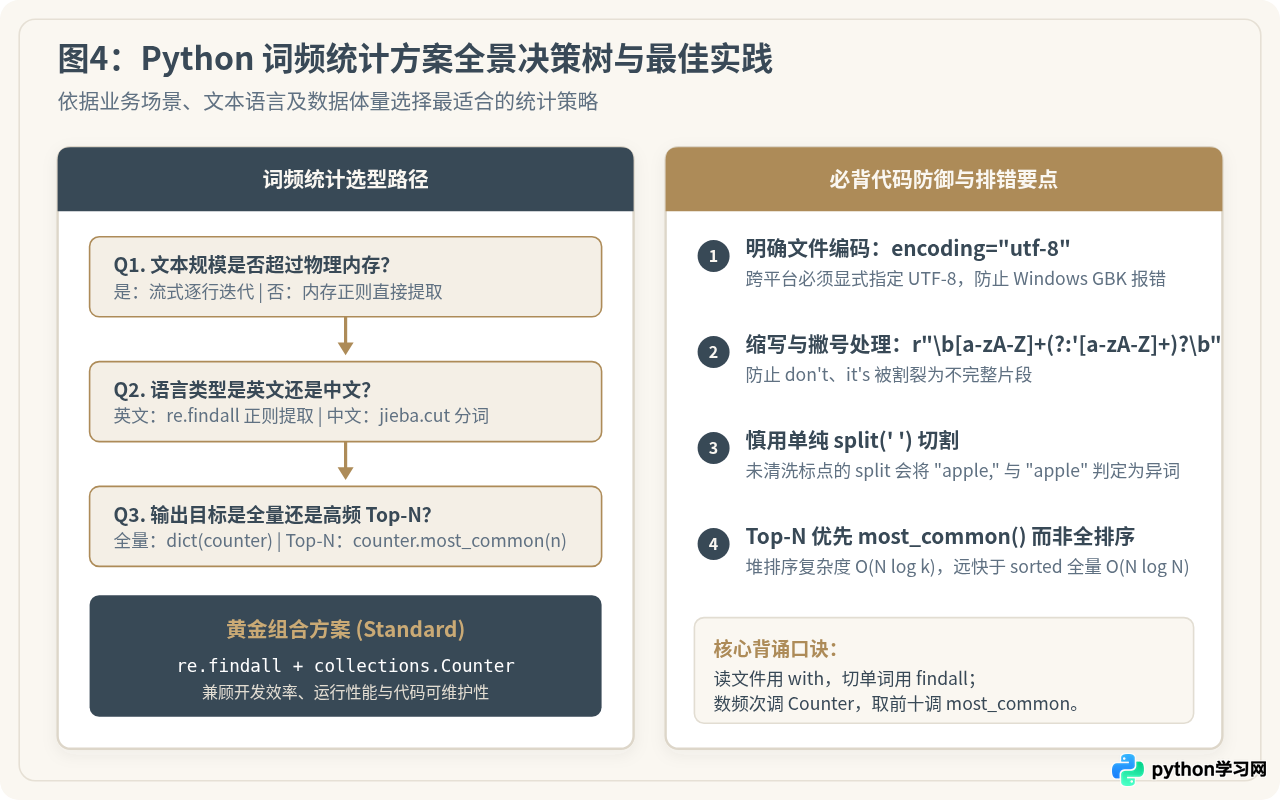
掌握 Python 单词计数与词频统计的精髓,在于把握“预处理质量”与“容器选择”两条主线:
- 日常开发首选:
Counter(re.findall(r'[a-zA-Z]+', text.lower())).most_common(N),3 行内兼具规范性与性能。 - 海量数据处理:以
with open(...)逐行迭代流为输入,通过counter.update()增量统计,将空间占用严格压制在 O(K) 字典规模。 - 排错核心习惯:显式指定
encoding='utf-8',规范化小写,妥善处理连字符与标点,必要时辅以停用词表。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









