

Python怎么读取包含合并单元格的Excel数据
深入讲解Python读取包含合并单元格Excel文件的核心机理、常见数据丢失陷阱,提供基于openpyxl的坐标广播填充与基于Pandas的快速处理方案,并附带工程落地注意事项。
在日常数据分析和报表自动化处理中,包含合并单元格的 Excel 文件十分普遍。使用 Python 尤其是常用的 pandas.read_excel() 直接读取这类表格时,往往会出现大部分合并区域数据变为 NaN(空值)的现象。这是因为在 Excel 规范中,合并单元格实际上仅将数值保存在合并区域左上角(Top-Left)的单个物理单元格内,其余位置并不保存值。解决这一问题,核心路径主要有两种:对于单纯按行分类合并的规范表格,使用 Pandas 结合 ffill() 快速进行向下填充;对于包含多列跨行跨列、需严格保留业务真实空值或需要精确控制坐标的复杂表格,使用 openpyxl 库遍历合并区间(merged_cells.ranges)并将首单元格数据广播填充至整个矩形区域。本文将详细讲解底层机理、具体代码实现及常见边界避坑要点。
一、Excel合并单元格的底层存储机理与读取陷阱
许多初学者在遇到数据缺失时,常误以为是解析库出现了 Bug。要彻底搞清楚如何准确读取,首先需要理解 Excel 底层(OpenXML 格式)对合并单元格的定义方式。
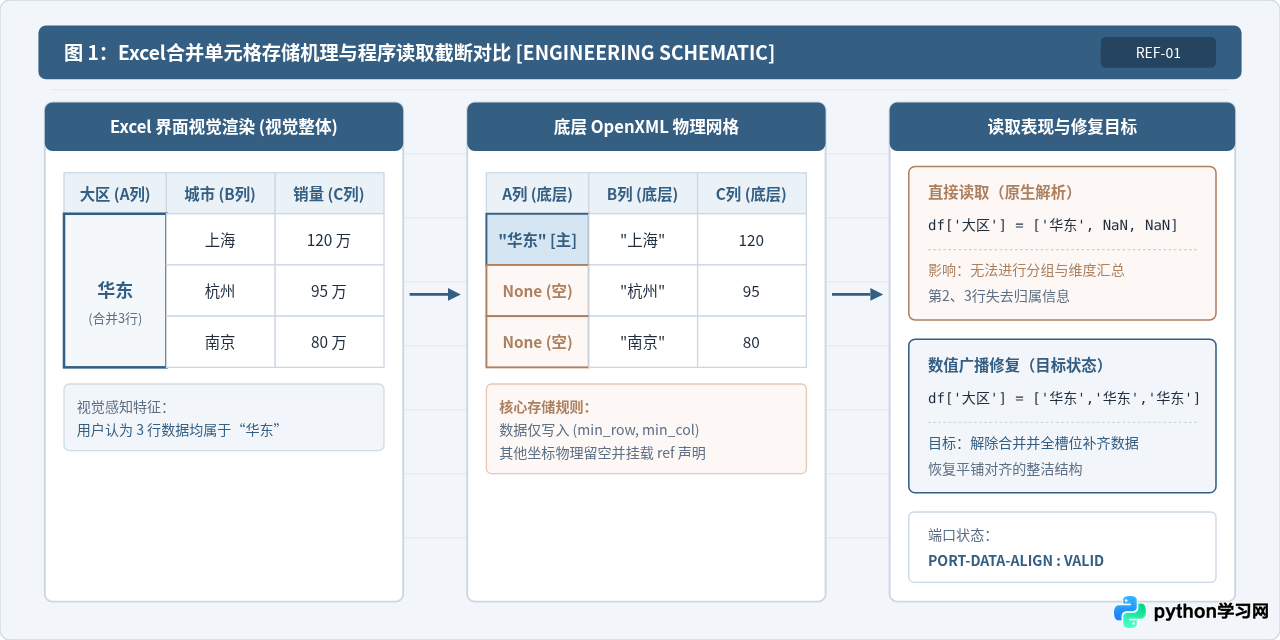
在 Excel 中,视觉上的一个“合并单元格”,在底层 XML 文件中并不是一个扩张尺寸的大单元格,而是一组普通的网格配合一段 <mergeCells> 声明。例如将 A1 到 A3 合并为一个单元格并填入“华东”,实际存储情况如下:
- 主单元格(A1):真实记录文本内容“华东”。
- 被合并从属单元格(A2、A3):在工作表内部不存储值,或者物理节点直接被省略;如果通过常规方式读取,返回的值为
None。 - 合并范围记录:工作表末尾记录
mergeCell ref="A1:A3",通知渲染引擎在界面上将其绘制为单个连通区块。
当我们使用数据处理库直接按行读取表格时,解析引擎会如实返回每个格点的物理内容,导致 A2 和 A3 被识别为缺失数据。这会导致后续的分组统计(groupby)、条件过滤或透视表计算出现大面积失真。
二、方案一:使用 openpyxl 扫描坐标并全量广播(通用标准解法)
对于数据清洗、ETL 管道或需要严格规避误填充的生产场景,最稳健的做法是直接借助底层 Excel 处理库 openpyxl。openpyxl 能够直接读取表格中声明的合并单元格元数据对象,允许我们在内存中将左上角的数据复制并填充至所有属于该区间的从属单元格。
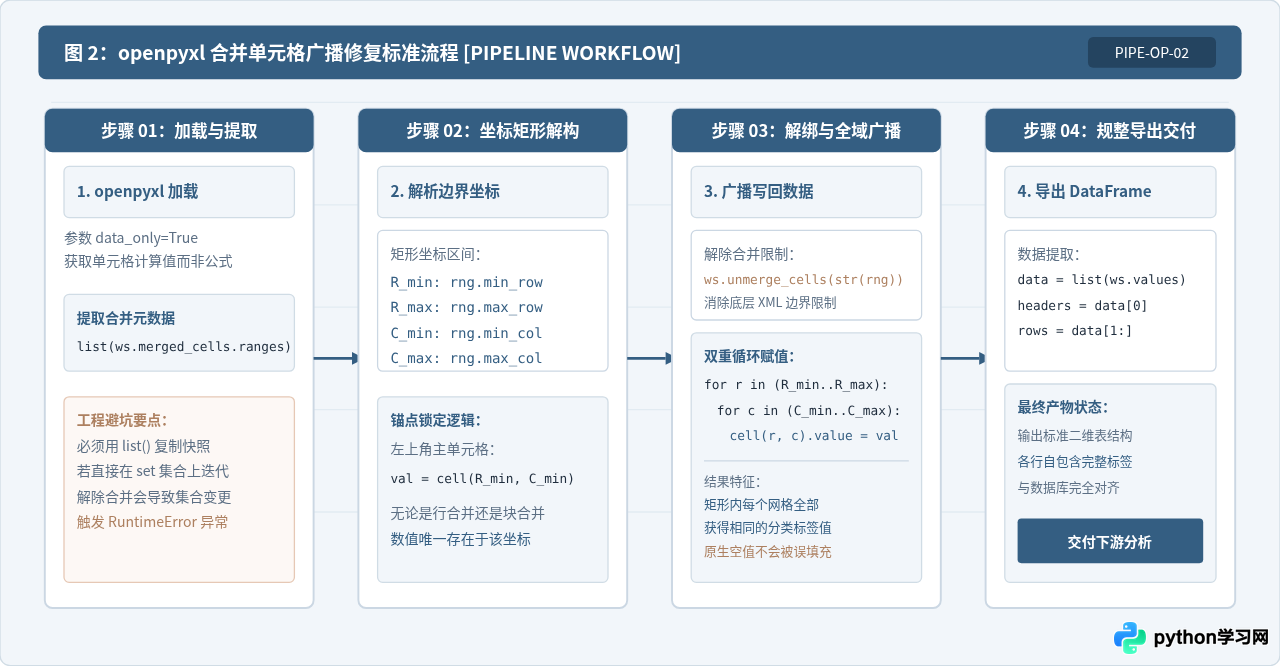
1. 实现流程与处理逻辑
该方案的标准操作链路分为四个有序阶段:
- 加载工作簿:使用
data_only=True模式打开文件,确保单元格内存在公式时,读取的是计算值而非公式表达式本身。 - 提取合并区域列表:通过
ws.merged_cells.ranges获取工作表中所有的合并矩形。需要将该迭代器转换为静态list,避免后续在遍历中解绑单元格时破坏迭代器状态。 - 解构坐标并解除合并:对每个合并区域,提取最小行(
min_row)、最大行(max_row)、最小列(min_col)与最大列(max_col),获取主单元格ws.cell(row=min_row, column=min_col).value,解除合并后双重循环广播赋值。 - 导出结构化数据:遍历清洗后的
ws.values,将其转换为纯净的 Pandas DataFrame 或二维数组交付给业务代码。
2. 生产级完整代码实现
下面是一个封装好的完整通用函数,能够读取任意指定工作表,解除合并并自动补全所有被合并单元格的数据,最终以标准的 Pandas DataFrame 格式返回。
import openpyxl
import pandas as pd

def read_excel_unmerged(file_path, sheet_name=None):
    """
    读取包含合并单元格的Excel文件,将合并区域的数据自动补全并转为DataFrame。

    参数:
        file_path (str): Excel文件路径
        sheet_name (str, 可选): 目标Sheet名称。默认加载活跃工作表

    返回:
        pandas.DataFrame: 整理平铺后的规整数据表
    """
    # 1. 以只读计算值模式打开工作簿
    wb = openpyxl.load_workbook(file_path, data_only=True)
    ws = wb[sheet_name] if sheet_name else wb.active

    # 2. 复制合并单元格范围集合(避免解除合并时引发集合迭代异常)
    merged_ranges = list(ws.merged_cells.ranges)

    # 3. 遍历每一个合并区域,读取左上角数值并完成全域广播
    for rng in merged_ranges:
        # 取左上角首单元格的值
        top_left_value = ws.cell(row=rng.min_row, column=rng.min_col).value

        # 解除单元格合并状态
        ws.unmerge_cells(str(rng))

        # 遍历该矩形区域的所有行和列,赋予相同的值
        for row in range(rng.min_row, rng.max_row + 1):
            for col in range(rng.min_col, rng.max_col + 1):
                ws.cell(row=row, column=col, value=top_left_value)

    # 4. 提取处理后的全部数据
    data = list(ws.values)
    if not data:
        return pd.DataFrame()

    # 默认第一行为表头,后续行为数据
    headers = data[0]
    rows = data[1:]

    return pd.DataFrame(rows, columns=headers)

# 示例调用
if __name__ == "__main__":
    df = read_excel_unmerged("业务数据表.xlsx")
    print("读取成功,数据前5行如下:")
    print(df.head())
data_only=True 保证包含公式的单元格返回实际计算值。ws.unmerge_cells(str(rng)) 会抹去底层的合并声明,随后对矩形内的每个单元格直接赋值。由于操作全程在内存中进行,并未执行 wb.save(),因此原始 Excel 文件保持只读且不被修改。
三、方案二:基于 Pandas 的快速补全与多级表头处理
虽然 openpyxl 的坐标广播是彻底的通用解法,但在许多快速数据探索场景中,如果数据结构较为简单(如仅在第 1、2 列有规范的向下行合并,且被合并列本身不存在真正的业务空值),我们可以直接使用 Pandas 进行更加轻量的处理。
1. 单纯行合并的向前填充:ffill()
当 Excel 表格仅仅是在左侧分类列对相同内容进行了垂直单元格合并时,Pandas 读取后,首行会有值,后续合并行表现为 NaN。此时可以直接调用 ffill()(Forward Fill,即用前一个有效值向下填充):
import pandas as pd

# 1. 正常使用 pandas 读取
df = pd.read_excel("销售分类报表.xlsx")

# 2. 指定仅对合并的分类维度列进行向下填充
columns_to_fill = ["大区", "省份", "部门"]
for col in columns_to_fill:
    if col in df.columns:
        df[col] = df[col].ffill()

print(df.head(10))
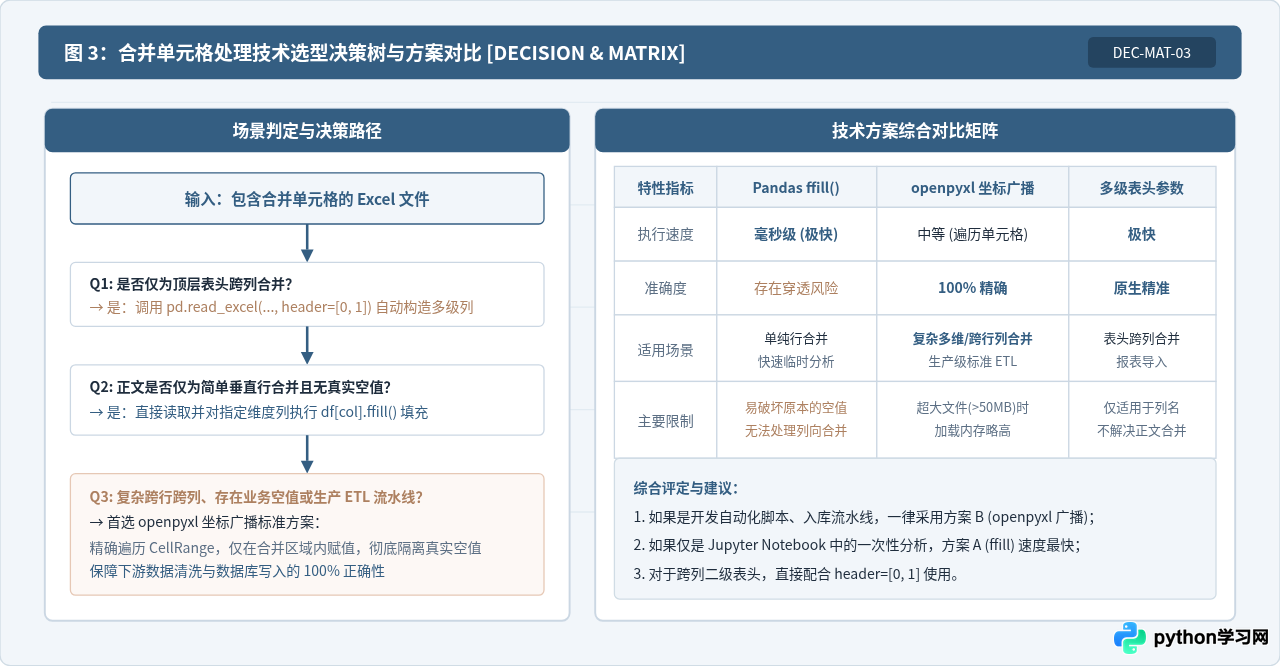
ffill() 是无差别向下填充。如果原始数据中某一行的该列确实就是“缺失/未登记”状态,ffill() 会错误地将上一行的值填入进去,产生数据污染。此外,如果合并列在遇到新分类时忘记中断,也会发生“穿透错误”。因此,仅在明确知晓该列无真实业务空值时使用。
2. 多级复合表头的合并读取:header=[0, 1]
另一种非常常见的合并场景是表头合并。例如,上方主表头跨越两列(“2025年实际完成”、“2026年目标预算”),下方二级表头为“收入”和“成本”。
对于这种表头合并,不要手动去修改正文数据,只需在读取时指定 header 参数:
import pandas as pd

# 读取双层表头(合并的顶层会自动被 Pandas 识别并填充)
df = pd.read_excel("财务季度报表.xlsx", header=[0, 1])

# 查看多级索引表头
print(df.columns)

# 扁平化多级表头为单层字符串,便于后续数据处理
df.columns = [f"{col[0]}_{col[1]}" if not col[0].startswith("Unnamed") else col[1] for col in df.columns]
print(df.columns)
四、方案对比与技术选型决策
面对不同的业务文件,选择合适的处理路径能够大幅节省开发时间并规避潜在的数据一致性风险。下图展示了从输入特征判定到方案落地的完整决策矩阵:
五、工程落地中的四个关键避坑要点
在实际工程代码中,除了掌握基本遍历算法外,还有几个容易导致程序崩溃或数据隐蔽错误的边界条件需要特别注意:
1. 公式计算值与字面量(data_only)的陷阱
如果合并单元格中的内容是通过 Excel 公式计算得出的(例如 =CONCATENATE(A2, B2) 或 =VLOOKUP(...)),如果直接使用 openpyxl.load_workbook(file)(默认 data_only=False),读取到的主单元格值将是公式字符串本身(例如 "=A2+B2"),而非最终的计算数值。因此,处理数据抽取任务时,务必显式传入 data_only=True。
data_only=True 读取的是 Excel 上一次保存时由 Excel 软件缓存的计算结果。如果文件是由第三方程序直接生成且从未在 Excel 中打开计算保存过,该缓存可能为空(即读取到 None)。遇到此类特殊文件,需要先调用 xlwings 或重新保存一次以生成计算缓存。
2. 只读模式(read_only=True)与合并单元格的兼容性冲突
在处理超大文件时,很多开发者习惯开启 read_only=True 来降低内存。但是,在 openpyxl 的只读模式下,工作表的 merged_cells 属性不会被解析或无法正常访问。因此,如果需要处理包含合并单元格的数据,不能启用 read_only=True,必须在标准工作簿模式下加载并进行解析。
3. 合并区域内嵌套真实空值
有些特殊业务表在合并列右侧的正文中存在完全合法的空单元格(例如某客户未留下电话号码)。如果采用 Pandas 的全局 ffill(),会导致电话号码列被上一行的电话无辜填满。这也是为什么必须通过 openpyxl 的 CellRange 精确限定填充范围的原因——只有在矩形边界内部才赋予相同的值,矩形外部的真实空值完好保留。
4. 内存优化:基于坐标映射的免修改读取法
如果 Excel 文件比较大,且不希望在内存中频繁调用 unmerge_cells 和修改单元格对象,可以先通过单次扫描构建一个坐标哈希字典,随后在提取数据时快速查找:
def build_merged_lookup_table(ws):
    """
    构建合并单元格坐标查找字典。
    键: (row, col)
    值: 对应合并区域左上角单元格的数值
    """
    lookup = {}
    for rng in ws.merged_cells.ranges:
        val = ws.cell(row=rng.min_row, column=rng.min_col).value
        for r in range(rng.min_row, rng.max_row + 1):
            for c in range(rng.min_col, rng.max_col + 1):
                lookup[(r, c)] = val
    return lookup

# 使用示例:在逐行遍历时直接通过字典获取
lookup_table = build_merged_lookup_table(ws)
# 当访问 (row, col) 时:
cell_val = lookup_table.get((r, c), ws.cell(row=r, column=c).value)
这种方法时间复杂度为 O(M),M 为被合并网格总数,在大型报表解析时能够保持极低的内存开销与卓越的运行速度。
六、全流程规范与数据质量检验总结
将上述所有处理规范整理为系统性的工程质量管理体系,可以将其归纳为四个分层阶段。每个阶段具备明确的质检哨兵,确保流入下游数据库或机器学习模型的数据绝对干净对齐。
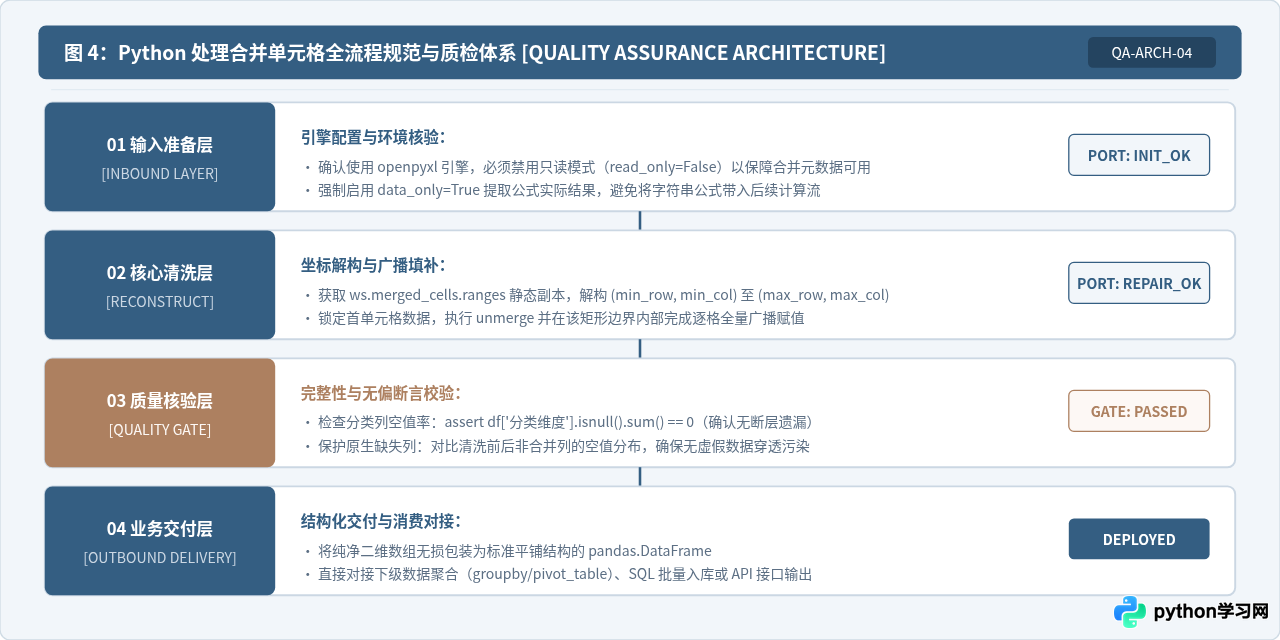
总结来说,Python 读取合并单元格的核心原则在于“理解底层只在左上角存储真实值的物理规则”。在实际项目中,优先推荐使用 openpyxl 配合坐标全量广播方案,它能够兼顾各种复杂的合并形态且绝不误伤原生空值;而在日常快速探索或处理整齐行合并时,合理运用 Pandas 的 ffill() 或 header=[0, 1] 则能极大提高编码效率。掌握这两套方法并严格遵守前置配置与质检校验,即可从容应对各种复杂 Excel 表格的数据清洗工作。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









