

图解Python浅拷贝与深拷贝:对象复制层级直观演示
深入图解Python中的直接赋值、浅拷贝与深拷贝机制,直观演示对象复制的内存层级差异、嵌套修改副作用以及深浅拷贝的选择策略与代码实践。
一、内存模型基础:变量与对象引用的本质
Python 的变量系统与传统的 C/C++ 变量在物理内存上有本质区别。在 Python 中,变量并非专门开辟一块容纳实际值的独立内存单元,而是一个贴在对象上的“名称标签”(Name Tag)。当我们执行 a = [1, [2, 3]] 时,运行时首先在堆内存中创建整数、子列表和外层列表对象,然后将名称 a 绑定到外层列表的内存起始地址。
如果直接将 a 赋值给另一个变量 b = a,Python 并没有复制任何列表或数据,它仅仅将标签 b 指向了 a 目前所指的同一个堆内存地址。我们可以通过内置函数 id() 查看对象唯一的内存标识符,或使用 is 身份运算符来验证这一点:
# 演示:直接赋值的引用共享机制
orig = [1, [2, 3]]
alias = orig

print("orig 内存地址 :", id(orig))
print("alias 内存地址:", id(alias))
print("两者是否同一对象:", orig is alias)  # 输出: True

# 修改 alias 内部内容
alias[0] = 99
print("orig 受到同步影响:", orig)  # 输出: [99, [2, 3]]
上述代码说明直接赋值无法实现数据隔离。要真正得到一个不受后续修改影响的数据副本,就需要根据数据结构的嵌套深度,在“浅拷贝”与“深拷贝”之间做出合理选择。
二、浅拷贝的实现路径与运行机制
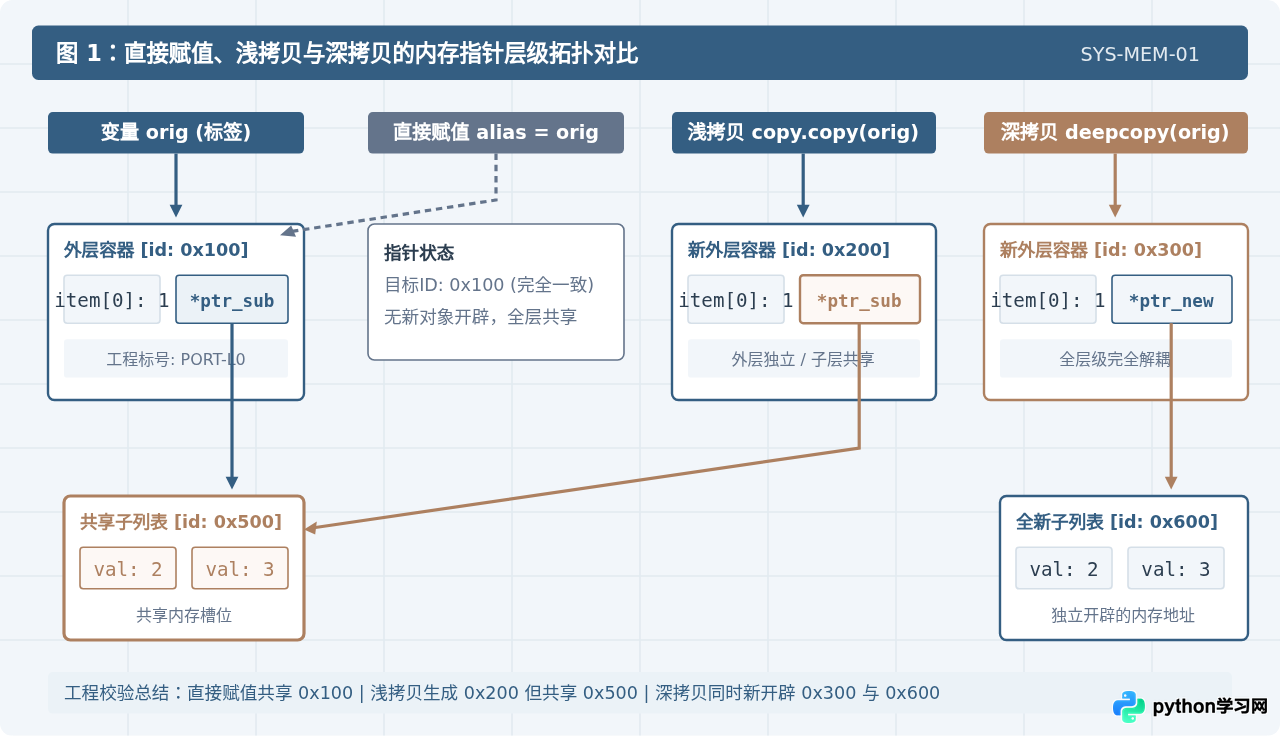
浅拷贝(Shallow Copy)的核心行为是:只构建最外层的全新容器对象,并把原容器内所有元素引用的物理地址原样复制到新容器中。
在日常开发中,浅拷贝有多种常用的内置表达方式:
- copy 模块调用:使用
import copy; copy.copy(x),这种方式具备通用性,适用于任何对象。 - 切片语法:针对列表、元组等序列类型,执行全切片
list_copy = original[:]。 - 类型构造器:使用内置类型的工厂函数,如
list(original)、dict(original_dict)或set(original_set)。 - 内置复制方法:列表的
list.copy()或字典的dict.copy()。
当数据仅包含一层扁平数据(例如纯整数或纯字符串列表)时,浅拷贝足以实现数据保护。因为不可变对象(如 int、str)被修改时只会让容器槽位指向新对象,原容器的槽位不会被联动改变。然而,一旦数据结构中存在嵌套的可变对象(例如列表中嵌套子列表、字典中嵌套子字典),浅拷贝就会暴露出“共享下层对象”的副作用。
copy_list[0] = 100),这仅改变了新容器自身的槽位指针,原对象不会受到影响;但如果通过指针调用了子对象的方法(例如 copy_list[1].append(4)),原对象也会同步改变,因为两者内部保存的是同一个子对象的指针。
三、深拷贝的运作原理:递归克隆与备忘录机制
深拷贝(Deep Copy)通过标准库的 copy.deepcopy() 函数实现。其运行策略是深度优先地递归遍历输入对象的所有属性、键值和子元素。只要遇到复合对象,就会在堆内存中申请对应类型的新空间,直到触碰到最底层的不可变叶子节点(如整型、浮点型、布尔型、字符串等)。
在递归复制的过程中,深拷贝必须解决一个复杂的图结构问题:对象的循环引用(Circular References)与多重共享引用。如果对象内部包含相互引用(例如列表包含自身 a.append(a)),单纯的递归会导致无限循环并最终触发栈溢出异常(RecursionError)。
copy.deepcopy() 通过在内部维护一个 memo 字典解决了这个问题:
- 当深拷贝开始遍历一个复合对象时,首先检查该对象的物理内存地址
id(obj)是否已存在于memo字典中。 - 若已存在,直接返回先前已创建好的对应新副本引用,立即截断重复递归。
- 若不存在,先开辟新容器,将其写入
memo[id(obj)] = new_obj,然后再深入复制该对象的各项子元素。
这种备忘录机制不仅避免了死循环,还能确保原始结构中原本指向同一个子对象的两个不同内部指针,在克隆后依然共同指向对应克隆出来的同一个新子对象,完整保持了内部拓扑结构的真实性。
四、嵌套修改实测:状态演变与副作用追踪
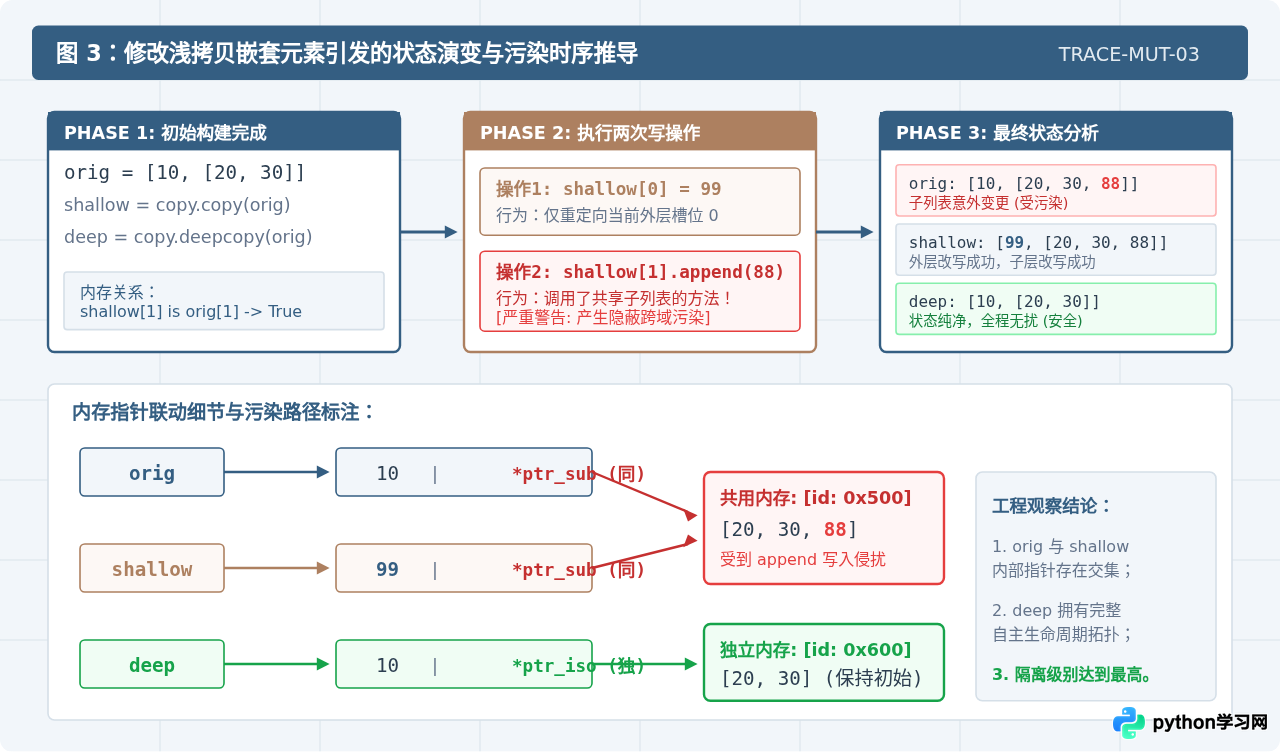
为了直观验证深浅拷贝在实际修改中的行为差异,我们使用一段包含两层结构的典型数据进行对比操作。观察对浅拷贝对象进行修改时,哪些元素会被原样保护,哪些元素会产生跨对象污染。
import copy

# 1. 构造具有嵌套结构的原始列表
orig = [10, [20, 30]]

# 2. 分别创建浅拷贝与深拷贝副本
shallow_obj = copy.copy(orig)
deep_obj = copy.deepcopy(orig)

# 3. 执行修改操作 A:修改浅拷贝对象的顶层元素 (槽位 0)
shallow_obj[0] = 99

# 4. 执行修改操作 B:向浅拷贝对象的嵌套列表中追加元素 (槽位 1)
shallow_obj[1].append(88)

# 5. 输出状态观察
print("原始对象 orig       :", orig)
print("浅拷贝对象 shallow_obj:", shallow_obj)
print("深拷贝对象 deep_obj   :", deep_obj)
运行上述脚本后,终端给出的标准输出结果如下:
原始对象 orig       : [10, [20, 30, 88]]
浅拷贝对象 shallow_obj: [99, [20, 30, 88]]
深拷贝对象 deep_obj   : [10, [20, 30]]
通过这个输出可以得出两个明确的实测结论:
- 顶层独立生效:
shallow_obj[0] = 99仅使浅拷贝对象的第一个槽位更新为 99,原对象orig[0]依旧保持为 10,这证明浅拷贝的外层容器是相互隔离的。 - 嵌套层被污染:当执行
shallow_obj[1].append(88)时,orig[1]同样出现了 88。这是因为orig[1]与shallow_obj[1]存放的是同一个子列表的内存指针,对该指针指向的内存进行修改会同步暴露给所有引用方。而深拷贝生成的deep_obj保持纯净,完全未受影响。
五、不可变对象的特殊拷贝表现
在 Python 中,如果被拷贝的对象本身是不可变类型(例如 int、str、float、tuple、frozenset),运行时会触发底层优化机制,其表现与可变对象存在显著区别:
- 不可变对象的浅拷贝:执行
copy.copy(t)(其中t为纯不可变元素的元组)时,Python 不会创建任何新元组,而是直接返回原对象的引用。这是因为元组内容无法被修改,创建副本完全没有必要,直接复用既节省内存又提升执行效率。 - 不可变对象的深拷贝:执行
copy.deepcopy(t)时,如果该元组只包含不可变类型(例如(1, 2, "hello")),深拷贝同样会直接返回原元组的引用;但如果元组内部嵌套了可变对象(例如(1, [2, 3])),深拷贝依然会按预期递归创建全新的元组及全新子列表。
# 演示不可变对象的优化表现
t1 = (1, 2, 3)
t2 = copy.copy(t1)
t3 = copy.deepcopy(t1)

print("纯不可变元组浅拷贝是否同一对象:", t1 is t2)  # 输出: True
print("纯不可变元组深拷贝是否同一对象:", t1 is t3)  # 输出: True

# 嵌套可变元素的元组
complex_t = (1, [2, 3])
deep_complex_t = copy.deepcopy(complex_t)

print("含可变对象元组深拷贝是否同一对象:", complex_t is deep_complex_t)  # 输出: False
print("内部列表是否同一对象:", complex_t[1] is deep_complex_t[1])       # 输出: False
六、工程选型与常见类型行为对照
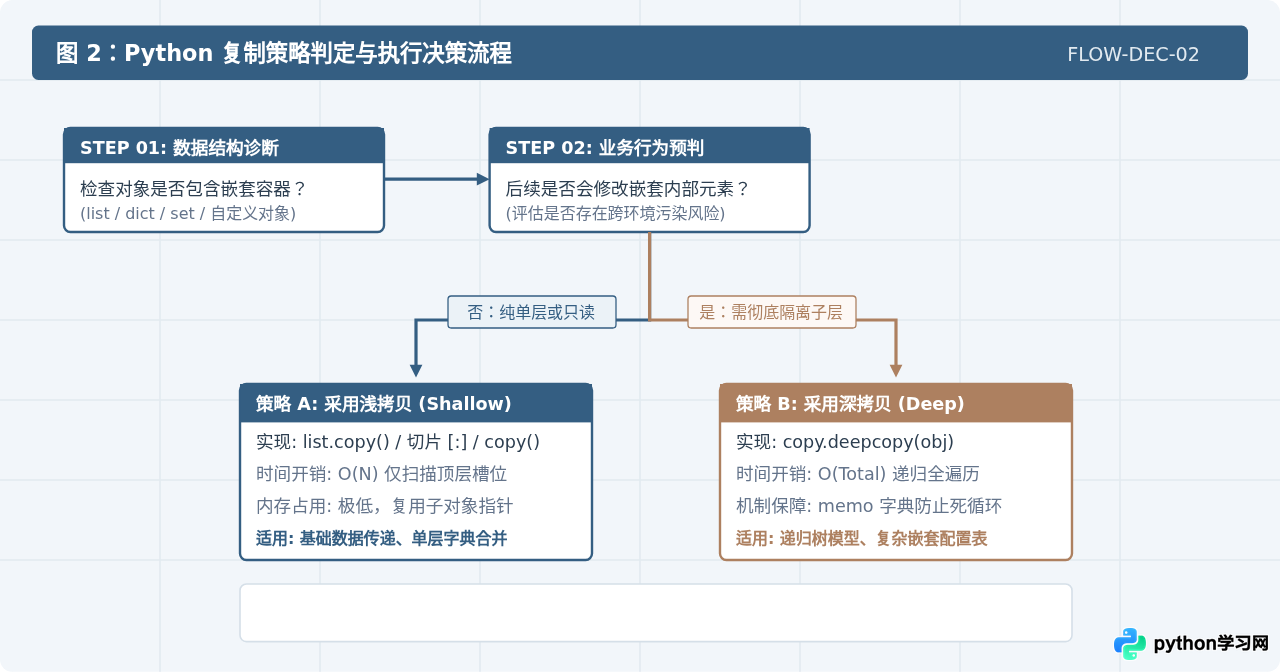
在实际项目架构中,并非所有地方都应无脑使用深拷贝。深拷贝需要遍历整棵对象树并维护内部哈希表,其时间复杂度为 $O(N)$($N$ 为整棵树的节点总数),且需要成倍申请内存空间。如果对象层级很深或包含庞大的数据结构,滥用深拷贝会带来显著的 CPU 瓶颈和内存抖动。
下面列出不同复制方式在核心指标上的横向对比与选型基准:
| 对比维度 | 直接赋值 ( = ) | 浅拷贝 (copy / 切片) | 深拷贝 (deepcopy) |
|---|---|---|---|
| 外层容器 | 完全同一对象 (同一内存地址) | 全新开辟独立容器 | 全新开辟独立容器 |
| 嵌套子对象 | 完全同一对象 | 共享原始子对象引用指针 | 递归克隆全新子对象 |
| 时间复杂度 | $O(1)$ 恒定 | $O(K)$ 仅正比于外层元素数量 | $O(N)$ 正比于整棵对象树节点总数 |
| 内存开销 | 仅新增一个指针标签 | 仅新增外层容器内存槽位 | 复制全量数据,内存翻倍 |
| 循环引用处理 | 无影响 (指向同地址) | 无影响 (仅拷贝顶层指针) | 通过 memo 字典自动拦截死循环 |
| 典型适用场景 | 函数参数传递、别名引用 | 扁平数据克隆、单层列表去重重排 | 嵌套配置项修改、树形/图数据隔离 |
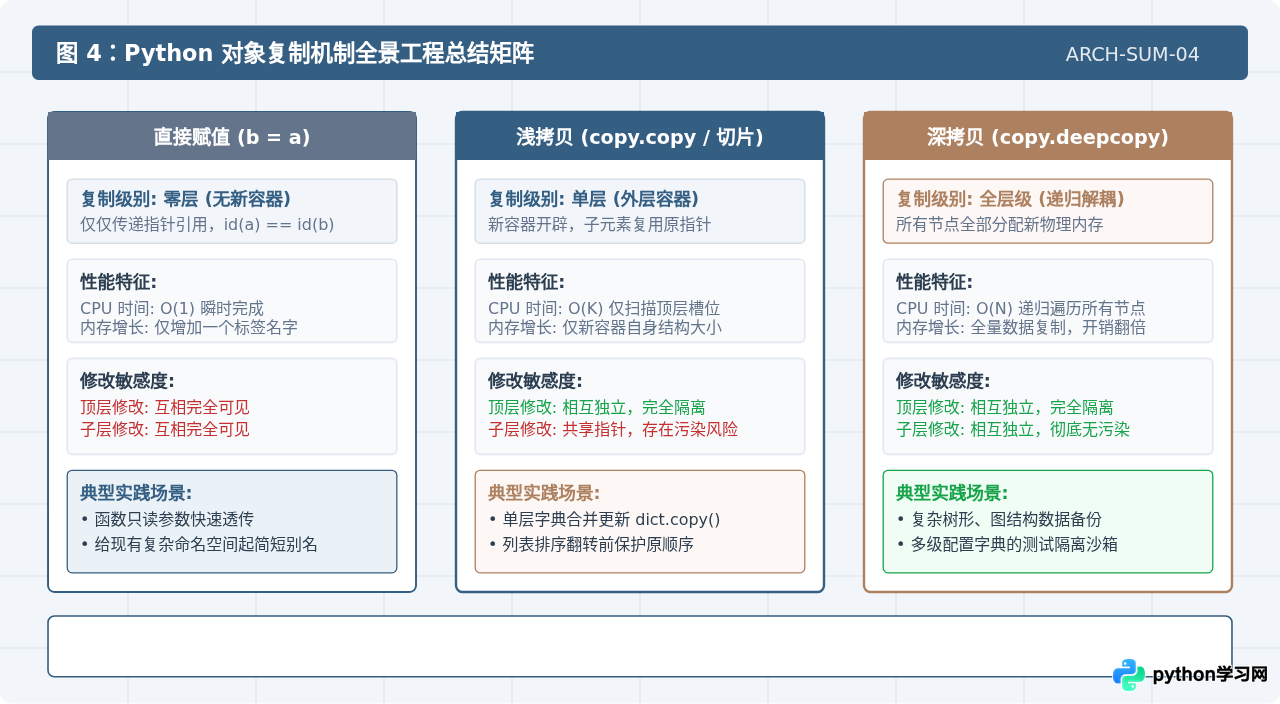
七、实施总结与自检规范
在日常开发与代码审查(Code Review)中,判断复制行为是否符合预期只需记住三条工程准则:
- 看结构层级:如果操作的对象是纯扁平的一维列表或字典(不含嵌套可变对象),切片
[:]或copy.copy()就能提供充分的隔离保护,无需动用更耗费资源的copy.deepcopy()。 - 看修改维度:如果只是对副本对象进行读取、检索、过滤,或者仅对最外层的槽位做整体替换,浅拷贝便已足够;只要涉及通过副本对深层节点进行
append()、pop()、update()等就地修改(In-place mutation),必须使用深拷贝。 - 用代码验证:在单元测试或调试阶段,直接打印
id(a) == id(b)与id(a[child]) == id(b[child]),通过指针地址的同一性校验,即可快速确认内存拓扑是否符合隔离预期。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









