

旧Python项目怎么渐进式引入类型注解
针对大型或存量老旧 Python 项目,系统讲解如何渐进式引入 PEP 484 类型注解与 mypy 静态检查。从配置宽松基线、自底向上模块拆解、MonkeyType 辅助推导,到 CI 增量卡点与团队治理,提供清晰、具体且可执行的落地实践指南。
一、放弃“一步到位”,确立渐进隔离核心原则
很多工程团队在决定引入类型注解(Type Hints)时,最常犯的错误是直接运行 mypy .。在没有类型约束的动态代码库中,由于动态字典穿透、第三方未标注库引用、鸭子类型随意分派等历史写法,检查器通常会倾泻出成千上万条报错。面对这道难以逾越的高墙,团队往往只能无奈放弃。
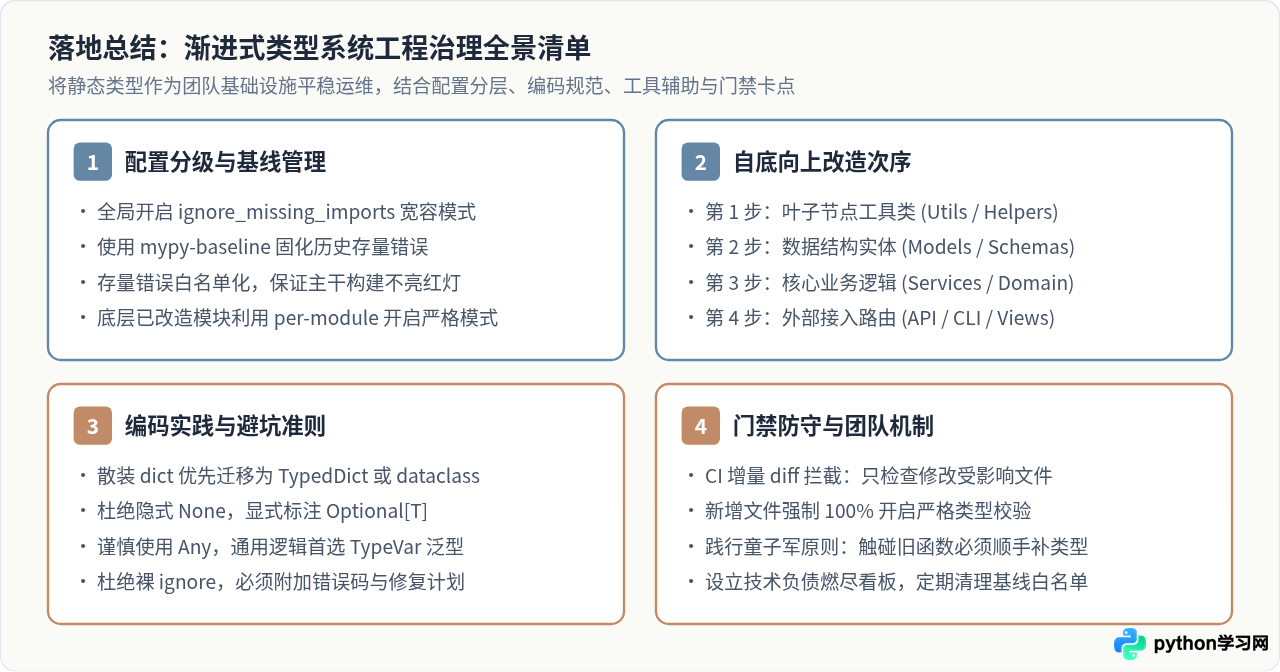
要想在不中断日常需求迭代的前提下改造旧项目,必须遵循四项基本准则:
- 保住增量(不增新债):新提交的文件与新编写的函数,一律以 100% 严格类型模式接入,绝不允许任何未标注代码混入代码库。
- 冻结存量(基线白名单):将现有的历史报错生成静态快照(Baseline),在 CI 构建中作为“已知存量”放行,仅拦截任何新增的类型违规。
- 自底向上(沿拓扑推进):优先改造无任何外部业务依赖的基础工具库与数据模型,再逐步向业务服务层与视图接入层蔓延。
- 由宽至严(分级收紧配置):全局采用宽松规则保证不炸,局部核心模块通过模块级配置(Per-module Options)单独开启严格检查。
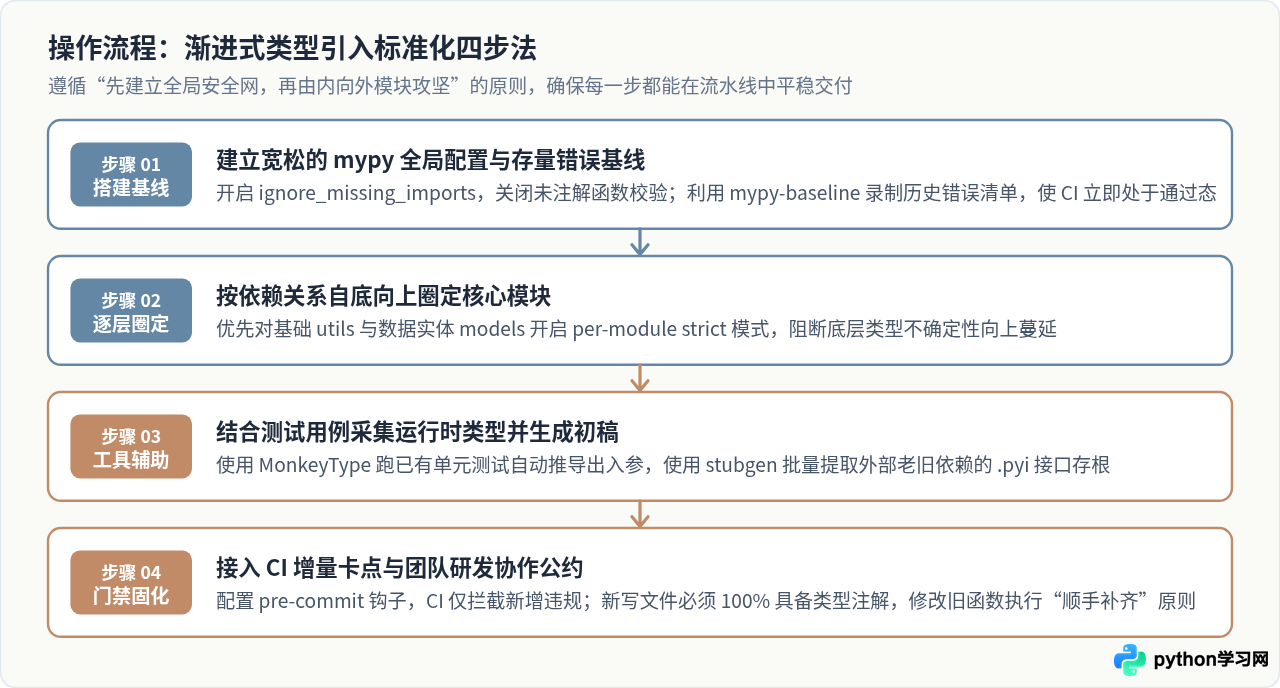
二、步骤一:配置宽松的全局基线与存量白名单
第一步是引入类型检查工具并完成最小化、不干扰现有构建的全局配置。目前 Python 生态最通用的静态检查器是 mypy。在项目根目录下创建 mypy.ini 或配置 pyproject.toml:
# mypy.ini
[mypy]
# 声明当前项目目标 Python 版本
python_version = 3.10

# 1. 忽略未安装类型存根的第三方老库(核心防爆开关)
ignore_missing_imports = True

# 2. 静默跟踪导入模块的错误,不反复提示依赖库内部问题
follow_imports = silent

# 3. 初始阶段不要强制检查未标注类型的函数体,避免全量报错
check_untyped_defs = False
disallow_untyped_defs = False

# 4. 显示具体的错误代码,方便精细化豁免与识别
show_error_codes = True
pretty = True在这份基础配置中,ignore_missing_imports = True 是重中之重。老项目通常依赖数十个缺乏 PEP 561 标记的旧三方轮子,开启此选项能避免检查器在外部库层面直接崩溃。
使用 mypy-baseline 固化历史报错
配置完成后,即使在宽松模式下,存量代码仍可能存在几百处类型冲突。此时使用 mypy-baseline 工具将现有问题生成基线快照:
# 安装 baseline 工具
pip install mypy-baseline

# 运行 mypy 并将当前全部报错录入基线文件
mypy my_project | mypy-baseline sync --record-file .mypy-baseline

# 校验当前状态(此时应返回退出码 0,表示存量已被记录)
mypy my_project | mypy-baseline filter --record-file .mypy-baseline三、步骤二:按依赖拓扑“自底向上”圈定核心模块
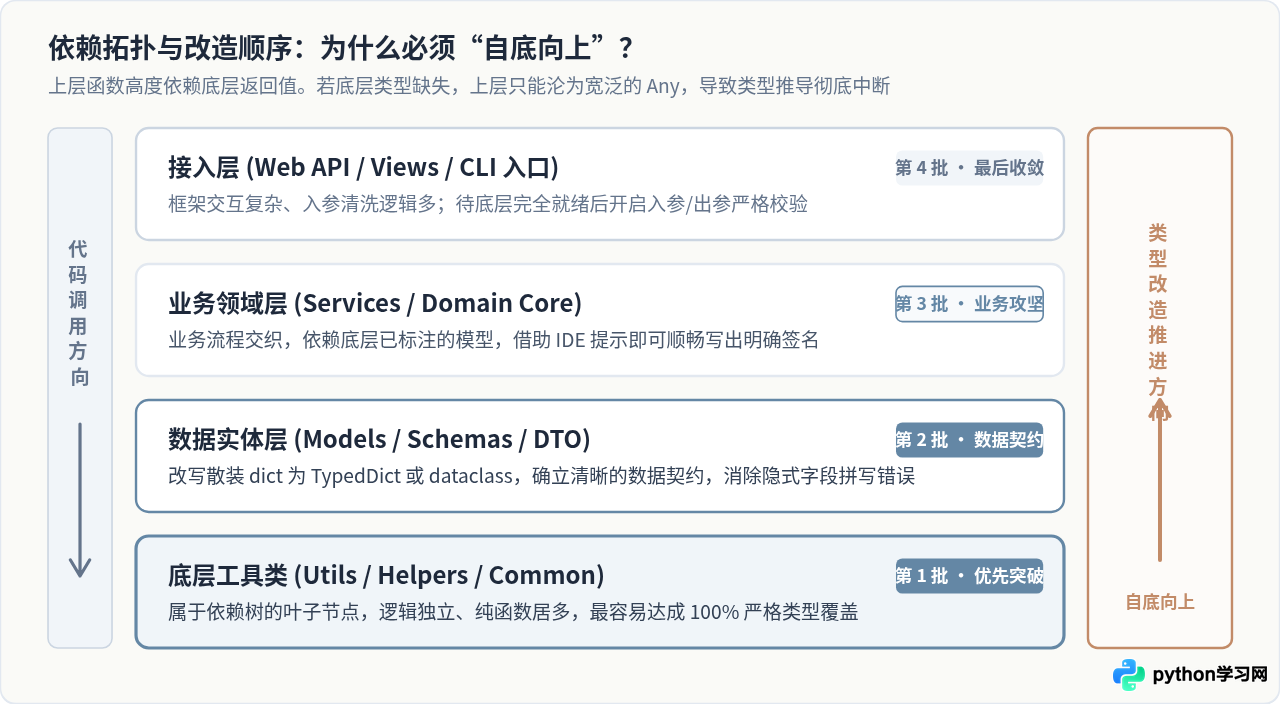
很多开发者习惯从接口控制器(API View)或命令行入口改起,这往往会导致重构寸步难行。因为上层函数的入参多来自底层模型,如果底层函数没有类型,上层只能被迫标注为 Any,后续类型推导直接中断。
合理的演进路线应当严格按照代码调用拓扑自底向上推演:
在 mypy.ini 中分模块开启严苛检查
在确认了从叶子节点到根节点的推进次序后,无需修改全局配置,直接在 mypy.ini 中利用模块通配符,为已改造的底层目录开启最高等级检查:
# 针对无业务依赖的基础工具库:开启完整严格模式
[mypy-my_project.utils.*]
disallow_untyped_defs = True
disallow_incomplete_defs = True
check_untyped_defs = True
warn_return_any = True

# 针对数据实体与数据传输对象层:杜绝未标注定义
[mypy-my_project.models.*]
disallow_untyped_defs = True
check_untyped_defs = True
这种按模块设防的做法,能让团队像切分微服务一样,每周集中精力歼灭一两个子模块的类型盲区,逐步形成自下而上的坚固防护层。
四、步骤三:借助工具链半自动化推导初稿
面对动辄数十万行的存量业务代码,纯手工逐行推导参数和返回值极其枯燥且容易出错。善用 Python 生态的开源推导工具,能够自动化完成 60% 以上的样板工作。
1. 利用 MonkeyType 采集运行时真实类型
Instagram 开源的 MonkeyType 通过在 Python 运行时注入跟踪器,在代码执行期间收集实际传递的参数和返回值类型,随后直接将注解生成并写回源代码文件:
# 借助现有的高覆盖率单元测试收集类型轨迹
monkeytype run pytest tests/unit/test_string_utils.py

# 预览生成给对应模块的类型标注补丁
monkeytype stub my_project.utils.string_utils

# 确认无误后直接应用修改写回源码
monkeytype apply my_project.utils.string_utils
2. 使用 stubgen 提取存根文件
对于一些逻辑过于混杂、短期内不适合直接修改源码的内部老黑盒模块,可以使用 mypy 自带的 stubgen 工具为其生成 .pyi 存根文件:
# 扫描 legacy_core 目录,生成对应的 .pyi 接口存根
stubgen my_project/legacy_core -o stubs/
生成的 .pyi 存根保留了类名、函数名与基础参数,虽然类型初值多为 Any,但为后续逐步填充真实签名提供了无需侵入旧源码的轻量跳板。
五、步骤四:破解旧代码四大典型类型泥潭
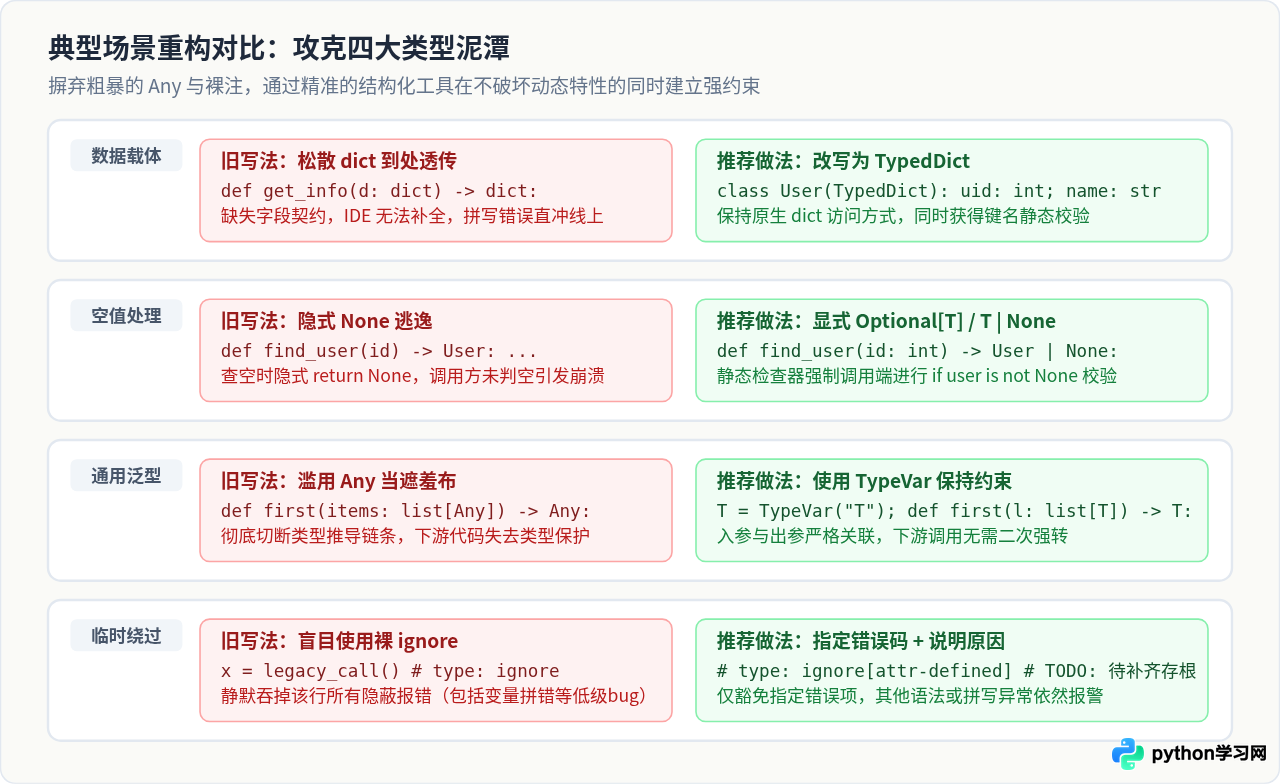
在旧 Python 代码中落地类型系统时,经常会遇到几类破坏类型检查的经典写法。如果不加辨别地简单粗暴处理,往往会引发“假类型安全”或引入新的运行时缺陷。
1. 散装字典向 TypedDict 演进
老代码中最常见的坏习惯是将普通 dict 作为通用数据载体。随处可见的 data["user_name"] 既无拼写提示,又可能在字段不存在时触发 KeyError。推荐使用 typing.TypedDict:
from typing import TypedDict

# 旧做法:无法得知里面究竟有哪些 key
def process_user(user_data: dict) -> None:
    print(user_data["uid"])

# 规范做法:既保留了字典索引语法,又获得了静态键检查
class UserProfile(TypedDict):
    uid: int
    name: str
    is_active: bool

def process_user(user_data: UserProfile) -> None:
    print(user_data["uid"]) # 拼写写成 u_id 时,mypy 立即报错
2. 显式化空值处理,终结 AttributeError
动态语言在查找未命中时常常顺手 return None,如果函数返回值只标注了 User 而非 User | None,调用方若遗漏判空,就会在生产环境遭遇臭名昭著的 AttributeError: 'NoneType' object has no attribute 'xxx':
from typing import Optional

# 明确告知调用端可能为空,强迫上游书写防御性判空
def get_user_by_id(user_id: int) -> Optional[UserProfile]:
    if user_id <= 0:
        return None
    return query_db(user_id)

user = get_user_by_id(10)
# 若直接执行 user["name"],mypy 会发出严格警告:
# Item "None" of "Optional[UserProfile]" has no attribute "__getitem__"
if user is not None:
    print(user["name"])
3. 限制 Any 蔓延,善用 TypeVar 泛型约束
遇到复杂类型时切忌直接甩出一个 Any,Any 会像病毒一样感染下游所有与之交互的变量。对于输入输出存在类型联动的场景,优先使用泛型 TypeVar:
from typing import TypeVar, Sequence

T = TypeVar("T")

# 保证传入什么类型的列表,返回的就是什么类型的首项
def get_first_element(items: Sequence[T]) -> T | None:
    return items[0] if items else None
4. 杜绝裸 ignore,必须绑定错误码
遇到老旧黑魔法或者类型检查器无法推断的极端场景,若必须豁免报错,绝不允许写单独的 # type: ignore。裸 ignore 会悄无声息地吞掉该行所有的语法疏漏。务必限定具体的错误代码并附带简短说明:
# 正确做法:只豁免指定的属性缺失错误,若本行存在其他类型不匹配依然会报警
raw_payload = third_party_module.dynamic_hook() # type: ignore[attr-defined] # TODO: 待补存根
六、步骤五:CI 防护网固化与团队协作治理
类型注解的引入不是一次性的技术改造,而是一项持续的工程治理。为了防止团队成员在前脚改完、后脚又被新提交拉回原点,必须依靠自动化流水线与团队公约构筑护城河。
1. 本地 pre-commit 轻量拦截
在开发机端,通过 pre-commit 框架配置钩子,只对本次暂存区(git staged)涉及的 Python 文件执行类型检查,耗时通常控制在秒级以内,不打断开发节奏:
# .pre-commit-config.yaml
repos:
  - repo: https://github.com/pre-commit/mirrors-mypy
    rev: v1.8.0
    hooks:
      - id: mypy
        additional_dependencies: [types-requests]
        args: [--config-file=mypy.ini]
2. CI 增量卡点机制
在持续集成(GitHub Actions / GitLab CI)中,运行 mypy-baseline filter 进行判定。基线内记录的历史错误不会阻塞流水线,但只要 PR 中包含基线之外的新错误,构建立刻变红并输出清晰差异。
3. 团队推行“童子军原则”
要求团队成员在日常开发中遵守两条不可妥协的工程纪律:
- 新文件新规矩:所有新创建的
.py业务代码,必须默认达到disallow_untyped_defs = True级别,提交未标注函数无法合并。 - 触碰即补齐(童子军法则):修改或重构旧函数时,无论修改范围多小,必须顺手为该函数的出入参补齐类型注解。随着业务需求的不断迭代,高频变更的核心模块会在几个月内自发完成类型安全蜕变。
七、结语
在动态类型语言中引入静态类型检查,本质上不是为了迎合编译器,而是为了给软件工程建立一套能够被计算机自动验证、永不落伍的活体架构契约。通过“宽松基线隔离、自底向上渗透、工具半自动辅助、增量门禁卡点”的渐进式策略,任何历史悠久的 Python 旧项目,都能在不破坏业务连续性的前提下,平稳演变为结构清晰、重构无忧的现代化高品质代码库。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









