

提升Python AI模型训练速度:GPU加速与数据加载优化技巧
针对Python深度学习训练中常见的GPU利用率低下与I/O阻塞问题,系统讲解数据读取流水线优化、锁页内存、异步传输、自动混合精度及内核融合等关键加速技巧。
在基于 Python 和深度学习框架(如 PyTorch)的模型训练过程中,昂贵的显卡经常处于“干等”状态。很多开发者在训练速度缓慢时,第一反应是直接更换算力更强的 GPU,但训练耗时往往并未成比例下降。其核心根源在于整个训练链条中存在显著的数据饥饿或调度阻塞:GPU 的矩阵运算速度远高于 CPU 的数据解析与传输速度,导致计算单元长期处于空闲等待状态。本文从性能瓶颈诊断入手,详细讲解数据预取流水线构建、主机到显存的异步搬运、混合精度计算以及编译优化等一系列可落地的实操手段,帮助消除训练瓶颈并充分释放硬件吞吐潜能。
一、定位训练瓶颈:判断计算受限还是 I/O 阻塞
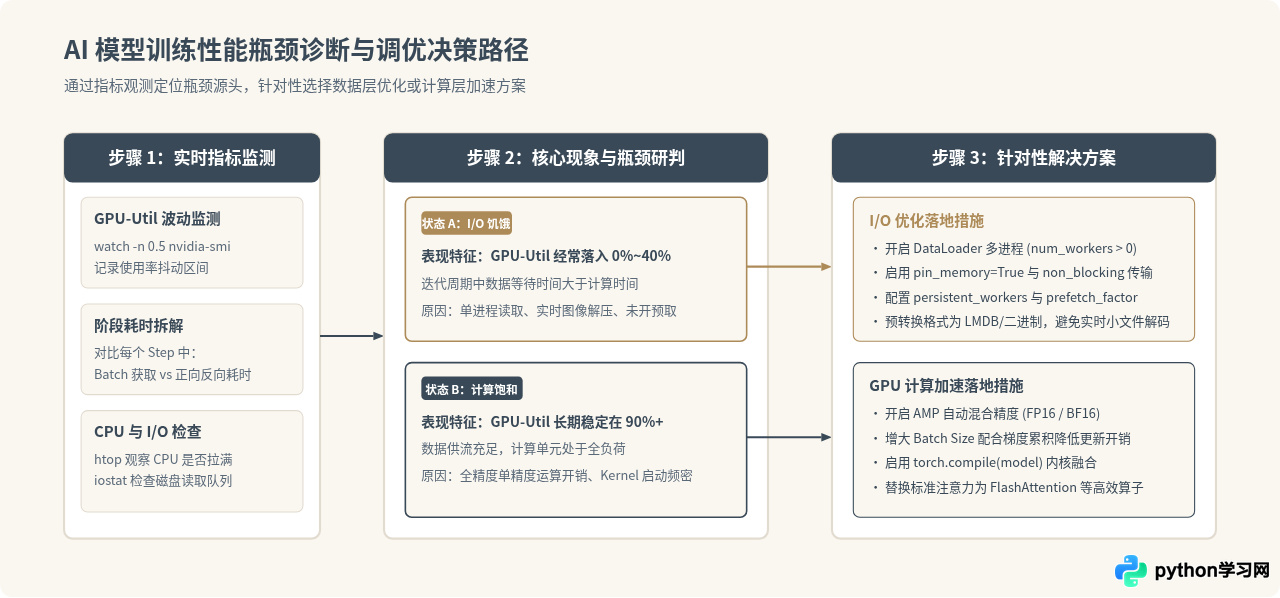
在开展任何加速配置前,必须先量化当前系统的瓶颈究竟停留在 CPU 数据处理端还是 GPU 运算端。缺乏数据支撑的盲目调优不仅效果有限,还可能引发内存溢出或多进程死锁。
最直接的基础判断方法是在训练进行过程中打开终端观察硬件实时负载:
- 使用
nvidia-smi观察 GPU 利用率(GPU-Util):如果利用率在 0% 到 95% 之间剧烈抖动,呈锯齿状循环,说明每当一个批次计算完毕,GPU 都在停工等待 CPU 准备下一个批次的数据,属于典型的 I/O 阻塞(CPU/磁盘受限)。 - GPU 利用率持续稳定在 95% 以上:说明数据流水线能够稳定喂饱显存,瓶颈处于张量计算本身,此时应重点转向模型结构计算优化、混合精度或分布式数据并行。
二、数据加载端优化:构建高吞吐 DataLoader 流水线
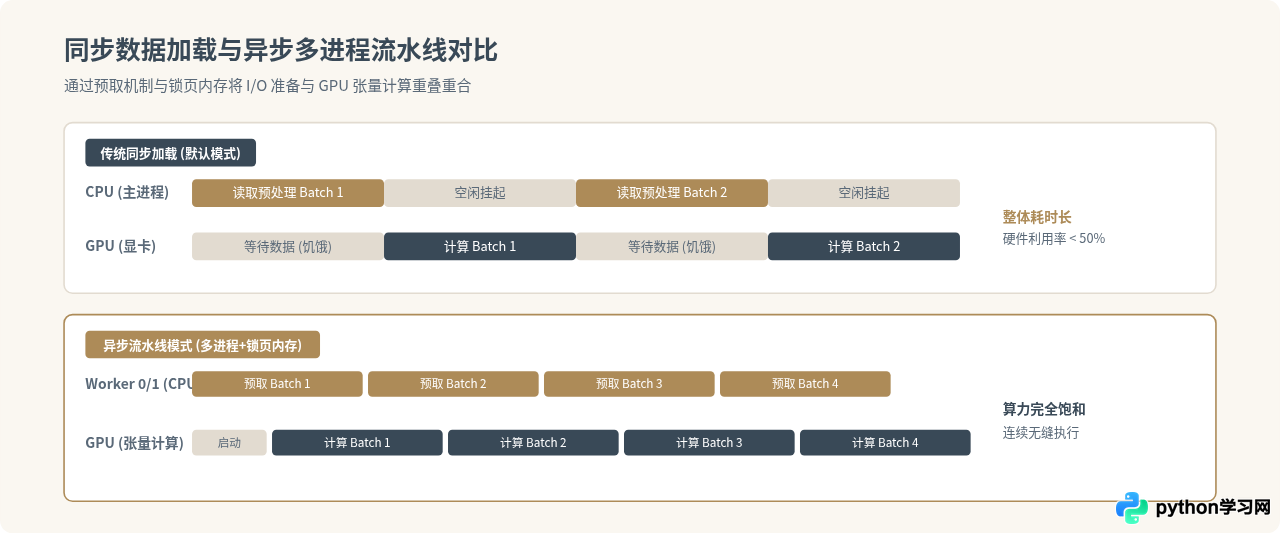
在 PyTorch 中,torch.utils.data.DataLoader 是连接存储与显卡的核心枢纽。默认参数下的 DataLoader 通常以单进程、阻塞式模式运行,极易成为系统短板。
1. 关键参数的配置与调优
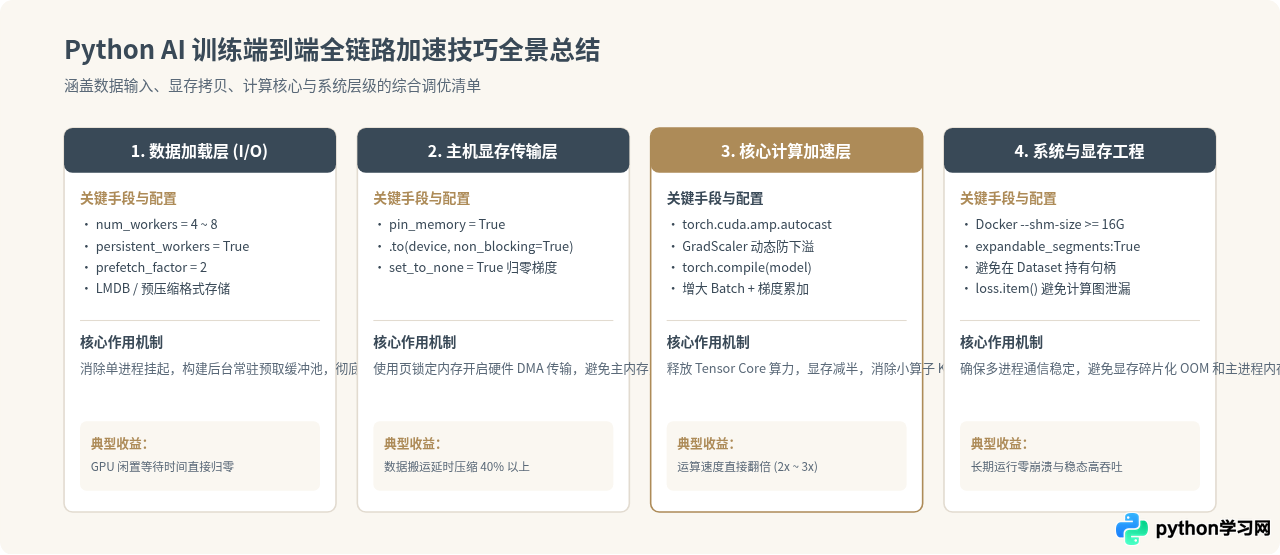
num_workers(子进程数量):默认值为 0,意味着数据读取与转换全部在主进程中执行,导致每次获取数据时计算线程完全被挂起。建议设置为4 * GPU数量或与可用物理 CPU 核心数相当。过高会导致进程间上下文切换和内存争用,过低则无法消除等待。pin_memory=True(锁页内存):CPU 的常规内存是可分页的,GPU 无法直接发起 DMA(直接内存访问)读取。开启此项后,系统将数据预先固定在不可分页的主机内存中,大幅提升向 GPU 传输的拷贝速度。persistent_workers=True:默认情况下,每个 epoch 结束时 DataLoader 都会销毁所有 worker 进程并在下一个 epoch 重新初始化。设置此项可以保持子进程常驻,避免由于频繁 fork 造成的延迟震荡。prefetch_factor(预取因子):指定每个 worker 提前预加载的批次数量(通常设为 2 或 4)。使计算批次在 GPU 上执行时,下一个批次已在 CPU 内存中解压完毕。
2. 高性能 DataLoader 构建代码示例
以下是经过性能调优的标准 DataLoader 实例化代码,包含了非阻塞显存传输配置:
import os
import torch
from torch.utils.data import DataLoader, Dataset

class OptimizedDataset(Dataset):
    def __init__(self, data_path):
        # 尽量避免在 __getitem__ 中读取零散小文件
        # 优先读取内存映射文件或预先序列化的格式
        self.data_path = data_path

    def __len__(self):
        return 10000

    def __getitem__(self, idx):
        # 模拟生成特征与标签张量
        x = torch.randn(3, 224, 224)
        y = torch.tensor(1, dtype=torch.long)
        return x, y

def create_dataloader(batch_size=64):
    dataset = OptimizedDataset("/path/to/data")

    # 根据可用硬件动态设定 worker 数量
    num_cpu_cores = os.cpu_count() or 4
    num_workers = min(8, num_cpu_cores)

    loader = DataLoader(
        dataset,
        batch_size=batch_size,
        shuffle=True,
        num_workers=num_workers,
        pin_memory=True,              # 开启锁页内存加速主机向 GPU 传输
        persistent_workers=True,       # 避免跨 epoch 重复创建 worker 进程
        prefetch_factor=2,            # 每个 worker 预先抓取 2 个 batch
        drop_last=True                # 丢弃末尾不完整 batch,保持张量尺寸稳定
    )
    return loader
三、GPU 计算与传输优化:混合精度与内核加速
在打通数据流水线后,如果 GPU-Util 已接近 100%,则需要从张量精度、显存占用以及指令调度维度进一步压榨 GPU 计算吞吐能力。
1. 自动混合精度训练(AMP,Automatic Mixed Precision)
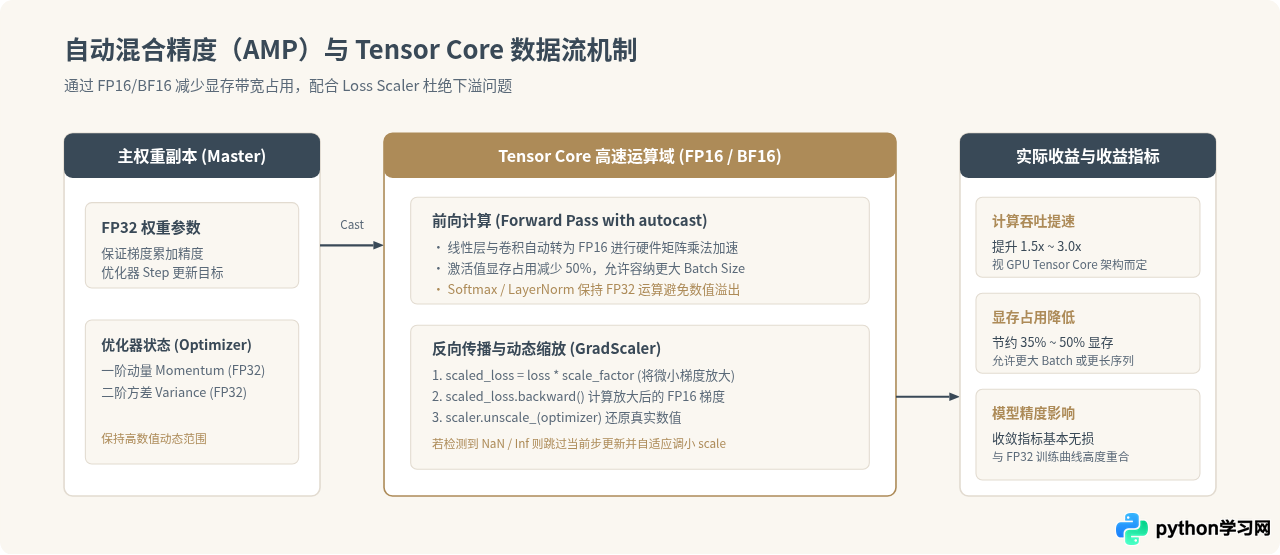
默认情况下,PyTorch 使用 32 位单精度浮点数(FP32)进行张量计算。现代 GPU(如 NVIDIA Turing、Ampere、Hopper 等架构)配备了专门的 Tensor Core,能够在半精度浮点(FP16 或 BF16)下提供数倍于 FP32 的峰值算力,同时显存带宽消耗降低一半。
PyTorch 提供了原生的 torch.cuda.amp 模块,只需在常规循环中加入自动类型转换(autocast)和损失缩放器(GradScaler),即可在保证数值稳定性的同时显著提速。
2. 混合精度训练标准循环代码
import torch
from torch.cuda.amp import autocast, GradScaler

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = MyNeuralNetwork().to(device)
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-4)
criterion = torch.nn.CrossEntropyLoss()

# 初始化梯度缩放器,防止 FP16 梯度下溢
scaler = GradScaler(enabled=(device.type == "cuda"))

for epoch in range(num_epochs):
    model.train()
    for inputs, targets in dataloader:
        # non_blocking=True 配合 pin_memory 实现异步拷贝
        inputs = inputs.to(device, non_blocking=True)
        targets = targets.to(device, non_blocking=True)

        optimizer.zero_grad(set_to_none=True) # set_to_none=True 节省内存写操作

        # 开启自动混合精度上下文
        with autocast(device_type="cuda", dtype=torch.float16):
            outputs = model(inputs)
            loss = criterion(outputs, targets)

        # 缩放损失并反向传播
        scaler.scale(loss).backward()

        # scaler.step 内部自动 unscale 梯度,如果出现 Inf/NaN 则跳过当前更新
        scaler.step(optimizer)
        scaler.update()
细节提醒:optimizer.zero_grad(set_to_none=True)
将梯度张量置为 None 而不是赋值全零矩阵,能够避免执行一次写入显存的全零填充操作,同时减少反向传播时的内存带宽占用,这是几乎零成本但立即可见的代码优化。
3. PyTorch 2.0+ 内核融合加速(torch.compile)
传统的 PyTorch 以 Eager 模式执行,每执行一行代码都会向 GPU 下发一个计算 Kernel。频繁启动短小算子会导致大量的 Kernel 启动开销与显存往返读写(I/O 带宽受限)。
在 PyTorch 2.0 及更高版本中,推荐在模型构建后调用 torch.compile(model)。它通过 TorchDynamo 拦截计算图并使用 TorchInductor 编译器,将相邻的逐元素操作、激活函数与归一化算子融合为一个复合 GPU Kernel,从而减少内存访问次数,带来 20%~40% 的额外吞吐提升。
# 仅需添加单行编译指令,其余训练循环代码完全保持不变
compiled_model = torch.compile(model)
四、工程落地避坑指南与常见问题排查
在实际工程场景中部署上述优化时,往往会遭遇与系统底层相关的边界问题:
- 共享内存溢出(
DataLoader worker killed by signal: Bus error):在 Docker 容器中多进程读取数据时,PyTorch 会利用/dev/shm在进程间传递 Tensor。Docker 默认的 shm 仅有 64MB,在多 worker 下极易引发总线错误崩溃。必须在启动容器时添加--shm-size=16g或--ipc=host。 - Dataset 内的多进程并发安全:不要在
Dataset.__init__中初始化数据库连接(如 SQLite、LMDB)或外部网络会话。因为在父进程中初始化的文件句柄被 fork 给子进程后会产生争用。正确做法是在worker_init_fn中或在__getitem__内部按需懒加载。 - 显存碎片化与 OOM:虽然增加 Batch Size 能够提升 GPU 吞吐量,但如果接近显存临界点容易发生碎片化 OOM。可通过设置环境变量
export PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True允许显存分配器动态扩展段空间。 - 不要盲目追求超大
num_workers:当设置的 worker 数量远超过物理 CPU 核心数时,线程上下文频繁切换和磁盘 IOPS 饱和反而会导致训练每步耗时变长。最佳 practice 是先从num_workers=4开始逐步递增测试,记录稳态时的 Iter/s 指标。
五、结语
提升 Python AI 模型训练速度并非单一技术点的孤立调整,而是一个由“存储读入 → CPU 数据解析与拼装 → PCIe/NVLink 显存传输 → GPU 张量计算”组成的完整闭环流水线优化。在日常开发中,应始终坚持以观测指标为导向:先借助硬件监控确认当前瓶颈所在,再依次启用多进程预取、锁页内存、自动混合精度及内核融合编译。通过这一套系统化的优化手段,能够在不更换硬件的前提下,将训练吞吐量提升数倍,显著缩短模型迭代与验证周期。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









