

Python中pandas、openpyxl和xlrd读取Excel的区别与选择
深入对比Python中pandas、openpyxl和xlrd三大Excel读取库的核心差异、底层协作机制、性能表现与选型标准,附标准化实操代码与避坑指南。
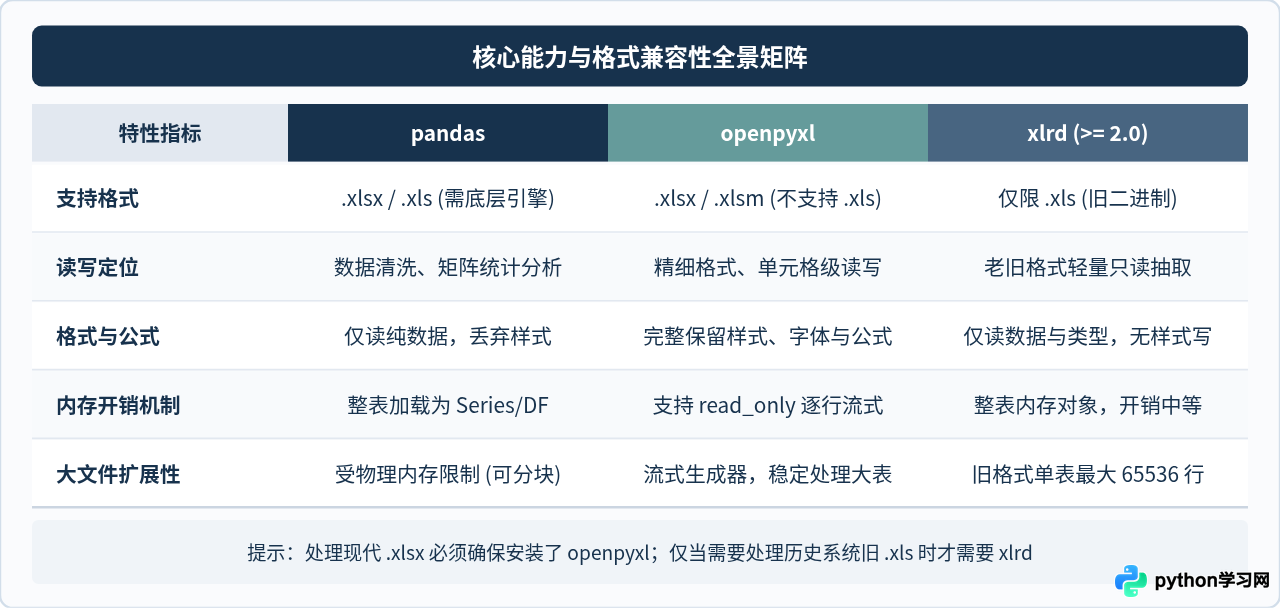
在Python中处理Excel表格时,很多开发者经常在 pandas、openpyxl 和 xlrd 之间产生困惑:为什么有的库读 .xlsx 会报错?为什么有时候读取几个文件内存就飙升?结论先明确:做数据清洗与表格统计首选 pandas;需要精细控制单元格样式、修改已有公式或用流式模式读取超大 .xlsx 文件时选 openpyxl;只有在必须读取遗留的旧版二进制 .xls 文件时,才针对性地使用 xlrd。 搞清楚这三者的分工与边界,能帮你省去大量排错与调优时间。
一、底层架构与协作关系:上层抽象与驱动引擎
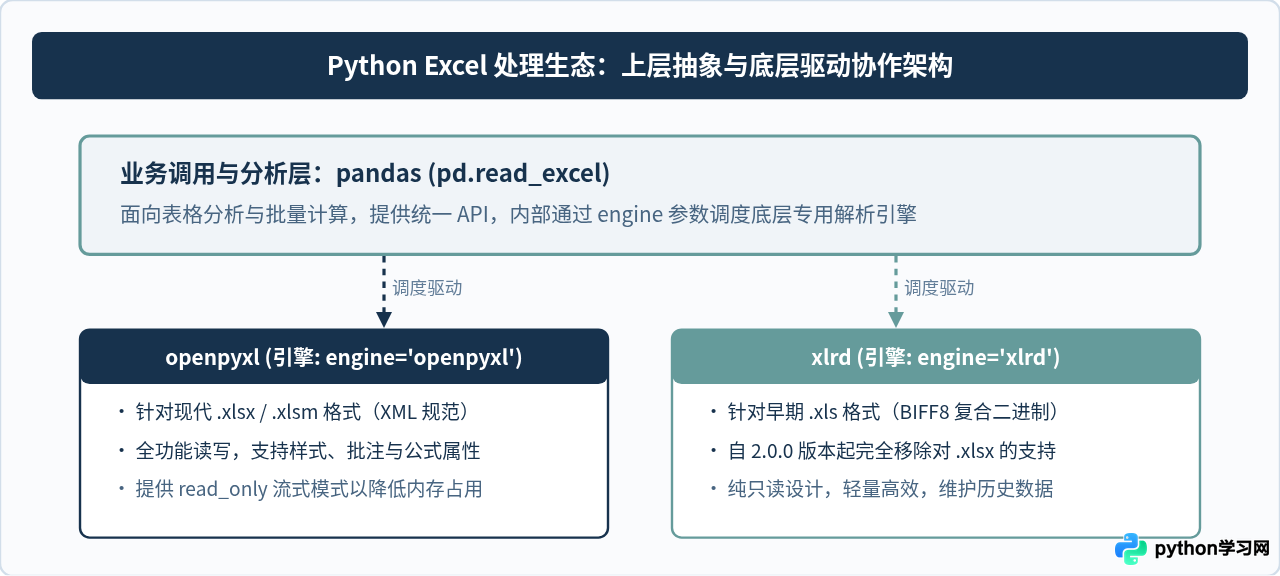
许多初学者容易产生一个认知误区,以为 pandas、openpyxl 和 xlrd 是三个完全平行的替代工具。实际上,pandas 处于更高的抽象层,而 openpyxl 和 xlrd 则是专门的底层文件格式解析器。
pandas 本身并不包含直接解析 Excel 二进制流或解压 OpenXML 架构的代码。当调用 pandas.read_excel() 时,它是在后台根据文件扩展名或显式传入的 engine 参数,将文件分发给底层的专业引擎读取,最后再将原始行列表封装为高效分析用的 DataFrame 数据结构。
二、格式兼容性与版本断代:为什么 xlrd 不能直接读 .xlsx?
在查阅网络旧资料时,经常会看到推荐用 xlrd 读取所有 Excel 文件的教程。但如果在当前环境下运行,常常会遇到如下报错:
XLRDError: Excel xlsx file; not supported这是因为 xlrd 在 2020 年发布了 2.0.0 正式版。官方鉴于 .xlsx 文件本质是由 ZIP 压缩包和若干 XML 组成的复杂结构,存在潜藏的 XML 实体注入(XXE)等安全风险,同时社区已有成熟的 openpyxl 库,因此决定主动移除所有对 .xlsx 的支持,未来仅作为旧版二进制 .xls(BIFF8 协议)的专用只读库。
三、实操演练:三者的典型读取代码与参数差异
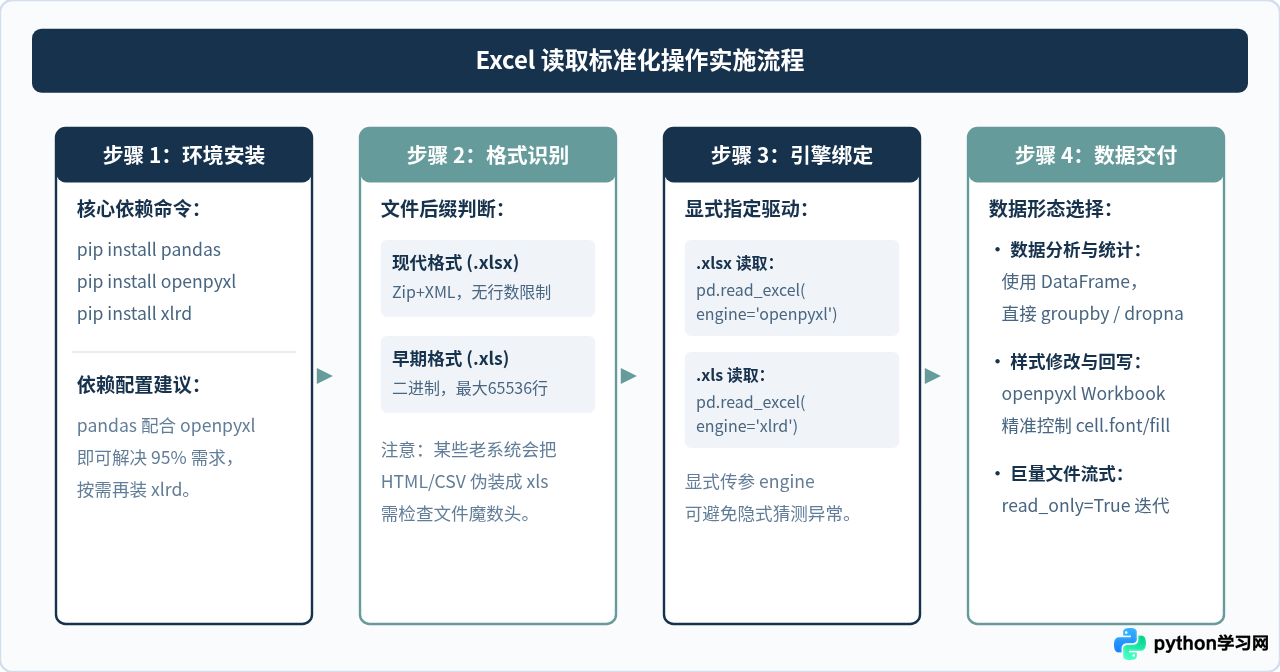
为了让不同场景的操作更加清晰,我们从依赖安装、代码实现到关键参数逐一演示。
1. pandas 读取示例:分析场景的标准范式
日常大部分表格数据处理,推荐直接使用 pandas。代码精简,类型自动转换:
import pandas as pd

# 示例:读取现代 .xlsx 文件(显式指定 engine='openpyxl')
df_xlsx = pd.read_excel('sales_data.xlsx', sheet_name='Sheet1', engine='openpyxl')

# 示例:读取旧版 .xls 文件(显式指定 engine='xlrd')
df_xls = pd.read_excel('legacy_report.xls', sheet_name=0, engine='xlrd')

# 快速查看表格形状与前 5 行
print("数据维度:", df_xlsx.shape)
print(df_xlsx.head())
2. openpyxl 读取示例:处理公式与流式大文件
当需要保留单元格格式,或 Excel 包含十万行以上导致内存吃紧时,使用 openpyxl 的只读模式:
from openpyxl import load_workbook

# 模式 A:普通模式读取(data_only=True 获取计算结果,False 获取公式本身)
wb = load_workbook('financial_model.xlsx', data_only=True)
sheet = wb['Balance']
cell_val = sheet['B4'].value
print("B4 单元格数值:", cell_val)
wb.close()

# 模式 B:针对超大文件的只读流式模式(read_only=True,极低内存消耗)
wb_stream = load_workbook('massive_log.xlsx', read_only=True)
stream_sheet = wb_stream.active

for row in stream_sheet.iter_rows(values_only=True):
    # 逐行迭代生成器,不把整张表一次性载入内存
    if row[0] is not None:
        pass # 处理单行数据

wb_stream.close()
3. xlrd 读取示例:旧版 .xls 纯只读提取
如果历史系统仅能导出 .xls,且你不想引入 pandas 这么庞大的依赖,可以用原生 xlrd:
import xlrd

# 打开旧版 .xls 工作簿
workbook = xlrd.open_workbook('old_system_export.xls')
sheet = workbook.sheet_by_index(0)

print(f"总行数: {sheet.nrows}, 总列数: {sheet.ncols}")
for row_idx in range(min(5, sheet.nrows)):
    print(sheet.row_values(row_idx))
四、选型决策指南:如何根据实际需求做出选择?
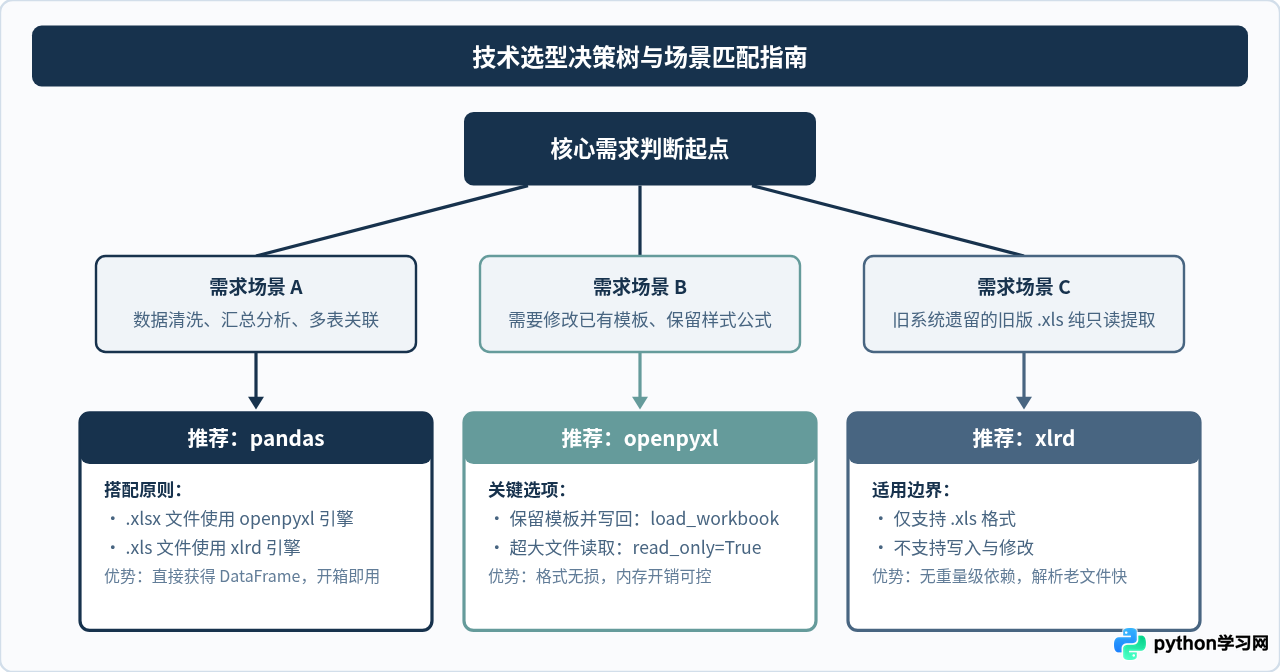
面对具体业务场景,究竟该选哪一个?我们可以根据业务目标绘制出清晰的决策路径:
五、常见避坑事项与排错建议
在日常开发过程中,还有以下几个非常容易让人踩坑的技术细节:
当使用 load_workbook(filename, data_only=True) 读取含公式的表格时,如果返回的值是 None,通常是因为该文件是由第三方脚本或库生成的,尚未被 Microsoft Excel 实际打开并触发过公式重算。Excel 在保存时会把公式结果缓存在 XML 中,data_only=True 读取的是这个缓存值。如果没有缓存,需要先用 Excel 或自动化工具保存计算结果,或者直接用 data_only=False 读取公式表达式本身。
在 Excel 底层中,日期本质上是从 1899-12-30 开始计算的序列天数。使用原生 xlrd 或未设置日期转换时,经常会读取到类似 44927.0 的浮点数。若使用 xlrd,需调用 xlrd.xldate_as_datetime() 转换;而 pandas 和 openpyxl 默认会自动结合单元格数字格式映射为 Python datetime 对象,处理体验更佳。
许多企业内部老系统(如某些 ERP 或银行流水系统)导出的“Excel”文件,后缀虽然写着 .xls,但直接用文本编辑器打开却发现是 HTML 的 <table> 标签或逗号分隔的纯文本。这类伪文件直接传给 xlrd 会报 Unsupported format or corrupt file。遇到这种情况,可先用 pandas.read_html() 或 pandas.read_csv() 快速验证真实格式。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









