

Python divmod()函数与%取余运算符的对比
深入对比Python中divmod()内置函数与%取余运算符的底层运行机制、负数与浮点数处理规则、性能开销及工程实战选型场景。
在 Python 中,% 运算符专门用于求两个数相除后的余数,而内置函数 divmod(a, b) 则同时计算商与余数,并以二元元组 (a // b, a % b) 的形式返回。当只需要获取余数时,% 是最直接且轻量的选择;而在需要同时使用商与余数的计算场景中,divmod() 能有效规避两次除法带来的性能开销并使代码更为简洁。本文将从底层实现、负数与浮点数处理规则、性能开销以及工程场景四个维度对两者展开深度对比。
一、基础语法与返回值对比
% 是 Python 的二元算术运算符,接受两个操作数并返回模运算的单个数值结果。例如表达式 17 % 5 的结果为整数 2。其语法简单直观,适合用于数值的奇偶性判断、周期性循环控制以及散列索引计算等单一余数场景。
# 示例 1:% 取余运算符
remainder = 17 % 5
print("余数:", remainder)  # 输出: 2

# 常见场景:判断奇偶
if remainder % 2 == 0:
    print("偶数")
与 % 不同,divmod() 是一个内置全局函数,其参数与除法相同,返回一个包含两个元素的元组。第一个元素是整除(地板除)结果 a // b,第二个元素是余数 a % b。在实际使用中,通常结合 Python 的序列解包语法直接将商和余数分别赋值给两个变量:
# 示例 2:divmod() 内置函数
quotient, remainder = divmod(17, 5)
print("商:", quotient)     # 输出: 3
print("余数:", remainder)   # 输出: 2
二、底层执行机制与流程差异
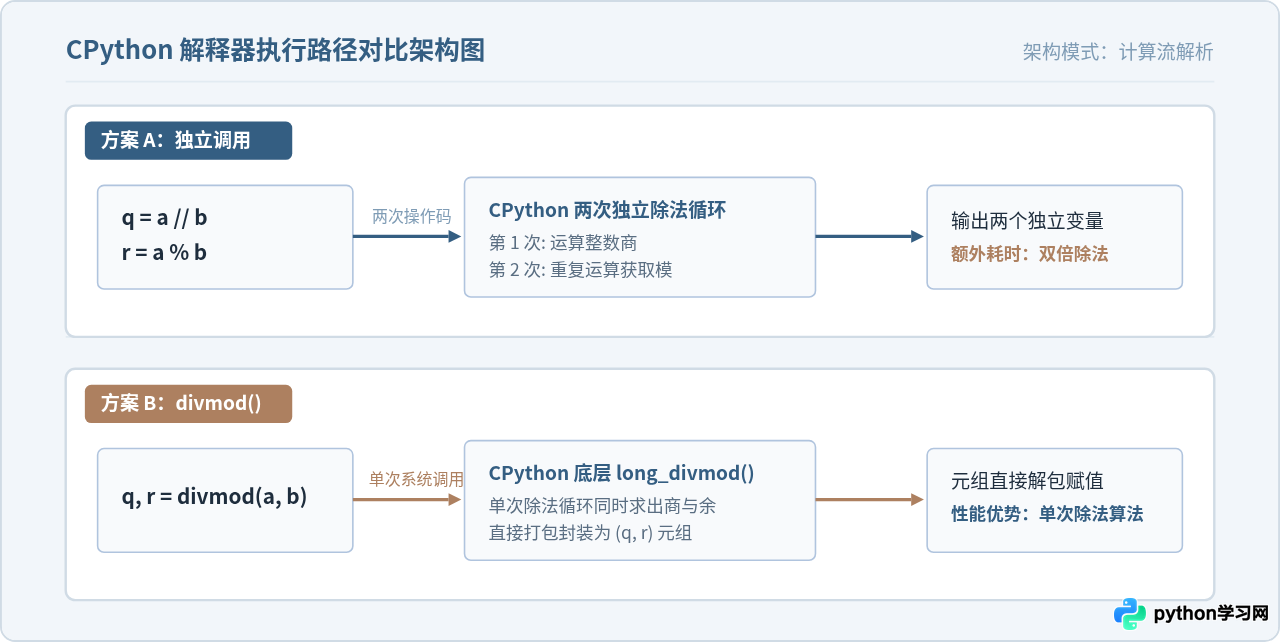
表面上看,divmod(a, b) 只是 (a // b, a % b) 的语法糖,但两者在 CPython 解释器底层的执行机制存在本质差异。在 CPU 和底层 C 语言实现中,除法与取模是一对伴生运算。当分别执行 a // b 和 a % b 时,解释器需要分别发起两个独立的算术操作码(BINARY_FLOOR_DIVIDE 与 BINARY_MODULO),触发两次底层的除法计算流程。
而在执行 divmod(a, b) 时,CPython 内部直接调用底层的 PyNumber_Divmod 接口。对于整数类型,其直接调用 C 语言的整数除法内核(如 long_divmod),在单次运算循环中同时计算出商和余数,并将结果包装为一个只读元组返回,避免了冗余的除法运算。
三、负数与浮点数的处理规则
很多开发者在跨语言编程时,容易在负数取模上犯错。C、C++ 或 Java 等语言采用“向零截断”(truncate toward zero)的整除方式,而在 Python 中,地板除 // 和取模 % 严格遵循数学上的向下取整(floor division)定义。
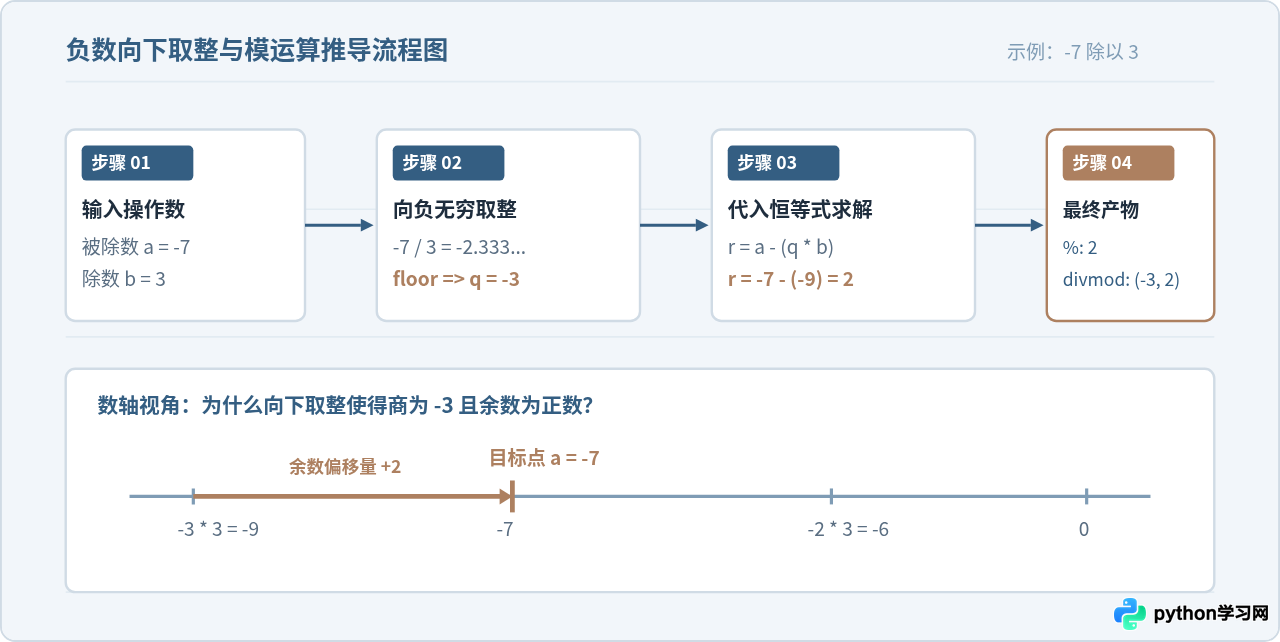
核心恒等式:在 Python 中,对于任意非零数 b,恒满足公式 a = (a // b) * b + (a % b)。这意味着余数的符号永远与除数 b 保持一致(或为 0),而不是由被除数 a 决定。
例如计算 -7 % 3:
- 第一步:
-7 / 3的精确数学结果是-2.3333...。 - 第二步:向下取整
floor(-2.3333...)得到商q = -3。 - 第三步:根据恒等式反推余数
r = -7 - (-3 * 3) = -7 - (-9) = 2。
因此,-7 % 3 的结果是 2,而 divmod(-7, 3) 返回的结果正是 (-3, 2)。同理,当除数为负数时(如 7 % -3),商为 -3,余数为 -2,两者乘积与和依然还原为 7。
浮点数情况下的行为与精度陷阱
% 与 divmod() 均支持浮点数参数。例如 divmod(7.5, 2.5) 返回 (3.0, 0.0)。然而在处理不能用二进制浮点数精确表示的小数时,两者均会受到 IEEE 754 浮点精度的影响:
# 浮点数精度示例
print(divmod(8.0, 0.2))
# 输出结果形如: (39.0, 0.1999999999999993) 而非 (40.0, 0.0)
这是因为 0.2 无法在计算机内部精确表示,实际参与运算的除数略大于 0.2,导致向下取整的商落在了 39.0,余数接近 0.2。若业务场景涉及高精度浮点或金额计算,应使用标准库 decimal.Decimal 或 math.fmod(),而非直接依赖 divmod() 或 %。
四、性能与系统开销对比
在性能敏感的程序中,选型主要取决于需要获取多少个值:
- 单一余数需求:如果只需要余数(例如
if x % 2 == 0),必须选用%运算符。因为%不需要额外的函数调用开销,也不需要创建和销毁元组对象,执行速度明显快于divmod()。 - 同时需要商与余数:如果代码需要同时获取商和余数,使用
divmod(a, b)会明显优于q = a // b; r = a % b。前者将计算合二为一,避免了对大整数做两次重复的除法迭代,同时使代码更为精炼。
五、工程实用场景与操作步骤
理解了两者的差异后,我们来看工程中最具代表性的使用模式。
1. 时间秒数的级联拆分
将以秒为单位的总时长拆分为“小时、分钟、秒”是典型的链式除法场景。此时连续使用两次 divmod() 是最规范、最不易出错的写法:
def format_seconds(total_seconds):
    # 第一步:3600 秒为 1 小时,拆分出小时与剩余秒数
    hours, remainder = divmod(total_seconds, 3600)
    # 第二步:60 秒为 1 分钟,拆分出分钟与最终秒数
    minutes, seconds = divmod(remainder, 60)
    return f"{hours:02d}:{minutes:02d}:{seconds:02d}"

# 验证测试
print(format_seconds(3665))  # 输出: 01:01:05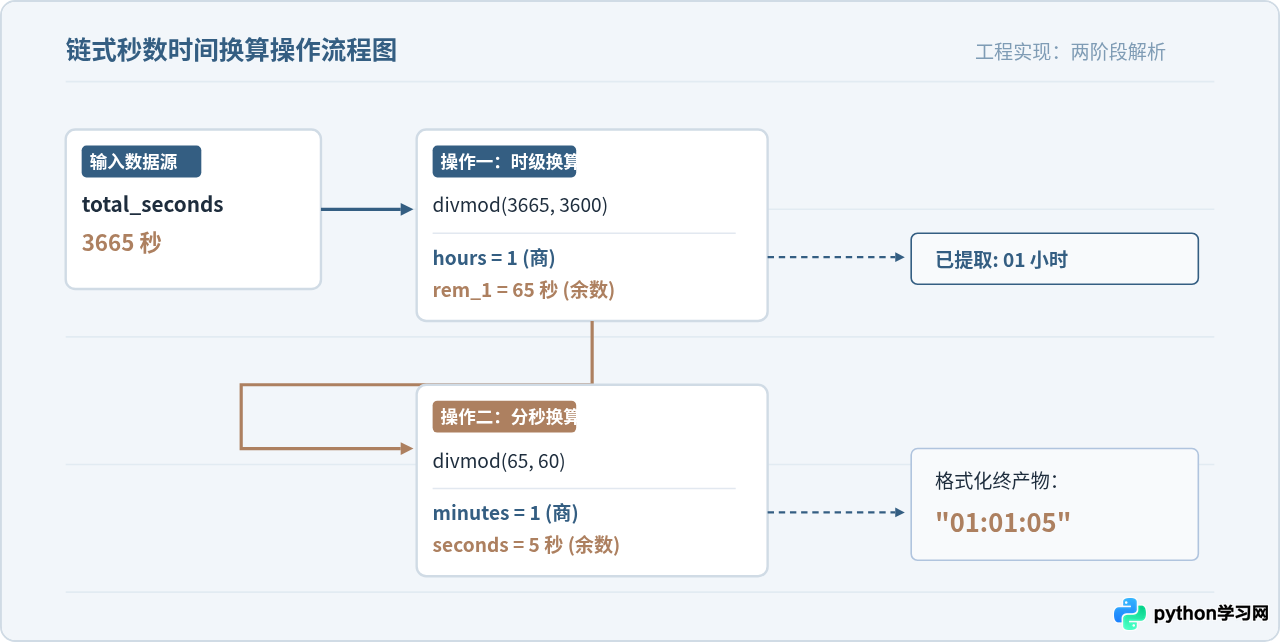
2. 后端分页与总页数推导
Web 开发中常根据“数据总条数 total”与“单页大小 page_size”计算总页数。结合 divmod() 可以极其优雅地完成判定:若余数大于 0 则需要额外增加 1 页:
def calculate_pages(total_items, page_size):
    full_pages, remainder = divmod(total_items, page_size)
    total_pages = full_pages + (1 if remainder > 0 else 0)
    return total_pages

# 示例:105 条数据,每页 10 条
print("总页数:", calculate_pages(105, 10))  # 输出: 11
六、选型指南与决策总结
为了在实际开发中快速作出准确决策,我们将 divmod() 与 % 的各项关键指标汇总如下:
| 对比维度 | % 取余运算符 |
divmod() 内置函数 |
|---|---|---|
| 返回数据类型 | 单个数值(int 或 float) | 包含两个数值的元组 (商, 余数) |
| CPython 底层调用 | 直接执行 BINARY_MODULO 操作码 |
调用 PyNumber_Divmod,底层除法一体化 |
| 对象创建开销 | 无额外元组打包开销 | 产生 1 个二元元组(在需要解包赋值时基本可忽略) |
| 负数处理行为 | 向下取整,符号与除数一致 | 商和余数均严格遵循向下取整与恒等式 |
| 最适应用场景 | 奇偶判定、散列分桶、周期计数等单一模运算 | 单位转换(时分秒/进制)、分页计算、坐标映射 |
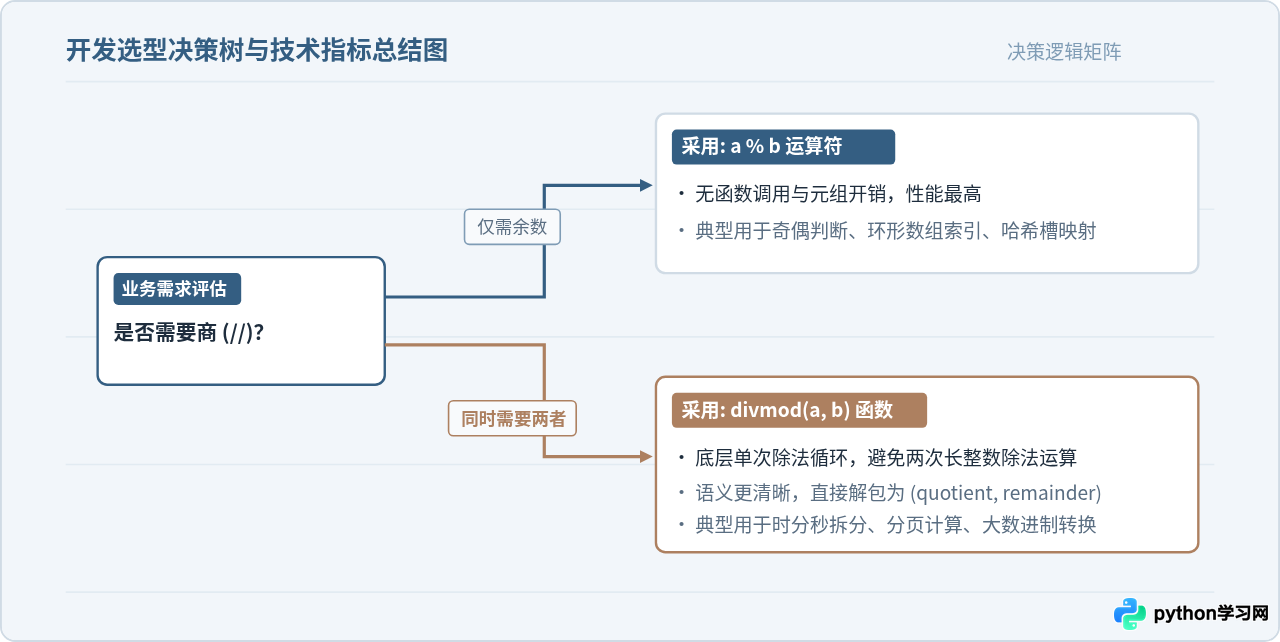
总结来说,% 与 divmod() 并不是互相替代的关系,而是各有侧重的互补工具。编写代码时,优先以“是否同时需要商和余数”为决策基准:若仅需余数,坚决使用 %;若二者兼顾,果断采用 divmod(),从而兼顾执行效率与代码可读性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









