

Python中%代表什么:取模运算与字符串格式化详解

在 Python 编程语言中,百分号 % 是一个双重身份的符号。当它出现在两个数值之间时,它是一个数学算术运算符(取模/求余数);当它紧随在字符串之后时,它则是 Python 经典的 printf 风格字符串格式化运算符。除此之外,在 Jupyter Notebook 或 IPython 交互式环境中,单个或双重 % 还被扩展用作魔法命令(Magic Commands)的前缀。本文将依次剖析取模运算与字符串格式化的底层原理、使用细节及常见误区,帮助读者透彻理解 % 的具体运用。
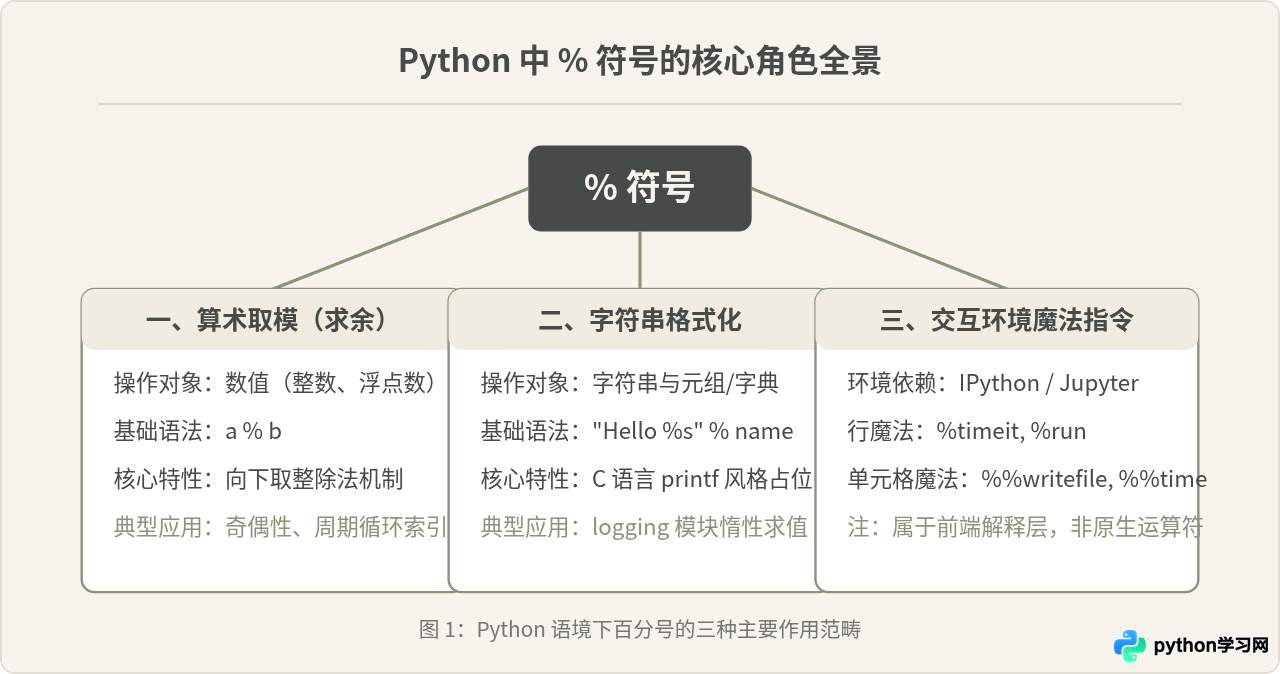
第一部分:作为算术运算符的取模运算(Modulo)
当 % 作为二元运算符放在两个数字之间时,它执行的是取模(Modulo)运算,即返回被除数除以除数后的余数。其基本语法结构为:
remainder = dividend % divisor1. 正整数取模与基础应用
在所有运算数均为正整数的常规情况下,取模的行为直观明了:
print(10 % 3)   # 示例输出:1  (10 = 3 * 3 + 1)
print(14 % 7)   # 示例输出:0  (能整除,余数为 0)
print(4 % 6)    # 示例输出:4  (被除数小于除数,商 0 余 4)
在日常开发中,正整数取模有以下几类常见使用场景:
- 判断奇偶性:任何整数与 2 取模,若
n % 2 == 0则为偶数,若n % 2 == 1则为奇数。 - 周期性与循环轮转:在固定长度的列表或轮播序列中,通过
index = (index + 1) % length可以实现无缝回环。 - 单位换算:例如将秒数拆解为分钟与剩余秒数:
minutes = total_seconds // 60,seconds = total_seconds % 60。
2. 核心数学机制:Python 的向下取整规则
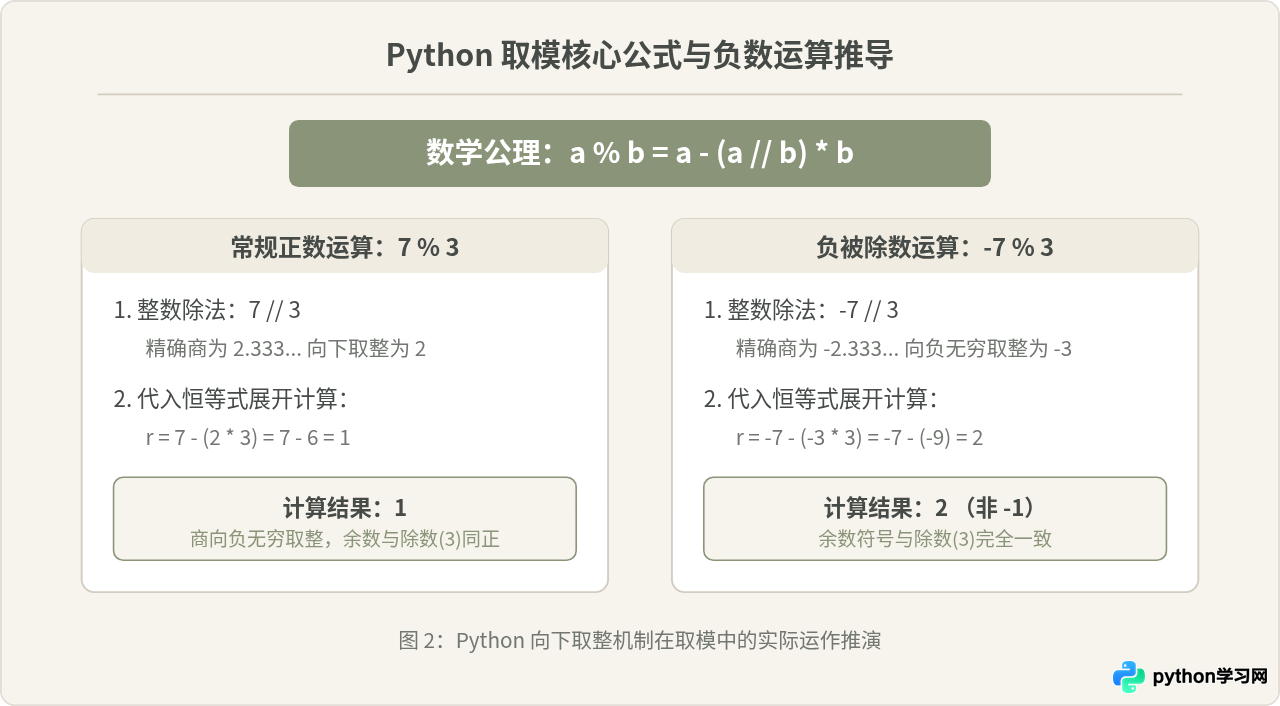
许多初学者或从 C、C++、Java 转入 Python 的开发者,在遇到负数取模时常常会对计算结果感到意外。例如在 C 语言中 -7 % 3 的结果是 -1,但在 Python 中,运行结果却是 2。
这并非 Python 的 bug,而是底层整数除法策略的选择差异。在 Python 中,取模运算严格遵循以下数学恒等式:
a % b = a - (a // b) * b其中,双斜杠 // 是向下取整除法(Floor Division),它不是简单截断小数部分,而是始终向数轴的负无穷方向取整:
- 计算
-7 // 3:真实商约为-2.3333。向负无穷方向取整得到-3。 - 代入恒等式求模:
-7 - (-3 * 3) = -7 - (-9) = 2。 - 计算
7 % -3:商7 // -3 = -3。代入得到7 - (-3 * -3) = 7 - 9 = -2。
由此得出一个关键推论:在 Python 中,非零余数 a % b 的正负符号,始终与除数 b 的符号保持一致。
进阶工具提示:如果你需要同时获取商和余数,可以直接使用内置函数 divmod(a, b),它内部返回一个二元组 (a // b, a % b),在处理时钟计算或分页算法时执行效率更高且表达更简洁。
第二部分:作为字符串格式化运算符(Printf-style)
当 % 左侧是一个包含转换说明符(占位符)的字符串时,% 扮演的是字符串格式化运算符。这一语法直接借鉴自 C 语言的 printf 函数家族。
1. 基本使用结构
如果字符串中只有一个占位符,右侧可以直接传入单个值;如果有多个占位符,右侧必须是一个元组(Tuple),或者是包含对应键名的字典(Dictionary):
# 1. 单值格式化
name = "张三"
print("你好,%s!" % name)
# 示例输出:你好,张三!

# 2. 多值元组传参(必须使用小括号包裹)
age = 25
score = 88.5
print("姓名:%s,年龄:%d 岁,得分:%f" % (name, age, score))
# 示例输出:姓名:张三,年龄:25 岁,得分:88.500000

# 3. 字典命名参数映射(更易读)
user_info = {"user": "李四", "status": "在线"}
print("当前用户:%(user)s,状态:%(status)s" % user_info)
# 示例输出:当前用户:李四,状态:在线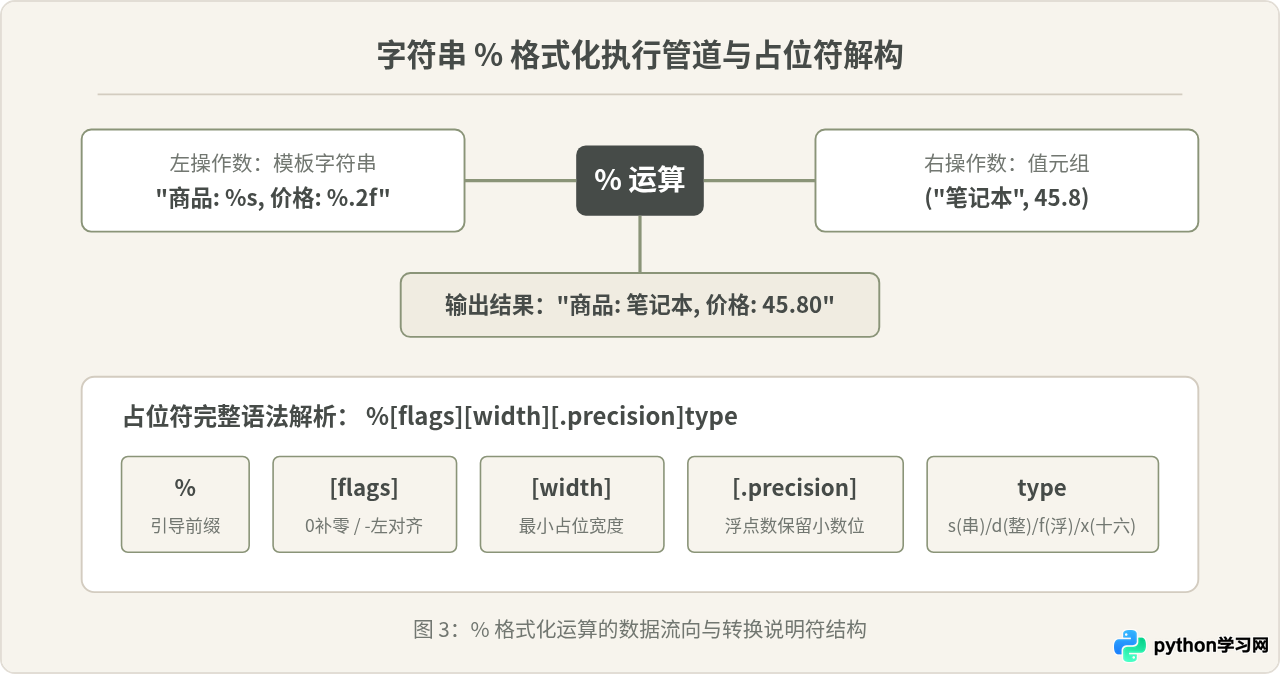
2. 常见类型说明符与修饰规则
| 说明符 | 含义与转换规则 | 示例用法 | 格式化输出 |
|---|---|---|---|
%s |
字符串(调用 str() 转换任意对象) |
"项目:%s" % "Ku-AiFram" |
项目:Ku-AiFram |
%d 或 %i |
有符号十进制整数 | "数量:%d" % 42 |
数量:42 |
%f |
十进制浮点数(默认保留 6 位小数) | "数值:%f" % 3.14 |
数值:3.140000 |
%.2f |
限制浮点数保留 2 位小数(带四舍五入) | "价格:%.2f 元" % 19.998 |
价格:20.00 元 |
%04d |
宽度至少 4 位,高位补 0 | "编号:%04d" % 7 |
编号:0007 |
%x / %X |
小写/大写十六进制整数 | "色值:%02X" % 255 |
色值:FF |
%% |
转义字符,输出一个纯百分号本身 | "增长率:%d%%" % 15 |
增长率:15% |
3. 初学者易踩陷阱:TypeError 常见报错分析
在使用 % 进行字符串格式化时,有两个极高频出现的错误:
- 误漏包裹元组:如果模板中有 2 个或更多占位符,右侧直接传逗号表达式而缺少外层括号,会导致语法混乱:
# 错误示例: # "A: %s, B: %s" % "x", "y" # 报 TypeError: not enough arguments for format string # 正确写法: "A: %s, B: %s" % ("x", "y") - 单变量恰好为元组:如果占位符只有一个
%s,但你想把一个元组作为整体传入,必须嵌套一层单元素元组,否则 Python 会尝试将元组元素解包匹配占位符,从而报TypeError: not all arguments converted during string formatting:point = (10, 20) # 错误写法:print("坐标为:%s" % point) -> 试图把 10 传给 %s,20 无法匹配 # 正确写法:print("坐标为:%s" % (point,))
第三部分:演进与选型——现代 Python 中还应该用 % 格式化吗?
自 Python 2.6 引入 str.format() 以及 Python 3.6 引入 f-string(格式化字符串字面量) 以来,Python 社区针对字符串插值给出了更现代化、更直观的方案。
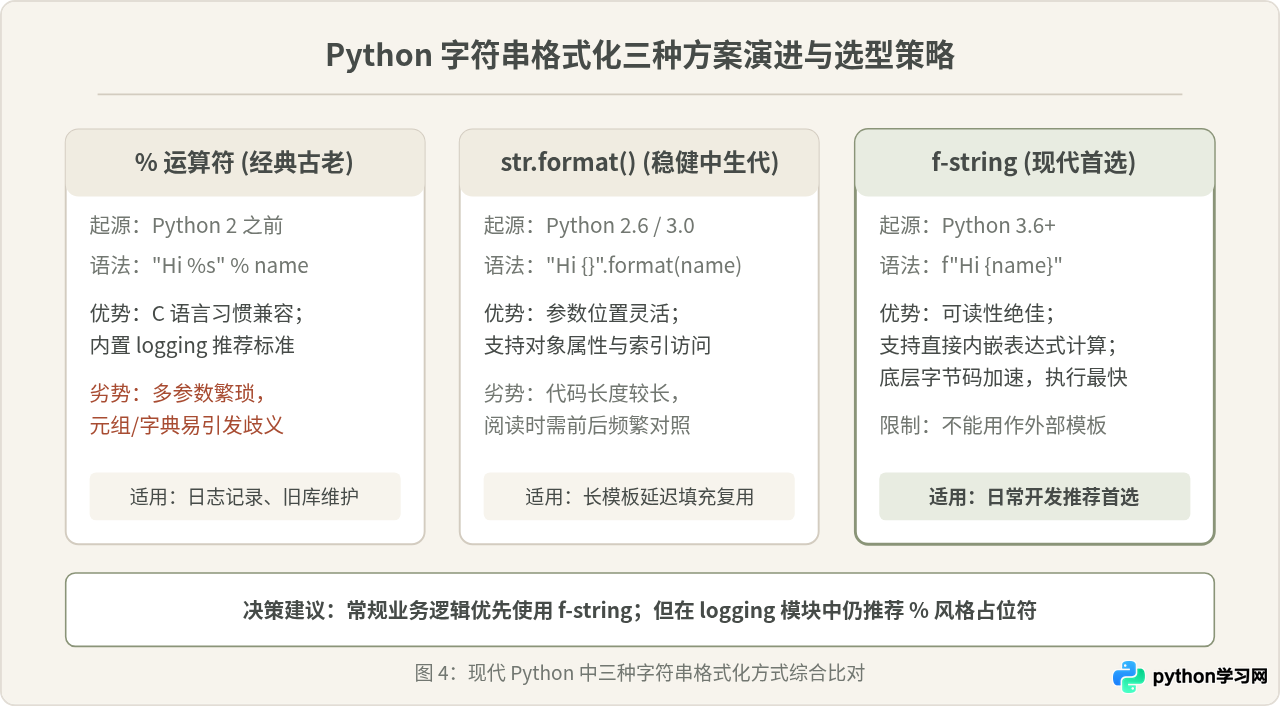
核心特例:为什么 logging 模块依然坚持使用 % 占位符?
虽然现代 Python 项目在大多数代码中都推荐使用 f-string,但在标准库 logging 模块中,官方依然强烈建议使用 % 风格的传参方式:
import logging

# 推荐写法(惰性求值 / Lazy Evaluation):
logging.info("接收到来自用户 %s 的请求,耗时: %.2f 秒", user_id, elapsed_time)

# 不推荐写法(即使当前日志级别不输出,字符串拼接依然提前发生,造成性能浪费):
logging.info(f"接收到来自用户 {user_id} 的请求,耗时: {elapsed_time:.2f} 秒")
原因是 logging.info(msg, *args) 内部使用了延迟格式化机制:如果日志级别低于当前激活的阈值(例如在生产环境中 DEBUG 日志被过滤),Python 不会真正执行格式化运算,从而避免了高并发场景下无效的字符串插值开销。
总结与快速查阅表
遇到 Python 中的 % 时,可以按照以下路径进行快速判定与处理:
- 看左右操作数类型:两端是数字,则是取模运算;左端是带有
%s/%d/%f等占位符的字符串,则是字符串格式化。 - 做负数除法/取模时:牢记
a % b = a - (a // b) * b,Python 始终向负无穷向下取整,余数符号随除数。 - 写日常业务格式化时:在 Python 3.6 及更新版本中优先使用
f"{var}";在编写日志打印或对接老旧代码库时,熟练运用%占位符。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









