

Python使用NumPy接收矩阵输入的方法
全面讲解Python中使用NumPy接收和构建矩阵输入的实用方法,涵盖交互式逐行录入、单行批量解析、sys.stdin流式读取及格式校验,配有完整代码与原理解析。
NumPy 是专注于高效数值运算的底层科学计算库,其核心对象 np.ndarray 要求底层数据在内存中具有连续或规则的步长分布。NumPy 本身并未封装针对终端控制台交互式读取的专属函数,因此“接收矩阵输入”的实质是将 Python 标准 I/O 捕获的文本字符流,经过清洗、数值切分与类型转换,重构为符合预期维度 (Rows, Columns) 的二维数组。
一、矩阵输入的核心流水线与底层逻辑
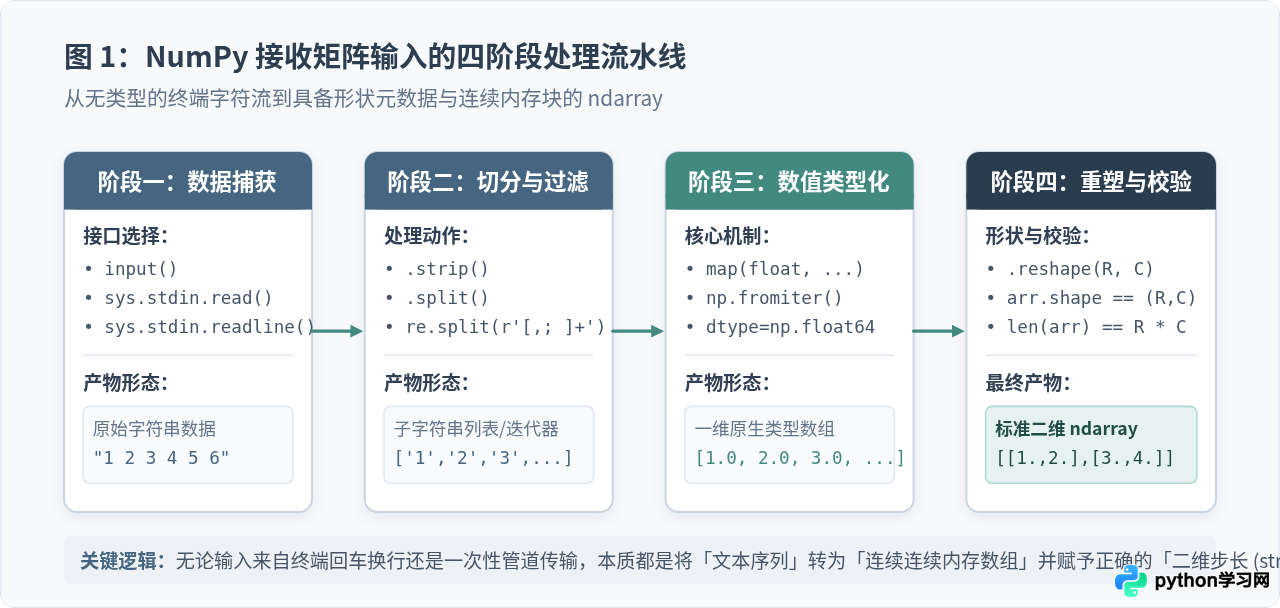
无论是面对算法题的输入规范,还是工程脚本中的交互式参数输入,接收矩阵输入都可以拆解为四个关键阶段:
- 文本流捕获(I/O 获取):通过
input()逐行阻塞读取,或使用sys.stdin.read()一次性读取全量字符流。 - 空白字符切分(Tokenizing):依据空格、换行或制表符切分出独立的数值字符串。
- 数值类型化(Type Casting):将字符串映射为 Python 的
int/float,或直接装载入 NumPy 预设的连续存储区(如np.float64)。 - 维度重塑与校验(Reshaping & Validating):将一维扁平序列通过
.reshape(r, c)或嵌套列表构造赋值矩阵的二维形状元数据,并校验元素个数是否匹配。
二、交互式控制台录入:已知行列数的标准方案
在大多数教学与常规脚本场景中,用户在控制台中首先输入矩阵的行数 $R$ 与列数 $C$,随后按行输入对应行的数据。针对这种场景,有两种最为常见的写法。
方法 1:逐行循环读取与列表推导法
该方法符合人类书写矩阵的直觉习惯:外层循环遍历每一行,内层通过 input().split() 获取当前行的数字字符串列表,并通过 map() 转换为数值。
import numpy as np

# 1. 接收矩阵的行数与列数
rows = int(input("请输入矩阵行数: "))
cols = int(input("请输入矩阵列数: "))

print(f"请逐行输入矩阵元素,每行 {cols} 个数值(空格分隔):")
matrix_data = []
for i in range(rows):
    row_values = list(map(float, input().strip().split()))
    if len(row_values) != cols:
        raise ValueError(f"第 {i+1} 行列数不匹配:预期 {cols} 个,实际获得 {len(row_values)} 个")
    matrix_data.append(row_values)

# 2. 转换为 NumPy 二维数组
matrix = np.array(matrix_data, dtype=np.float64)

print("成功接收矩阵,形状为:", matrix.shape)
print("矩阵内容:
", matrix)请输入矩阵列数: 3
请逐行输入矩阵元素,每行 3 个数值(空格分隔):
1 2 3
4 5 6
7 8 9
成功接收矩阵,形状为: (3, 3)
矩阵内容:
[[1. 2. 3.]
[4. 5. 6.]
[7. 8. 9.]]
代码解析:此方法中通过 len(row_values) != cols 在每一行录入时进行即时校验,能最快捕获输入错漏。使用列表推导式可将代码精简为单行:matrix = np.array([list(map(float, input().split())) for _ in range(rows)])。
方法 2:全量数值平铺输入与 reshape 变换法
当输入格式不严格限制换行位置(例如所有数值写在同一行,或混杂着换行与多余空格)时,将所有数值先视为扁平序列录入,最后通过 reshape(rows, cols) 还原矩阵形态更加稳健。
import numpy as np

r = int(input("请输入行数 R: "))
c = int(input("请输入列数 C: "))

# 一次性读入所有元素
raw_elements = input(f"请输入全部 {r * c} 个元素(空格分隔):").strip().split()

if len(raw_elements) != r * c:
    raise ValueError(f"元素总数错误:预期 {r * c} 个,实际接收到 {len(raw_elements)} 个")

# 构造一维数组后重塑为 (r, c)
matrix = np.array(raw_elements, dtype=np.float64).reshape(r, c)

print("重塑后的矩阵:
", matrix)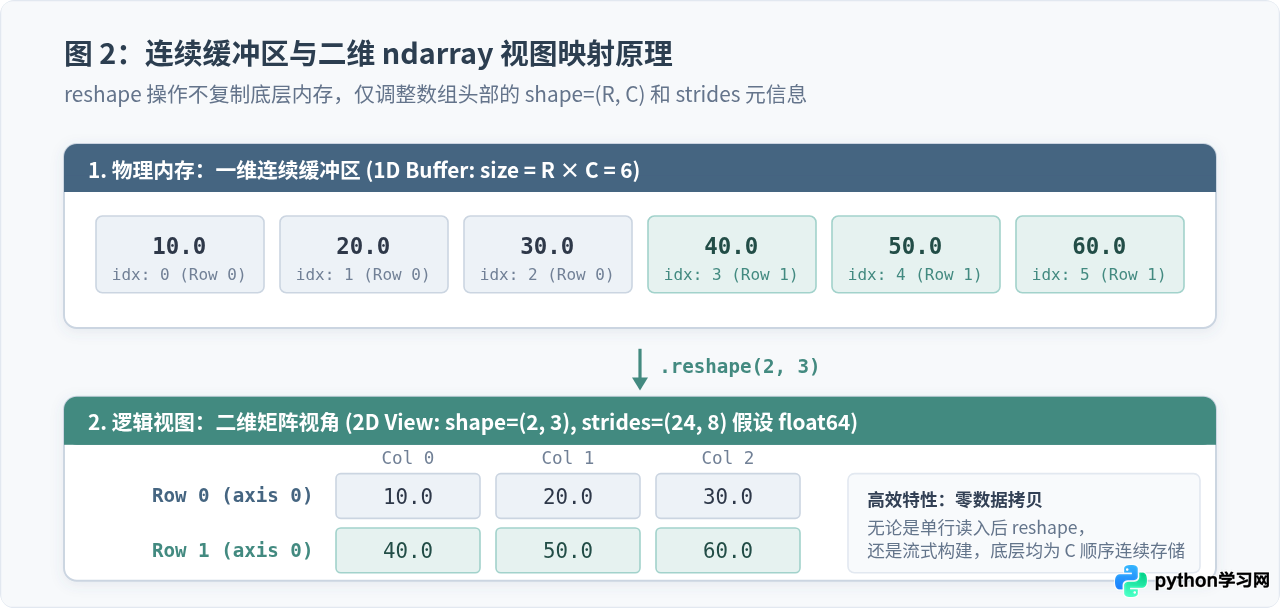
原理细节:NumPy 的 reshape 操作是零拷贝(Zero-copy)的视图调整:它并不在物理内存中移动数据,而是创建了一个新的数组头部,仅将 shape 修改为 (r, c),并计算对应的 strides。对于包含大量数字的矩阵,单次平铺分配效率显著优于维护多层 Python 动态列表。
三、高性能批量读取:sys.stdin 与流式解析
在算法竞赛、OJ 评测或大数据批处理场景中,数据通常通过管道(如 cat data.txt | python script.py)重定向至标准输入。此时多次调用 input() 会带来显著的函数调用开销与 I/O 阻塞。
使用 sys.stdin.read() 应对海量数据
import sys
import numpy as np

def read_matrix_from_stdin():
    # 一次性读取标准输入的全部剩余内容
    input_text = sys.stdin.read().strip()
    if not input_text:
        return np.empty((0, 0))

    tokens = input_text.split()

    # 假设前两项为矩阵的行数与列数
    rows = int(tokens[0])
    cols = int(tokens[1])

    # 截取后续的数据部分
    data_tokens = tokens[2 : 2 + rows * cols]

    if len(data_tokens) < rows * cols:
        raise ValueError("输入数据不足,无法构成完整矩阵")

    matrix = np.array(data_tokens, dtype=np.float64).reshape(rows, cols)
    return matrix
借助 np.fromiter 进一步减少内存峰值
当需要解析超大型矩阵时,tokens = input_text.split() 会先在内存中生成包含数百万个子字符串的中间列表。改用生成器配合 np.fromiter,可以一边读取字符串迭代器一边直接填充 C 原生数组内存,从而显著节省内存:
import sys
import numpy as np

# 采用迭代器方式逐项转换为浮点数,直接喂入 NumPy 预分配的缓冲区
def fast_matrix_stream(rows, cols):
    total_elements = rows * cols
    tokens_iter = (float(tok) for tok in sys.stdin.read().split())
    # count 参数极为关键:告知 NumPy 预分配精确容量,避免动态扩容拷贝
    arr = np.fromiter(tokens_iter, dtype=np.float64, count=total_elements)
    return arr.reshape(rows, cols)
四、非标准结构化文本矩阵的解析
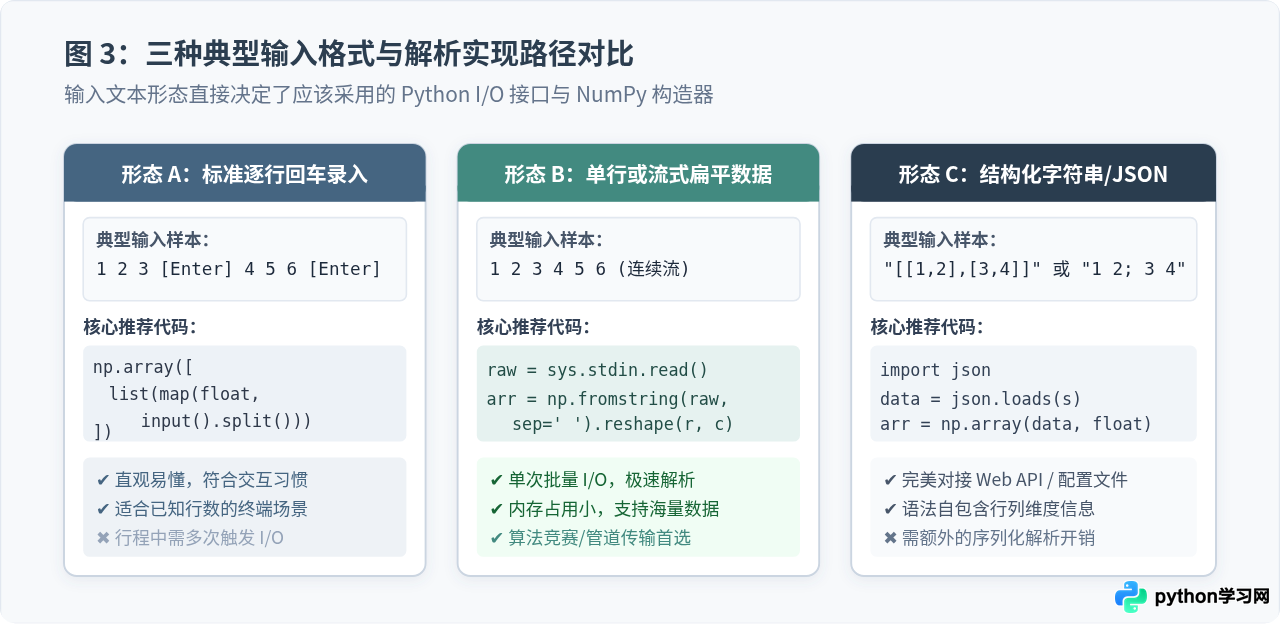
在实际工程或跨语言协同中,输入的矩阵文本往往不是单纯的空格数字,而是带有特定语法结构的字符串。
1. 类 MATLAB 分号分隔语法
某些控制台工具允许用户以 1 2 3; 4 5 6; 7 8 9 形式输入矩阵(分号代表换行)。早期 NumPy 提供了 np.matrix('1 2; 3 4'),但该类目前已被官方建议弃用,应统一使用标准的 np.array 解析方式:
import numpy as np

matlab_str = "1 2 3; 4 5 6; 7 8 9"

# 以分号切分各行,再以空格切分各列元素
matrix = np.array([
    [float(x) for x in row.strip().split()]
    for row in matlab_str.split(';') if row.strip()
])

print("解析分号格式矩阵:
", matrix)
2. JSON 格式与嵌套列表字面量
当矩阵以 [[1, 2], [3, 4]] 的 JSON 字符串传入时,切忌使用存在代码注入风险的 eval(),推荐使用标准库 json.loads() 或 ast.literal_eval():
import json
import numpy as np

json_str = '[[1.5, 2.0, 3.2], [4.1, 5.0, 6.8]]'

parsed_list = json.loads(json_str)
matrix = np.array(parsed_list, dtype=np.float64)

print("JSON 反序列化矩阵形状:", matrix.shape)
五、常见错误与防御性校验
在处理外部输入时,异常情况频发。编写健壮代码需针对以下三类典型问题加入校验机制:
若某一行输入的元素数量与其他行不同(例如第 1 行 3 个数字,第 2 行只有 2 个数字),直接执行
np.array(list_of_lists) 在旧版本 NumPy 中会退化为低效的 object 类型数组,而在 NumPy 1.20+ 及后续版本中会直接抛出 ValueError: setting an array element with a sequence。必须在构造前确保各行长度严格一致。
arr.reshape(r, c) 严格要求一维数组的长度必须完全等于 $r \times c$。若用户多输或少输了一个数值,会抛出 ValueError: cannot reshape array of size X into shape (r,c)。在 reshape 之前检查 len(tokens) == r * c 是必要的防护手段。
下面给出一个集成了类型验证、维度预检与友好提示的完整封装函数:
import numpy as np

def safe_input_matrix():
    """安全接收控制台矩阵输入,包含完备的异常处理"""
    try:
        r = int(input("矩阵行数: ").strip())
        c = int(input("矩阵列数: ").strip())
        if r <= 0 or c <= 0:
            raise ValueError("矩阵行列数必须均为正整数")
    except ValueError as e:
        print(f"输入格式错误: {e}")
        return None

    rows_data = []
    for i in range(r):
        while True:
            raw_row = input(f"输入第 {i+1}/{r} 行 ({c}个数字,空格隔开): ").strip()
            parts = raw_row.split()
            if len(parts) != c:
                print(f"警告:该行需要 {c} 个元素,您输入了 {len(parts)} 个,请重新输入本行!")
                continue
            try:
                numeric_row = [float(x) for x in parts]
                rows_data.append(numeric_row)
                break
            except ValueError:
                print("错误:行内包含无法解析为数字的字符,请重新输入本行!")

    return np.array(rows_data, dtype=np.float64)
六、方法选型指南与总结
不同应用场景下接收矩阵输入的方案选型可参考下表及决策流程图:
| 输入场景 | 首选推荐方案 | 内存与时间表现 | 主要优势与适用条件 |
|---|---|---|---|
| 常规控制台人机交互 | 逐行循环 + map(float, input().split()) |
中等(有中间小列表) | 每行独立输入,可实时给出校验与重试提示 |
| 单行平铺格式输入 | input().split() + .reshape(r, c) |
良好(连续内存重塑) | 书写紧凑,容忍数字间任意多余空白符 |
| 算法竞赛 / 管道重定向 | sys.stdin.read().split() + reshape |
极高(单次系统调用完成I/O) | 解决海量数据下的 I/O 阻塞超时问题 |
| 大规模海量流数据 | 生成器 + np.fromiter(..., count=N) |
最优(零多余大列表内存开销) | 避免在 Python 堆中存放几百万个字符串对象 |
| Web API / 配置文件 | json.loads() / io.StringIO |
标准开销 | 标准化协议支持,天生保证维度与数据边界 |
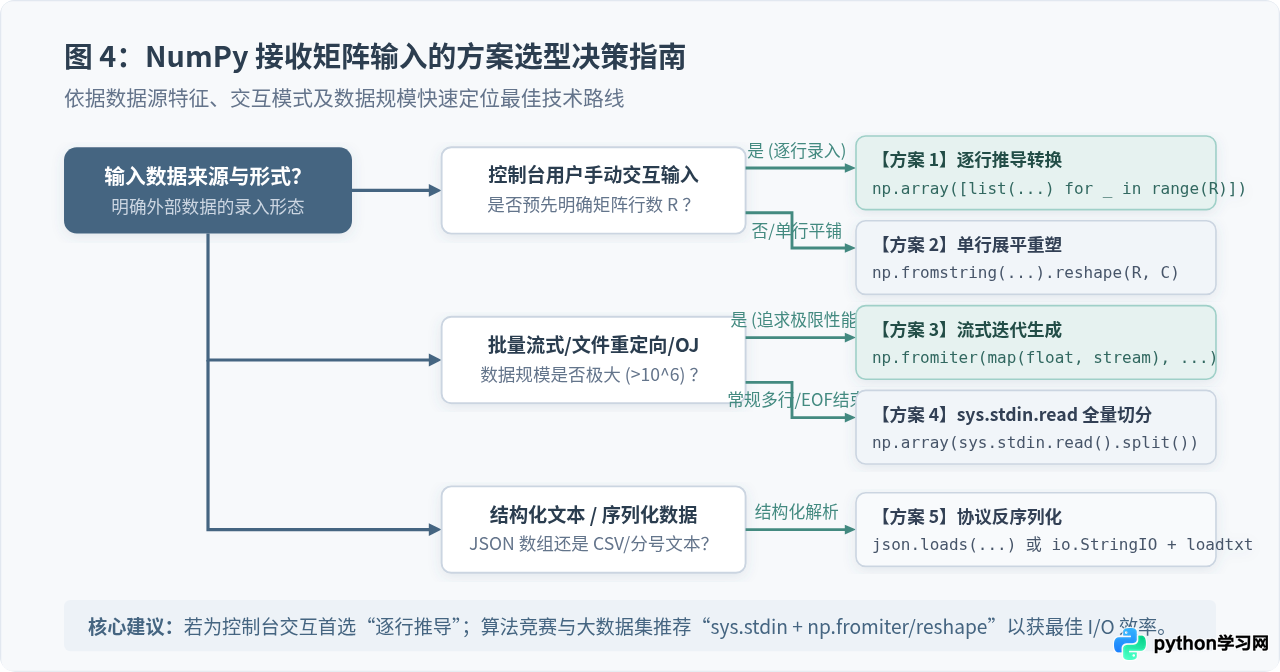
总结而言,在 Python 中使用 NumPy 接收矩阵输入时,核心抓手在于厘清输入数据流来源与目标矩阵形状约束。小型交互场景侧重友好的行列长度提示,规模数据与流式管道场景则侧重最小化 I/O 次数并结合 NumPy 的 reshape 及 np.fromiter 释放 C 语言级别的内存装载性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









