

Python数据分析能做什么?金融、电商等典型应用场景介绍
深入解析Python数据分析的核心能力与工程化落地路径,围绕金融风控评级、量化资产风险度量、电商RFM用户分群、漏斗转化与同期群留存等典型场景,提供详实的实现步骤与实战方法。
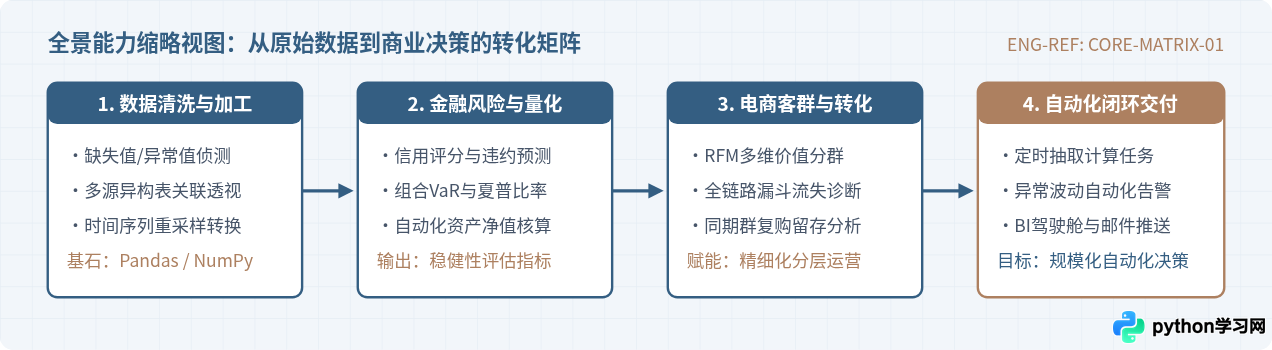
一、Python数据分析的基础工程能力全景
在企业业务生产中,数据分析并不仅仅是绘制几张图表,而是一套可重现的数据工程闭环。传统电子表格处理数十万行订单明细或交易流水时,极易发生卡顿、公式错位或逻辑丢失。Python通过严谨的代码逻辑,将数据处理转化为具备确定性的自动化处理流水线。
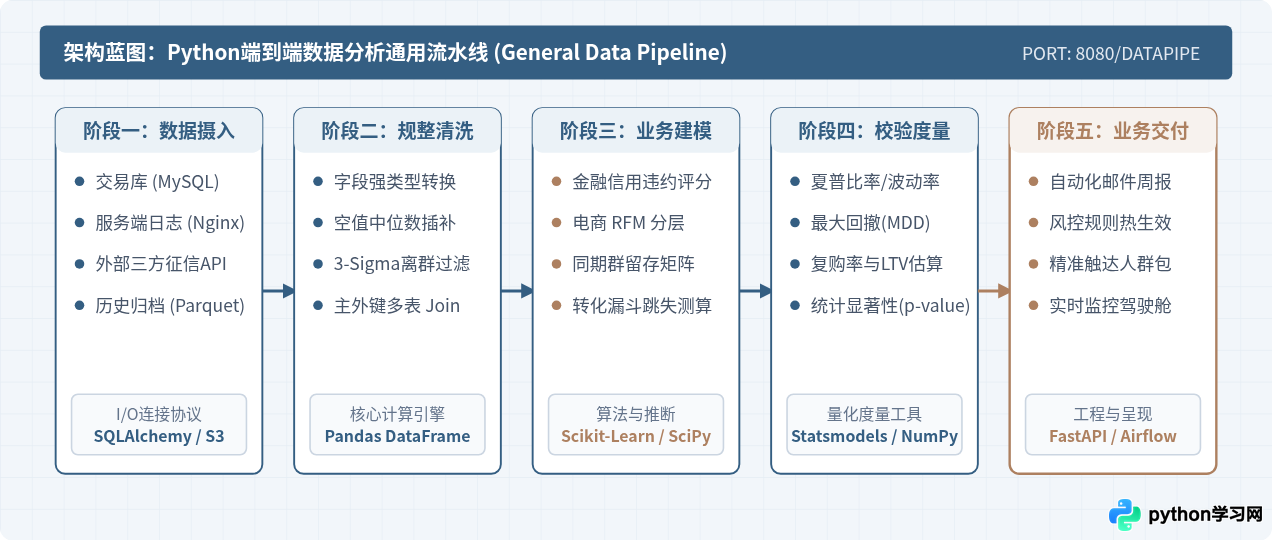
具体而言,Python数据分析的基础工作流涵盖五个关键阶段:
- 多源数据提取与加载:通过
pandas.read_sql、read_csv或 RESTful API,从关系型数据库(MySQL/PostgreSQL)、日志服务器或对象存储中批量抽取原始数据。 - 数据清洗与规整:标准化字段类型,自动化处理空值(NaN)、清洗格式混乱的电话与地址,并剔除离群异常值。
- 探索性统计分析(EDA):运用描述性统计指标(分位数、均值、偏度)透视分布规律,发现变量间的相关性。
- 特征工程与模型推断:对高维类别变量进行编码,计算业务衍生指标(如最近一次行为间隔、累计消费频次),输入统计模型进行分类或回归。
- 结果导出与调度交付:生成格式完备的数据看板、将运算结果落库或通过企业协作机器人自动触发预警。
二、金融领域的核心应用场景
在金融行业,数据分析的首要目标是量化不确定性,在控制风险底线的前提下实现收益最大化。Python在信贷风控、量化投资以及财务审计等场景中扮演着关键角色。
1. 信贷风控与违约评分卡系统
信贷业务的核心是评估借款人的违约概率(Probability of Default, PD)。传统人工审核耗时且标准不一,而通过Python构建自动化风控评分卡,能够从历史多维借贷记录中提炼出强判别特征。
- 数据分箱与WOE转换:对连续变量(如年龄、月收入、负债比)进行分箱,计算分箱内的证据权重(Weight of Evidence, WOE)与信息价值(Information Value, IV),剔除弱预测性字段。
- 逻辑回归与卡方检验:利用
scikit-learn训练带正则化的逻辑回归模型,将回归系数线性映射为300到850分的标准化信用评分。 - 坏账拦截与阈值决策:设定硬性截断线(Cut-off Point),对于低于特定分值的申请自动拒绝,边缘分值转入人工复审,大幅压缩信贷坏账率。
2. 量化资产组合分析与风险度量
在资产管理场景中,Python被广泛用于量化评估投资组合的表现。通过对各资产历史收益率序列的协方差矩阵进行统计推断,分析师能够实时监测组合的波动与风险暴露。
以下是使用Python计算资产组合年化收益率、年化波动率、夏普比率(Sharpe Ratio)及历史模拟法在险价值(Value at Risk, VaR)的核心计算示例:
import numpy as np
import pandas as pd

# 示例:假设 portfolio_returns 为包含单日资产组合收益率的 Pandas Series
def evaluate_portfolio_risk(daily_returns: pd.Series, risk_free_rate: float = 0.025):
    """
    计算投资组合的核心风险与收益指标
    """
    trading_days = 252  # 每年标准化交易日

    # 1. 年化收益率与年化波动率
    compounded_return = (1 + daily_returns).prod() ** (trading_days / len(daily_returns)) - 1
    annual_volatility = daily_returns.std() * np.sqrt(trading_days)

    # 2. 夏普比率 (Sharpe Ratio)
    sharpe_ratio = (compounded_return - risk_free_rate) / annual_volatility

    # 3. 最大回撤 (Maximum Drawdown)
    cumulative_returns = (1 + daily_returns).cumprod()
    peak = cumulative_returns.cummax()
    drawdown = (cumulative_returns - peak) / peak
    max_drawdown = drawdown.min()

    # 4. 历史模拟法 95% 置信度下的单日 VaR
    var_95 = np.percentile(daily_returns, 5)

    return {
        "年化复合收益率": f"{compounded_return * 100:.2f}%",
        "年化波动率": f"{annual_volatility * 100:.2f}%",
        "夏普比率": round(sharpe_ratio, 2),
        "最大回撤": f"{max_drawdown * 100:.2f}%",
        "单日95% VaR": f"{var_95 * 100:.2f}%"
    }

# 示例输出参考(具体数值取决于输入序列)
# {'年化复合收益率': '14.20%', '年化波动率': '18.50%', '夏普比率': 0.63, '最大回撤': '-12.40%', '单日95% VaR': '-1.85%'}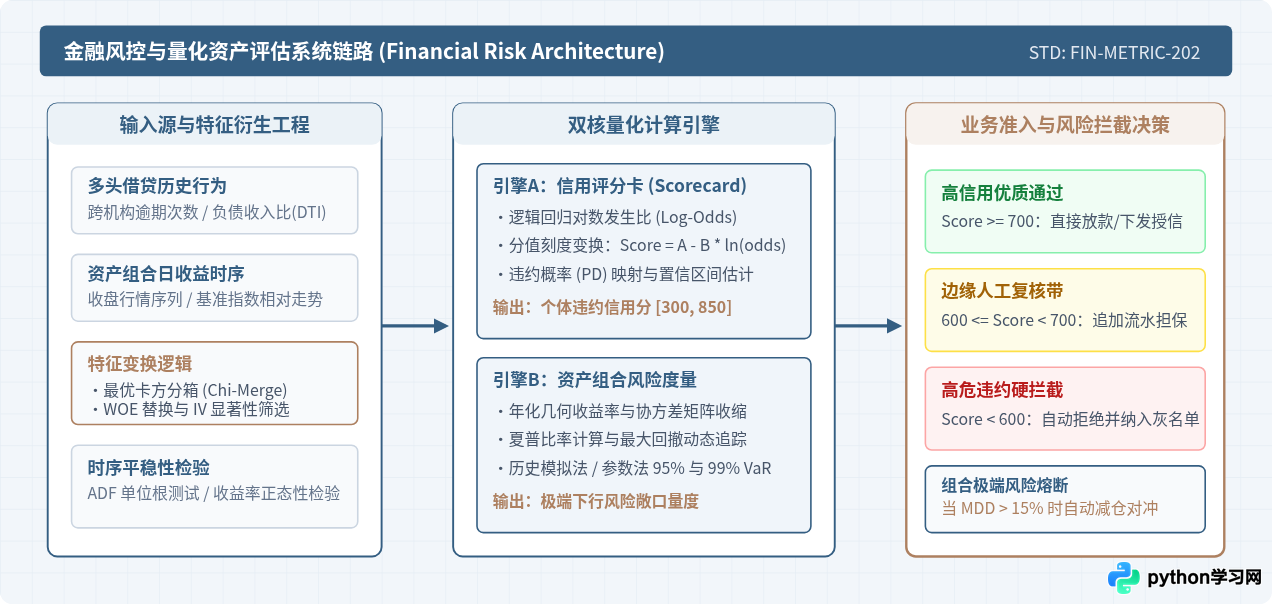
三、电商领域的典型应用场景
电商平台每天产生数以亿计的访问轨迹、加购记录与成交账单。Python数据分析能够把“货、场、人”全链路数据串联起来,解决用户精细化运营、转化瓶颈定位与供应链库存优化等痛点。
1. RFM客户价值模型与分层运营
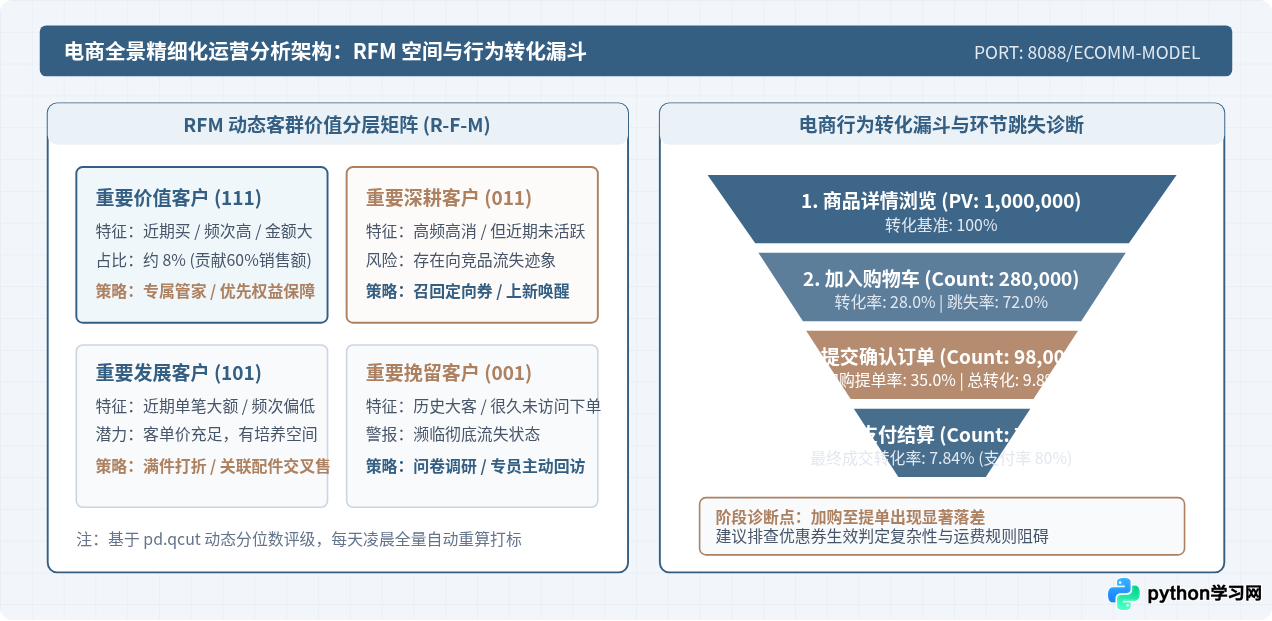
不是所有用户的商业价值都相同。通过分析用户的最近一次消费时间(Recency)、消费频次(Frequency)与消费金额(Monetary),可建立经典的RFM模型。Python利用分位数统计(Quantile)或K-Means聚类,将海量用户自动打标为8类核心客群:
- 高价值重要价值客户(R高F高M高):最近买过、买得频繁且金额大。运营策略应提供专属VIP权益与优先售后保障。
- 重要深耕客户(R低F高M高):忠诚度高但近期未下单,存在流失倾向。应推送个性化定向券进行精准召回。
- 重要挽留客户(R低F低M高):历史消费金额巨大但频次低且长期未访问。需进行重点回访与流失原因排查。
- 一般低价值客户(R低F低M低):仅在促销低价时产生偶发购买。避免过度投放昂贵的定向运营资源。
在Python中实现RFM分层打分的核心代码逻辑如下:
# 假定 df 包含 columns: ['user_id', 'order_date', 'order_amount']
# reference_date 为分析基准日(如最新日期的次日)
rfm_df = df.groupby('user_id').agg({
    'order_date': lambda x: (reference_date - x.max()).days, # Recency 距离天数
    'user_id': 'count',                                      # Frequency 订单数
    'order_amount': 'sum'                                    # Monetary 累计消费
}).rename(columns={'order_date': 'R', 'user_id': 'F', 'order_amount': 'M'})

# 利用分位数进行1-4分评分(R越小分越高;F与M越大分越高)
rfm_df['R_Score'] = pd.qcut(rfm_df['R'], 4, labels=[4, 3, 2, 1])
rfm_df['F_Score'] = pd.qcut(rfm_df['F'].rank(method='first'), 4, labels=[1, 2, 3, 4])
rfm_df['M_Score'] = pd.qcut(rfm_df['M'], 4, labels=[1, 2, 3, 4])

# 将各维度分值与均值比较,映射至8类目标客群
r_mean = rfm_df['R_Score'].astype(int).mean()
f_mean = rfm_df['F_Score'].astype(int).mean()
m_mean = rfm_df['M_Score'].astype(int).mean()

def segment_customer(row):
    r = "1" if row['R_Score'] >= r_mean else "0"
    f = "1" if row['F_Score'] >= f_mean else "0"
    m = "1" if row['M_Score'] >= m_mean else "0"
    mapping = {
        "111": "重要价值客户", "011": "重要深耕客户",
        "101": "重要发展客户", "001": "重要挽留客户",
        "110": "一般价值客户", "010": "一般维持客户",
        "100": "一般发展客户", "000": "一般低价值客户"
    }
    return mapping.get(r + f + m, "其他")

rfm_df['Customer_Segment'] = rfm_df.apply(segment_customer, axis=1)
2. 转化漏斗与同期群留存(Cohort)分析
除了静态的用户分群,电商业务更依赖动态链路追踪:
- 全链路转化漏斗:从“商品详情页浏览 → 加入购物车 → 提交订单 → 成功支付”,计算每一步的绝对转化率与相对跳失率。若发现在提交订单到成功支付之间出现陡降,即可迅速锁定支付接口故障或运费过高等阻碍因素。
- 同期群留存矩阵:按用户首购发生月份划分为不同的群体(Cohort),横向追踪第1至第12个月的复购活跃度,从而准确验证新运营策略或改版对长期复购习惯的真实提振效果。
四、实施Python数据分析的标准操作步骤
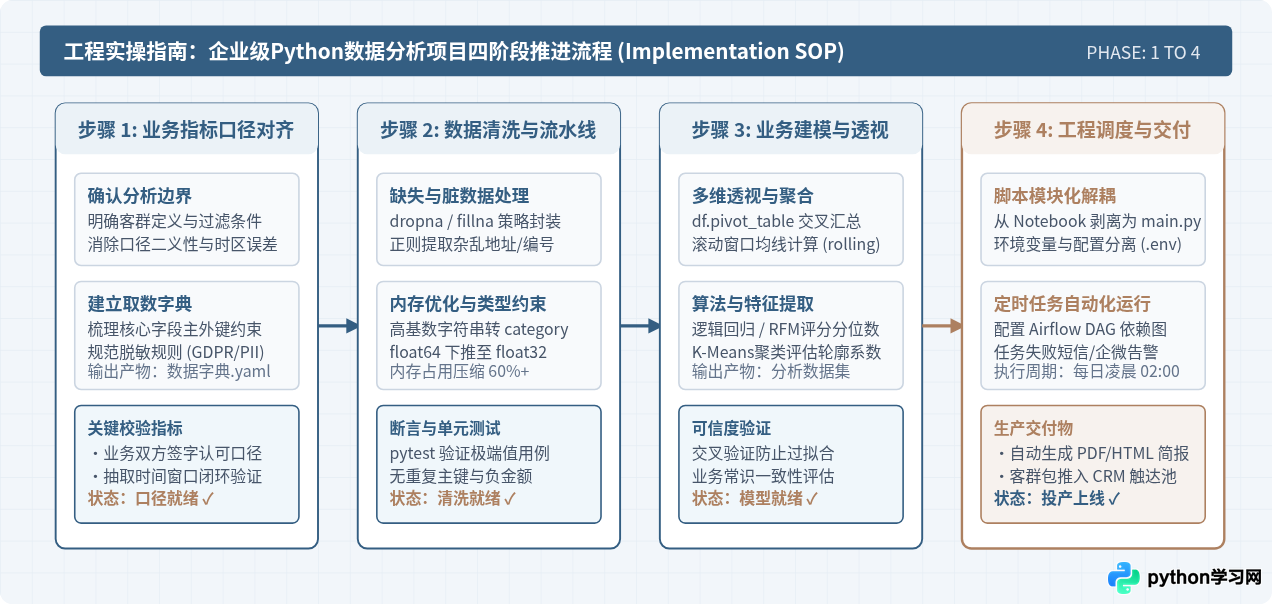
要让数据分析真正服务于商业决策,不能仅停留在临时编写的脚本中,而应建立规范、可复现、可监控的标准操作流程。无论是在金融机构做资产回测,还是在电商企业做每日大促复盘,标准实施过程均可拆解为四个关键步骤:
步骤一:明确商业指标口径与数据对齐
在开始编写代码前,必须先与业务团队对齐指标计算公式。例如,“用户复购”是指30天内产生第二次有效支付,还是排除退款后的净交易笔数;“违约率”计算是以贷款发放日为基准还是以逾期发生日为基准。明确口径能避免后续推倒重算。
步骤二:构建本地可验证的清洗流水线
在本地Jupyter Lab或Python工程中完成样本抽取,编写可复用的清洗函数。包括检测时间戳的时区统一性、对缺失连续值采用中位数插补、对缺失分类变量打标为“未知”,并编写断言(assert)确保基础字段在合理区间内(如年龄在0至120之间、交易金额大于等于0)。
步骤三:统计建模与核心指标多维透视
通过Pandas透视表(Pivot Table)、分组聚合(GroupBy)与Scikit-Learn模型,对目标客群或资产组合进行测算,提取关键指标,并检验结果的统计显著性(p值验证与置信区间覆盖)。
步骤四:工程化封装与自动化生产部署
将探索性Notebook脚本重构为模块化的标准 .py 工程,配置自动化调度工具(如Airflow或系统Crontab),建立每日定时抽取清洗、指标更新与数据异常告警机制。
五、场景选型与工具链综合总结
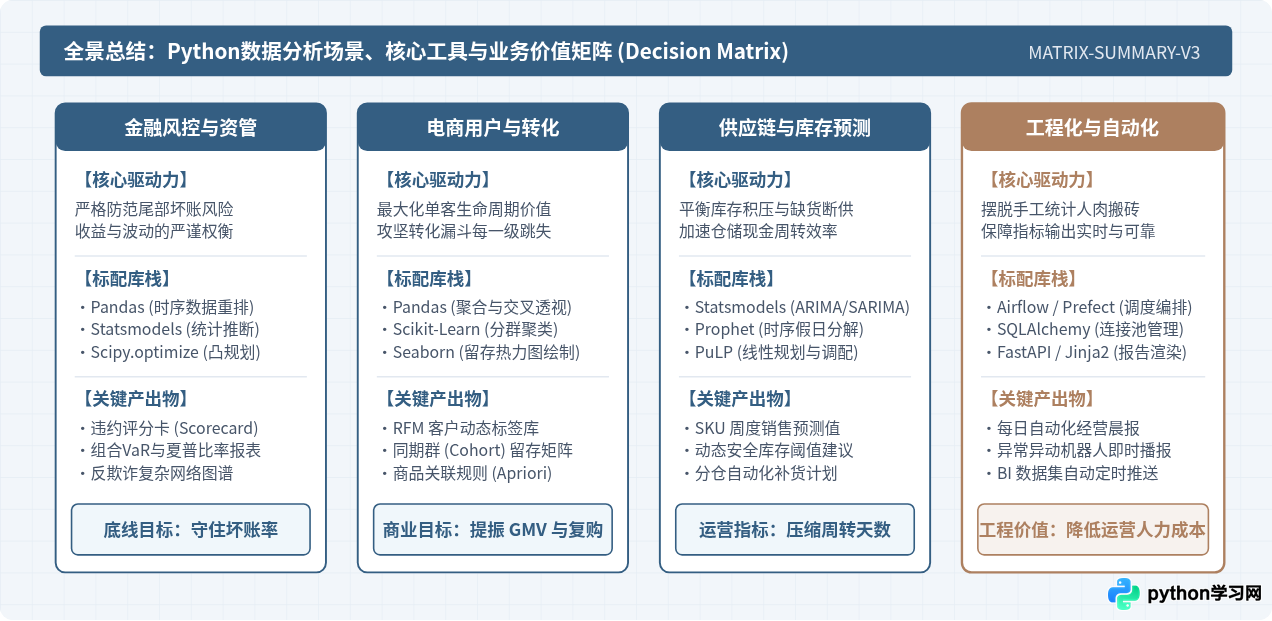
不同行业和业务场景所面临的数据结构、实时性要求以及合规约束大相径庭。在实际技术选型中,应根据业务目标选用针对性的库与工程架构,避免“杀鸡用牛刀”或“工具选型能力不足导致内存溢出”。下表系统梳理了金融、电商与通用运营场景的选型对照:
| 业务领域 | 核心分析场景 | 关键业务指标 | 核心依赖技术栈 | 输出物形态 |
|---|---|---|---|---|
| 金融风控 | 信用评分卡、反欺诈筛查 | 违约概率 (PD)、KS值、AUC、IV | Pandas, Scikit-Learn, Statsmodels | 实时评分接口 / 准入规则集 |
| 量化资管 | 资产组合评估、极值风险测算 | 夏普比率、最大回撤、年化波动率、VaR | NumPy, SciPy, Matplotlib | 风险归因分析报告 / 自动调仓指令 |
| 电商运营 | RFM价值细分、精准营销 | 客单价 (AOV)、购买频次、首购间隔 | Pandas, Scikit-Learn (K-Means) | 动态CRM用户标签人群包 |
| 电商转化 | 全链路转化漏斗、同期群留存 | 各环节跳失率、次月复购率、LTV | Pandas, Seaborn, Plotly | 交互式BI分析看板 / 异常流失预警 |
| 通用运营 | 服务器日志审计、自动化对账 | 接口错误率、对账平账差异额、处理时延 | Python OS/Re, Polars, SQLAlchemy | 每日自动化邮件 / 企业微信告警机器人 |
六、工程实践中的注意事项与常见误区
- 幸存者偏差与样本选择偏误:例如在电商留存分析中,如果仅统计“已绑定手机号并完成实名认证”的用户,会显著高估整体留存水平;在金融风控建模中,未通过风控的历史客户违约数据是缺失的(Rejected Reject),若直接用存量样本建模会导致样本偏误,必要时需采用“拒绝推断(Reject Inference)”技术进行校正。
- 内存溢出与吞吐瓶颈:当单表记录突破千万行时,直接调用
pd.read_csv()容易导致内存溢出(OOM)。可采用chunksize分块读取、显式指定精简数据类型(如将int64转换为int32或uint16),或对于更大体量的数据迁移使用Polars或分分布式计算框架。 - 因果倒置与虚假相关:“在电商App停留时长越长的人消费越多”往往是因为意向强烈的用户在仔细比价挑选,而非强制延长停留时间就能带来转化提升。分析结论必须区分相关关系与因果关系,重要业务决策需通过严谨的 A/B 测试(双样本 t 检验)予以验证。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









