

Python可变与不可变数据类型的区别及内存机制
深入解析Python中可变与不可变数据类型的本质差异、底层CPython内存对象结构(PyObject与PyVarObject)、参数传递机制、原地操作符原理及经典默认参数与元组嵌套陷阱。
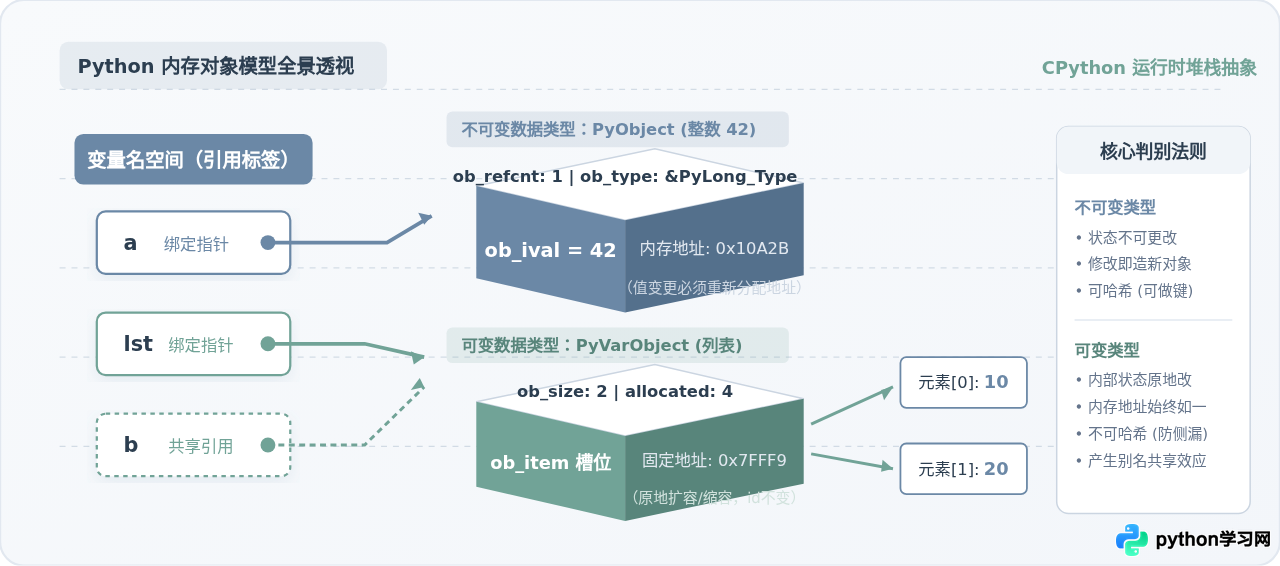
一、核心认知:变量是贴在对象上的“标签”
很多从 C/C++ 转向 Python 的开发者常带着“变量即内存空间”的思维定势:声明 int a = 10; 时,系统在栈上划出一块 4 字节的固定内存区域,后续赋值 a = 20; 只是将新数据覆写进该固定地址。
但 Python 的内存运作方式完全不同。在 Python 中:
- 一切皆对象:无论整数、浮点数、函数还是列表,在底层都是在堆内存中动态分配的 C 语言结构体。
- 变量只是指针别名:变量本身不持有数据,它只是命名空间字典(如局部符号表)中的一个键,其值是指向堆内存对象的指针。
- 内置函数
id()的本质:在 CPython 官方实现中,id(obj)直接返回该对象在 C 语言层面的内存虚拟地址;运算符is用于比较两个变量是否指向同一个内存地址(即判断id(a) == id(b)),而==则调用对象的__eq__方法比对内容是否相等。
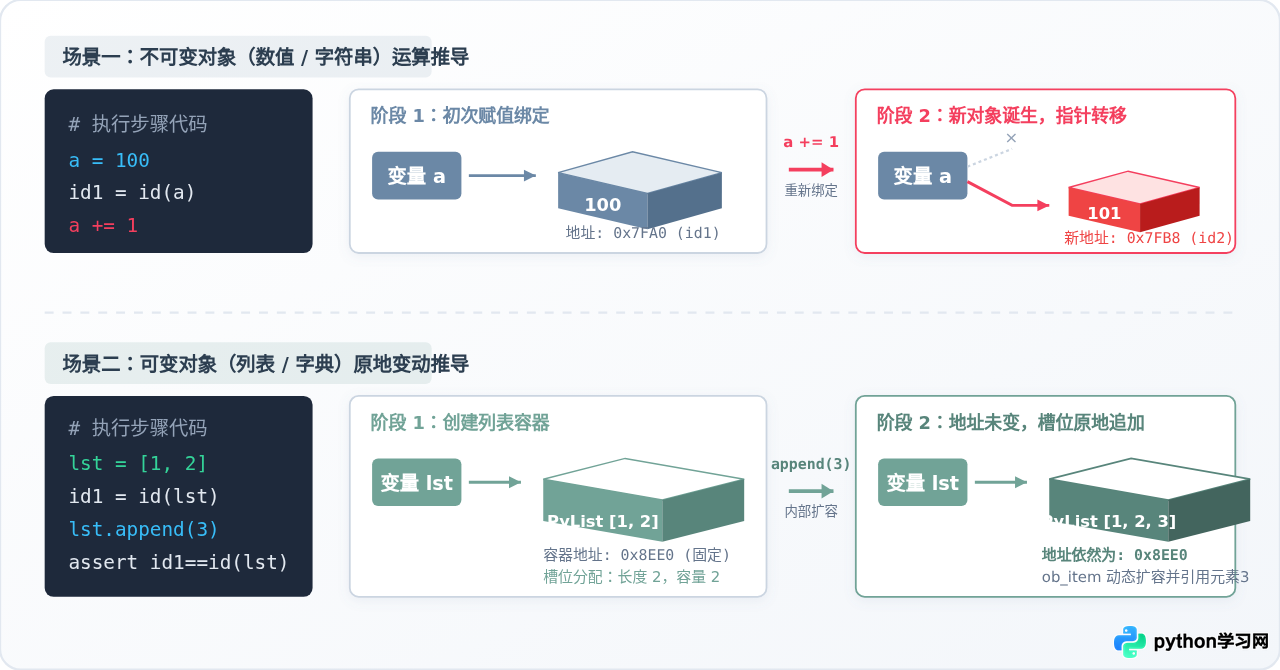
当执行 a = 100 然后 a += 1 时,由于整数是不可变对象,CPython 无法直接在原有内存块上将数值修改为 101,而是必须在堆中创建(或从缓存池调取)一个全新的整数对象 101,并将变量标签 a 重新指向这个新地址,原有的 100 如果没有其他引用,则等待垃圾回收器(引用计数机制)回收。
而执行 lst = [1, 2] 然后 lst.append(3) 时,变量 lst 所指的列表对象内存地址自始至终未曾改变,变动的是该列表结构体内部持有的动态指针数组。
二、分类体系与底层数据结构:PyObject 与 PyVarObject
要从根本上把握可变与不可变,需要深入 CPython 的源码结构。在 Python 的底层 C 语言实现中,所有对象都以 PyObject 或其扩展结构 PyVarObject 开头:
/* CPython 源码结构精简示意 */
typedef struct _object {
    _PyObject_HEAD_EXTRA // 双向链表指针,用于垃圾回收跟踪
    Py_ssize_t ob_refcnt; // 引用计数器
    struct _typeobject *ob_type; // 类型指针,指向对象的类型元数据
} PyObject;

typedef struct {
    PyObject ob_base;
    Py_ssize_t ob_size; // 变长对象所容纳的元素个数
} PyVarObject;| 分类 | 数据类型 | 底层核心结构 | 内存可变性 | 哈希特性(Hashable) |
|---|---|---|---|---|
| 不可变数据类型 | int, float, bool, str, tuple, frozenset, bytes |
定长 PyObject 或结构封冻的 PyVarObject |
创建后内存载荷禁止变更,修改必生成新对象 | 具备 __hash__ 方法,可作字典键或集合元素 |
| 可变数据类型 | list, dict, set, bytearray |
含动态数组/哈希表的 PyVarObject |
允许在原有地址上扩容、缩容、更新元素 | __hash__ 为 None,不可作字典键 |
1. 为什么字符串与整数不可变?
不可变性为底层引擎带来了巨大的优化红利:
- 小整数对象池(Small Integer Cache):CPython 启动时会预先在内存中分配
[-5, 256]范围内的所有整数对象。因为整数不可变,全进程任何位置对该区间数值的引用均可安全共享同一份内存地址,极大减轻了频繁数值计算导致的内存碎片。 - 字符串驻留机制(String Interning):符合标识符规则的短字符串在内存中会被驻留缓存。因为内容不可修改,Python 进行字典键查找比对时,无需逐字符比较字符串内容,直接比对指针地址(
a is b)即可完成命中判断,速度提升数倍。 - 字典哈希键的稳定性保证:Python 的
dict是高度优化的哈希表。键的哈希值必须保证在生命周期内永不改变。如果字典键是可变类型并且内容被修改,其在哈希桶中的定位将发生错位,导致数据无法检索。因此 Python 明确规定:只有不可变对象(或所有子元素均不可变的元组)才允许被哈希。
三、经典疑难剖析:不可变容器中的可变元素
“元组是不可变的”,这句话在初学者中常被误解为“元组内所有东西都不能变”。事实上,元组的“不可变”仅指该元组对象所持有的引用槽位数组不可被替换,它既不保证其引用的目标对象本身不可变,也不限制目标对象内部状态的演进。
请观察以下经典的面试难题:
t = (1, [2, 3])
try:
    t[1] += [4]
except TypeError:
    print("捕获到异常!")

print("此时元组内容为:", t)
运行输出结果:
捕获到异常!
此时元组内容为: (1, [2, 3, 4])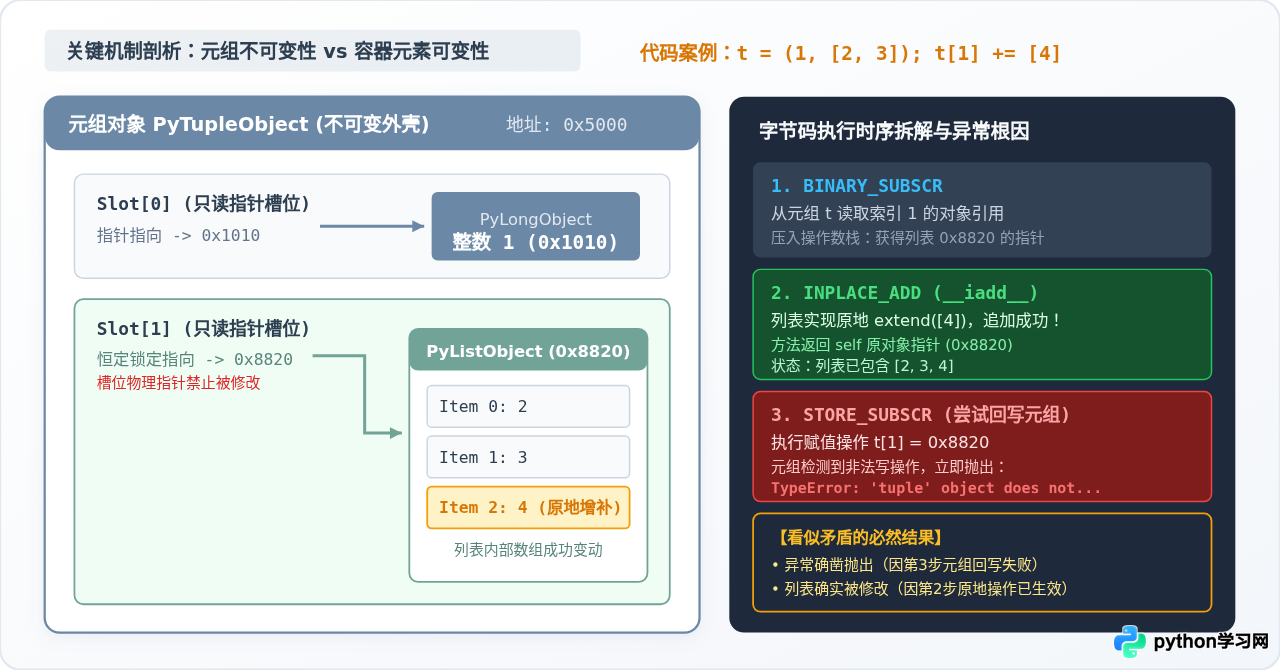
很多开发者对此大为困惑:为什么报错抛出了 TypeError: 'tuple' object does not support item assignment,列表内部却依然成功添加了元素 4?
通过 dis.dis("t[1] += [4]") 查看 Python 字节码,执行过程清晰可见:
- 加载目标对象:字节码指令
BINARY_SUBSCR获取t[1],得到位于堆内存地址0x8820的列表对象。 - 执行就地加法:指令
INPLACE_ADD调用列表对象的__iadd__协议,在0x8820内部将[4]原地追加进当前列表,并将self(即自身地址0x8820)返回并压入计算栈顶。至此,列表内部数据已经完成变更! - 执行存储赋值:增量操作符
+=的语法定义要求将运算结果写回原容器变量,因此下一条指令是STORE_SUBSCR,它尝试执行t[1] = 0x8820。 - 触发防御阻断:元组的类型定义中没有实现
tp_as_mapping->mp_ass_subscript赋值接口,系统判定为非法写操作,立即抛出TypeError。
+=, *=)。如果确实需要扩充列表,应明确调用 t[1].extend([4]) 或 t[1].append(4),避免因回写赋值触发语法异常。
四、函数传参机制与默认形参陷阱
关于 Python 的函数调用,常有人争论是“值传递”还是“引用传递”。官方文档将其明确定义为“传对象引用”(Call by Object Reference)或“共享传参”(Call by Sharing)。
当实参传递给函数形参时,并没有发生任何深层的内存拷贝,而仅仅是将形参这个“局部标签”绑定到了实参所指向的同一内存对象上。形参内部的代码决定了后续行为:
- 对不可变对象做修改或重新赋值:如
x = x + 1或x = [1, 2],只是将局部变量x重新绑定到新对象,外部实参指向的对象毫无变化。 - 对可变对象就地修改:如
x.append(100)或x["status"] = "ok",直接影响堆中原本的对象,函数外部所有指向该对象的变量都会感知到该变化。
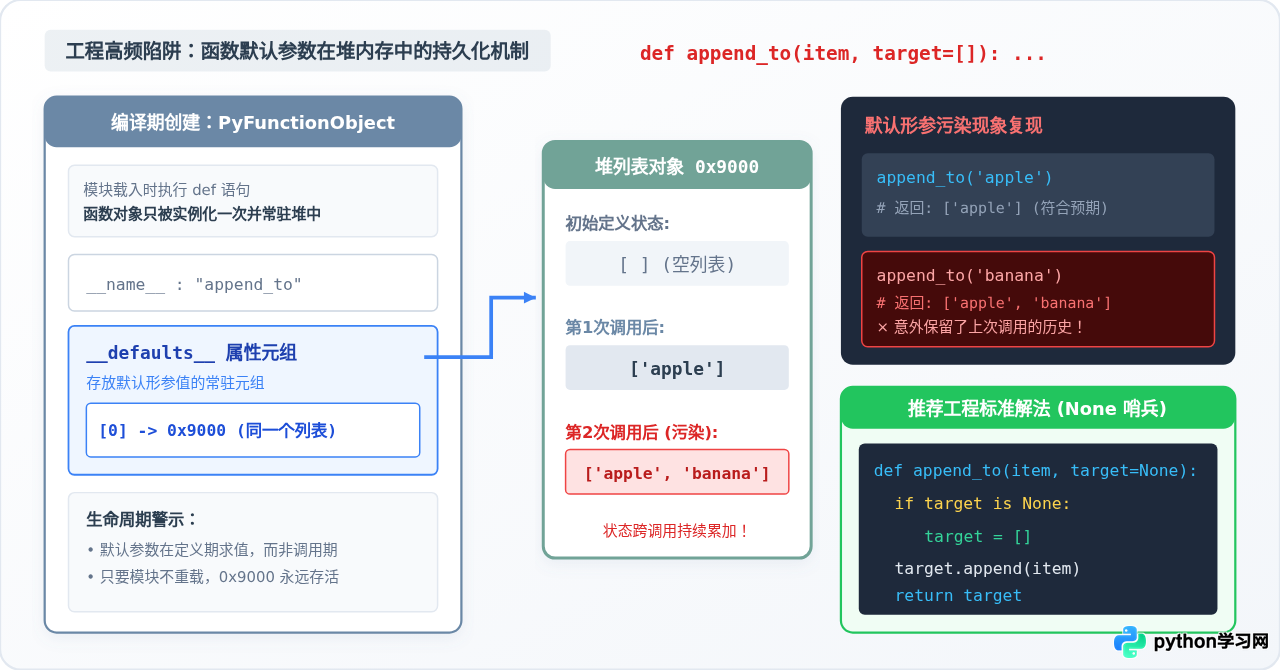
臭名昭著的默认参数污染
以下代码是 Python 开发中最容易出现的“幽灵 Bug”之一:
def add_item(item, container=[]):
    container.append(item)
    return container

print(add_item("A")) # 预期: ['A'],实际: ['A']
print(add_item("B")) # 预期: ['B'],实际: ['A', 'B'] !!!
根本原因:Python 解释器在编译载入模块执行 def 语句时,仅对函数定义求值一次。默认参数列表 container=[] 在定义时便在堆内存中实例化完成,并作为元组被妥善保存在该函数对象的 __defaults__ 内部属性中。
每次调用 add_item 时,如果不传入第二个参数,局部变量 container 就会直接指向 __defaults__[0]。在函数内部执行 container.append() 时,修改的正是那个跨请求、跨会话常驻在堆中的同一个列表对象。
None 作为具有可变语义参数的默认值,并在函数体内动态判断并初始化:
def add_item(item, container=None):
    if container is None:
        container = [] # 每次调用动态分配全新的局部列表
    container.append(item)
    return container
五、原地操作符、浅拷贝与深拷贝的内存行为
可变对象的共享特性带来了灵活与高效,但在处理对象复制时,如果忽视内部指针的层级关系,极易导致别名污染。
1. += 与 + 的内存差异
对于列表,a = a + [1] 与 a += [1] 存在本质区别:
a = a + [1]:调用__add__,创建并拼接出一个全新的列表对象,然后将a重新绑定。如果有其他变量b = a,b的内容不会改变。a += [1]:调用__iadd__,等同于a.extend([1]),直接在原列表内存中原地扩容。如果存在别名b = a,则b会同步发生变化。
2. 浅拷贝(Shallow Copy)与深拷贝(Deep Copy)
import copy

origin = [1, [2, 3]]

# 浅拷贝方式:切片 [:]、list()、copy.copy()
shallow = copy.copy(origin)

# 深拷贝方式:copy.deepcopy()
deep = copy.deepcopy(origin)
在内存层面:
- 浅拷贝:仅在堆上创建新的最外层列表外壳,但列表内部的槽位只是机械复制原列表的指针。修改
shallow[1].append(99)会同时殃及origin[1],因为它们引用的子列表是同一个内存块。 - 深拷贝:通过维护一个备忘字典(Memo Dict)递归遍历整棵对象树,为所有遇到的可变子对象分配全新的内存空间,并正确保持循环引用的完整性。
六、工程实践与决策总结
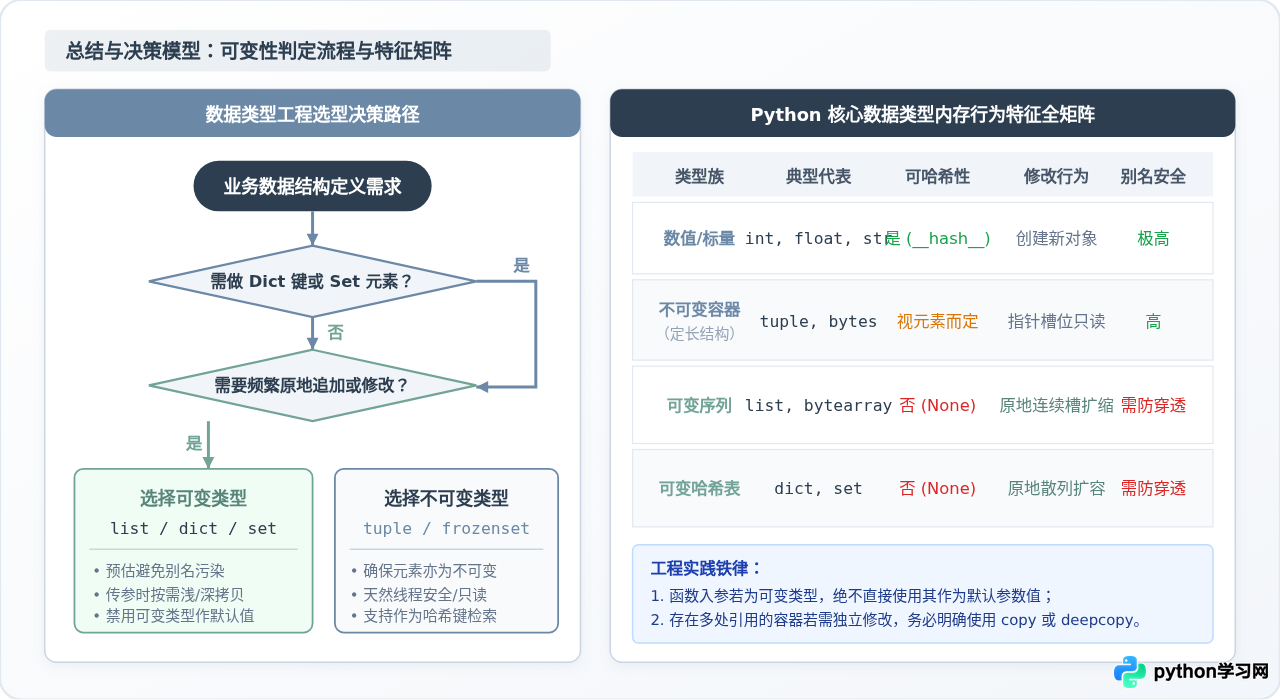
在实际工程架构与编码设计中,合理选用可变与不可变类型是保障代码健壮性与运行性能的关键。可以遵循以下四项核心设计准则:
- 字典键与集合元素必须选不可变类型:如果需要以多字段作为复合键,优先选用
tuple或只读的NamedTuple,严禁使用list。 - 并发与多线程场景优先使用不可变数据结构:不可变对象创建后内部状态恒定,天然不存在写冲突与数据竞争,无需加锁即可跨线程安全读取。
- 性能敏感的高频字符串拼接避免使用
+=:因为字符串不可变,循环执行s += chunk会导致频繁的内存重分配与旧数据内存拷贝,时间复杂度退化至 \(O(N^2)\)。应当预先收集进列表,最后调用"".join(chunks)一次性在 C 层面计算总长度并申请内存完成组装。 - 外部接口输入的可变数据需做好防御性隔离:当类的构造方法接收外部传入的列表或字典作为内部属性时,若后续业务需要修改该属性,建议在赋值时显式执行
self.items = list(input_items)建立浅拷贝或深拷贝,切断与外部调用者的内存牵连。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









