

Python 2与Python 3中range函数的行为差异

在 Python 语言的演进过程中,range 函数是核心语法中变动最显著、影响也最深远的内置功能之一。核心结论十分直接:在 Python 2 中,range() 是一个即时在内存中完整构建并返回整数列表的函数;而在 Python 3 中,旧版 xrange() 被移除,新版 range() 被彻底重构为一种计算开销恒定、占用极低内存的不可变序列类型(range 对象)。理解这一变化不仅关乎语法的正确使用,更直接影响海量循环场景下的内存开销与执行效率。
一、核心机制对比:即时列表生成与惰性按需求值
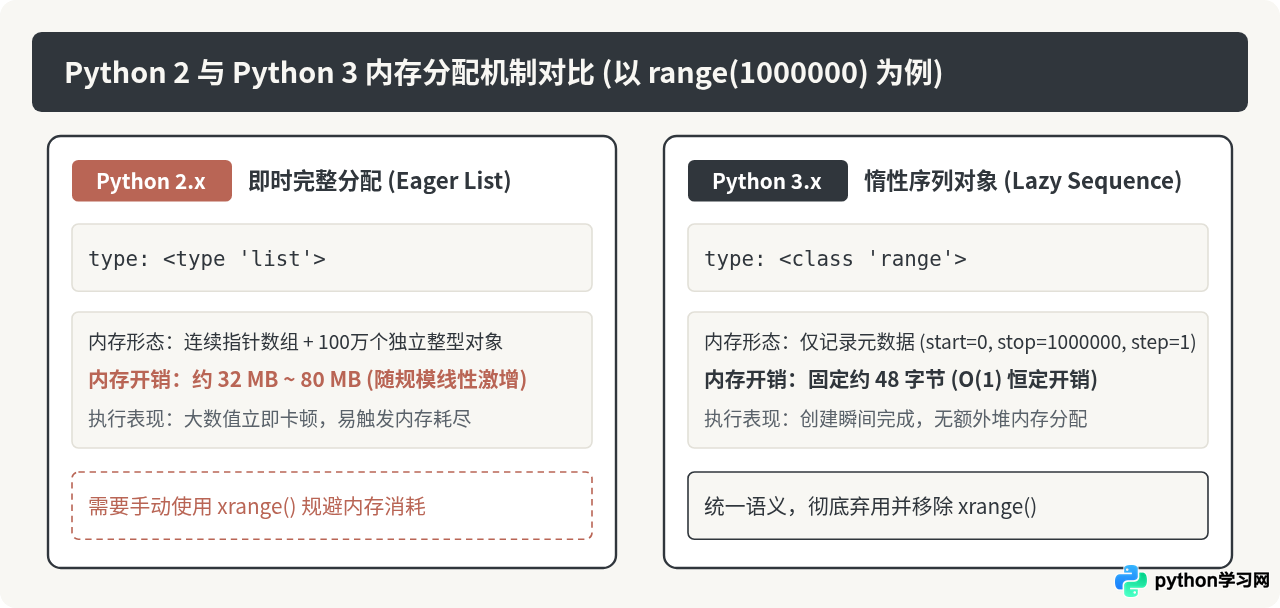
在 Python 2 中调用 range(n) 时,解释器会立即在堆内存中开辟连续的数组空间,逐一实例化从 0 到 n-1 的所有整数对象,并将指针填入一个新建的 list 实例中返回。如果指定的范围达到千万级,这一操作会瞬间吞噬数十兆甚至数百兆内存,并且存在显著的内存分配延迟。
为了解决高开销问题,Python 2 曾经额外提供了名为 xrange() 的内置函数。而在 Python 3 的设计中,解释器去除了这种语义重复的双轨机制:完全删除了 xrange 关键字,并将 range 改造为惰性计算序列。在 Python 3 中,无论范围传入多大,range() 均仅保存起始(start)、终止(stop)与步长(step)三个数值元数据,其内存占用保持恒定(在 64 位 CPython 环境下仅约 48 字节)。
二、类型表达与返回值特征
在交互式命令行终端中直接运行 range(),可以清晰直观地观察到两个主版本的表达差异:
1. Python 2.7 终端执行表现
# 终端执行示例(Python 2.7 环境)
>>> r = range(5)
>>> type(r)
<type 'list'>
>>> r
[0, 1, 2, 3, 4]
>>> r.append(99)  # 具备 list 的所有可变方法
>>> r
[0, 1, 2, 3, 4, 99]
2. Python 3 终端执行表现
# 终端执行示例(Python 3.10+ 环境)
>>> r = range(5)
>>> type(r)
<class 'range'>
>>> r
range(0, 5)
>>> list(r)       # 如确实需要实体列表,需显式转换
[0, 1, 2, 3, 4]
>>> r.append(99)  # 抛出异常:AttributeError: 'range' object has no attribute 'append'
这种改变意味着在 Python 3 中,range 对象是一个不可变序列,不再具备 list 的任何就地修改方法(如 append()、extend()、pop() 或 sort())。
三、Python 3 range 并非简单生成器:序列特性与 O(1) 操作
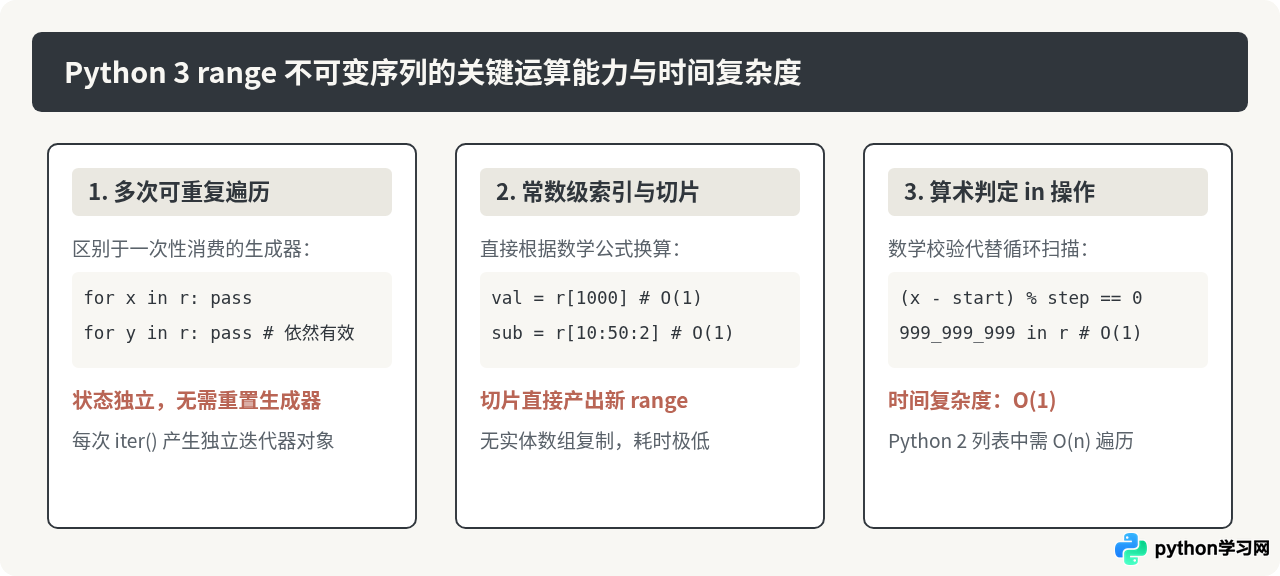
不少从旧版本过渡的开发者常误将 Python 3 的 range 视作类似生成器函数(Generator)或迭代器(Iterator)的对象。事实上,Python 3 的 range 实现了完整的不可变序列协议(Sequence Protocol),具有许多生成器无法具备的高级能力:
- 支持高频多重迭代: 生成器是一次性消费的,遍历结束后即枯竭;而 Python 3 的
range对象是可重入的,可以多次在不同的for循环中遍历而无需重新生成。 - 常数级随机索引: 支持
r[i]负索引和正索引随机访问,计算耗时为常数级 $O(1)$,通过公式start + i * step直接推导结果,无需逐一计数。 - 常数级切片生成: 对
range进行切片操作(如r[2:8:2])不会产生列表,而是立即返回一个新的range对象,计算复杂度同样为 $O(1)$。 - 数学化成员检测: 判断数值是否存在(如
val in r),Python 2 的list与xrange均需要线性扫描迭代($O(n)$ 复杂度);而在 Python 3 中,解释器通过取模与边界计算(如(val - start) % step == 0)直接得出布尔值,即使在十亿级范围内也是微秒级返回。
四、数值上限差异:sys.maxint 的历史枷锁
在 Python 2 中,尽管 xrange() 具有类似惰性计算的优点,但它的底层是用 C 语言的原生 long 类型实现的。这意味着 xrange() 接受的参数范围不能超过系统底层 sys.maxint 的上限(在 32 位系统通常是 $2^{31}-1$,64 位系统通常是 $2^{63}-1$)。一旦尝试超出该范围,解释器会直接抛出 OverflowError: Python int too large to convert to C long 错误。
在 Python 3 中,标准整数类型与长整型实现了统一(移除了旧版 long,统一为任意精度的 int)。同时,Python 3 的 range 支持任意精度的超大数值:
# Python 3 支持超大整数无缝传入
>>> big_r = range(10**50, 10**50 + 10)
>>> big_r[2]
100000000000000000000000000000000000000000000000002
>>> len(big_r)
10
五、代码迁移与跨版本兼容实践
在维护需要同时兼容 Python 2 和 Python 3 的代码库,或将老旧系统代码升级至 Python 3 时,涉及 range 的改动是引起兼容性报错的常见诱因。以下是梳理的标准判断与迁移步骤:
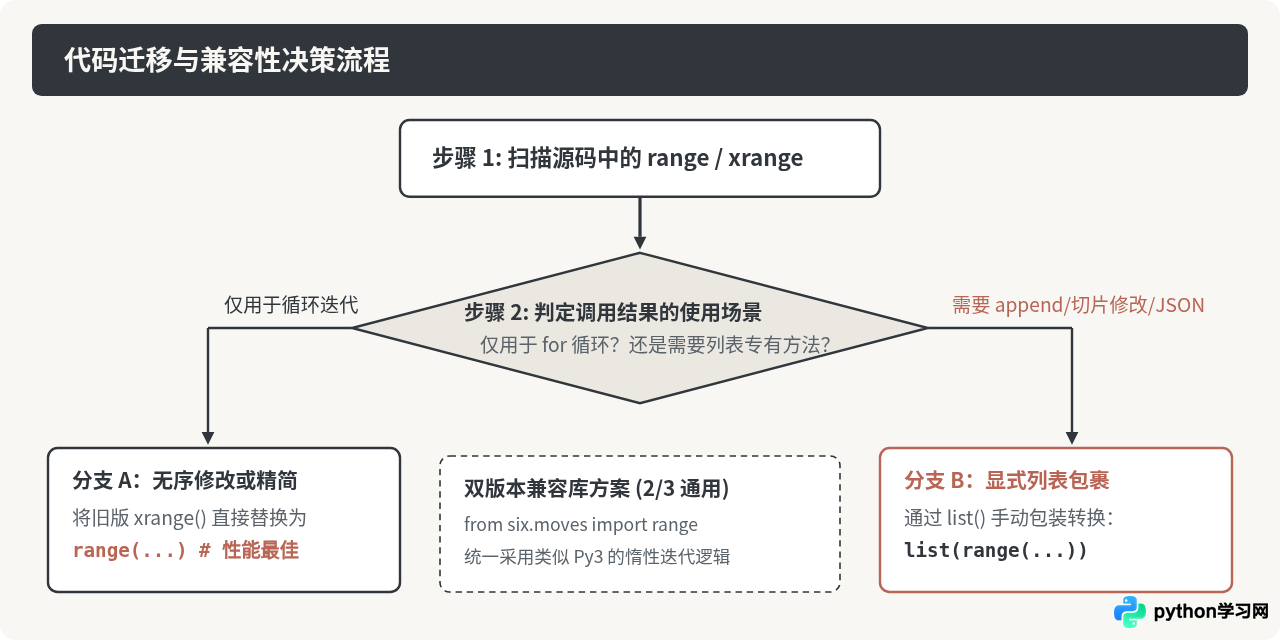
迁移中的典型易错场景:
- 列表拼接与切片运算报错:
# 在 Python 2 中合法,但在 Python 3 会抛出 TypeError nums = range(5) + [10, 20] # Python 3: TypeError: unsupported operand type(s) for +: 'range' and 'list' # 修复方案:显式包装为列表 nums = list(range(5)) + [10, 20] - 序列化与接口输出:
在使用
json.dumps()导出数据时,Python 2 中的range结果本质就是列表,可直接被序列化;但在 Python 3 中,直接向json.dumps()传入range(10)会触发TypeError: Object of type range is not JSON serializable。必须在序列化前显式调用list()。 - 类型断言与判断:
如果现有代码中存在
isinstance(val, list)的校验逻辑,在传入 Python 3 的range()结果时将直接返回False。针对这种序列判断,应根据实际诉求改用isinstance(val, collections.abc.Sequence)。
六、全维度对比总结
综合上述所有机制、语法和性能层面的细节,我们将 Python 2 的 range、xrange 与 Python 3 的 range 之间的关键特性汇总对比于下表与示意图中:
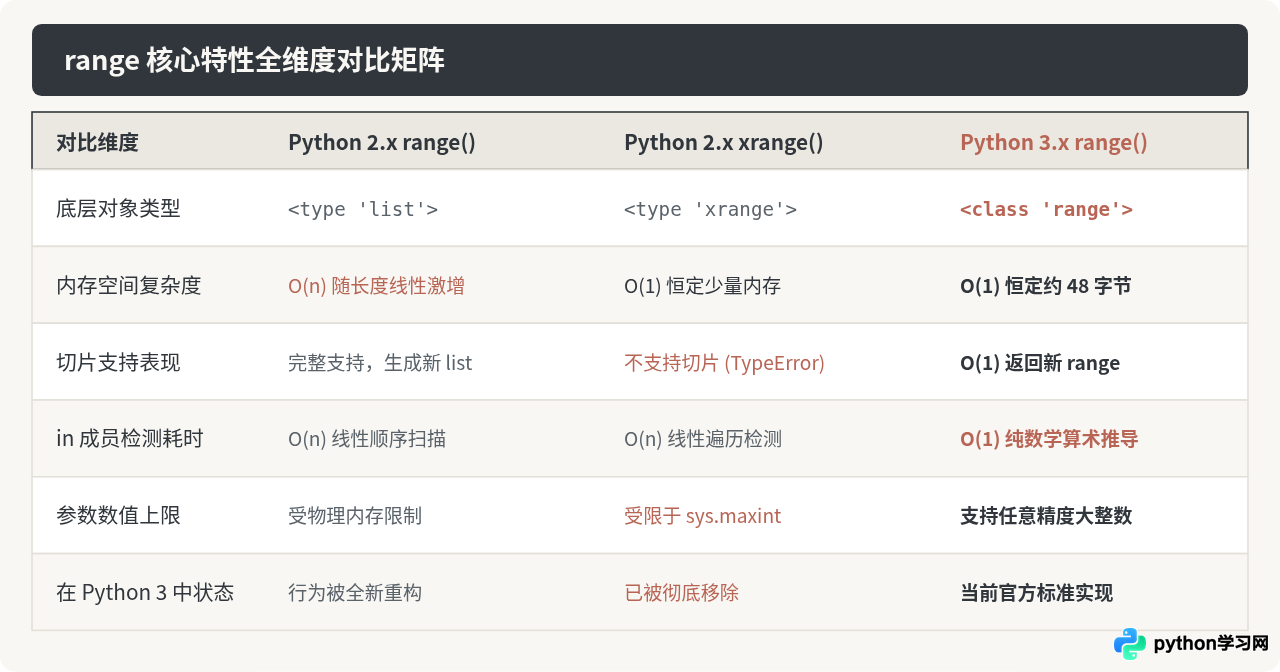
range 的重新设计体现了现代编程语言对“空间换时间”与“按需计算”之间平衡的精细考量。它不仅继承了 Python 2 xrange 的极简内存开销,还通过不可变序列接口保留了切片、索引与常数级成员判定的高效特性,实现了性能与表达力的高度统一。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









