

Python中文字符串排序乱序怎么解决
深入解析Python中文字符串排序出现乱序的底层原因,详细讲解基于pypinyin库、标准库locale以及工业级PyICU的三种解决方案,包含字典多维排序、多音字处理与避坑实践。
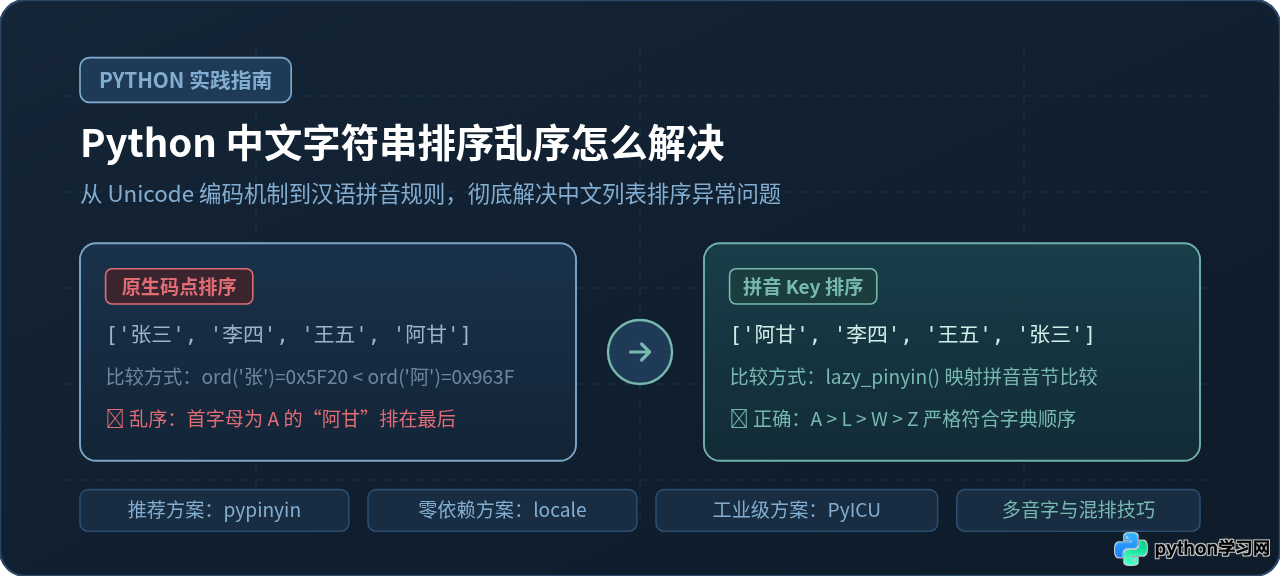
sort() 或 sorted() 时,输出顺序往往既不是汉语拼音的首字母顺序,也不是部首笔画顺序,而是按照汉字在 Unicode 字符集中的原始码点(Code Point)数值进行升序排列。解决该问题的标准做法是通过 key 参数提供拼音转换函数。在绝大多数实际工程中,最稳妥、跨平台完全一致的方案是使用 pypinyin 库;若处于严禁安装第三方依赖的极端离线环境,则可使用标准库 locale 作为备选。
一、现象与根源:为什么 Python 默认排序会出现“乱序”
假设系统中有包含人名的中文列表:["张三", "李四", "王五", "赵六", "阿甘"]。按照大众熟悉的汉语拼音或通讯录检索习惯,首字母为 A 的“阿甘”应当排在首位,而首字母为 Z 的“张三”和“赵六”应当排在最后。
然而,直接在 Python 中运行内置排序会得到如下结果:
# 示例:Python 默认排序行为
names = ["张三", "李四", "王五", "赵六", "阿甘"]
sorted_names = sorted(names)

print("排序结果:", sorted_names)
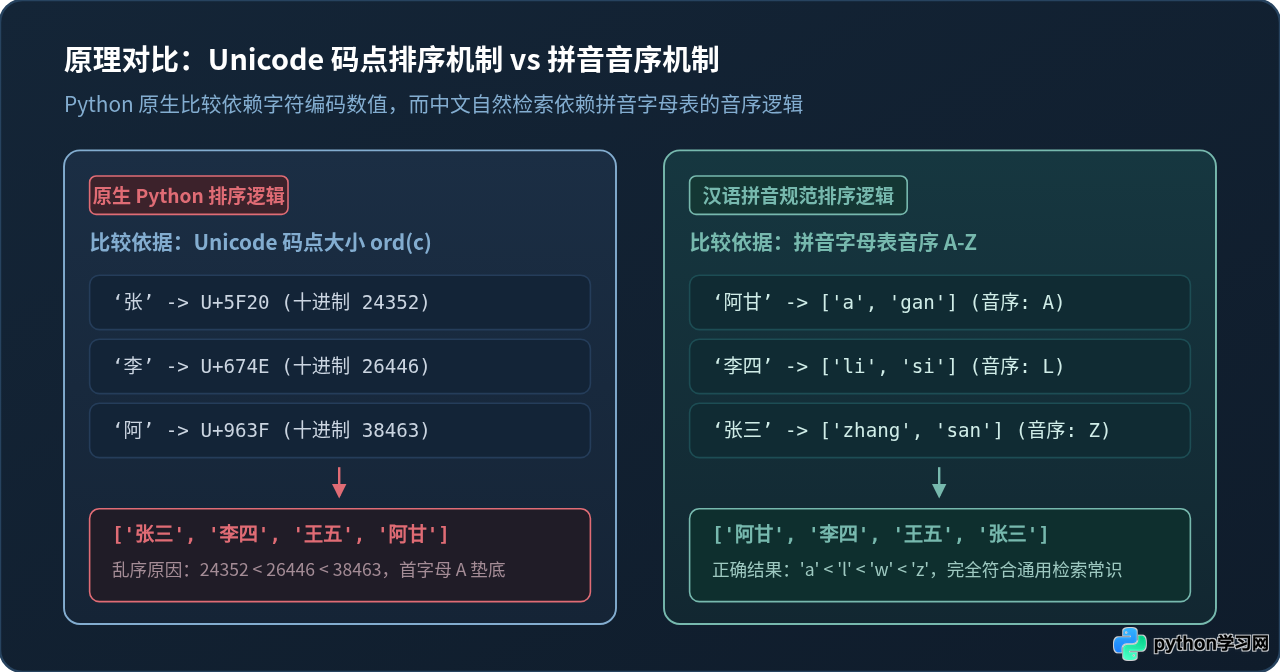
# 示例输出:['张三', '李四', '王五', '赵六', '阿甘']可以看到,“阿甘”不仅没有出现在最前面,反而被排在最末尾。导致这一“乱序”现象的根源在于:Python 默认的字符串大小比较机制是基于字符的 Unicode 码点数值(即 ord(char) 的返回值)逐字比较的,它完全不具备中文拼音的语义认知。
我们通过内置函数 ord() 检查各个字符的十六进制与十进制码点:
'张':Unicode 编码U+5F20,对应十进制整数 24352'李':Unicode 编码U+674E,对应十进制整数 26446'王':Unicode 编码U+738B,对应十进制整数 29579'赵':Unicode 编码U+8D75,对应十进制整数 36213'阿':Unicode 编码U+963F,对应十进制整数 38463
因为 24352 < 26446 < 29579 < 36213 < 38463,所以在计算机纯数值视角下,“张”确实比“阿”小。下图清晰展示了原生数值比较与人类拼音期望之间的差异:
二、推荐方案:使用 pypinyin 库实现拼音音序排序
在生产环境和业务开发中,解决该问题最健壮的方法是引入成熟的第三方拼音处理库 pypinyin。它纯 Python 实现,安装轻量且不依赖操作系统的底层语言包配置,无论在 Windows、Linux 容器还是 macOS 下,都能保持百分之百一致的排序输出。
1. 环境安装
pip install pypinyin2. 基础列表排序
利用 sorted() 函数的 key 参数,传入 pypinyin.lazy_pinyin。该函数能够把汉字字符串转换为无声调的拼音列表,例如 '阿甘' 转化为 ['a', 'gan']。Python 在比对列表时,会依次比较内部的英文字符串,自然实现 A-Z 拼音排序:
from pypinyin import lazy_pinyin

names = ["张三", "李四", "王五", "赵六", "阿甘"]

# 将拼音提取函数作为排序 key
sorted_names = sorted(names, key=lazy_pinyin)

print("排序结果:", sorted_names)
# 示例输出:['阿甘', '李四', '王五', '张三', '赵六']
3. 对象列表或字典按中文键排序
在实际业务中,中文数据常以字典或对象的形式存在(例如用户列表按姓名排序)。此时可通过 lambda 表达式指定中文字段并调用 lazy_pinyin:
from pypinyin import lazy_pinyin

users = [
    {"id": 101, "name": "张三", "dept": "技术部"},
    {"id": 102, "name": "李四", "dept": "市场部"},
    {"id": 103, "name": "王五", "dept": "运营部"},
    {"id": 104, "name": "阿甘", "dept": "设计部"}
]

# 提取字典中的 name 字段并转换为拼音比较
sorted_users = sorted(users, key=lambda item: lazy_pinyin(item["name"]))

for u in sorted_users:
    print(f"{u['name']} (ID: {u['id']})")

# 示例输出:
# 阿甘 (ID: 104)
# 李四 (ID: 102)
# 王五 (ID: 103)
# 张三 (ID: 101)
4. 进阶处理:兼顾同音字与多音字
当列表中出现同音字(如“张伟”和“章伟”)时,若只比对 lazy_pinyin,两者生成的拼音都是 ['zhang', 'wei']。为了使排序具备严格的确定性,建议使用元组作为 key,即在拼音相同的情况下回退到原始字符串比对:
from pypinyin import lazy_pinyin, Style

names = ["章伟", "张伟", "阿甘"]

# 推荐写法:构造 (拼音, 原文本) 二元组作为排序键
sorted_names = sorted(names, key=lambda x: (lazy_pinyin(x), x))
print(sorted_names)
# 示例输出:['阿甘', '张伟', '章伟']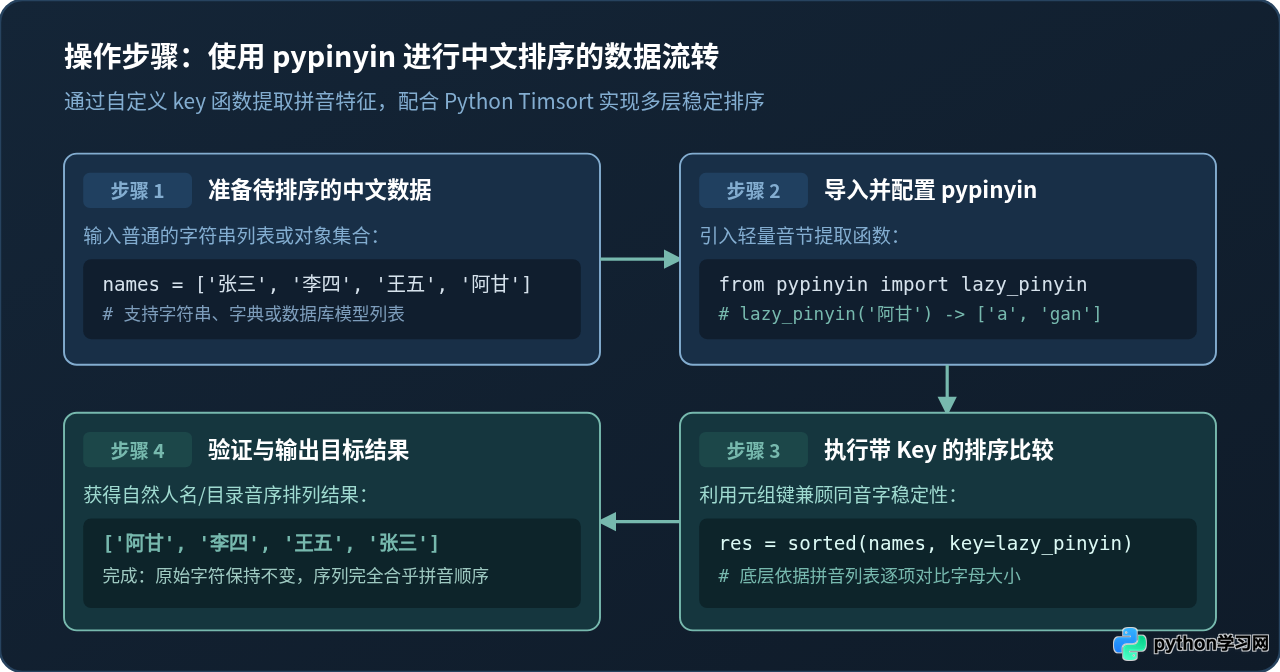
三、零依赖方案:使用标准库 locale
若你的运行环境严禁访问公网或无法通过 pip 安装任何第三方库,可以使用 Python 标准库内置的 locale 模块。它通过调用操作系统底层的语言环境(Collate)规则来确定字符先后顺序。
1. 标准实现代码
import locale

names = ["张三", "李四", "王五", "赵六", "阿甘"]

# 设置当前区域为简体中文(Linux / macOS 通常为 zh_CN.UTF-8)
try:
    locale.setlocale(locale.LC_COLLATE, 'zh_CN.UTF-8')
except locale.Error:
    # Windows 系统的常见区域标识为 Chinese_China.936 或 zh-CN
    locale.setlocale(locale.LC_COLLATE, 'Chinese_China.936')

# locale.strxfrm 将字符串转换为符合当前 locale 的可排序字节串
sorted_names = sorted(names, key=locale.strxfrm)

print("排序结果:", sorted_names)
# 示例输出:['阿甘', '李四', '王五', '张三', '赵六']- 平台名称差异:Linux / macOS 通常使用
zh_CN.UTF-8,而 Windows 则使用Chinese_China.936。代码若要跨平台必须编写兼容捕获逻辑。 - 系统环境依赖:在极其轻量的精简 Docker 镜像(如
alpine或python:slim)中,默认往往没有预装zh_CN语言包,调用setlocale会直接抛出locale.Error: unsupported locale setting。 - 线程安全风险:
locale.setlocale修改的是整个 Python 进程级别的全局状态,在多线程高并发服务(如 Django / FastAPI)中调用可能会引发不可预测的副作用。
四、进阶方案:使用 PyICU(超大规模数据与国际化规范)
对于多语言全球化产品或数据量达到百万级的大数据处理场景,还可以考虑使用 PyICU。它是国际化组件库 ICU(International Components for Unicode)的 Python 绑定,严格执行 Unicode 排序算法(UCA,Unicode Collation Algorithm)。
# 需要系统具备 libicu 并在虚拟环境中安装:pip install PyICU
import icu

names = ["张三", "李四", "王五", "赵六", "阿甘"]

collator = icu.Collator.createInstance(icu.Locale('zh_CN'))
sorted_names = sorted(names, key=collator.getSortKey)

print("排序结果:", sorted_names)
# 示例输出:['阿甘', '李四', '王五', '张三', '赵六']
PyICU 的优势是极快且标准规范完备,但安装门槛较高,需要系统具备 C++ 编译工具链与 ICU 底层库,通常在大型分布式系统中采用。
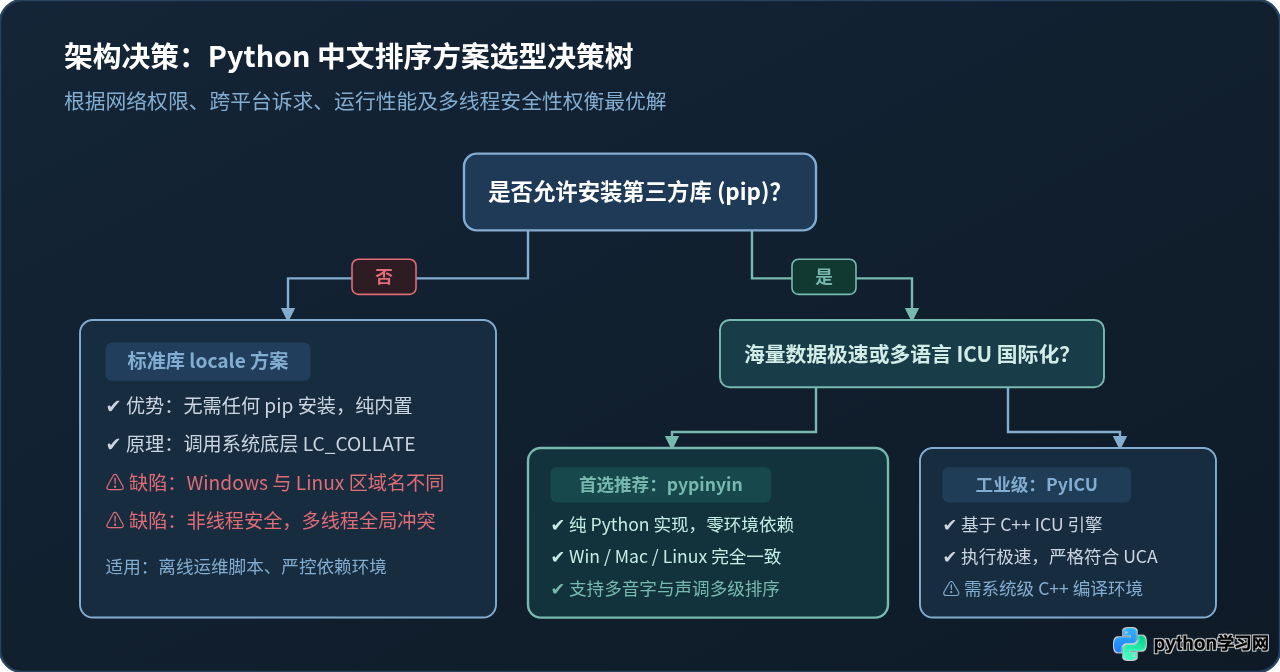
五、方案选型与技术决策树
面对不同的业务场景与基础设施限制,如何挑选最合适的技术方案?可参考下方的决策流转逻辑:
六、工程实战避坑指南
- 就地排序与新建列表:若希望直接修改原列表,请使用
names.sort(key=lazy_pinyin);若希望保留原始列表并返回全新有序列表,请使用sorted(names, key=lazy_pinyin)。 - 中英文混排场景:
lazy_pinyin对英文单词和英文字母默认不做变动,会原样保留字符串,因此在英文与中文混合列表中也能自然进行 A-Z 字母排序。 - 姓氏多音字处理:中文人名中存在特殊姓氏多音字(如“区”作姓氏读
ōu,而普通读音为qū;“单”作姓氏读shàn)。若对人名准确度有极其严苛的要求,可通过pypinyin的词典修正功能加载自定义姓氏拼音表,避免将“区小明”排入 Q 组。
七、总结与核心方案对照
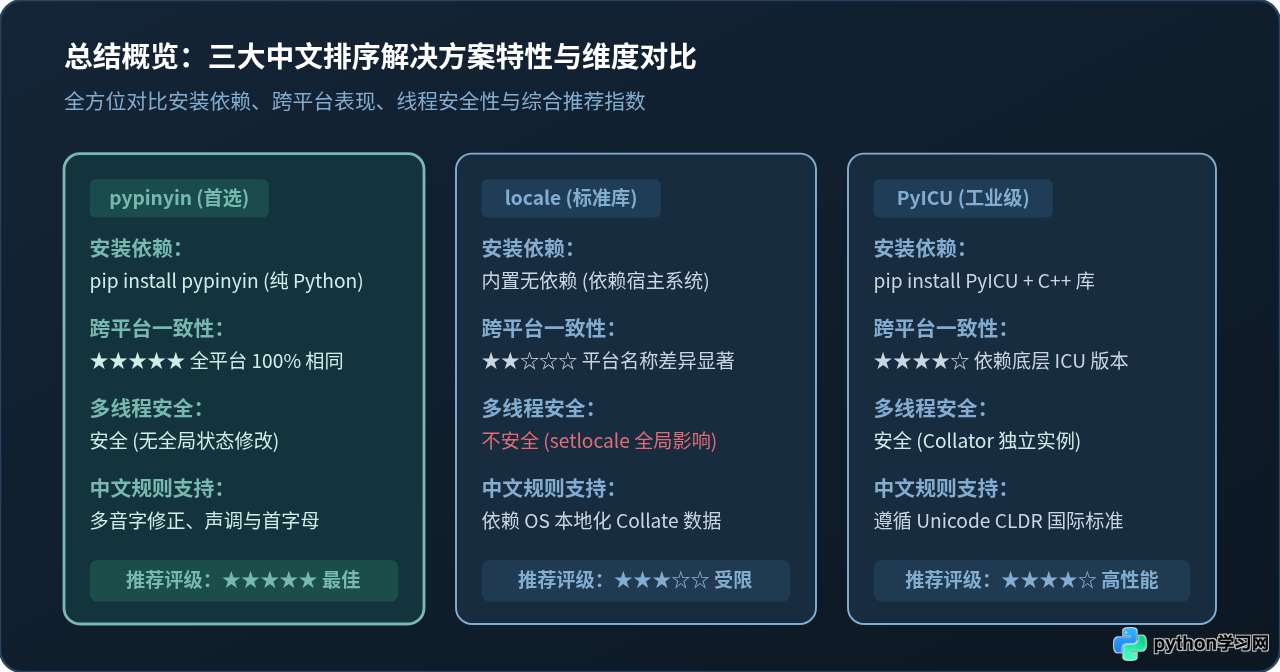
Python 中文字符串排序出现乱序是由于原生比较机制与自然拼音语意不匹配所致。解决的核心思想是“转换比较键(Key)”。下表与图示全面总结了三种核心解决方案的技术指标:
| 方案名称 | 依赖成本 | 跨平台一致性 | 线程安全性 | 典型适用场景 |
|---|---|---|---|---|
| pypinyin(首选) | 轻量第三方包(纯 Python) | 极佳(100% 一致) | 高(函数无全局状态) | 绝大多数 Web 服务、自动化脚本、数据分析 |
| locale(标准库) | 无(标准库内置) | 差(系统参数各异) | 低(修改进程全局 Locale) | 无法安装 pip 的严苛离线机器、小型单线程脚本 |
| PyICU(工业级) | 需安装 C++ ICU 动态库 | 优(统一依据 CLDR) | 高(独立 Collator 实例) | 超大规模海量文本、严苛多语言国际化系统 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









