

Python怎么用正则表达式验证邮箱和手机号格式
详细讲解在Python中使用re模块及正则表达式验证邮箱与手机号格式的实用方法,包含正则元字符拆解、输入清洗、完整可运行代码与常见边界处理技巧。
在 Python 开发中,验证用户输入的邮箱与手机号是否合法,是用户注册、表单提交和接口参数校验的基础操作。核心方案是导入内置的 re 模块,编写符合标准规则的正则表达式,并调用 re.fullmatch() 进行全字符比对。这种方式无需安装第三方依赖,执行效率高,能拦截绝大多数非法字符与乱码输入。
一、Python 正则验证的核心机制与方法选型
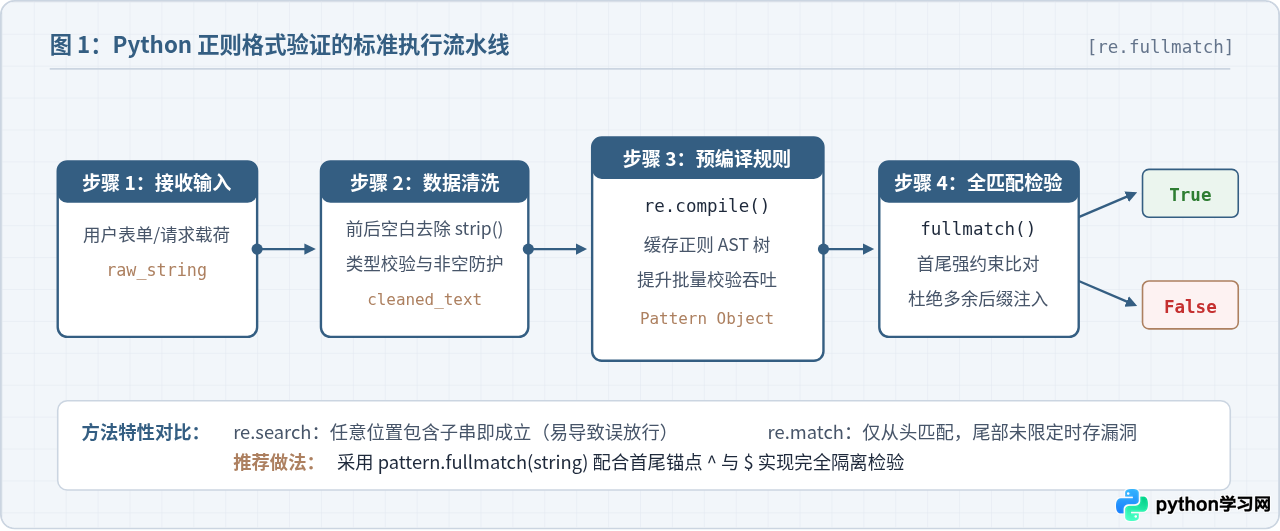
Python 标准库提供了内置的 re 模块处理正则匹配。但在验证字符串合法性时,初学者经常误用 re.search() 或 re.match(),从而产生安全隐患与逻辑遗漏。
- re.search(pattern, string):扫描整个字符串,只要任意子串符合正则即返回匹配对象。用于验证时,像
abc@example.com-suffix这种脏数据也会被判定为合法。 - re.match(pattern, string):仅从字符串的开头位置开始匹配,如果开头符合但末尾有多余字符,依然会判定成功(除非在正则末尾强行写上
$)。 - re.fullmatch(pattern, string):要求整个字符串从头到尾必须完整符合规则,不会因局部匹配而漏检多余字符,是最适合做输入格式校验的函数。
同时,如果程序需要在循环或高并发接口中多次校验输入,应当使用 re.compile() 将正则表达式提前编译为 Pattern 对象,从而复用编译缓存,减少每次匹配时的解析开销。
二、邮箱格式验证的正则表达式设计与实现
一个标准邮箱由三部分组成:本地用户名(Local-part)、分隔符 @ 和域名部分(Domain-part)。根据国际标准与现代互联网通用格式,合法邮箱需要满足以下特征:
- 本地用户名:可以包含大小写英文字母、数字,以及下划线
_、点.、加号+和连字符-。 - 分隔符:有且仅有一个字符
@。 - 域名部分:由二级域名(如
qq、gmail、github)和顶级域名(如com、cn、org、edu.cn)组成。二级域名允许字母、数字和连字符,顶级域名则至少为 2 位及以上的英文字母。
综合工业界常用规范,推荐使用如下生产级正则表达式:
^[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+$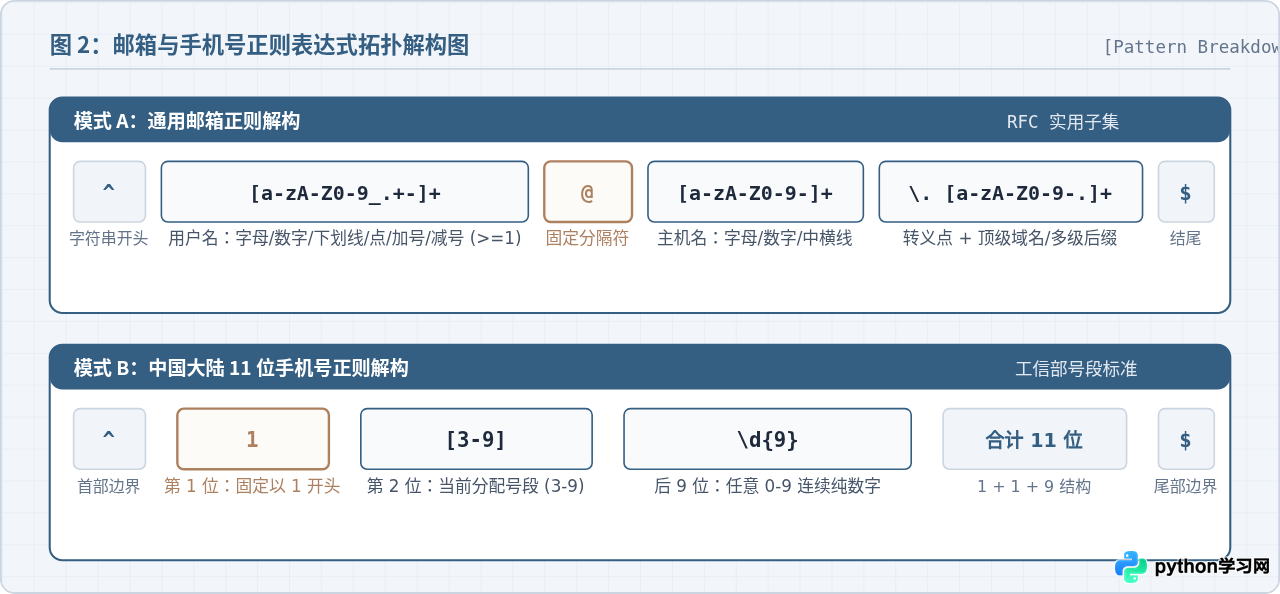
Python 邮箱验证完整代码示例
下面是一个标准的邮箱验证函数。函数首先检查输入参数是否为字符串类型并执行 strip() 去除首尾空白,随后使用预编译的正则对象调用 fullmatch():
import re

# 预编译邮箱正则表达式
EMAIL_PATTERN = re.compile(r'^[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+$')

def validate_email(email: str) -> bool:
    """
    验证邮箱字符串是否符合常规格式。

    参数:
        email: 待验证的邮箱地址
    返回:
        bool: 符合标准返回 True,否则返回 False
    """
    if not isinstance(email, str):
        return False

    cleaned_email = email.strip()
    if not cleaned_email:
        return False

    return EMAIL_PATTERN.fullmatch(cleaned_email) is not None

# 测试用例
if __name__ == "__main__":
    test_cases = [
        ("user@example.com", True),
        ("dev.ops_test+12@company-sub.domain.org", True),
        ("invalid..email@domain.com", True),       # 格式基本合法,能否送达需邮件协议交互
        ("user@domain", False),                    # 缺少顶级域名
        ("@domain.com", False),                    # 缺少用户名
        ("user@.com", False),                      # 域名主机缺失
        ("user@domain..com", False),               # 连续点号在很多场景不合法
    ]

    for email_str, expected in test_cases:
        res = validate_email(email_str)
        print(f"验证: {email_str:<40} 结果: {res} (预期: {expected})")
三、中国大陆手机号格式验证的设计与实现
根据工业和信息化部(MIIT)分配的手机号段规则,中国大陆手机号具有固定的形态特征:
- 总长度固定为 11 位纯数字。
- 第 1 位固定为 1。
- 第 2 位对应分配号段,当前为 3、4、5、6、7、8、9(即
[3-9])。目前 10、11、12 号段并未分配给民用手机。 - 后 9 位为 0-9 之间的任意数字(
\d{9})。
核心的基础手机号正则为:
^1[3-9]\d{9}$现实业务中的输入清洗需求
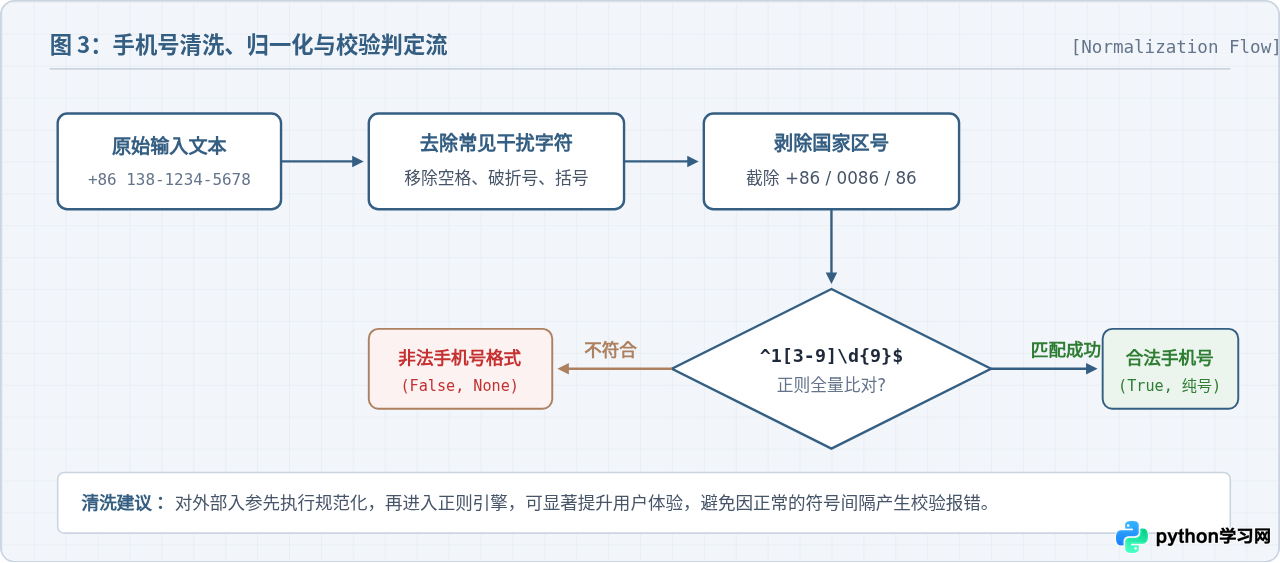
在实际网页或移动端输入中,用户输入的手机号可能包含形如 +86、0086、短横线 - 或空格(如 +86 138-0000-0000)。如果直接用纯正则判定,这类有效号码会被直接拒绝。因此,工业界通用流程是:先提取/去除合法前缀与分隔符,再对归一化后的纯数字进行正则验证。
Python 手机号验证完整代码示例
import re
from typing import Tuple, Optional

# 预编译 11 位手机号正则
PHONE_PATTERN = re.compile(r'^1[3-9]\d{9}$')

def validate_mobile_phone(phone: str, auto_clean: bool = True) -> Tuple[bool, Optional[str]]:
    """
    验证手机号是否为中国大陆合法的 11 位手机号。

    参数:
        phone: 待校验的原始手机号字符串
        auto_clean: 是否自动清除区号 (+86) 与常见分隔符 (- 或 空格)
    返回:
        (bool, Optional[str]):
            第 1 项为校验结果布尔值;
            第 2 项为成功时的纯 11 位数字字符串,失败时为 None。
    """
    if not isinstance(phone, str):
        return False, None

    cleaned = phone.strip()
    if not cleaned:
        return False, None

    if auto_clean:
        # 去除常见的分隔符号(破折号、空格、点)
        cleaned = re.sub(r'[\s\-.]', '', cleaned)

        # 去除中国国家区号前缀
        if cleaned.startswith('+86'):
            cleaned = cleaned[3:]
        elif cleaned.startswith('0086'):
            cleaned = cleaned[4:]
        elif cleaned.startswith('86') and len(cleaned) == 13:
            cleaned = cleaned[2:]

    # 使用 fullmatch 进行全量纯数字匹配
    if PHONE_PATTERN.fullmatch(cleaned):
        return True, cleaned

    return False, None

# 测试用例
if __name__ == "__main__":
    phones = [
        "13800138000",
        "+86 139-1234-5678",
        "0086 186 0000 1111",
        "12800138000",         # 错误:12 开头未分配
        "1380013800",          # 错误:只有 10 位
        "138001380000",        # 错误:有 12 位
        "19912345678",         # 正确:19 开头属于当前合法号段
        "13800138000abc"       # 错误:夹带字母
    ]

    for p in phones:
        is_valid, pure_num = validate_mobile_phone(p)
        print(f"输入: {p:<22} 合法性: {str(is_valid):<6} 提取结果: {pure_num}")
四、工程实战:封装通用输入验证器
在实际服务端项目(例如 Django、FastAPI 或 Flask)中,建议将邮箱和手机号校验逻辑封装为独立的校验工具类或函数集合。这样不仅便于统一维护业务规则,也能在单元测试中集中覆盖。
import re
from typing import Dict, Any

class FormValidator:
    """通用表单格式验证工具类"""

    # 预编译正则对象提高执行吞吐
    _EMAIL_RE = re.compile(r'^[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+$')
    _PHONE_RE = re.compile(r'^1[3-9]\d{9}$')

    @classmethod
    def check_email(cls, email: str) -> bool:
        if not isinstance(email, str):
            return False
        cleaned = email.strip()
        # 限制邮箱总长度(RFC 规定本地+域名最长 254 字符),防止超长字符串消耗正则回溯
        if len(cleaned) > 254 or not cleaned:
            return False
        return cls._EMAIL_RE.fullmatch(cleaned) is not None

    @classmethod
    def check_phone(cls, phone: str) -> bool:
        if not isinstance(phone, str):
            return False
        cleaned = re.sub(r'[\s\-.]', '', phone.strip())
        if cleaned.startswith('+86'):
            cleaned = cleaned[3:]
        elif cleaned.startswith('0086'):
            cleaned = cleaned[4:]
        return cls._PHONE_RE.fullmatch(cleaned) is not None

    @classmethod
    def validate_user_payload(cls, payload: Dict[str, Any]) -> Dict[str, Any]:
        """批量检测注册载荷"""
        errors = {}

        email = payload.get("email")
        if not email or not cls.check_email(email):
            errors["email"] = "邮箱格式不正确"

        phone = payload.get("phone")
        if not phone or not cls.check_phone(phone):
            errors["phone"] = "手机号码格式不正确"

        return {
            "is_valid": len(errors) == 0,
            "errors": errors
        }

# 运行验证示例
if __name__ == "__main__":
    sample_user = {
        "username": "zhangsan",
        "email": "zhangsan@tech-firm.com.cn",
        "phone": "+86 188-1234-5678"
    }

    check_result = FormValidator.validate_user_payload(sample_user)
    print("校验汇总结果:", check_result)
五、注意事项与常见陷阱
在实际落地时,应当重点关注以下几点:
-
不要追求 100% RFC 5322 全量邮箱正则:RFC 5322 允许带双引号的本地名称、甚至括号注释和 IP 域(如
"john..doe"@example.com)。用超复杂正则不仅严重拖慢性能,还容易引起 ReDoS(正则表达式拒绝服务攻击),实际上普通用户根本不会使用这类邮箱。 -
输入长度硬限制:在正则匹配之前,必须先检查
len(input_str)。例如邮箱限制最长不超过 254 字符,手机号限制不超过 20 字符。如果不限长度直接传给正则引擎,恶意用户可能传入几兆字节的畸形字符串消耗服务器 CPU。 -
手机号段的时效性:过去国内手机号只有 13、15、18 等号段,后来陆续开放了 14、16、17、19 号段。如果把正则写死为
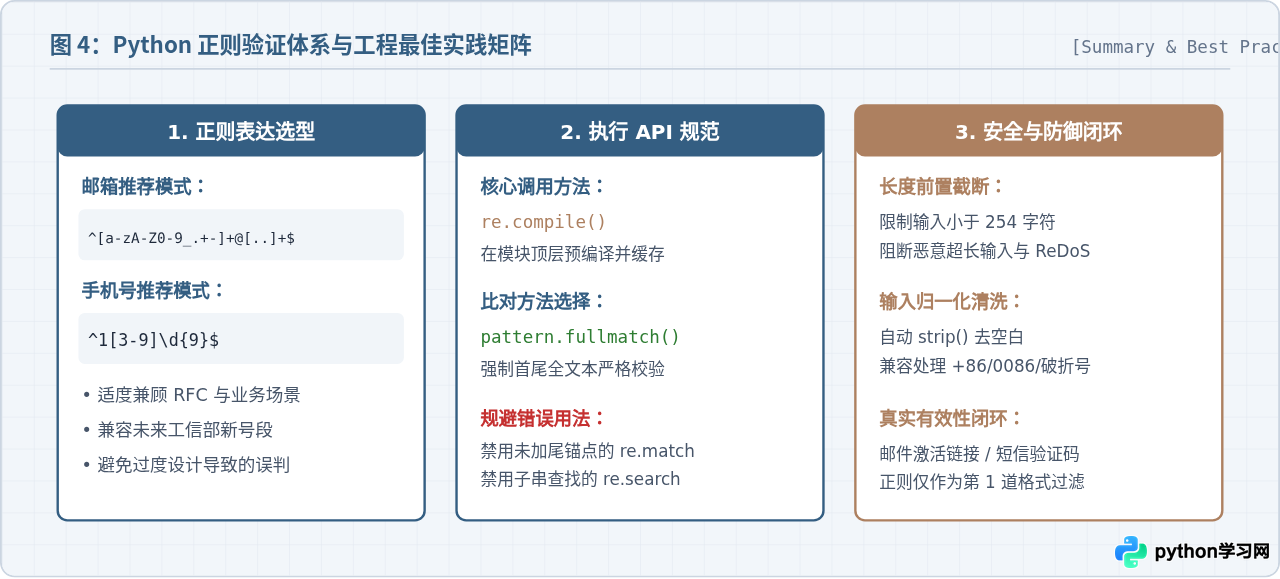
^1(3|5|8)\d{9}$,会导致新号段用户全部无法注册。使用^1[3-9]\d{9}$具有更好的未来兼容性。 - 最终真实性验证闭环:正则验证是第一道廉价过滤器;确认邮箱真实性必须通过“发送激活/验证邮件”,确认手机号真实性必须通过“短信验证码(SMS OTP)”。
六、总结
在 Python 中验证邮箱和手机号格式并不复杂,但要想写出兼具安全性与健壮性的生产级代码,关键在于把握三点:一是明确选用 re.fullmatch() 杜绝局部匹配漏洞;二是正则表达式的设计要符合工业主流,既不过度宽泛也不过度限制(如手机号使用 ^1[3-9]\d{9}$);三是在正则匹配前完成去空白、去区号等必要的预清洗,并将正则作为前端过滤器,配合验证邮件和短信验证码完成最终的身份核验闭环。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









