

pandas3.0和matplotlib3.11一起用有什么坑?
深入解析pandas 3.0与matplotlib 3.11协同使用时的典型兼容性陷阱,涵盖PyArrow类型冲突、非纳秒时间戳刻度偏移、Nullable缺失值断层及写时复制对绘图流程的影响与实用应对方案。
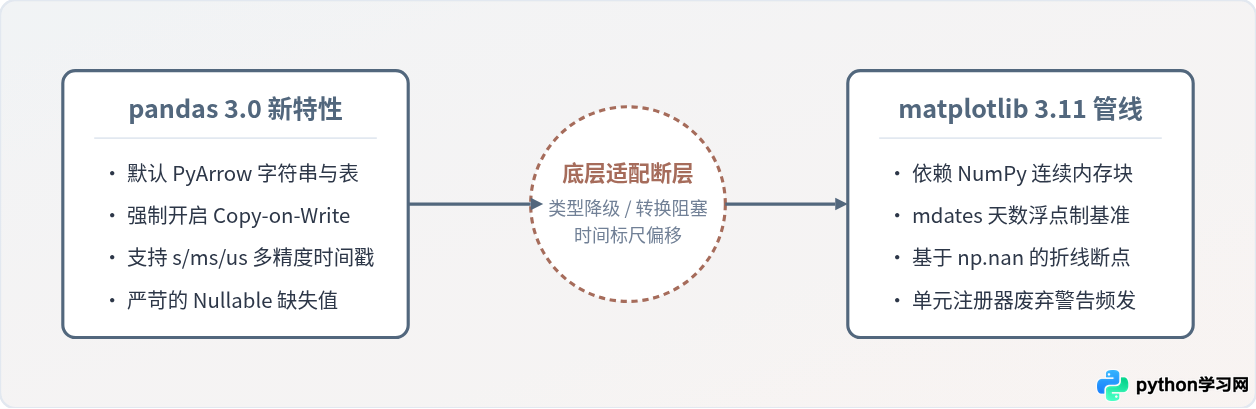
一、PyArrow 类型传参:从“静默兼容”到 TypeError 异常
在 pandas 2.x 时期,大多数用户的 DataFrame 仍然运行在 NumPy 对象数组或特定扩展类型之上;到了 pandas 3.0,字符串默认启用 PyArrow 引擎存储(string[pyarrow]),且更多整型和浮点列直接采用 Arrow 内存格式(如 int64[pyarrow])。
如果你按照旧习惯,直接将一个包含 PyArrow 字符串或 PyArrow 类别列的 Series 传入 matplotlib 的裸绘图接口:
import pandas as pd
import matplotlib.pyplot as plt

# pandas 3.0 中默认生成的字符串列为 pyarrow-backed
df = pd.DataFrame({
    'category': ['Alpha', 'Beta', 'Gamma'],
    'val': [12.5, 34.2, 28.1]
})

fig, ax = plt.subplots()
# 坑:在某些低级别 matplotlib 3.11 渲染接口中直接传参
ax.bar(df['category'], df['val'])
plt.show()
在部分极端场景下,你会遭遇 TypeError: float() argument must be a string or a real number, not 'pyarrow.lib.StringScalar',或者分类轴(Categorical Axis)标签全变成了空串或哈希码。这是因为 matplotlib 3.11 在调用底层 C 拓展进行单位转换(Unit Conversion)与坐标映射时,虽然支持了基本的 Python 序列协议,但当遇到 Arrow ChunkedArray 或带有内联掩码的 Arrow 标量时,无法自动将其解包为原生标量或 C 内存连续的 numpy.ndarray。
二、非纳秒时间戳支持:坐标轴被拉平或压缩数千倍
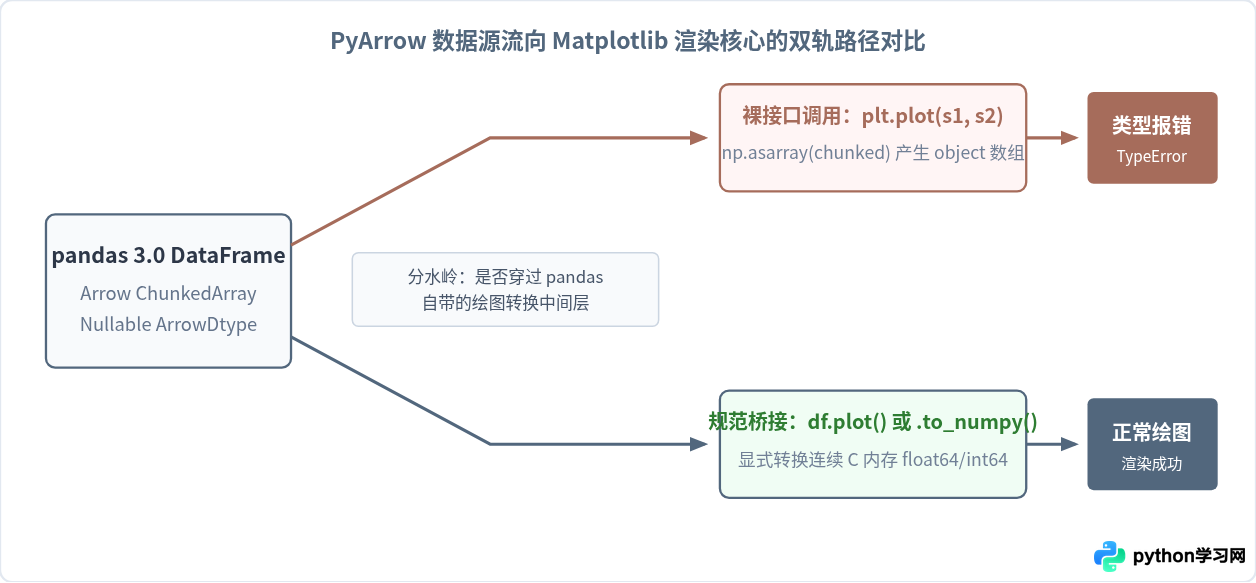
在过去,pandas 强制所有时间戳都必须是纳秒精度的 datetime64[ns],这使得支持的时间跨度只能在 1677 年到 2262 年之间。pandas 3.0 正式支持非纳秒单位:秒 s、毫秒 ms、微秒 us,以大幅降低内存占用并扩大年份范围。
然而,matplotlib 3.11 的时间定位器与格式化器(matplotlib.dates)内部完全是基于公元元年开始的“浮点天数”计算。两者的交互带来了以下两个显著隐患:
- 时间单位错位引起的极端缩放:当直接向
ax.plot()传入带有datetime64[ms]或datetime64[s]精度的 DatetimeIndex 或 Series 时,matplotlib 的隐式转换器如果未能准确识别单位精度,可能把整数时间戳直接当成浮点天数解析,导致绘制出来的折线缩在 1970 年初的某个单一点上,或者 X 轴标签格式化为1970-01-01。 - 废弃警告满屏:你可能频繁在终端看到
FutureWarning: Explicitly registering datetime converters with pandas is deprecated。在 pandas 3.0 中,旧式的register_matplotlib_converters()已经被视为遗留兼容层,强行调用反而会阻断 matplotlib 3.11 原生单位转换器的探测。
三、Nullable 缺失值(pd.NA)让折线图直接挂掉
在旧版基于 NumPy 的架构中,浮点数与大多数数值类型的缺失值都是标准的 IEEE 754 np.nan。matplotlib 对 np.nan 有极其成熟的内置规则:在绘制折线图时,遇到 np.nan 会主动断开线段(产生跳跃空隙),而不会使程序中断。
但在 pandas 3.0 的原生 PyArrow 类型或扩展整型(如 Int64)中,缺失值使用的是统一的单例对象 pd.NA。当这些列未经处理传给 matplotlib.pyplot.plot() 时:
import pandas as pd
import matplotlib.pyplot as plt

# pandas 3.0 推荐的 Arrow 整数类型
s = pd.Series([10, 20, None, 40, 50], dtype="int64[pyarrow]")

# 坑:matplotlib 3.11 尝试将其转换为 float 时,无法处理 pd.NA
plt.plot(s)
# 抛出异常:TypeError: float() argument must be a string or a real number, not 'NAType'
解决方法非常明确:在传给 matplotlib 底层前,使用 to_numpy(dtype=float, na_value=np.nan) 进行显式脱敏,将 pd.NA 替换回 matplotlib 能识别的 np.nan。
四、Copy-on-Write(CoW)锁死:就地微调(In-place)全面失效
数据可视化常常伴随临时的清洗动作,例如对准备绘图的切片列做均值填补、极值截断或重命名。在 pandas 3.0 之前,不少工程师习惯写出如下链式赋值或 inplace 修改代码:
# 旧版常见写法
sub_df = df[df['flag'] == 1]
# pandas 3.0 中引发 ChainedAssignmentError 或静默不生效
sub_df['plot_val'].fillna(0, inplace=True)
ax.plot(sub_df['plot_val'])
在 pandas 3.0 中,Copy-on-Write 已经成为硬性默认行为,且 inplace=True 在绝大多数序列操作中已被彻底废弃。对切片试图进行就地赋值会触发 ChainedAssignmentError,防止用户在不知情的情况下产生视图与副本的副作用。在编写结合 matplotlib 的绘图脚本时,必须规范化为显式的不可变对象衍生模式:
# 适配 pandas 3.0 的安全规范写法
sub_df = df[df['flag'] == 1].copy()
sub_df['plot_val'] = sub_df['plot_val'].fillna(0)
ax.plot(sub_df.index, sub_df['plot_val'].to_numpy())
五、排查与协同避坑四步标准流程
为了让 pandas 3.0 与 matplotlib 3.11 在生产环境及数据分析流水线中稳定共存,推荐遵循以下排查流程:
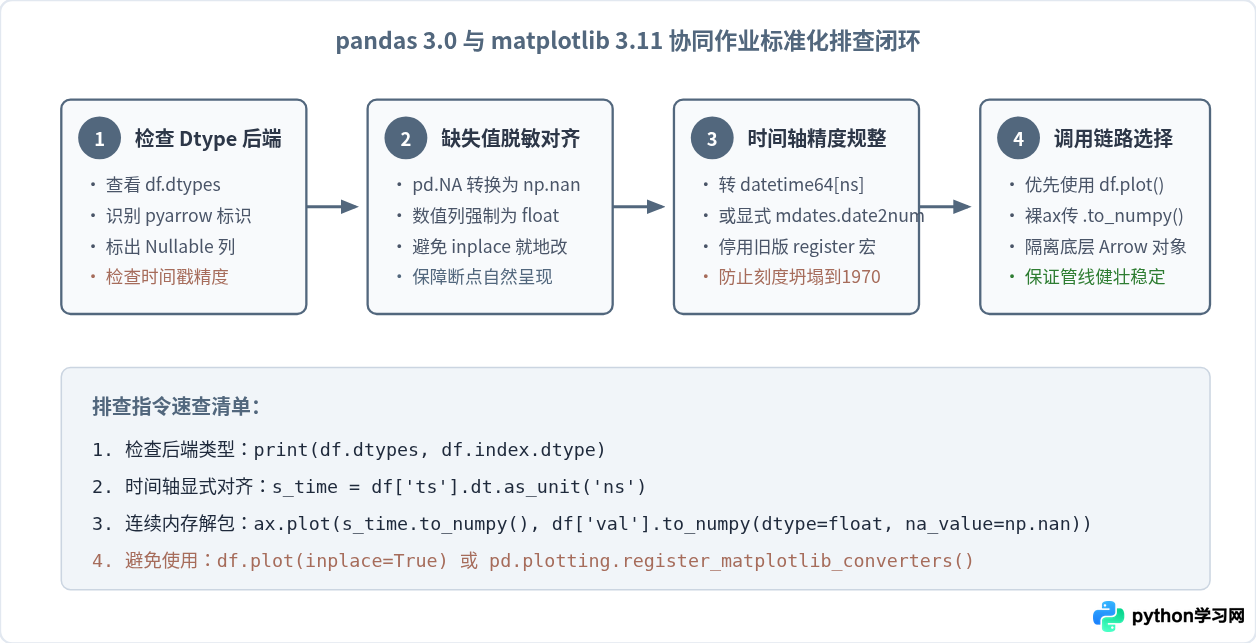
六、高频“踩坑”场景对照与避坑模式
下表提炼了在 pandas 3.0 与 matplotlib 3.11 配合编写生产级脚本时最容易触发的典型问题及推荐处理方式:
| 场景与现象 | 引发原因 | 错误写法(避开) | 推荐写法(建议) |
|---|---|---|---|
| PyArrow 字符串柱状图报 TypeError | matplotlib 3.11 底层单位注册器无法直接拆解 Arrow StringScalar。 | ax.bar(df['str_col'], df['val']) |
ax.bar(df['str_col'].to_numpy(dtype=str), df['val']) 或直接 df.plot.bar() |
| 非纳秒时间戳绘制全堆叠在 1970 年 | 毫秒/微秒时间戳被误当做以天为单位的浮点数,或者比例失调 10^6 倍。 | 直接将 datetime64[ms] 序列传给裸 ax.plot() |
使用 df['time'].dt.as_unit('ns') 或显式通过 matplotlib.dates.date2num() 传参。 |
| 带缺失值的整数列绘图抛出 NAType 错误 | Arrow Nullable 类型的 pd.NA 无法转换为标准浮点数。 |
plt.scatter(df['x'], df['arrow_int_with_na']) |
df['arrow_int_with_na'].to_numpy(dtype=float, na_value=np.nan) |
| 切片数据绘图前预处理报 ChainedAssignmentError | pandas 3.0 全面默认启用 Copy-on-Write,就地修改视图被严苛禁止。 | df[df.v > 0]['v'].fillna(0, inplace=True) |
clean = df[df.v > 0].copy(); clean['v'] = clean['v'].fillna(0) |
结语
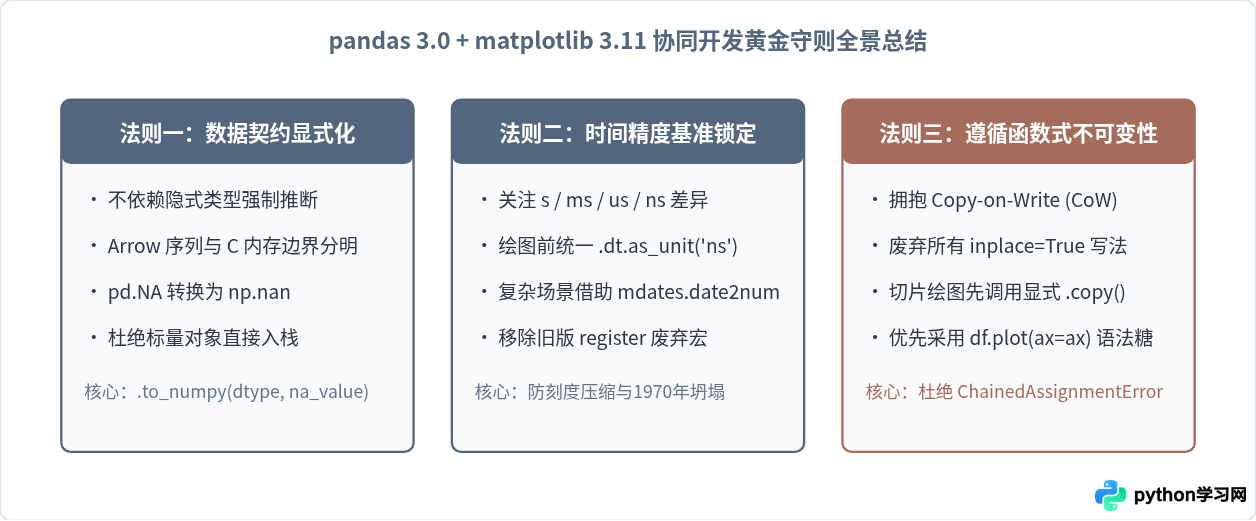
pandas 3.0 的核心进步在于用 PyArrow 和 Copy-on-Write 换取了更高的数据吞吐与更清晰的内存语义,而 matplotlib 3.11 则在持续优化绘图性能与通用数组协议支持。两者的结合点之所以容易产生“坑”,本质上是新旧内存布局与类型系统的碰撞。只要在编写可视化代码时守住“显式声明转换、统一时间单位、告别就地赋值”这三条准则,就能完全释放两个最新主版本的性能与表达力优势。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









