

Python计算两个时间点之间的毫秒差值
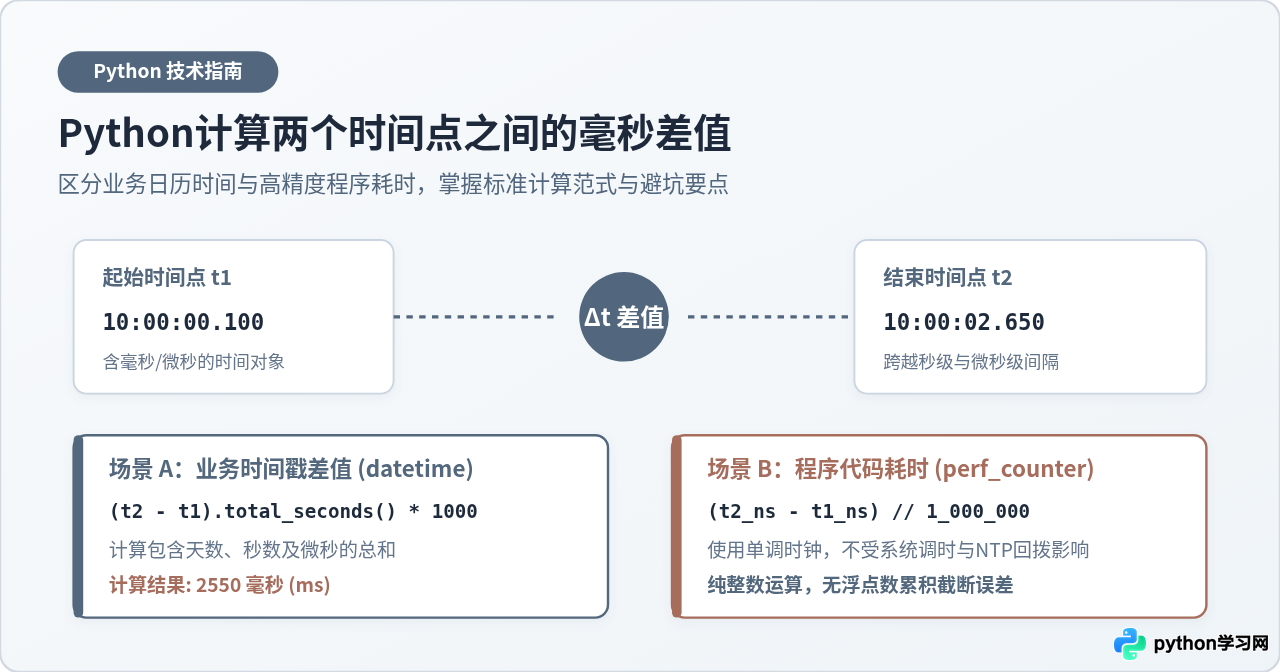
本文系统讲解在Python中计算两个时间点之间毫秒差值的标准方法。区分日历业务时间戳与程序性能耗时测量,深入解析timedelta结构避坑指南与高精度时钟选型,提供完整可运行代码。
datetime 对象相减,并通过 (t2 - t1).total_seconds() * 1000 换算总毫秒;如果是为了度量程序代码片段的执行耗时或基准测试,则必须选用单调硬件时钟 time.perf_counter_ns() // 1_000_000,从而彻底规避系统时钟跳变与浮点数精度损耗。
一、基于 datetime 对象的标准计算范式
在处理业务时间(如订单创建与支付时间、用户会话持续时长、接口请求时间戳)时,最常用的数据结构是标准库 datetime 模块中的 datetime 对象。当两个 datetime 对象进行减法运算时,Python 会自动返回一个 timedelta 对象。
1. 标准计算代码示例
获取两个具体时间点并求取整型毫秒差值的标准实现如下:
from datetime import datetime

# 定义两个包含微秒的时间点
t1 = datetime(2026, 10, 31, 10, 0, 0, 100000)  # 10:00:00.100 (含100毫秒)
t2 = datetime(2026, 10, 31, 10, 0, 2, 650000)  # 10:00:02.650 (含2秒650毫秒)

# 两个 datetime 对象相减,得到 timedelta 对象
delta = t2 - t1

# 通过 total_seconds() 换算为毫秒,并取整
diff_milliseconds = int(delta.total_seconds() * 1000)

print(f"时间跨度毫秒数: {diff_milliseconds} ms")2. 核心原理:为什么严禁直接使用 delta.microseconds?
初学者在查阅 timedelta 属性时,往往容易误选 delta.microseconds,并通过 delta.microseconds // 1000 来尝试获取毫秒数。这是一个极易引发线上事故的隐蔽陷阱。
在 Python 内部实现中,timedelta 仅维护三个属性:days(天数)、seconds(秒数,范围为 0 至 86399)以及 microseconds(微秒数,范围为 0 至 999999)。任何超出对应进位区间的差值都会自动进位到更高单位。
delta.microseconds 仅仅代表不足 1 整秒的那部分微秒碎末。例如两点相差 2.55 秒时,内部属性为 seconds = 2,microseconds = 550000。若只取 delta.microseconds // 1000,得到的将是 550 ms,而属于 seconds 的 2000 ms 将被完全丢弃!
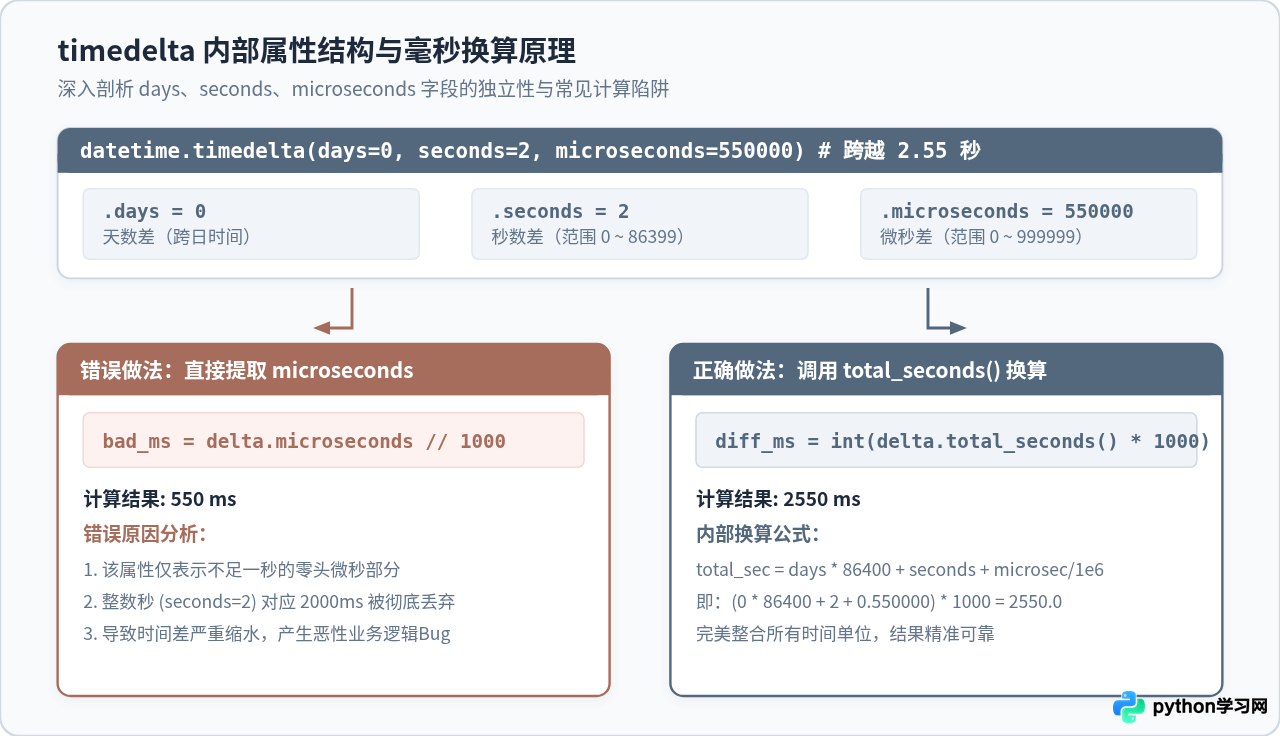
相比之下,方法 delta.total_seconds() 会把对象内部的全部字段严格按照数学逻辑聚合起来:
total_seconds = days * 86400 + seconds + (microseconds / 1000000.0)。将其结果乘以 1000 后,即可精确还原横跨天、秒、微秒的完整毫秒跨度。
二、时间字符串解析与流水线操作步骤
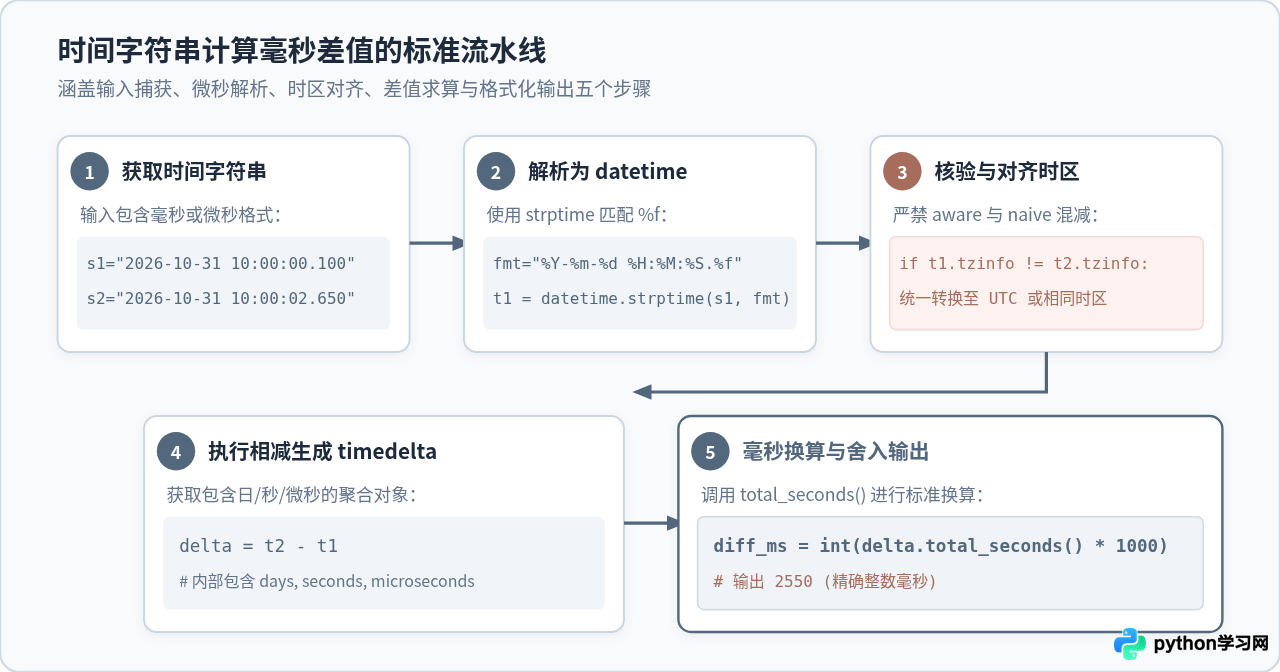
在实际项目开发中,时间点往往是以文本日志、HTTP 接口参数或数据库查询结果的形式存在的。要准确计算毫秒差,需要经历完整的字符串提取、格式化解析、时区对齐和差值输出流程。
完整操作步骤与代码实现
-
步骤一:获取并识别字符串格式
确认字符串中的毫秒或微秒格式。通常 ISO 8601 格式形如"2026-10-31T10:00:00.123+08:00",而常见日志格式形如"2026-10-31 10:00:00.123"。 -
步骤二:精确解析为 datetime 对象
若字符串符合标准 ISO 格式,可直接使用 Python 3.7+ 的datetime.fromisoformat()。若为自定义格式,需使用strptime并配置%f占位符匹配微秒部分(%f能兼容 1 到 6 位精度小数)。 -
步骤三:核对时区感知(Timezone-Aware)
如果一个时间点带时区信息(Aware),而另一个不带时区信息(Naive),两者相减会直接抛出TypeError: can't subtract offset-naive and offset-aware datetimes。必须统一转换为相同时区(如统一为 UTC)后再进行差值运算。 -
步骤四:执行作差并转换为毫秒
调用total_seconds() * 1000得到浮点毫秒,并根据业务需求决定是使用int()截断,还是使用round()遵循四舍五入。
from datetime import datetime, timezone

# 模拟接收到的两个时间字符串
str_start = "2026-10-31 10:00:00.100"
str_end = "2026-10-31 10:00:02.650"
time_format = "%Y-%m-%d %H:%M:%S.%f"

# 1. 格式化解析
t_start = datetime.strptime(str_start, time_format)
t_end = datetime.strptime(str_end, time_format)

# 2. 检查与统一时区(如均为 Naive,则显式赋予系统或UTC时区以保证健壮性)
t_start = t_start.replace(tzinfo=timezone.utc)
t_end = t_end.replace(tzinfo=timezone.utc)

# 3. 计算毫秒差
delta = t_end - t_start
ms_diff = int(delta.total_seconds() * 1000)

print(f"字符串解析计算结果: {ms_diff} ms")三、代码执行耗时测量:为什么切忌使用 datetime?
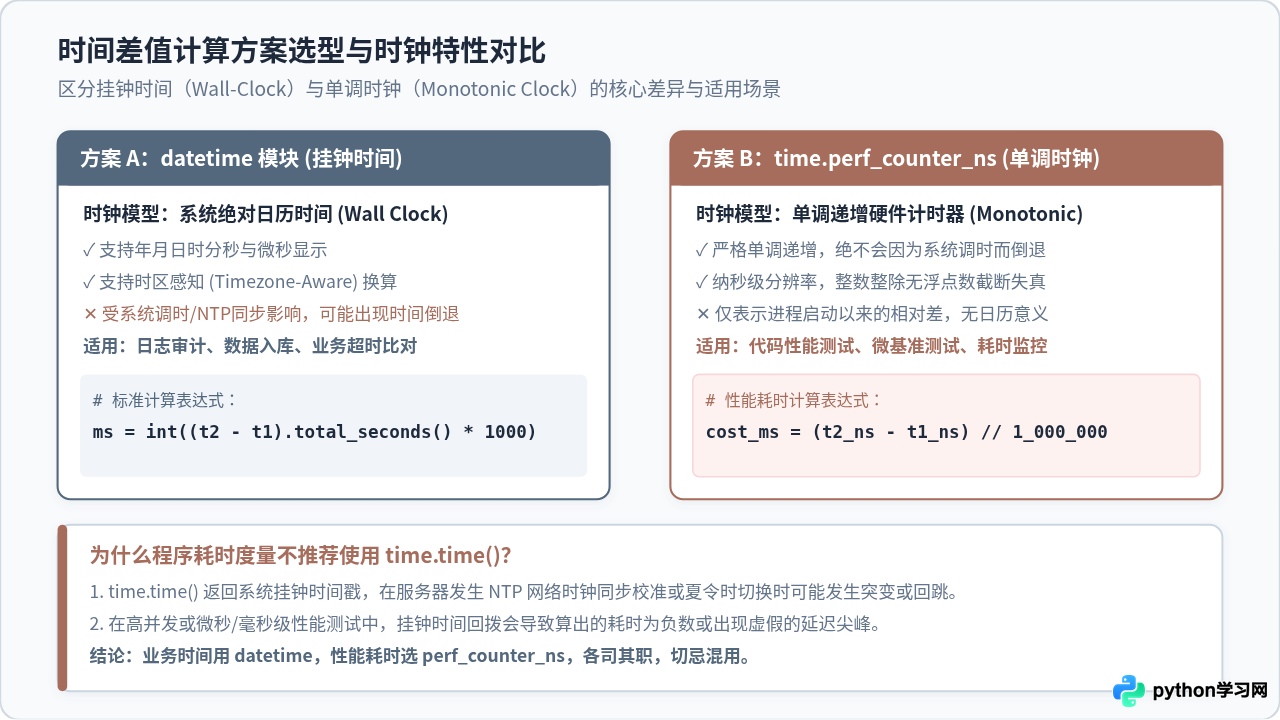
如果计算时间差的目的是统计一段 Python 代码的运行性能、接口响应耗时或算法执行开销,那么使用 datetime.now() 甚至 time.time() 都是不稳健的设计。
datetime.now() 和 time.time() 属于系统挂钟时间(Wall-Clock Time)。挂钟时间反映的是现实生活中的日历与时钟,它会受到操作系统的网络时间协议(NTP)对时校准、管理员手动调整时钟或闰秒微调的影响。在两次采样的微小间隙中,一旦触发了时钟回退,算出的差值可能会变成负数,从而导致监控系统报警或逻辑异常。
高精度耗时推荐方案:time.perf_counter_ns()
对于性能基准测试与代码块耗时,Python 官方推荐使用单调时钟 time.perf_counter() 或其整数纳秒版本 time.perf_counter_ns()。
- 单调性保障:无论系统时钟如何调整,该时钟的值永远单调递增,绝不会发生时间倒流。
- 硬件高分辨率:调用底层 CPU 高精度计数器,时间精度达纳秒级别。
- 零浮点误差:使用
perf_counter_ns()返回纯整数纳秒,通过// 1_000_000进行整除即可直接得到不带浮点累积误差的整数毫秒。
import time

# 记录代码开始执行时的单调纳秒刻度
start_ns = time.perf_counter_ns()

# 模拟被测代码段(如数据运算或处理任务)
time.sleep(0.05)  # 休眠 50 毫秒

# 记录结束刻度
end_ns = time.perf_counter_ns()

# 纯整数运算获取毫秒耗时
elapsed_ms = (end_ns - start_ns) // 1_000_000

print(f"代码段执行耗时: {elapsed_ms} ms")四、常见问题排查与注意事项
在毫秒差值的计算与落地过程中,开发者通常还会遇到以下几种边缘情况,需根据业务规则针对性处理:
1. 时间先后顺序不确定产生负值
当从异步消息队列或并发请求中收集时间戳时,接收顺序可能颠倒。若业务仅关注“时间跨度的绝对大小”,应主动使用内置函数 abs() 进行包装:
abs_ms = abs(int((t2 - t1).total_seconds() * 1000))。
2. Unix 时间戳直接作差
如果外部系统已经提供了以秒为单位的浮点 Unix 时间戳(如 1730332800.123),则完全无需先反序列化为 datetime 对象再相减,直接进行数值作差并乘以 1000 即可显著提升处理吞吐量:
diff_ms = int((ts2 - ts1) * 1000)。如果上游给出的是 13 位毫秒级时间戳,则直接做整数减法即可。
五、总结
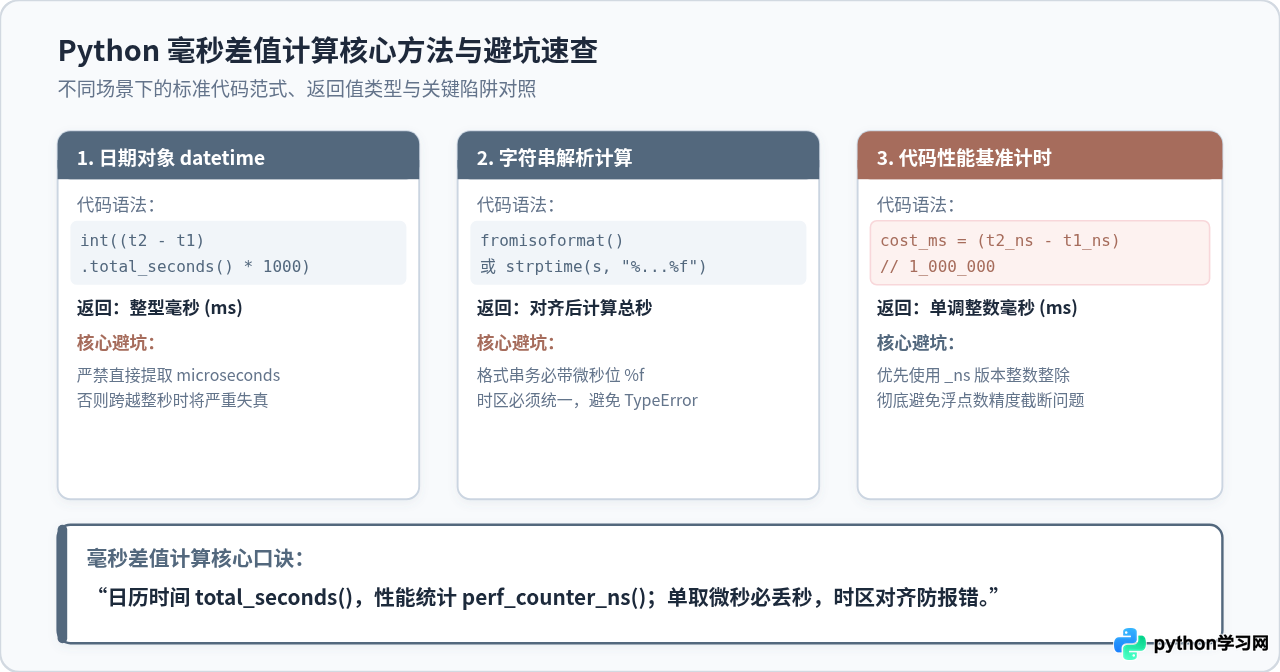
计算两个时间点之间的毫秒差值,技术实现并不繁琐,但核心在于选对工具与理解数据模型。处理日历、日志与业务数据时,使用 datetime 作差并始终通过 total_seconds() * 1000 聚合计值,坚决避开仅反映微秒碎末的 delta.microseconds;度量程序耗时与性能基准时,果断切换至硬件级单调时钟 time.perf_counter_ns()。遵循这套标准模式,能够保证代码在各类高并发、跨时区及复杂运维环境下的长期准确与稳健。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









