

Kimi API常见错误码排查:鉴权失败、速率限制与超时解决方案
针对 Kimi (Moonshot AI) API 调用过程中最常遭遇的 401/403 鉴权与权限失败、429 速率与并发限制、以及 408/504 请求超时等核心异常,提供系统化的排查路径、根因剖析、完整代码示例与生产级防御方案。
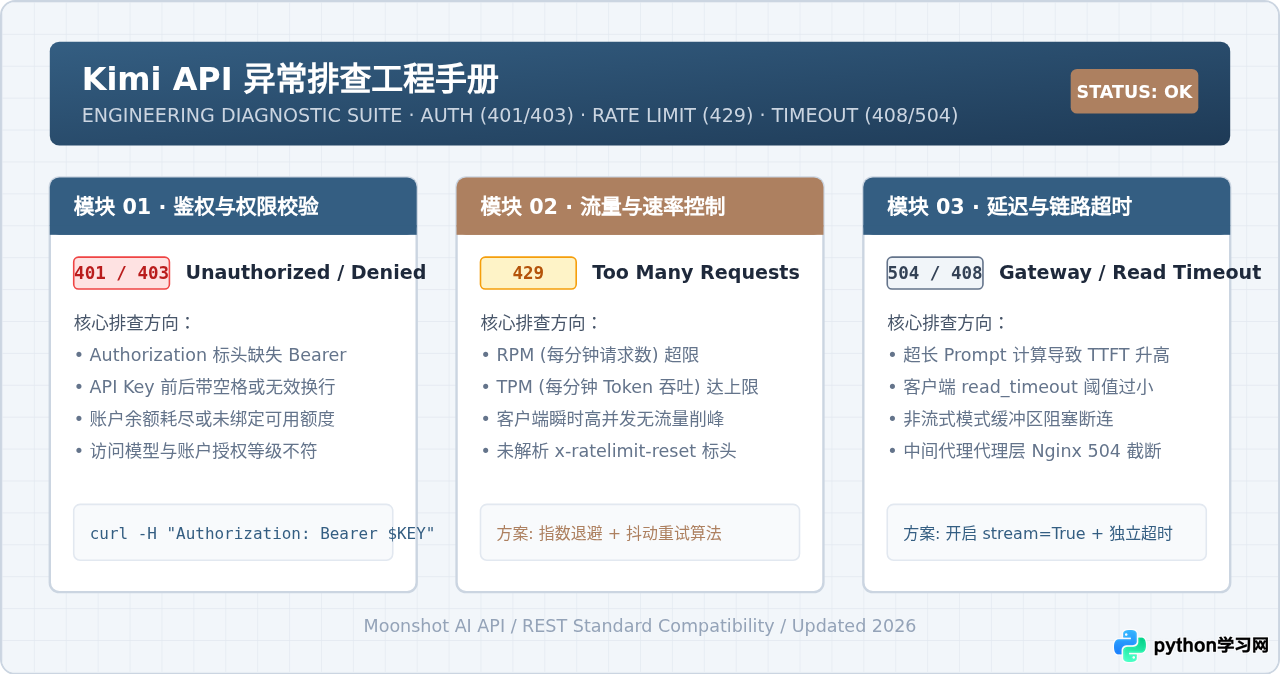
在接入和使用 Kimi(Moonshot AI)大模型 API 时,开发者最常遇到的异常集中在三类:凭据与权限不通过导致的 401/403 鉴权失败、高频调用或大吞吐触发的 429 速率限制,以及长上下文推理等待引发的 408/504 与客户端 ReadTimeout 超时。本文将围绕这三类高频阻断性问题,提供从底层错误原因、单点最小隔离测试、生产环境配置规范到自动化重试代码的完整解决路径,帮助工程团队快速定位根因并建立高可用的调用防御机制。
一、错误诊断快速切入与状态码判定
排查 Kimi API 调用的第一步,是明确异常发生的网络层级。Kimi 提供了标准兼容的 RESTful 接口,所有错误均会返回标准的 HTTP 状态码以及包含详细错误说明的 JSON 响应体。当程序报错时,切忌盲目修改代码,应首先检查 HTTP 响应状态码及响应体中的 type 与 message 字段。
Kimi API 返回的错误结构体通常符合如下格式:
{
  "error": {
    "message": "Invalid Authentication header. Bearer token is missing or malformed.",
    "type": "invalid_request_error",
    "param": null,
    "code": "invalid_api_key"
  }
}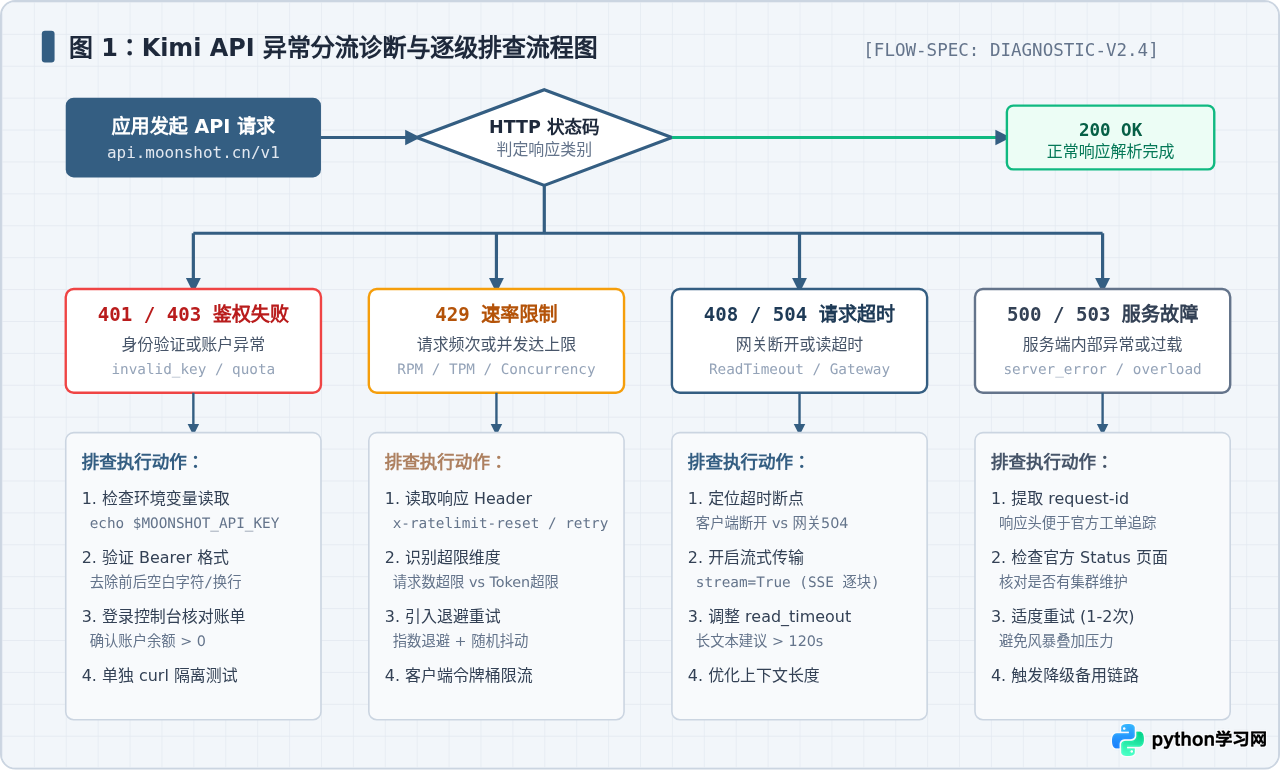
按照图 1 所示的排查主干,快速判定原则如下:
- 401 Unauthorized:凭证识别失败,说明请求在接入网关处未通过有效性检查,直接检查 Key 字符串完整性与 Bearer 格式。
- 403 Forbidden:凭证合法,但账户状态或权限受限,通常是账户未充值、余额欠费耗尽或所请求的模型尚未开通授权。
- 429 Too Many Requests:触发了服务端的流量保护配额,需根据返回头信息区分是 RPM(每分钟请求数)还是 TPM(每分钟 Token 数)超限。
- 408 / 504 / ReadTimeout:网络链路中断或推理耗时超出超时等待阈值,需通过流式传输(SSE)与参数分级超时进行解耦。
- 500 / 503 Internal Server Error:Kimi 服务端算力集群临时调度抖动,应记录
x-request-id并执行带退避的有限重试。
二、鉴权失败排查:401 与 403 错误根因与修复
鉴权失败(Authentication Failure)是大模型接入初期的第一道屏障。虽然报错常表现为简单的“拒绝访问”,但 401 与 403 在底层机制上具有严格的区别。
1. 401 Unauthorized 典型根因与排查步骤
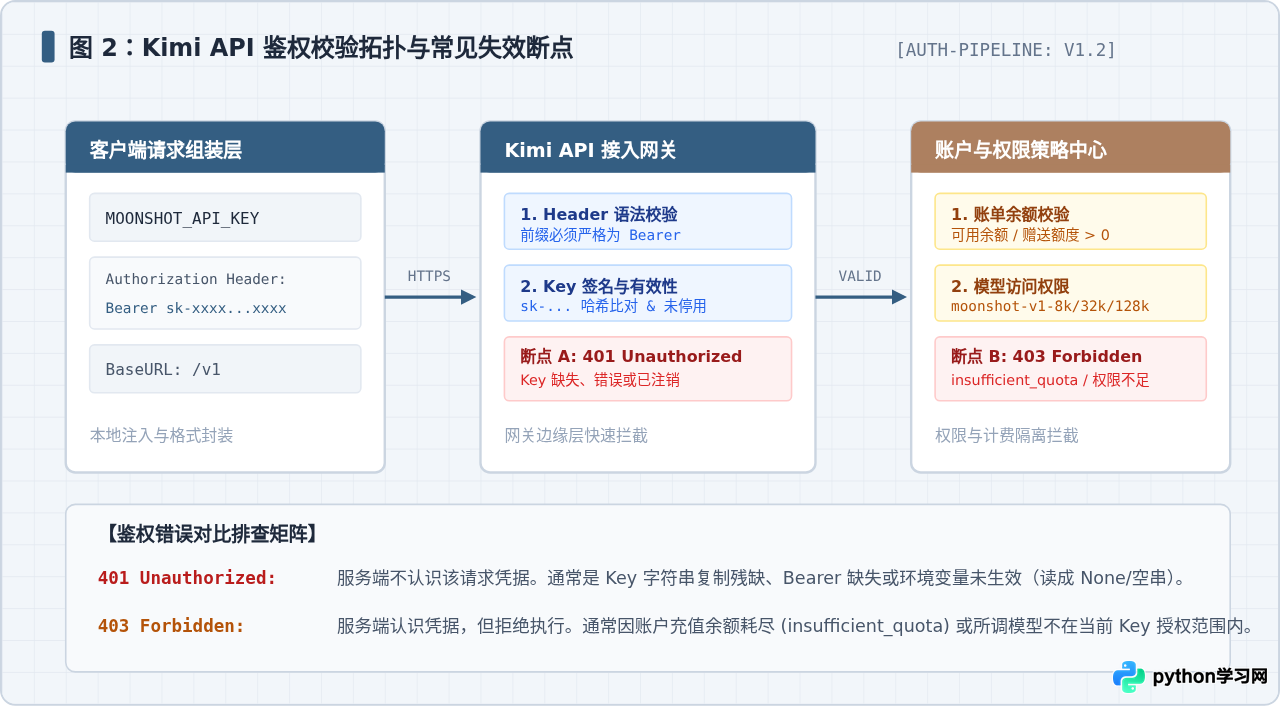
401 错误发生于 API 接入网关的边缘验证阶段(图 2 断点 A),意味着网关无法识别请求中的身份标识。常见根因包括:
- 请求头格式缺少
Bearer前缀:Kimi 强制要求 HTTP Header 中的 Authorization 字段遵循 Bearer 规范。若写成Authorization: $KEY或拼写为token $KEY,均会触发 401。 - Key 包含不可见的空白字符:在文本编辑器或控制台复制 API Key 时,若误选了前缀空格、尾部换行符(
\r\n),会导致哈希校验直接失败。 - 环境变量未正确加载:应用启动时未执行
source .env或进程权限不足,导致os.environ.get("MOONSHOT_API_KEY")取出的是空字符串""或None。 - API Key 已在控制台被删除或撤销:密钥已被停用或废弃。
当本地程序持续报 401 时,首要动作是脱离复杂的 SDK 和框架,在终端执行以下基础 curl 命令。如果 curl 能返回正常数据,说明密钥完全有效,问题必然出在应用层的变量加载或 Header 拼装上:
curl -X POST https://api.moonshot.cn/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer sk-YourActualApiKeyHere" \
  -d '{
    "model": "moonshot-v1-8k",
    "messages": [{"role": "user", "content": "ping"}],
    "max_tokens": 10
  }'
2. 403 Forbidden 典型根因与排查步骤
与 401 不同,403 表示网关已成功识别你的 API Key,但鉴权中心与计费策略引擎拒绝了本次请求(图 2 断点 B)。在 Kimi API 中,最典型的 403 场景是余额耗尽与模型未授权:
- 报错
insufficient_quota:账户在 Moonshot 开放平台的充值余额已耗尽,或者赠送的代金券已过期。即使 API Key 本身有效,系统也会拦截任何新的推理扣费请求。 - 报错
model_not_found或permission_denied:调用的模型名称拼写错误,或者该 API Key 没有被分配访问长上下文模型的权限(例如误传了不存在的模型名)。当前官方主要模型为moonshot-v1-8k、moonshot-v1-32k、moonshot-v1-128k。
修复验证:登录 Moonshot 开发者控制台,进入“财务中心”检查可用额度;进入“API Key 管理”核对当前使用的 Key 是否属于当前账户。完成充值后,通常数秒内额度自动同步刷新。
3. 生产环境安全注入与代码规范
在 Python 代码中,应杜绝明文硬编码 API Key。推荐采用如下具备健壮性防御的初始化模式:
import os
import sys
from openai import OpenAI

def get_kimi_client() -> OpenAI:
    api_key = os.environ.get("MOONSHOT_API_KEY", "").strip()
    if not api_key:
        sys.exit("【致命错误】环境变量 MOONSHOT_API_KEY 未设置或为空,请先配置后重试。")
    if not api_key.startswith("sk-"):
        sys.exit("【格式警告】MOONSHOT_API_KEY 格式疑似异常,标准密钥通常以 'sk-' 开头。")

    # Kimi API 完全兼容 OpenAI 客户端协议,但必须指定 base_url
    client = OpenAI(
        api_key=api_key,
        base_url="https://api.moonshot.cn/v1"
    )
    return client
三、速率限制排查:429 Too Many Requests 应对机制
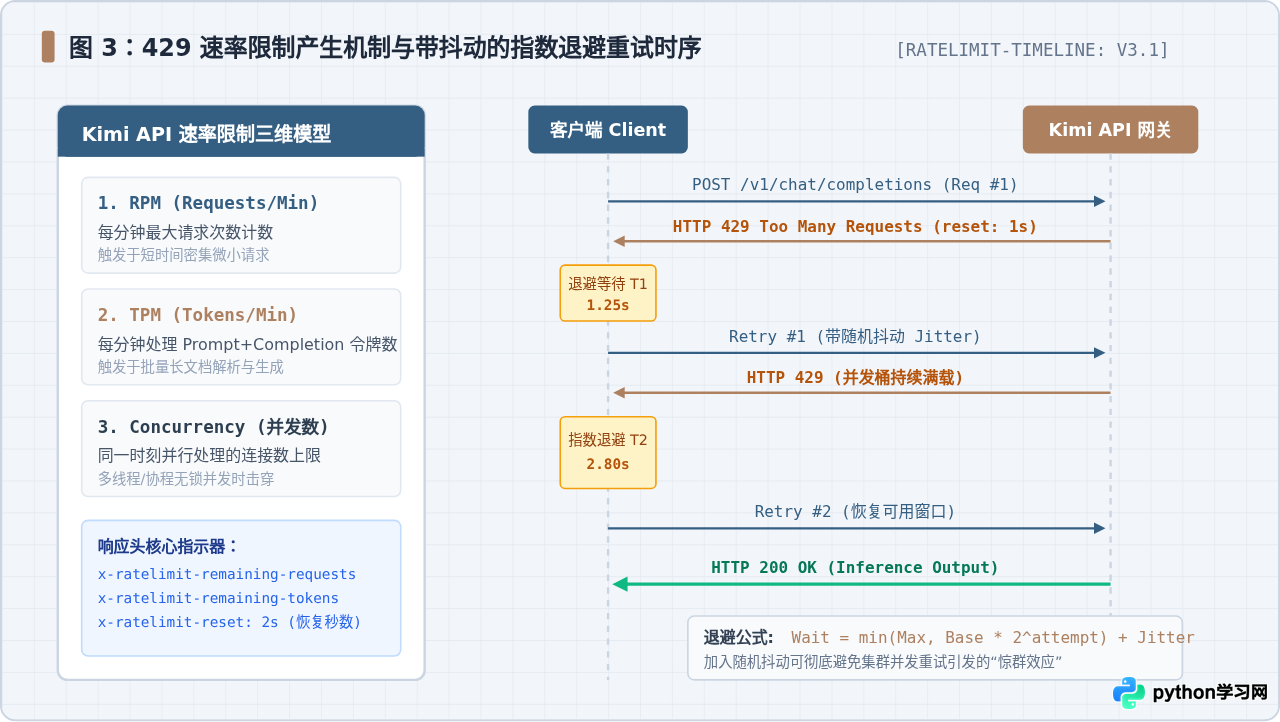
当客户端请求频次或吞吐规模超过账户所处层级(Tier)的配额时,服务端将返回 HTTP 状态码 429 Too Many Requests。对于大模型接口,429 并非单纯指“请求数量太多”,而是受到三维限制矩阵的综合制约。
1. 深入理解 429 的三维触发维度
如图 3 所示,Kimi API 的限流由三个独立计数器控制:
- RPM (Requests Per Minute):每分钟请求次数。即使用户每次只发送一个词,只要一分钟内发起的 HTTP 请求总数超限,即触发 RPM 拦截。
- TPM (Tokens Per Minute):每分钟 Token 吞吐量。它统计的是
输入 Prompt Tokens + 输出 Completion Tokens的总和。在长文本分析场景下(例如一次传入 20,000 字),即便只发了 2 个请求,也可能直接打满 TPM 限额。 - Concurrency(并发连接数):同一时刻服务端正在处理的请求连接数。若客户端采用多线程或未受控的协程并发冲击接口,极易触发并发溢出。
2. 解析响应头中的限流指示器
当收到 429 响应时,Kimi 会在 HTTP Response Header 中返回关键的配额恢复时间。常见标头包括:
| 标头字段 (Header) | 含义解释 | 代码应对策略 |
|---|---|---|
x-ratelimit-remaining-requests |
当前周期内剩余的请求配额 (RPM) | 数值接近 0 时主动在客户端降低派发速率 |
x-ratelimit-remaining-tokens |
当前周期内剩余的 Token 配额 (TPM) | 不足以支撑长文本时排队暂缓发送 |
x-ratelimit-reset-requests |
RPM 配额重置倒计时(秒) | 指导重试线程进入对应时长的睡眠 |
retry-after |
建议等待的休眠时间(秒) | 最直接的退避依据,优先取此值作为等待基础 |
3. 生产级解决方案:带随机抖动的指数退避重试 (Full Jitter Backoff)
遇到 429 时,绝对不能使用固定间隔(如 time.sleep(1))无脑重试。因为当多个请求同时遭遇 429 时,固定间隔重试会导致所有客户端在同一时刻再次冲击服务端,形成“惊群效应”(Thundering Herd),导致系统持续处于雪崩状态。
标准解法是结合指数退避(Exponential Backoff)与随机抖动(Jitter)。重试间隔公式为:
WaitTime = min(MaxWait, BaseWait × 2attempt) + uniform(0, Jitter)
以下是具备自适应重试与错误捕获的生产级封装示例:
import time
import random
import logging
from openai import OpenAI, RateLimitError, APIError

logging.basicConfig(level=logging.INFO)
logger = logging.getLogger("kimi_worker")

def call_kimi_with_retry(client: OpenAI, messages: list, model: str = "moonshot-v1-8k", max_retries: int = 5):
    base_delay = 1.0   # 基础退避时间(秒)
    max_delay = 32.0   # 最大等待封顶(秒)

    for attempt in range(max_retries):
        try:
            response = client.chat.completions.create(
                model=model,
                messages=messages,
                temperature=0.3
            )
            return response.choices[0].message.content

        except RateLimitError as e:
            # 捕获 429 速率限制错误
            if attempt == max_retries - 1:
                logger.error(f"429 重试达上限 ({{max_retries}} 次),抛出异常: {{e}}")
                raise

            # 计算指数退避时间 + 均匀抖动
            exponential_delay = min(max_delay, base_delay * (2 ** attempt))
            jitter = random.uniform(0.1, 1.0)
            sleep_time = exponential_delay + jitter

            logger.warning(f"[429 触发] 正在执行第 {{attempt + 1}}/{{max_retries}} 次重试,将在 {{sleep_time:.2f}} 秒后重试...")
            time.sleep(sleep_time)

        except APIError as e:
            # 其他非 429 异常(如 500、503)按需决定是否重试
            if e.status_code in [500, 503] and attempt < max_retries - 1:
                sleep_time = 2.0 + random.uniform(0.1, 0.5)
                logger.warning(f"[{{e.status_code}} 服务端抖动] 等待 {{sleep_time:.2f}}s 后重试...")
                time.sleep(sleep_time)
            else:
                raise
四、请求超时排查:408、504 与客户端 ReadTimeout 解决方案
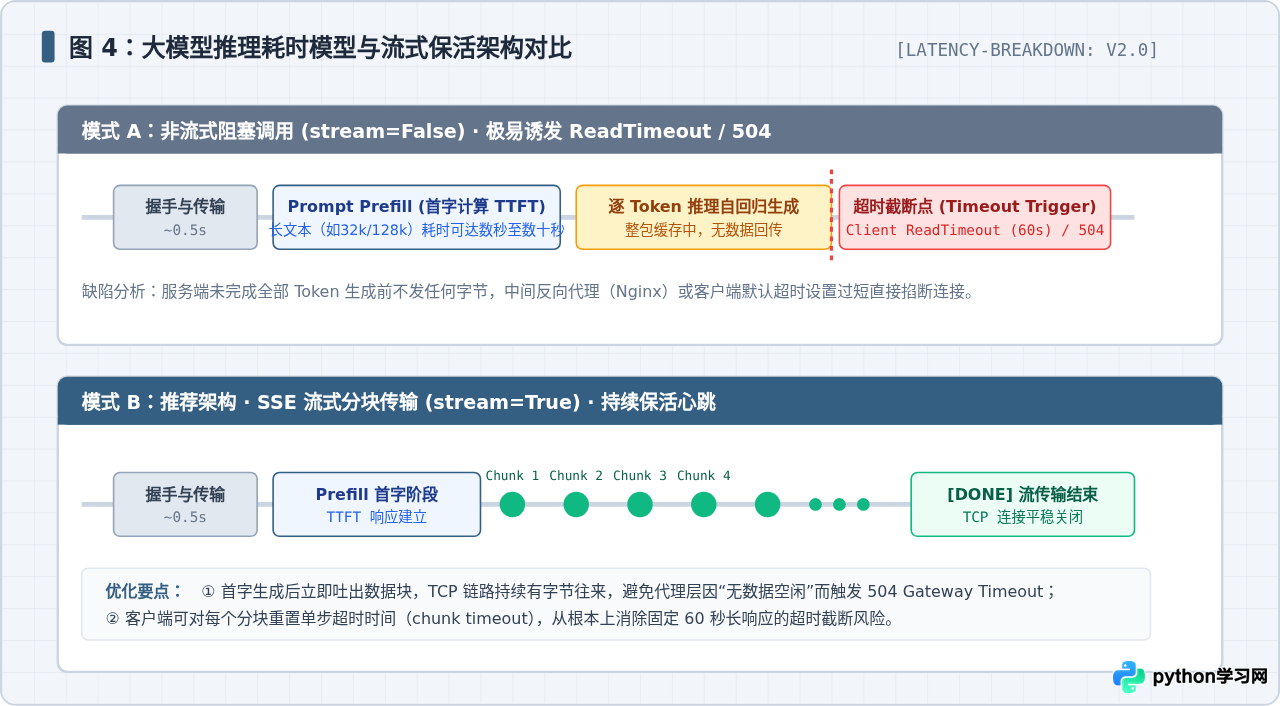
大模型服务与传统 Web 服务存在本质差异:大模型需要执行耗时的计算(Prompt Prefill 矩阵相乘与自回归 Decode 逐字生成)。长上下文输入往往需要数秒乃至数十秒才能产出第一个 Token。如果超时控制配置不当,极易出现超时截断。
1. 剖析超时的两个源头:客户端与网关
排查超时前,首先明确是哪一方主动掐断了 TCP 连接:
- 客户端 ReadTimeout:客户端 HTTP 库(如 Python
httpx、requests)在发出 HTTP 请求后,如果在指定的timeout秒数内没有收到服务端返回的任何一个字节,本地直接抛出httpx.ReadTimeout。默认情况下许多库的超时阈值仅为 5 秒到 30 秒,对于 32k/128k 长文档推理而言显然过短。 - 网关 504 Gateway Timeout:服务链路中的反向代理服务器(如公网 Nginx、云负载均衡器 ALB)具有内部代理读取超时(
proxy_read_timeout,通常设为 60 秒)。若服务端 LLM 算力节点在 60 秒内未回传数据包,网关层会强制切断上游连接并向客户端返回 504。
2. 核心解决方案 A:启用 SSE 流式传输(stream=True)
如图 4 下半部分所示,解决超时最有效的方法是将非流式同步调用改为Server-Sent Events (SSE) 流式传输。
在非流式模式下,服务端必须等待全部几千个 Token 生成完毕后才开始通过 HTTP 响应发送数据包,整个耗时期间链路没有任何字节传输,极易触发超时。而开启 stream=True 后,只要模型完成了 Prompt Prefill 并计算出第一个 Token(TTFT, Time to First Token),服务端就会立即向客户端推送数据分块(Chunk)。后续每个 Token 都是一个独立的数据包,这不仅使得客户端能实时看到输出,更让 TCP 连接持续保持“活跃心跳”,从而绕过任何网关的空闲截断机制。
3. 核心解决方案 B:区分 Connect 与 Read 超时配置
在客户端初始化中,切忌使用过小的单一超时值。应将握手连接超时(Connect Timeout)与数据读取超时(Read Timeout)分离:
- Connect Timeout(连接超时):设为 5.0 ~ 10.0 秒。如果 10 秒内连不上 Kimi 网关,说明存在 DNS 解析故障或跨地域网络阻断,应立即失败报警。
- Read Timeout(读取超时):在非流式长文本调用中应放宽至 120.0 ~ 300.0 秒;在流式调用中,该值代表“两个相邻 Token 分块之间的最大允许间隔”,设为 60.0 秒即可提供极高安全性。
以下为在 Python 中通过 OpenAI 官方 SDK 正确配置超时与流式消费的完整模式:
import os
from openai import OpenAI
import httpx

# 明确配置连接与读超时时间
custom_http_client = httpx.Client(
    timeout=httpx.Timeout(
        connect=10.0,    # TCP 连接与 TLS 握手最大等待 10s
        read=180.0,      # 数据读取等待 180s(满足超长文本计算)
        write=10.0,      # 请求体发送等待 10s
        pool=30.0        # 连接池获取等待 30s
    )
)

client = OpenAI(
    api_key=os.environ.get("MOONSHOT_API_KEY", "").strip(),
    base_url="https://api.moonshot.cn/v1",
    http_client=custom_http_client
)

def stream_kimi_response(prompt: str):
    print("【正在建立连接并等待首字生成...】")
    try:
        response_stream = client.chat.completions.create(
            model="moonshot-v1-32k",
            messages=[
                {"role": "system", "content": "你是一名精通分布式系统架构的技术专家。"},
                {"role": "user", "content": prompt}
            ],
            stream=True,         # 必须启用流式传输以防止 504 断连
            temperature=0.3
        )

        full_content = []
        for chunk in response_stream:
            if chunk.choices and chunk.choices[0].delta.content:
                text_piece = chunk.choices[0].delta.content
                full_content.append(text_piece)
                print(text_piece, end="", flush=True)  # 实时打印逐块内容

        print("\n\n【流式接收完成】")
        return "".join(full_content)

    except httpx.ReadTimeout:
        print("\n【超时警告】服务端超过指定时间未推送新 Token 分块,请检查网络或放宽 read_timeout。")
    except Exception as e:
        print(f"\n【调用中断】异常详情: {e}")
五、生产级自检矩阵与防御式调用建议
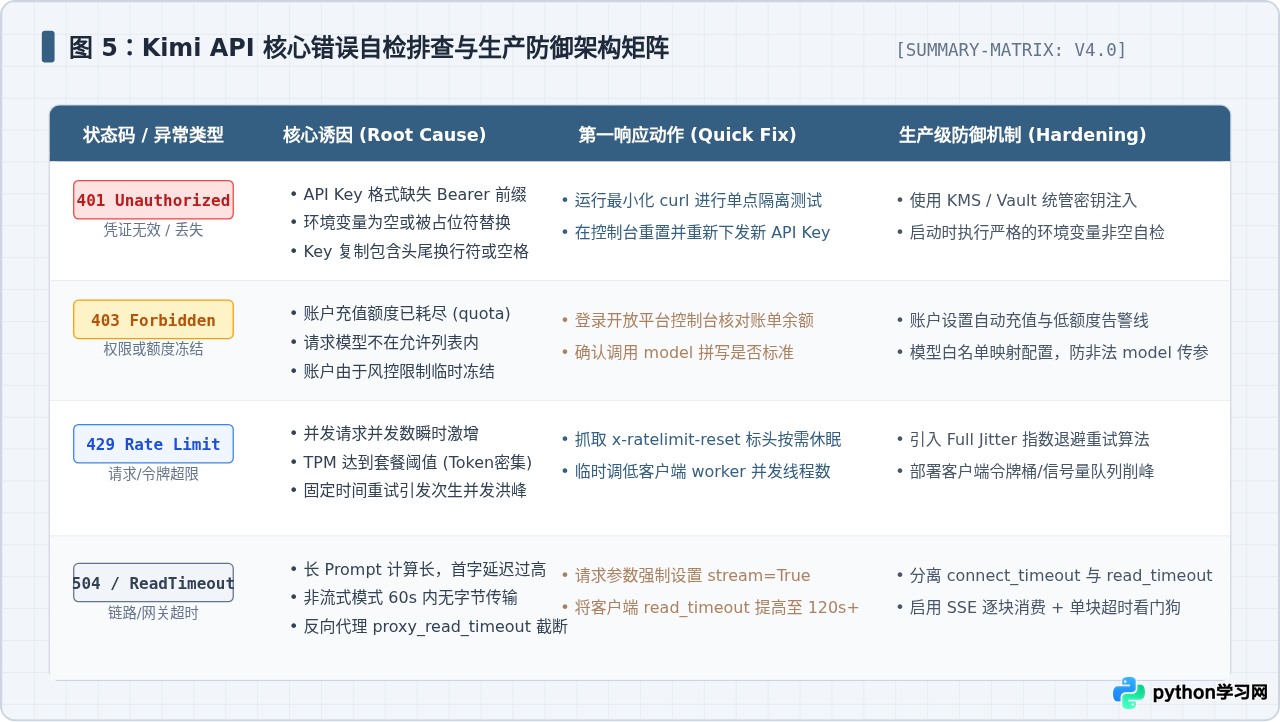
为了便于工程团队在日常运维和线上告警时迅速查证,我们将 Kimi API 常见故障分类、根因、速查动作与防御架构整合成矩阵。
生产环境稳定性加固要点清单
- 启动即检查(Fail-Fast):服务启动阶段,主动触发一次极低 Token 消耗的验证调用(如发送单个
ping),确保MOONSHOT_API_KEY可用且未欠费,防止服务带病上线。 - 长短文本模型按需路由:优先使用
moonshot-v1-8k处理常规短对话;仅在长文档分析、大文件摘要时调用moonshot-v1-32k或moonshot-v1-128k。更短的 Prompt 不仅显著降低延迟,还能大幅节省 TPM 配额。 - 强制接入熔断与降级:在微服务架构中,当 Kimi API 持续出现 500/503 或长时间超时时,客户端熔断器(Circuit Breaker)应迅速介入,切断重试风暴,并优雅降级为静态提示或切换至备用模型服务。
- 全链路日志保留
x-request-id:当需要联系 Moonshot AI 官方技术支持提交工单时,纯粹提供报错文本效率极低;记录下 HTTP Response Header 中的x-request-id才能让官方技术人员瞬间定位到底层具体的算力节点与链路日志。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









