

面试问Polars的LazyFrame延迟执行怎么答?
深度解析面试中如何回答Polars的LazyFrame延迟执行机制,从计算图定义、查询优化器原理、谓词与投影下推到流式执行与避坑指南,提供结构化面试答题框架与代码实例。
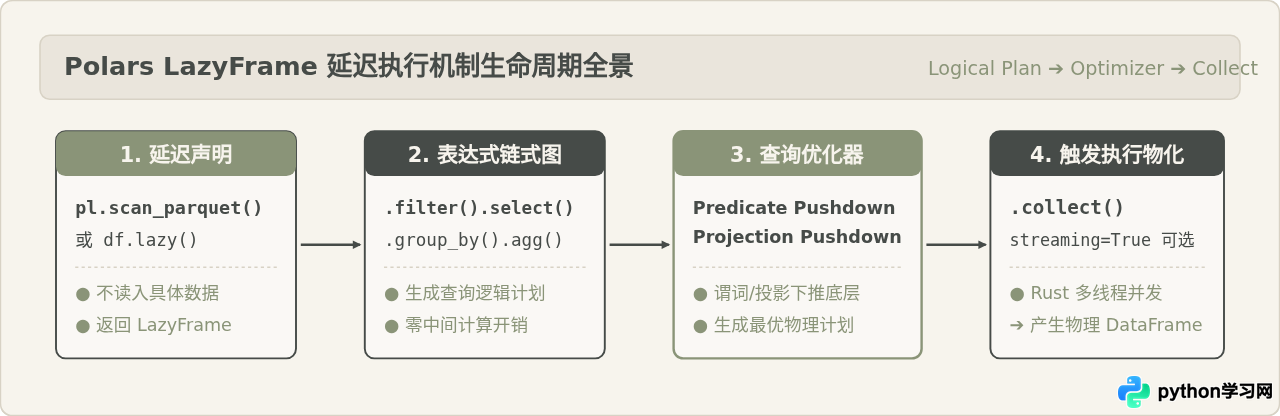
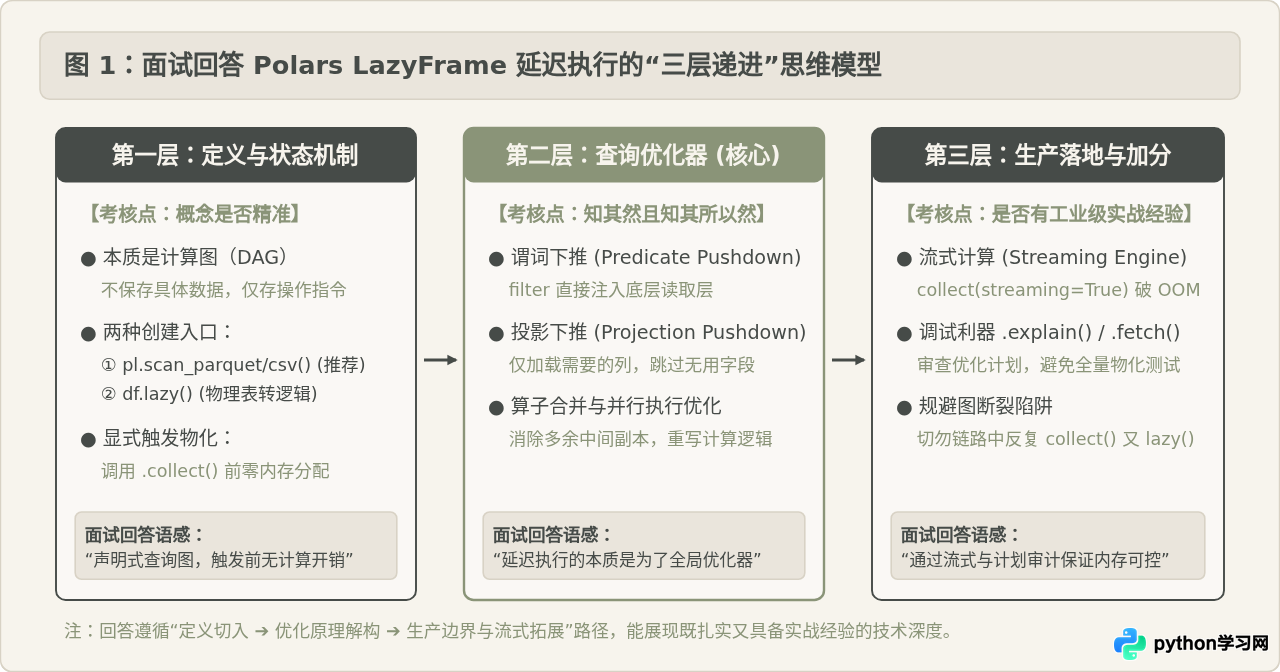
collect() 才真正计算”。延迟执行的核心价值绝不仅是推迟运行,而是通过延迟执行为底层内置的查询优化器(Query Optimizer)争取全局视野,从而实施谓词下推、投影下推和公共子计划消除,从根本上降低磁盘 IO 与内存峰值。最佳的回答结构应沿循“明确定义与状态流转 ➔ 拆解查询优化器四大策略 ➔ 延伸生产级流式落地与避坑”三层递进展开。
一、第一层:精准给出定义与状态流转机制
面试开场时,先用简洁的语言定性 LazyFrame 的物理实质。LazyFrame 本质上是一个声明式的有向无环计算图(Logical Plan / DAG),它并不持有物理内存中的二维数据,而是严格记录了用户对数据的操作意图和依赖关系。
回答时可以梳理其状态流转的两个核心阶段:
- 创建与转换入口:推荐通过
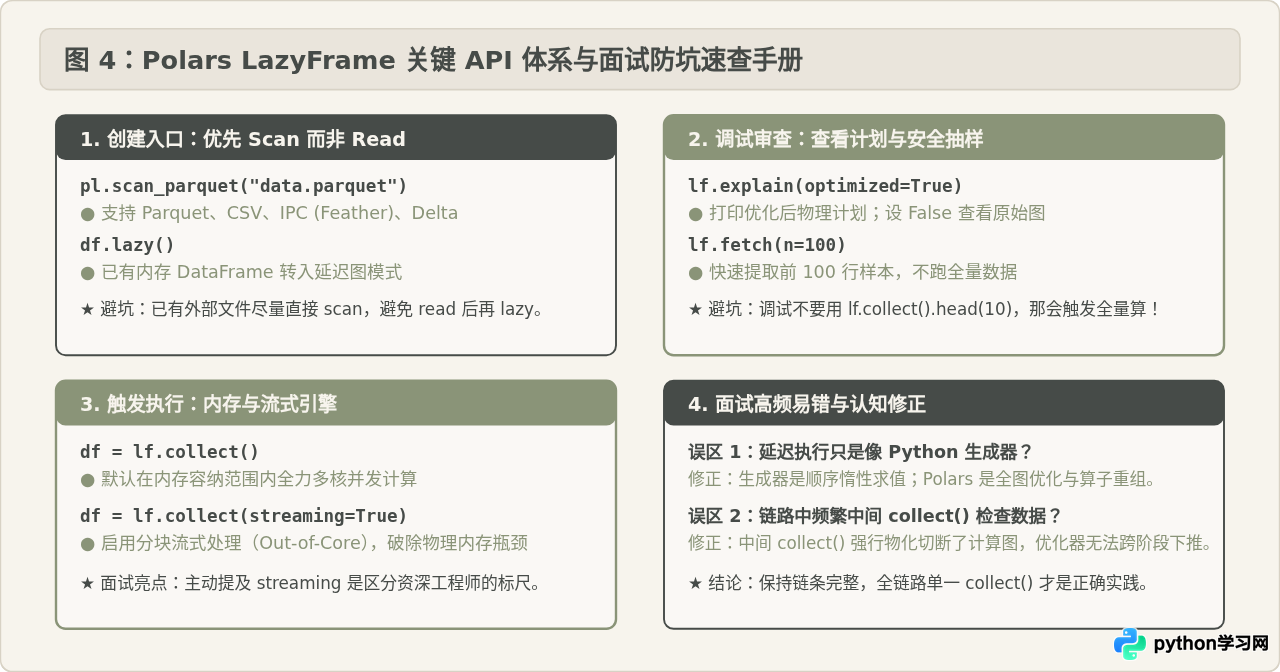
pl.scan_parquet()、pl.scan_csv()等scan_*系列直接创建,此时仅扫描文件头元数据,不读入具体行;若已有内存中的 DataFrame,则可通过df.lazy()转化为 LazyFrame。 - 物化触发出口:在链式调用所有的
filter、select、group_by之后,调用.collect()显式触发求值;若仅用于调试抽样,则使用.fetch(n)。在触发之前,内存开销几乎为零。
import polars as pl

# 1. 声明式延迟查询:此时未读取任何文件内容,未分配大规模 RAM
lazy_query = (
    pl.scan_parquet("orders_2026.parquet")
    .filter(pl.col("status") == "COMPLETED")
    .filter(pl.col("amount") > 100.0)
    .select(["order_id", "user_id", "amount", "order_time"])
)

# 打印对象类型:为 polars.lazyframe.frame.LazyFrame
print("查询对象类型:", type(lazy_query))

# 2. 显式触发物理执行,返回真实的 polars.dataframe.frame.DataFrame
result_df = lazy_query.collect()
print("执行完成,结果行数:", len(result_df))执行完成,结果行数: 142850
二、第二层:底层原理核心——查询优化器到底做了什么
如果候选人只答出“惰性求值”,面试官通常会追问:“既然最后还是要算,那为什么不一开始就一步一步算?Lazy 究竟快在哪里?”此时必须切入 Polars 的核心技术底座——基于 Rust 实现的物理与逻辑查询优化器。
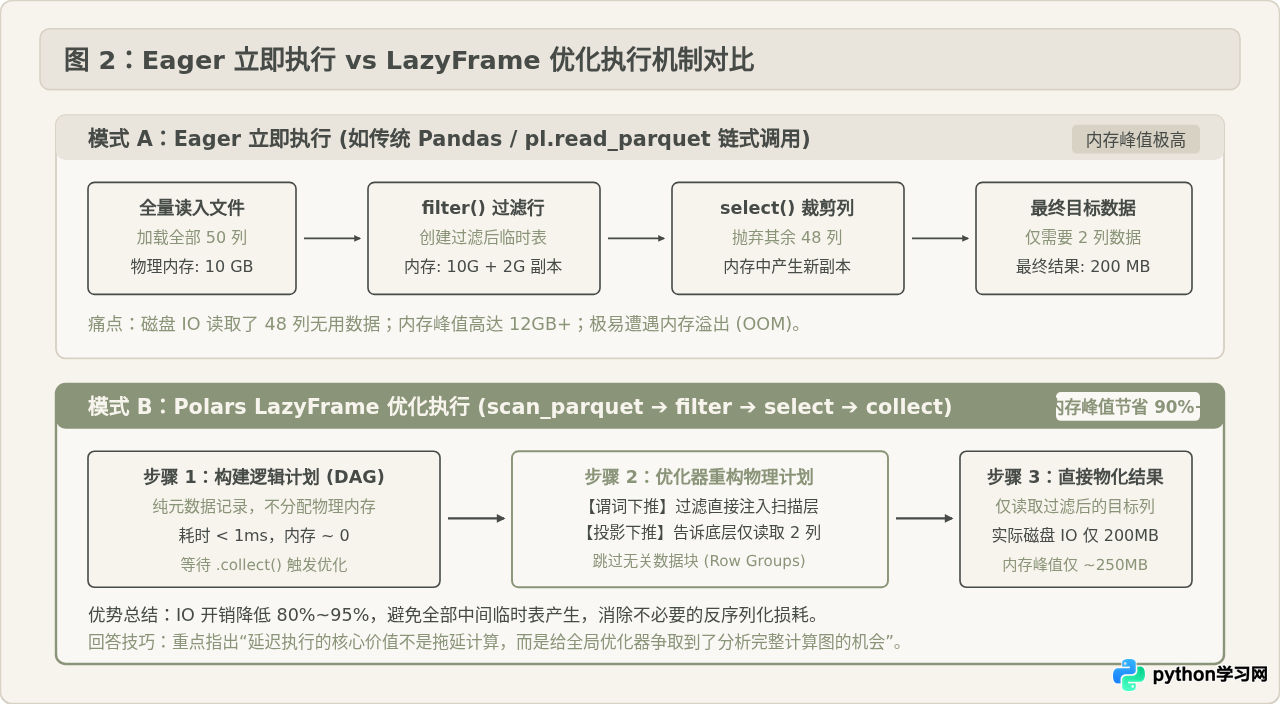
在 Eager 模式(如 Pandas 或直接使用 Polars DataFrame)下,代码每执行一行就会生成一个完整的中间临时表。如果先读入 50 列的宽表再筛选 2 列,那其余 48 列的反序列化、内存占用和随后的垃圾回收(GC)全是无意义的损耗。而在 LazyFrame 模式下,优化器在拿到全局计算图后,会执行以下关键优化:
1. 谓词下推(Predicate Pushdown / Filter Pushdown)
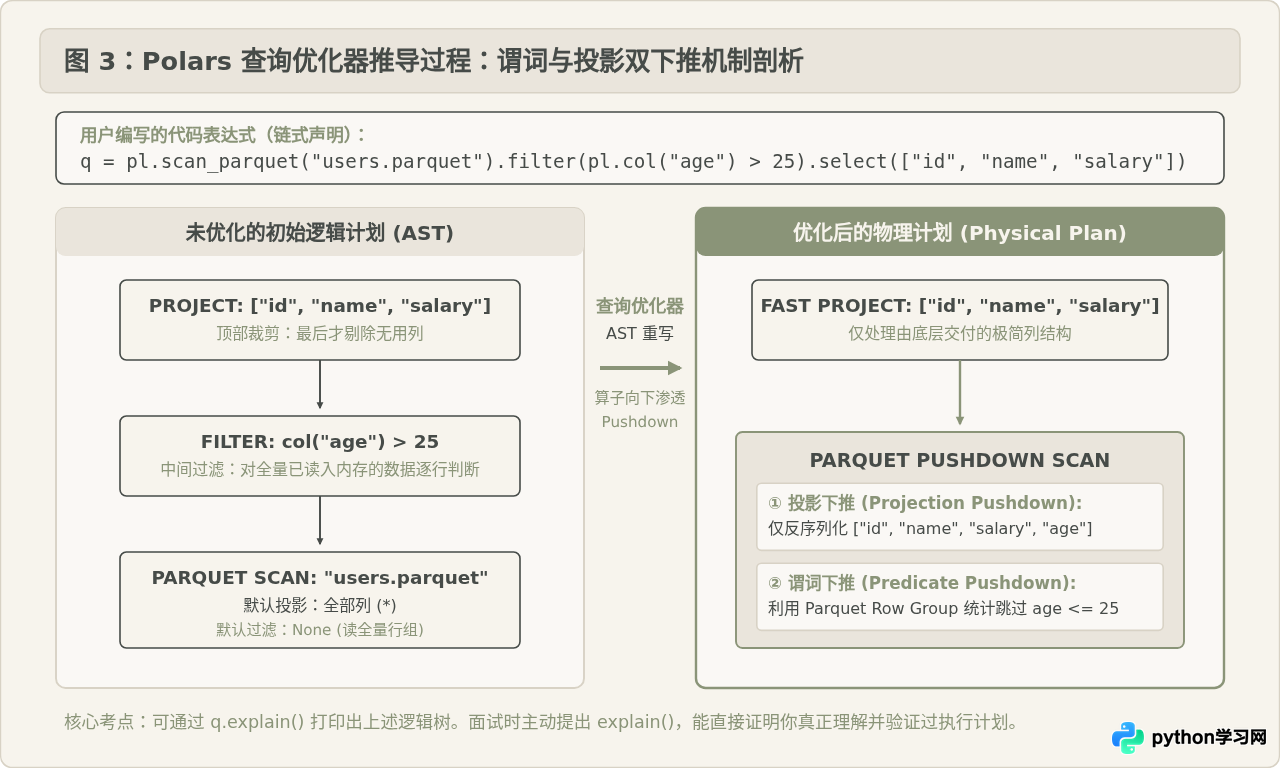
优化器会主动将 filter() 算子渗透穿透到整个计算图的最底端——文件读取层。对于 Parquet 等列式存储格式,每个 Row Group(行组)头部都记录了当前列的 min/max 统计值。Polars 能直接利用这些元数据跳过不满足过滤条件的整个数据块,大幅减少从磁盘读取到物理内存的数据量。
2. 投影下推(Projection Pushdown / Slice Pushdown)
优化器在图遍历时,会自顶向下检查后续计算到底使用了哪些列。即使用户写的是 scan_parquet() 扫描整个表,只要最终 select() 或计算只涉及 3 列,存储引擎就只从磁盘反序列化这 3 列,彻底消除读取冗余列的 IO 与内存开销。
3. 公共子计划消除与多线程并行重排
Polars 底层基于 Rust 与 Apache Arrow 内存模型,拥有天然的多线程并行能力。查询优化器会自动消除重复的子表达式,并将无依赖关系的表达式交由底层工作线程池(Rayon)并行计算,避免单线程串行等待。
.explain() 命令在面试现场,主动向面试官说明如何验证优化器的工作,是证明实操经验的关键。通过打印
q.explain(),可以直接在控制台展示优化前后的执行树。
# 查看优化后的物理执行计划 (Physical Plan)
print(lazy_query.explain(optimized=True))

# 对比未优化的原始逻辑计划 (Unoptimized Logical Plan)
print(lazy_query.explain(optimized=False))PARQUET SCAN orders_2026.parquet
PROJECT 4/50 COLUMNS
SELECTION: [([(col("status")) == (String(COMPLETED))]) & ([(col("amount")) > (100.0)])]
从输出中能清晰看到:原本写在最后的过滤条件被直接嵌入到了 PARQUET SCAN 内部的 SELECTION 属性中,而 PROJECT 4/50 COLUMNS 则印证了投影下推——底层只读取了 50 列中的 4 列。
三、第三层:生产落地与进阶考点——内存控制与流式执行
资深面试官往往会抛出一个极端场景:“当待处理的数据集规模达到 100GB,而服务器物理内存只有 16GB 时,普通的 collect() 仍然会爆内存(OOM),LazyFrame 怎么应对?”
这时需要给出工业级杀手锏——Polars 的流式引擎(Streaming Engine)。
在调用 collect() 时,传入参数 streaming=True:
# 启用 Out-of-Core 流式计算引擎,处理超出物理内存限制的超大数据集
streamed_df = lazy_query.collect(streaming=True)
流式引擎不会尝试将优化后的结果一次性全部塞入内存,而是将整个数据流切分为批次(Batches/Chunks),采用流水线(Pipelining)机制边读边算,中间结果及时沉降或释放,从而使内存峰值保持在一个恒定的安全阈值内。
工程调试避坑:慎用 head(),善用 fetch()
初学者常犯的一个严重错误是:为了查看前几行,写出 lazy_query.collect().head(10)。这种写法实际上命令 Polars 对整个数据集完成全量计算并物化到内存,最后才截取前 10 行,完全失去了调试效率。
正确做法是使用专门针对 LazyFrame 设计的 fetch(n) API:
# 仅对前 100 行样本构建并执行计划,安全快速验证数据逻辑
sample_df = lazy_query.fetch(n=100)
四、常见认知误区与深度辨析
在面试中,主动辨析以下容易混淆的概念,能大幅展现思维的严密性:
1. 辨析一:“LazyFrame 延迟执行与 Python 生成器(Generator)一样?”
为何看似合理:两者表面上都是“声明时不计算,要求结果时才逐一产出”。
核心差异与修正:Python 生成器是纯粹的单向逐项惰性求值,它完全无法感知后续步骤,更不能颠倒算子顺序。而 Polars LazyFrame 是全图语法树分析与优化重排。它在执行前能够重写整张图(例如把第 5 步的 filter 挪到第 1 步执行),这在生成器中是根本无法做到的。
2. 辨析二:“是否所有场景无脑用 LazyFrame 都一定比 DataFrame 快?”
为何看似合理:优化器总是产生更好的执行计划。
成立边界与修正:在几百行的小规模纯内存数据或交互式单步探索场景下,解析逻辑图和运行优化器存在微秒级的固定损耗。此时 Eager 模式随写随出更直观便捷。但只要涉及磁盘文件 IO、多表 Join、复杂过滤或数据规模超过数万行,LazyFrame 的优化收益便呈数量级碾压。
3. 辨析三:“链路中间频繁插入 collect() 导致图断裂”
很多开发者习惯写两步就 collect() 看一眼,再 .lazy() 接下去写。这种操作被称为“计算图断裂”。优化器无法跨越物理物化边界进行谓词和投影下推,导致下推优化彻底失效。正确的模式是:全链路保持 Lazy 状态,只在最终交付数据时执行唯一一次 collect()。
五、面试现场满分口述模板(1分钟精炼版)
如果在面试现场被提问“请讲讲 Polars 的 LazyFrame 延迟执行”,你可以直接采用以下结构清晰、节奏稳健的话术进行口述回答:
面试官您好,关于 Polars 的 LazyFrame 延迟执行,我主要从概念本质、优化器机制和工程落地三个维度来理解:
第一,在概念上:LazyFrame 是一个声明式的有向无环图(DAG),它并不直接持有数据,只记录算子逻辑。我们通常通过 pl.scan_parquet() 建立延迟扫描,在调用 collect() 之前完全不分配物理计算内存。
第二,在底层机制上:延迟执行的核心并不是“拖延”,而是给 Polars 内置的查询优化器争取全局优化的空间。最核心的两项优化是谓词下推和投影下推——优化器能将 filter 直接注入 Parquet 存储层,利用行组元数据跳过无关数据块;同时自顶向下分析仅反序列化必要列,这能减少 80% 到 90% 以上的磁盘 IO 和内存中间临时表复制。在开发中,我们可以直接用 .explain() 打印出物理计划来验证这种下推。
第三,在生产落地与边界上:当数据体量超出内存物理上限时,LazyFrame 支持 collect(streaming=True) 流式引擎分批计算,防止 OOM;在调试阶段,则应使用 .fetch(n) 抽取局部样本,避免全量物化。同时工程上要避免在链路中途频繁调用 collect(),保证全局计算图的连续性。
这一套回答覆盖了概念定义、底层原理、验证手段、架构边界与生产实践,既展现了扎实的底层功底,又证明了具备真正的大规模数据工程实战经验。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









