

python函数注解写错不影响运行吗
深入解析Python函数注解写错是否影响程序运行。详细阐述CPython底层解释机制、__annotations__元数据原理、运行时与静态检查的差异,以及Pydantic等框架下的特殊表现。
核心结论:在标准 Python(CPython)中,函数注解写错绝大多数情况下完全不影响代码的正常运行。Python 本质上是一门动态类型语言,类型注解(Type Hints)在运行时默认只作为元数据存储在函数的属性中,解释器在执行调用时不会对参数和返回值做任何强制类型校验。但写错注解会导致静态分析报错、IDE 代码提示失真,而在使用 Pydantic 或 FastAPI 等运行时依赖注解的框架中,则会直接引发程序崩溃。
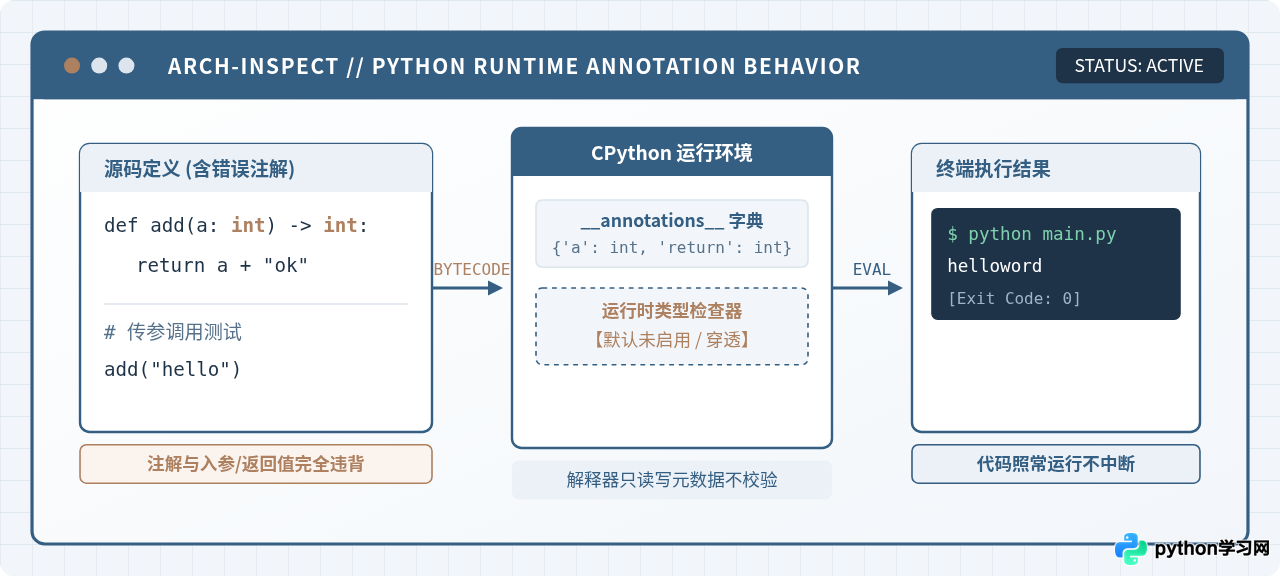
一、为什么函数注解写错了程序依然能跑?
很多刚从静态语言(如 C++、Java)转向 Python 的开发者,往往会下意识地认为函数签名中写了类型就等于拥有了类型约束。例如将参数标注为 int,如果传了 str 就应该像编译型语言那样抛出类型错误。但在 Python 中,事情并不是这样运作的。
Python 引入函数注解(PEP 3107)和类型提示(PEP 484)的初衷,是为了向开发者、IDE 和第三方静态分析工具提供辅助信息,而不是在运行时改变 Python 的动态类型本质。无论你在函数签名里写了什么注解,Python 解释器在实际执行函数调用时,压根不会去核对传入的实参与注解是否匹配。
def calculate_tax(amount: int) -> int:
    # 故意标注为必须接收 int 并返回 int
    # 实际传入字符串,返回列表
    return [amount, amount]

# 实际调用:传入与注解完全相反的字符串
result = calculate_tax("1000")
print("执行结果:", result)
print("返回值类型:", type(result))执行结果: ['1000', '1000']
返回值类型: <class 'list'>从上面的执行结果可以看到,终端毫无阻碍地输出了列表,退出码为 0,没有抛出任何警告或异常。这直接证明了:原生的 Python 解释器在执行函数时,完全把类型注解当成透明的元数据忽略掉了。
二、底层机理:Python 解释器如何处理函数注解?
为了彻底搞明白为什么注解写错不影响运行,我们需要拆解 Python 解释器在编译与运行阶段的具体流程:
- 编译阶段(AST 解析):Python 解释器在将
.py源码解析为抽象语法树(AST)时,会确认函数注解是否符合 Python 的表达式语法。只要语法合法,这些注解就会被打包进编译产物中。 - 定义阶段(实例化函数对象):当模块被加载、解释器执行到
def语句时,会创建一个函数对象,并将函数签名中的所有注解解析求值后,存入该函数对象的__annotations__字典属性中。 - 执行阶段(函数调用):当程序发起调用(如
calculate_tax("1000"))时,解释器直接进入栈帧并绑定参数。在执行CALL_FUNCTION等底层字节码时,虚拟机直接操作对象本身,完全不会读取__annotations__字典进行比对。
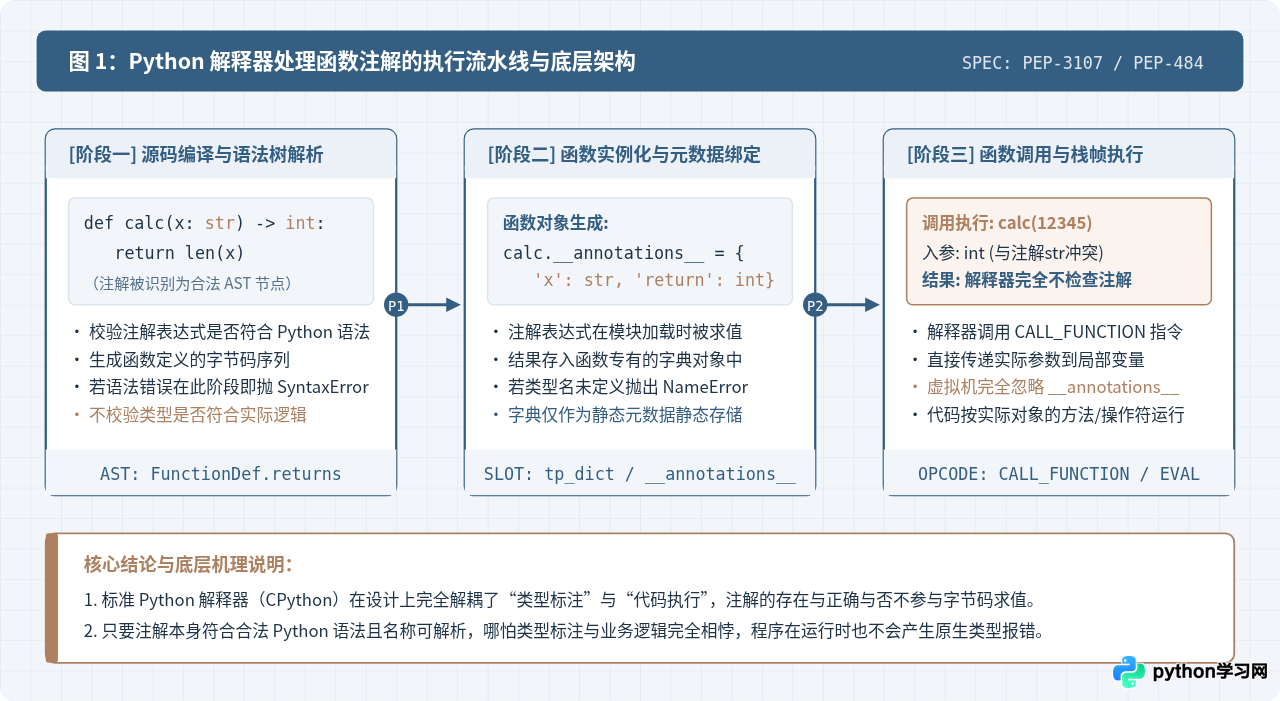
我们可以通过交互式环境直接打印函数的内部属性来验证这一点:
def greet(name: str) -> int:
    return "Hello, " + name

print(greet.__annotations__)
# 输出: {'name': <class 'str'>, 'return': <class 'int'>}可以看到,greet.__annotations__ 仅仅是一个普通的 Python 字典,记录了 name 是 str、返回值是 int。解释器对它的唯一操作就是“在定义时放进去”,后续的运行过程全凭函数体内的逻辑自行运转。
三、特例剖析:什么时候注解写错“真的会”影响运行?
虽然常规逻辑下注解错误不会阻止程序运行,但在以下两类特殊场景中,写错注解会直接导致程序崩溃:
1. 注解本身包含未定义的名称或语法错误
在 Python 默认机制下,函数注解在模块加载(函数定义)时会被立即求值。如果你在注解里写了一个根本不存在的类型名称,解释器在定义该函数时就会直接抛出 NameError,根本连函数调用的机会都没有。
# 并没有导入或定义 UserProfile
def load_user(user_id: int) -> UserProfile:
    return {"id": user_id}

# 执行结果:抛出 NameError: name 'UserProfile' is not defined避坑提示:在 Python 3.7 及以上版本中,可以通过在文件头部添加 from __future__ import annotations(PEP 563)来启用延迟求值。启用后,所有注解都会被当成纯字符串存储,避免了因未定义类型而在模块加载时抛出 NameError,但如果在运行时调用 typing.get_type_hints() 仍然会报错。
2. 使用了运行时依赖注解的第三方框架
现代 Python 生态中有大量框架在运行时深度依赖 __annotations__ 元数据,最典型的就是 Pydantic、FastAPI、SQLModel 以及 Typeguard。在这类框架中,类型注解不仅是标注,更是真正的业务数据校验契约。
from pydantic import BaseModel, ValidationError

class UserAccount(BaseModel):
    # 开发者笔误将年龄标注为字符串,或者把业务字段类型写错
    age: int

try:
    # 传入无法转为 int 的参数
    user = UserAccount(age="not_a_number")
except ValidationError as e:
    print("运行时直接捕获校验异常:")
    print(e)
在这种体系下,一旦函数或模型的类型注解写错,框架在执行数据反序列化与入参检查时,会严格按照注解执行校验与类型强制转换,直接抛出 ValidationError 并中断业务请求。因此,在现代微服务与 Web 框架中,绝不能轻视注解的准确性。
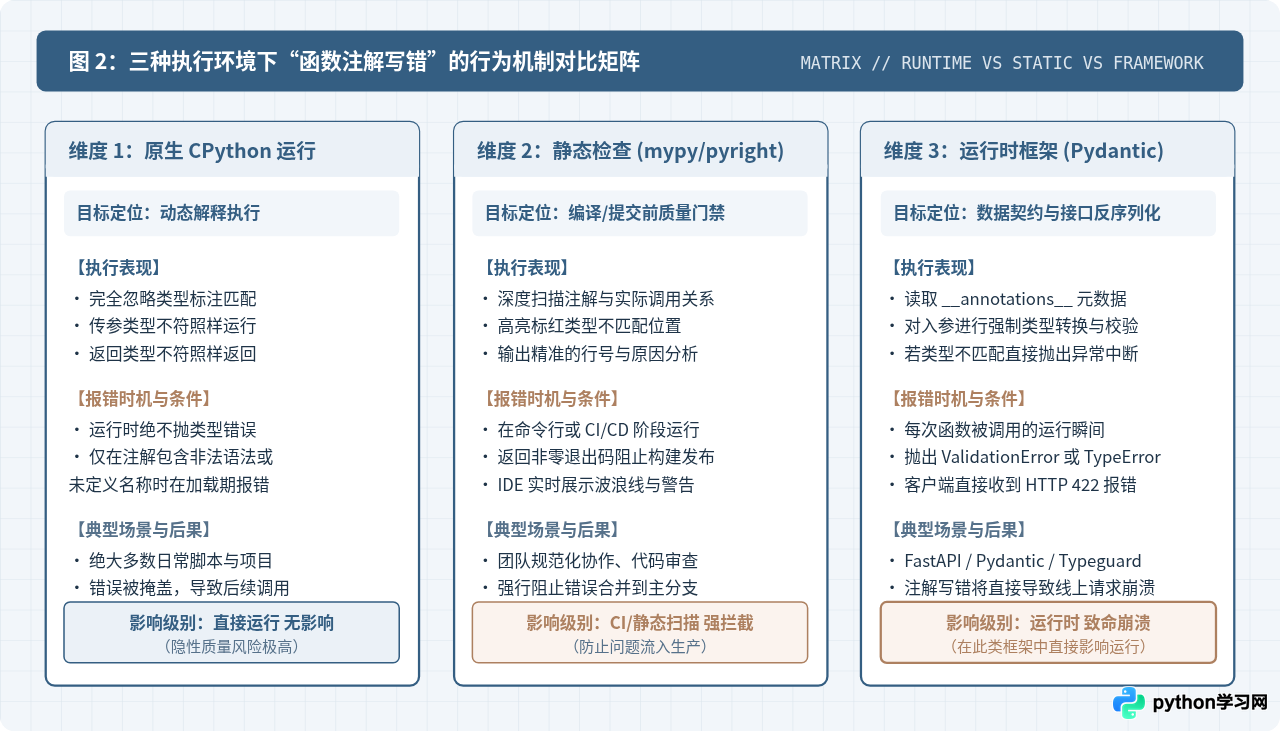
四、既然大多数时候不影响运行,为什么绝不能乱写?
许多开发者在得知注解写错不影响运行后,便随意乱写甚至敷衍了事。这种做法会带来三大严重的工程隐患:
- IDE 代码补全与导航完全混乱:现代编辑器(如 VS Code、PyCharm)完全依据类型注解来推断变量拥有的方法与属性。如果标注了错误的类型,IDE 会给出完全错误的 API 提示,或者对正确的调用打上大红波浪线,严重干扰编码体验。
- 制造“类型安全”的心理假象:其他维护代码的同事看到
def get_user() -> User,会理所当然地按照User对象的方法去调用。如果实际返回的是dict,后续代码在访问属性时就会突发AttributeError,排查极为困难。 - 破坏静态质量门禁:规范的团队工程都会在 CI/CD 流水线中集成静态检查工具。注解错误会导致持续集成流水线直接失败,阻断代码合并与交付。
五、实战操作:如何通过静态检查器提前揪出错误注解?
既然 Python 解释器在运行时不管注解,我们如何保证工程里的注解是百分之百正确、不发生错位的呢?答案是:借助静态类型检查工具(如 mypy 或 pyright)建立防线。
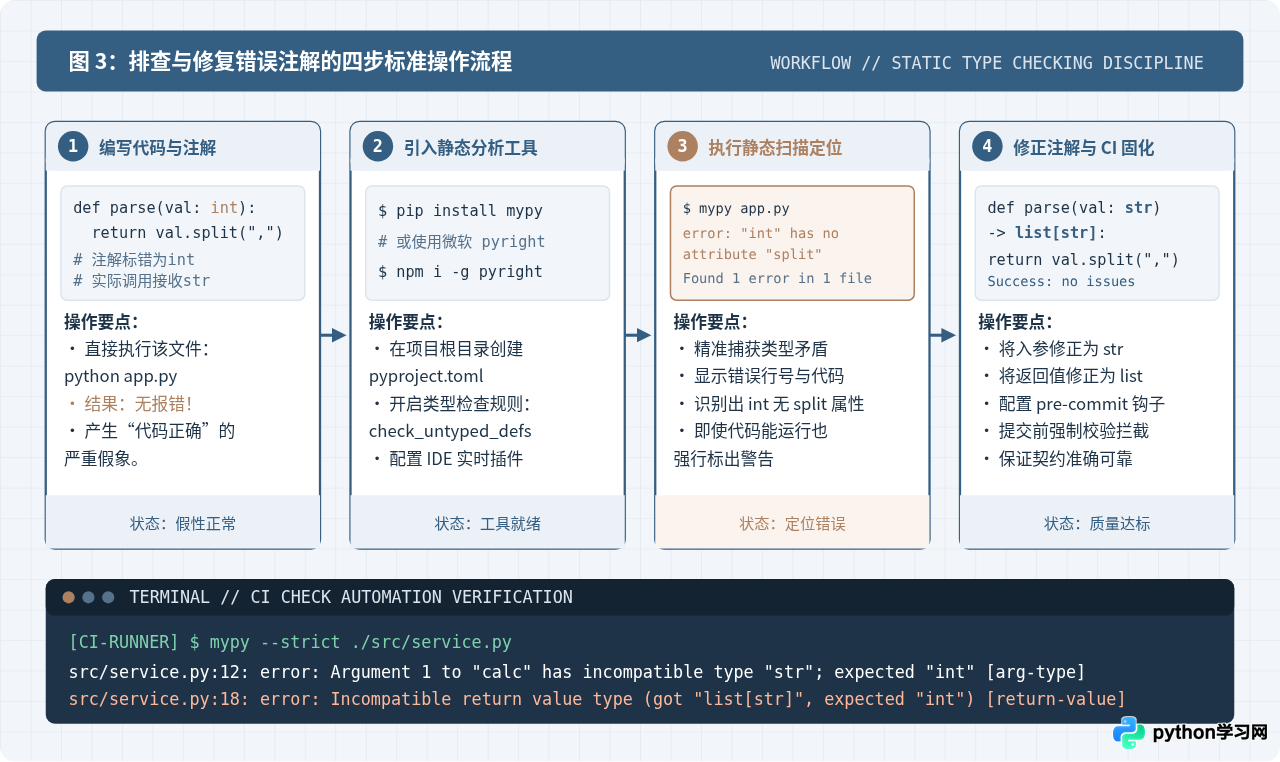
步骤 1:安装静态检查工具
在你的虚拟环境或本地终端中,通过 pip 安装业界标准的静态类型检查器 mypy:
pip install mypy步骤 2:对目标文件执行类型扫描
假设我们有如下存在注解错误的代码文件 demo.py:
def process_items(items: list[str]) -> int:
    total = 0
    for item in items:
        total += len(item)
    # 错误:代码明明返回的是字符串,但签名注解标成了 int
    return f"Total length is: {total}"

result = process_items(["apple", "banana"])
直接运行 python demo.py 不会有任何报错。现在我们在终端使用 mypy 进行静态检查:
$ mypy demo.py
demo.py:7: error: Incompatible return value type (got "str", expected "int")  [return-value]
Found 1 error in 1 file (checked 1 source file)
mypy 精准地在第 7 行抓住了矛盾:实际返回了 str,但函数签名声称返回 int。
步骤 3:修复注解并再次验证
将 demo.py 中的返回类型修正为 str:
def process_items(items: list[str]) -> str:
    total = 0
    for item in items:
        total += len(item)
    return f"Total length is: {total}"
再次运行 mypy demo.py,终端将提示:
Success: no issues found in 1 source file步骤 4:在自动化流程中固化检查
为了防止开发者在本地写错注解被意外合入,建议在项目根目录的 pyproject.toml 中添加 mypy 配置,并在 git 提交钩子(pre-commit)或 CI 流水线中加入校验:
[tool.mypy]
python_version = "3.10"
warn_return_any = true
warn_unused_configs = true
disallow_untyped_defs = true
六、影响评估与处置总结
在面对“函数注解写错”这一问题时,可以对照下表快速判断其影响面与处理策略:
| 场景类别 | 原生运行表现 | 静态检查表现 | 根本原因与处置建议 |
|---|---|---|---|
| 普通 Python 函数 | 正常运行 (无报错) | 报错 / 标红警告 | 解释器仅存元数据不校验;必须在 CI 中接入 mypy 把关。 |
| 未定义类型/拼写错误 | 定义期抛 NameError | 报错 (Name not defined) | 模块加载时求值失败;需检查导入或使用延迟注解字符串。 |
| Pydantic / FastAPI | 运行时抛 ValidationError | 报错 / 提示不匹配 | 框架在运行时主动读取注解做强校验;必须严格保证注解与实际数据一致。 |
| IDE 代码提示与重构 | 代码逻辑按实际运行 | 代码补全失效 / 乱码 | 开发工具完全受注解引导;错误注解会严重降低维护效率。 |
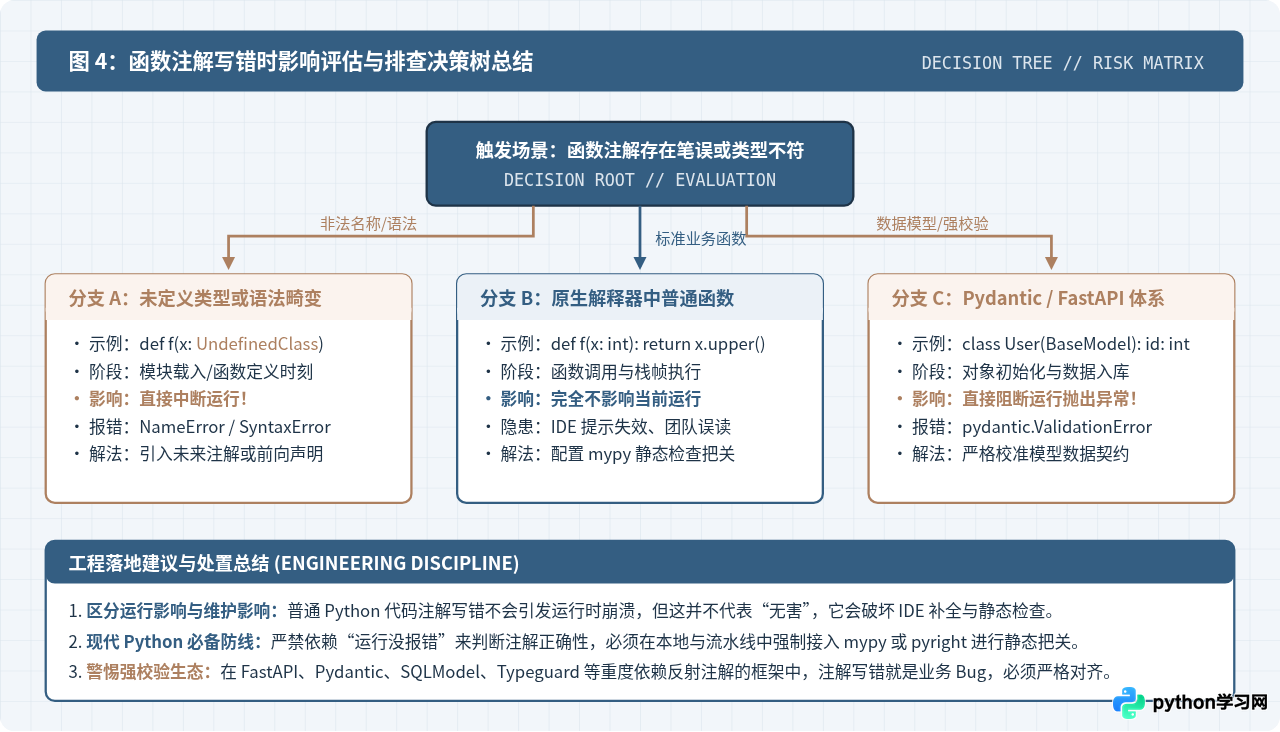
总的来说,“Python 函数注解写错不影响运行”是事实,但也是一个具有欺骗性的技术细节。在严谨的工程实践中,我们应当将类型注解视作代码不可分割的一部分,通过静态类型检查工具将其纳入质量闭环,确保既能享受动态语言的灵活性,又能获得静态类型带来的可靠契约。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









