

python必背源代码线性查找代码
详解Python线性查找(顺序查找)的核心源代码模板与实现原理,涵盖标准索引查找、单步执行流程、性能分析及与二分查找的选型决策,提供初学者必背的基础代码参考。
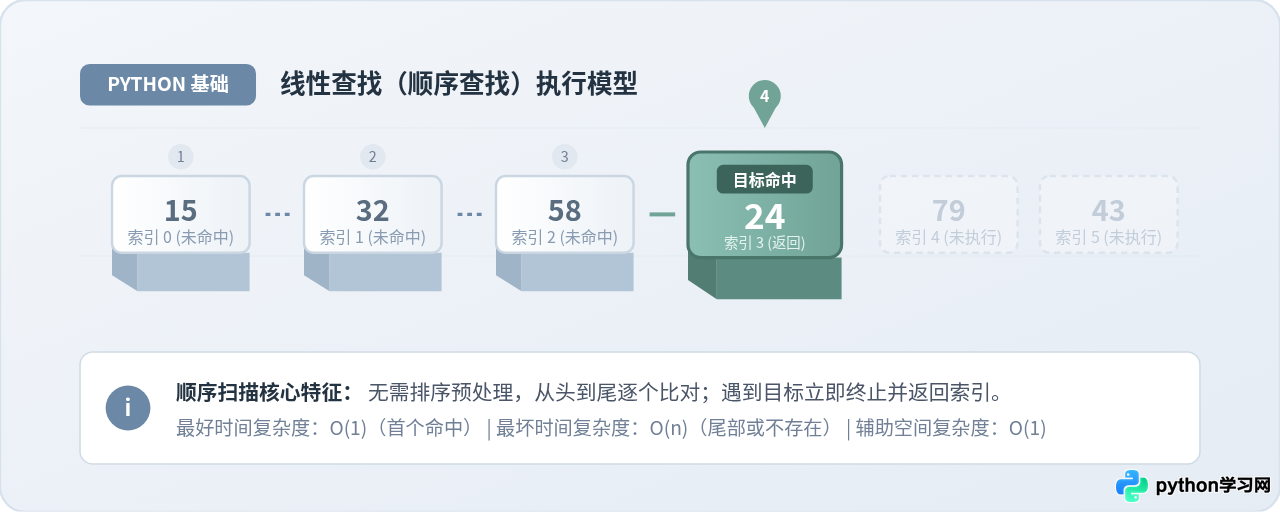
线性查找(Linear Search),也称顺序查找,是计算机编程中最基础、使用频次最高的检索算法。它的核心思想十分直观:从数据序列的第一个元素开始,按物理顺序依次将每个元素与目标值进行比对,若找到相等元素则立即返回其位置索引;若查遍整个序列仍未匹配,则返回未找到的标识(通常约定为 -1)。
一、线性查找核心必背源代码
在 Python 中编写线性查找,最标准、工程推荐的做法是使用内置的 enumerate() 函数。这样既能直接获取当前元素的值,又无需手动维护下标变量自增,代码简洁且不易出错。
def linear_search(arr, target):
    """
    线性查找(顺序查找)标准实现
    :param arr: 待查找的序列(列表或元组)
    :param target: 需要检索的目标值
    :return: 目标值首次出现的索引;若不存在则返回 -1
    """
    for index, value in enumerate(arr):
        if value == target:
            return index  # 命中目标,立即提前返回当前索引
    return -1  # 完整遍历后仍未找到,返回 -1
下面是一个可直接执行的验证示例:
# 验证示例
if __name__ == "__main__":
    scores = [65, 82, 90, 74, 88, 95]
    search_val = 74

    result_index = linear_search(scores, search_val)

    if result_index != -1:
        print(f"查找成功:数值 {search_val} 首次出现在索引位置 {result_index}")
    else:
        print(f"查找失败:数值 {search_val} 不在序列中")

# 示例输出:
# 查找成功:数值 74 首次出现在索引位置 3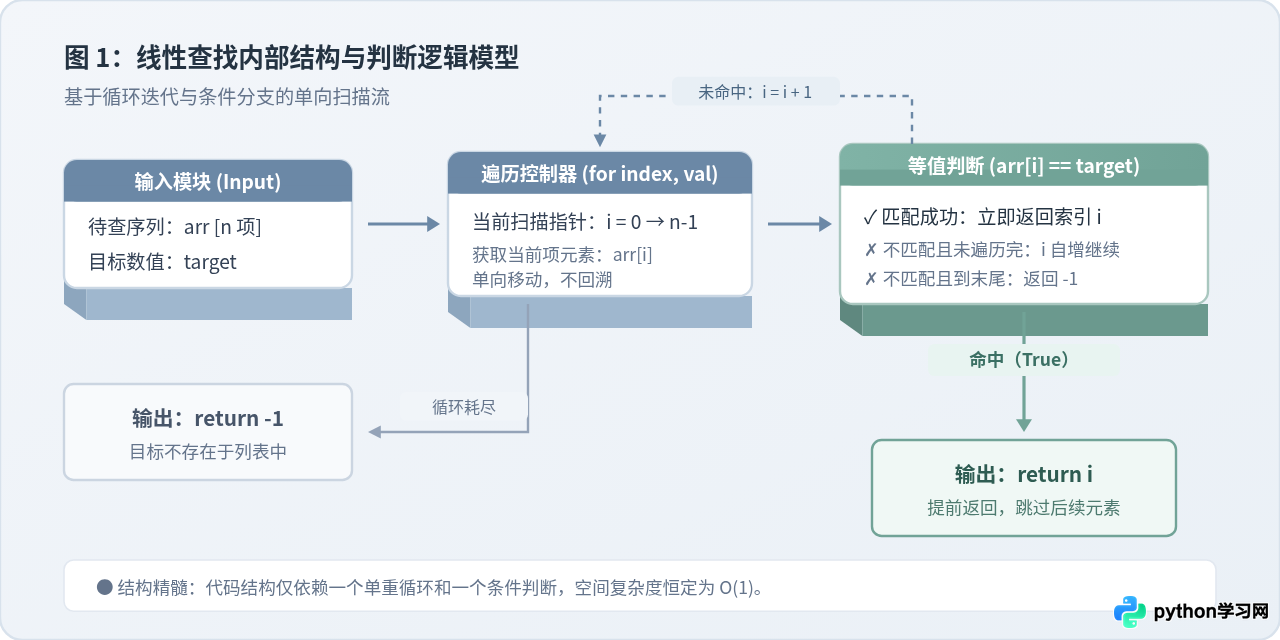
这段代码包含三个关键设计点:
- 参数通用性:形参
arr支持 Python 中任意支持迭代的序列类型,包括列表(list)、元组(tuple)甚至字符串(str)。 - 提前退出机制(Early Return):一旦
value == target条件成立,函数执行return index立即跳出循环,绝不执行无意义的后续遍历。 - 未命中统一标识:如果循环正常执行完毕仍未触发 return,代码流会走到最后一行返回
-1。在编程规范中,非负整数代表合法索引,-1作为通用的哨兵值(Sentinel Value)清晰代表“未找到”。
二、单步执行流程与推导演变
为了深刻理解线性查找的运行动态,我们以具体数据列表 [15, 32, 58, 24, 79, 43] 中查找目标值 24 为例,观察 CPU 在遍历过程中的状态变迁:
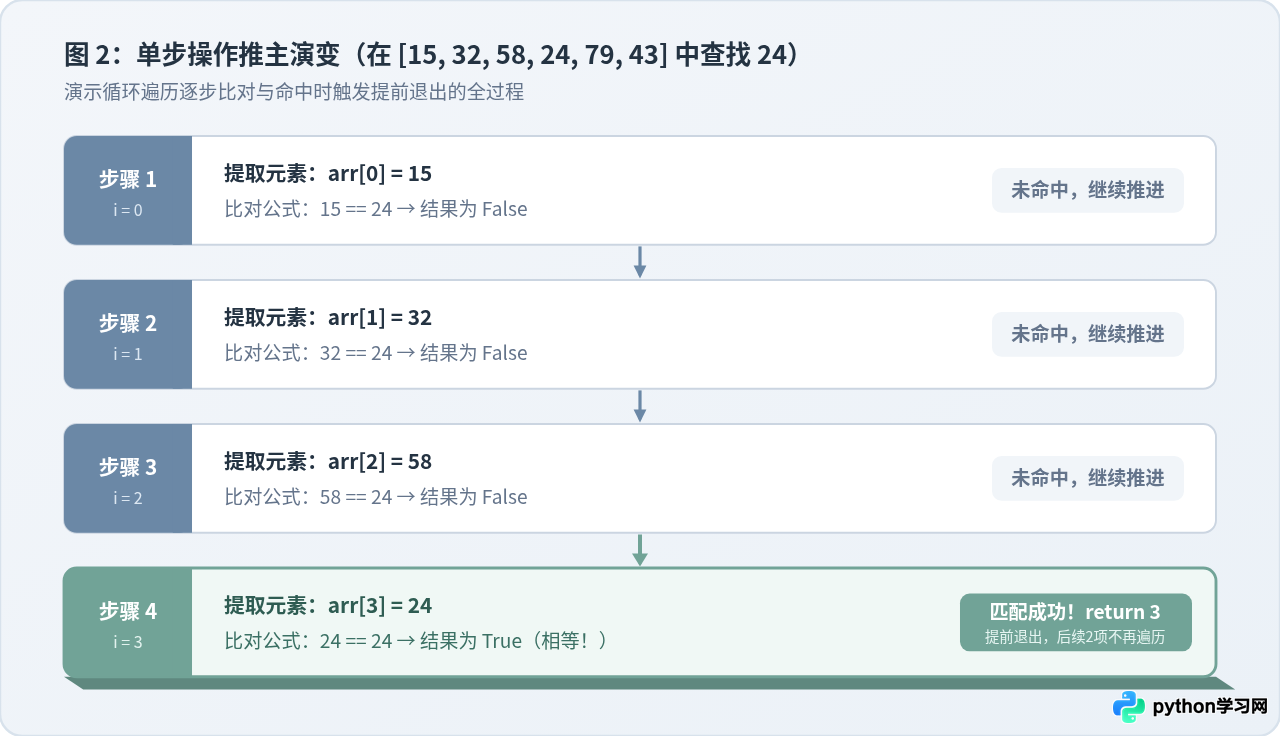
- 第 1 次比对 (index = 0):取出
arr[0]值为15。执行条件判定15 == 24,结果为False。循环不终止,指针推进至下一个位置。 - 第 2 次比对 (index = 1):取出
arr[1]值为32。判定32 == 24,结果为False。继续推进。 - 第 3 次比对 (index = 2):取出
arr[2]值为58。判定58 == 24,结果为False。继续推进。 - 第 4 次比对 (index = 3):取出
arr[3]值为24。判定24 == 24,结果为True。匹配成功,函数立即执行return 3。 - 后续截断:列表末尾的
79与43不会被访问,检索过程提前终结。
return -1 错误地写在 for 循环内部的 else 分支中。如果写在循环内部,会导致第一次比对未命中就直接退出函数,使查找逻辑退化成“只检查第 0 个元素”。请务必保证 return -1 与 for 关键字处于同一缩进层级。
三、常见业务变形写法与 Python 原生对照
在实际开发中,根据调用方关注的信息不同,线性查找通常有以下两种常见变形需求:
1. 仅判断目标是否存在(返回布尔值)
如果业务只需知道某个元素“在不在”集合中,而不需要具体下标,可以返回 True 或 False:
def linear_search_exists(arr, target):
    """判断 target 是否存在于列表中,返回布尔值"""
    for item in arr:
        if item == target:
            return True
    return False
2. 查找全部匹配项的索引(处理重复元素)
基础的线性查找只能定位首次出现的位置。若列表中存在重复项且需要记录所有匹配位置,可以使用列表推导式或追加结果:
def linear_search_all(arr, target):
    """查找所有等于 target 的索引列表"""
    indices = []
    for index, value in enumerate(arr):
        if value == target:
            indices.append(index)
    return indices

# 示例:
# linear_search_all([10, 20, 10, 30, 10], 10) 将返回 [0, 2, 4]
3. Python 内置语法的底层对应
Python 语言本身已将线性查找高度封装在底层 C 源码中:
- 运算符
item in my_list:底层便是对列表的线性遍历,耗时与序列长度成正比。 - 方法
my_list.index(target):同样执行线性查找并返回首次出现的下标;与我们手写的函数不同的是,若元素不存在,index()会抛出ValueError异常,需要配合try...except结构处理。
四、算法选型对比与决策树
在实际工程选型中,很多初学者会疑惑:既然二分查找(Binary Search)的时间复杂度是 $O(\log n)$,我们为什么还要背诵和使用时间复杂度为 $O(n)$ 的线性查找?
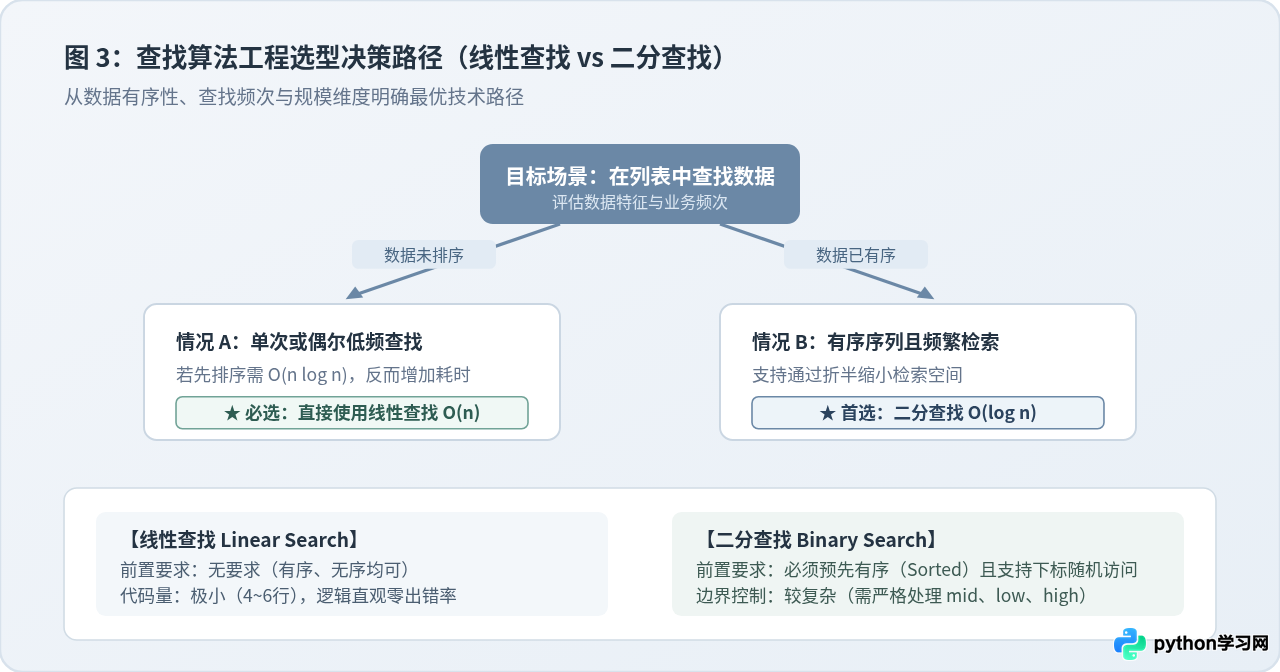
关键依据在于数据前置状态与整体计算成本:
- 二分查找的前提是数据必须完全有序。如果拿到的是一个无序列表,且我们只需要进行一次或少数几次查找,先对列表排序需要消耗 $O(n \log n)$ 的计算时间,再加上一次二分查找 $O(\log n)$,整体耗时远超直接进行一次 $O(n)$ 的线性查找。
- 数据结构限制:二分查找依赖随机访问能力(通过下标以 $O(1)$ 时间定位中间项)。如果是单链表、生成器、管道流等不支持快速随机访问的数据源,二分查找无法施展,必须采用线性查找。
- 代码健壮性与开发成本:线性查找逻辑极简,没有边界偏移(如
low <= high、mid + 1、防止整数溢出等)的心智负担,出错率为零。
五、全景知识总结与性能指标
最后,我们将线性查找的核心概念、性能指标与避坑要点汇总如下:
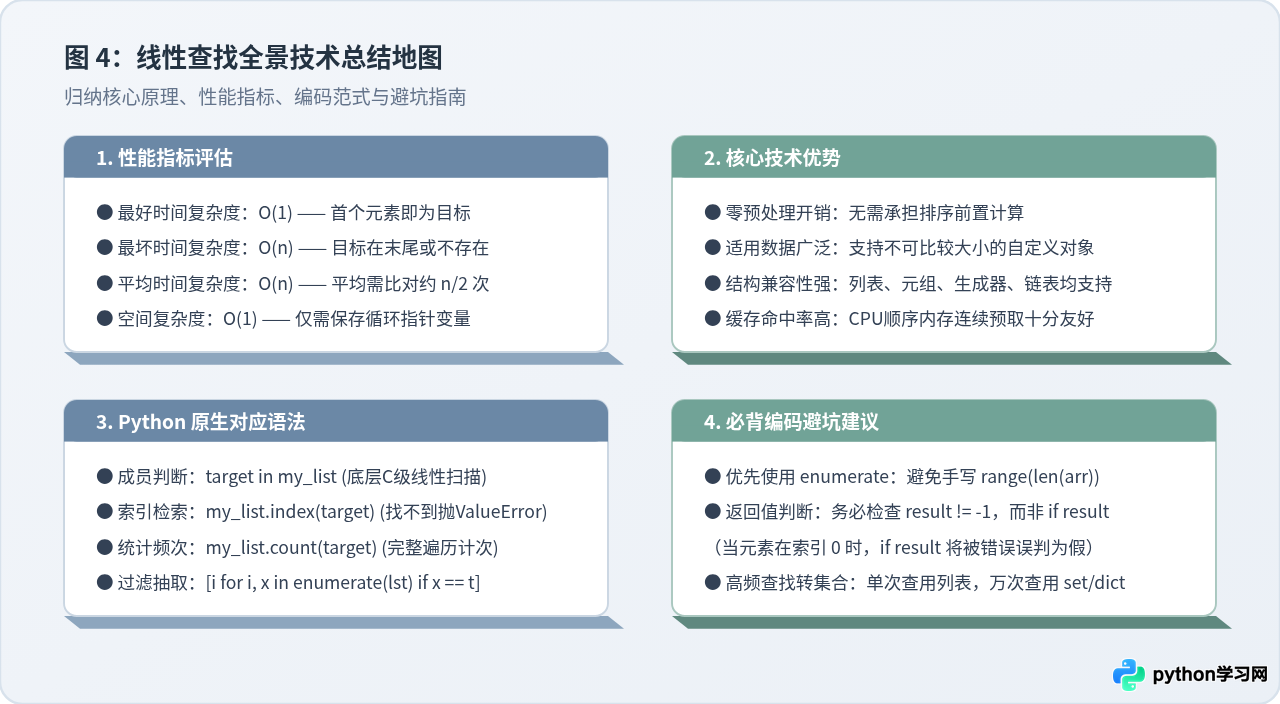
| 评估维度 | 指标 / 表现 | 具体说明 |
|---|---|---|
| 最好时间复杂度 | O(1) | 目标值恰好位于列表首位(索引 0),第 1 次比对即命中退出。 |
| 最坏时间复杂度 | O(n) | 目标值在列表最末位,或者目标值根本不存在,必须完整遍历 n 项。 |
| 平均时间复杂度 | O(n) | 在目标等概率出现在各个位置的假设下,平均比对次数约为 (n + 1) / 2。 |
| 辅助空间复杂度 | O(1) | 原地比对,仅分配少量局部变量(索引和数值指针),内存开销恒定。 |
| 数据预处理要求 | 无 | 支持无序数据,支持任意自定义对象,即开即用。 |
if result != -1:,绝对不要偷懒简写成 if result:。因为当被查找元素恰好是列表第 0 项时,函数返回的索引是 0;在 Python 的布尔上下文中,整数 0 会被判定为 False,从而导致逻辑发生严重误判。
掌握线性查找不仅是掌握一种具体的代码写法,更是理解算法时间与空间权衡、理解提前退出优化机制的基石。在处理中小规模数据集或流式无序数据时,它始终是最稳健、最直观的求解手段。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









