

Python基础学习路线指南:核心知识点清单与学习建议
一份系统、结构清晰且具有实操验证标准的Python基础学习路线指南。详细梳理从语法基石、内置容器、函数抽象到面向对象与异常处理的核心知识点清单,深入剖析变量引用与内存模型,并提供分阶段自测与避坑建议。
一、基础学习的阶段演进与验收标准
很多初学者在学习 Python 时容易陷入“看过即学会”的假象,或者在基础阶段花费过多时间去机械背诵冷门语法。Python 的基础内容具有明确的工程分界线:掌握基础语法的目的,是为后续的自动化脚本、Web 开发、数据分析或爬虫提供稳定且规范的编程直觉,而非成为语言规范的字典。
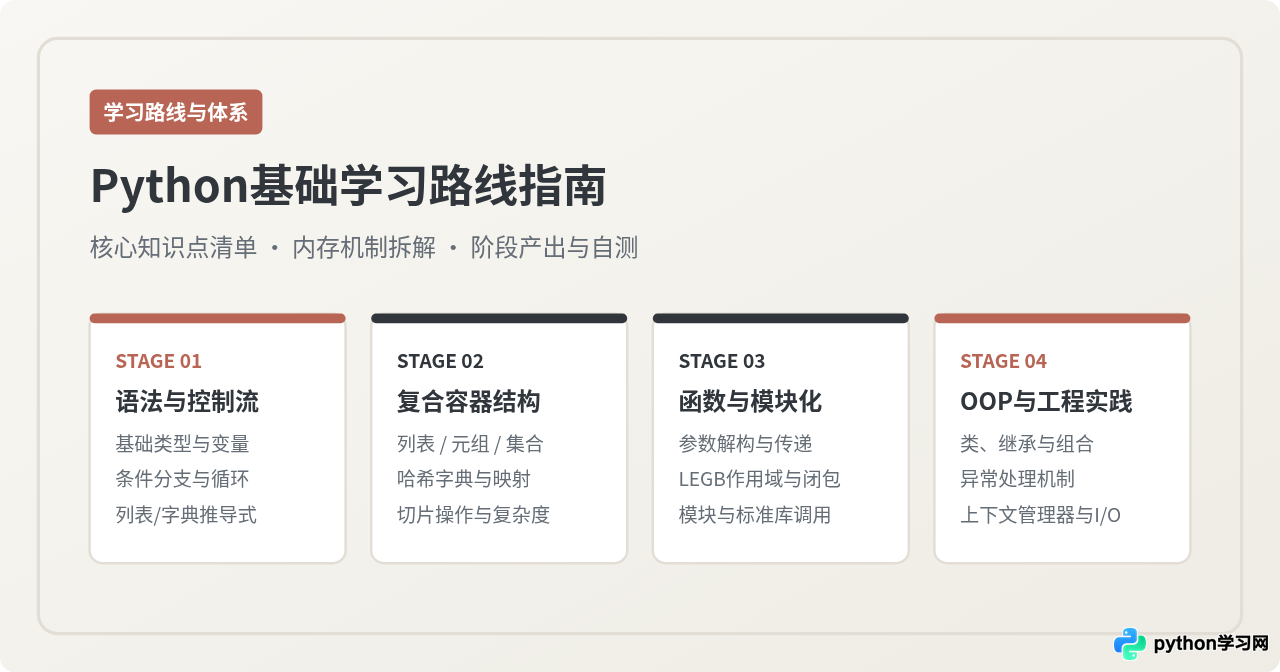
为了保证学习过程具备清晰的正向反馈,建议将基础学习划分为四个线性推进的阶段:每个阶段都有明确的输入知识、核心训练焦点以及可量化检验的产出标志。只有完成当前阶段的产出检验,再进入下一阶段,学习效率才能得到保障。
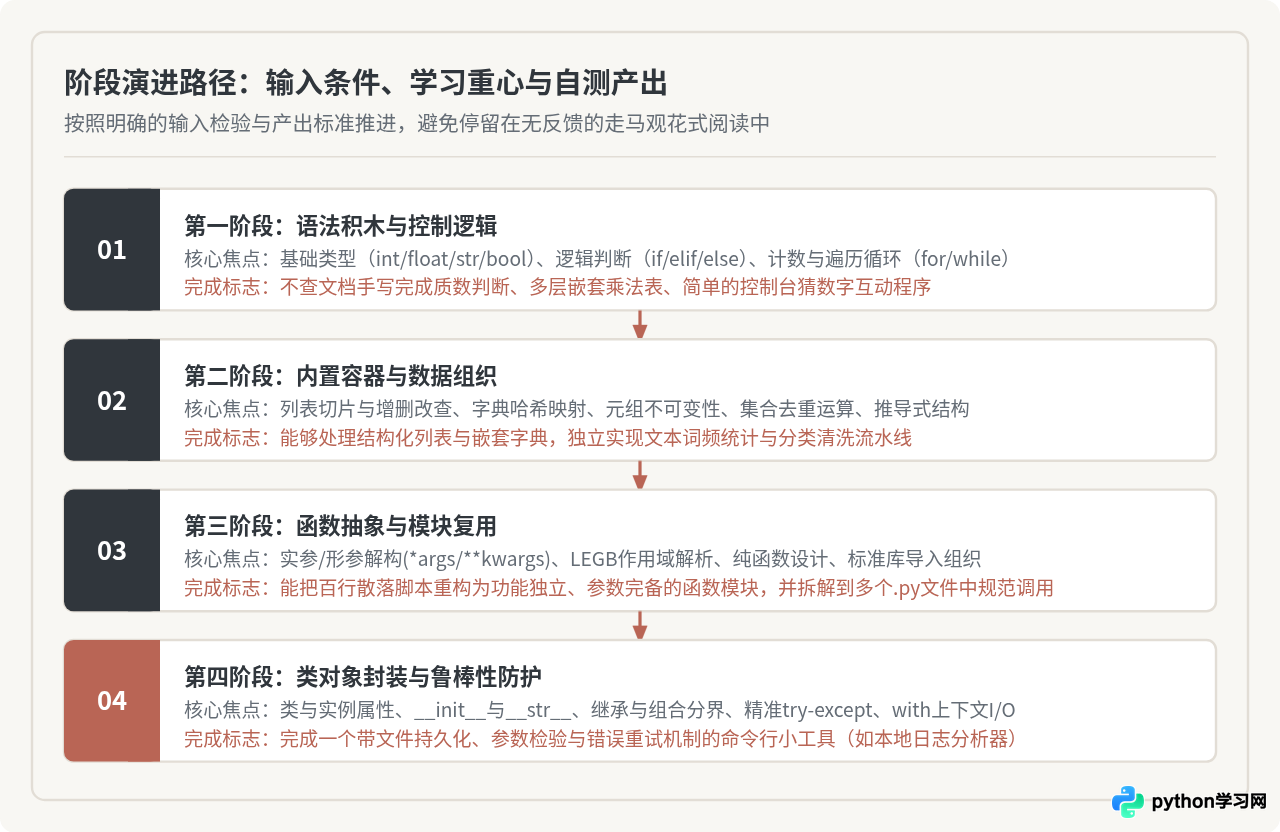
从阶段 01 到 04,复杂度逐渐从单点语法扩展到程序组织结构:
- 第一阶段(语法基石与控制流): 核心是建立计算机程序的“时序执行”直觉。掌握 int、float、str、bool 四种核心数据形态,熟练组合 if 分支与 for/while 循环,能够利用嵌套循环和边界判断实现基础算法。
- 第二阶段(核心容器与数据建模): 真实世界的数据很少是单一数值,必须学会使用列表、元组、字典、集合去表达结构化信息。该阶段必须掌握不同容器的读写特性、遍历方法以及列表推导式的构造。
- 第三阶段(函数抽象与模块复用): 告别“自上而下一行写到底”的流水账代码。学习用函数将独立逻辑封装为黑盒,透彻理解位置参数、默认参数、动态解构(
*args与**kwargs),并掌握模块拆分和导入机制。 - 第四阶段(面向对象基础与健壮性防护): 掌握类与实例的职责边界,学习通过
__init__维护对象状态;同时掌握基于try-except-finally的防御性编程与with上下文管理器,确保文件和外部资源安全释放。
二、Python 基础核心知识点清单
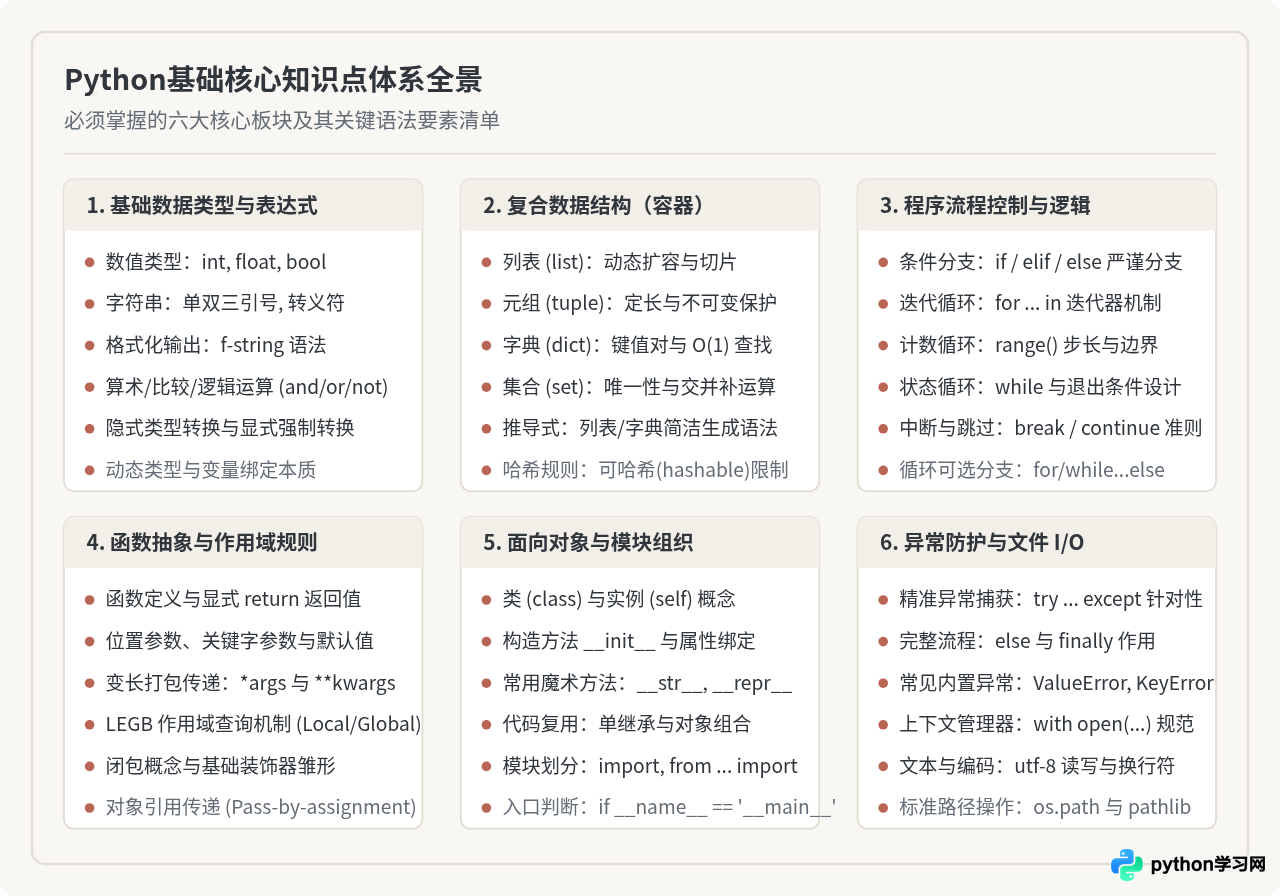
针对上述四个阶段,以下梳理出不容遗漏的核心技术清单。在日常练习中,应当以这份知识拓扑为基准核对自己的盲区,确保每一个核心知识点都有对应的代码编写经验。
1. 基础数据类型与常用运算
Python 是一门动态强类型语言。所谓“动态”,是指变量无需显式声明类型,赋值即绑定;所谓“强类型”,是指不同类型之间不会发生隐式意外转换(例如字符串与整数相加会直接抛出 TypeError,而不是静默将整数拼接为字符串)。
- 数值运算与精度控制: 掌握加减乘除、整除(
//)、取模(%)与幂运算(**)。需注意浮点数在底层采用 IEEE 754 标准存储,例如0.1 + 0.2 != 0.3,涉及高精度金融计算时需要了解decimal模块。 - 字符串核心操作: 掌握切片语法
s[start:stop:step],掌握常用内置方法如strip()、split()、join()、replace()。格式化输出优先使用 Python 3.6 引入的f-string(例如f"用户: {name}, 余额: {balance:.2f}"),其执行效率和可读性均优于%操作符和format()。 - 布尔值与逻辑运算: 掌握
and、or、not的短路求值特性。在 Python 中,空字符串""、数字0、空容器[]、{}以及None在条件判断中均被评估为假(Truthy / Falsy 机制)。
2. 程序流程控制:分支与循环
控制流决定了代码的执行路径。在编写分支与循环时,核心是保持判断逻辑的平铺与清晰,避免过度嵌套。
# 示例:循环与条件分支的典型结构(统计并筛选及格成绩)
scores = [78, 59, 92, 45, 88, 60]
passed_records = []

for score in scores:
    if score < 0 or score > 100:
        print(f"无效分值: {score},跳过")
        continue
    if score >= 60:
        passed_records.append(score)

print(f"及格人数: {len(passed_records)}, 及格分均值: {sum(passed_records) / len(passed_records):.1f}")在循环控制中,需要熟练掌握以下控制关键字的边界条件:
break:立即终止当前所在的最内层循环,直接跳至循环外部语句。continue:跳过本次迭代中尚未执行的剩余语句,直接进入下一次循环条件判定。for ... else:Python 特有的语法糖结构。只有当循环完整执行完毕且没有触发break时,才会执行else代码块,非常适合用于线性查找判定。
3. 内置数据结构:特性、选型与性能
容器是程序组织数据的核心。选择恰当的容器不仅关系到代码的清晰度,还直接决定了程序的运行时间复杂度。
| 容器类型 | 是否有序 | 是否可变 | 主要操作时间复杂度 | 典型应用场景 |
|---|---|---|---|---|
| 列表 (list) | 有序 | 可变 | 末尾追加 O(1),按索引读取 O(1),中间插入/删除 O(n) | 动态序列、队列基础结构、批量记录收集 |
| 元组 (tuple) | 有序 | 不可变 | 按索引读取 O(1),不可新增或删除 | 函数多返回值打包、只读配置、字典的复合键 |
| 字典 (dict) | 保持插入序 | 可变 | 根据键读写与删除平均 O(1) | 关联映射、数据库单条记录映射、高频哈希检索 |
| 集合 (set) | 无序 | 可变 | 元素添加、删除与成员检测 (in) 平均 O(1) | 快速去重、关系交并补运算、大样本成员存在性检查 |
初学者容易忽视的是容器的推导式(Comprehension)语法。列表推导式、字典推导式不仅语法简练,在 CPython 解释器内部也是基于字节码优化的紧凑循环,其运行效率通常优于显式 append 循环:
# 列表推导式与字典推导式示例
raw_users = [("alice", 28), ("bob", 19), ("charlie", 35)]

# 提取年龄大于 20 的用户名(大写)
adult_names = [name.upper() for name, age in raw_users if age > 20]

# 构建以姓名为键、年龄为值的哈希映射
user_map = {name: age for name, age in raw_users}

print("adult_names:", adult_names)
print("user_map:", user_map)4. 函数抽象、作用域与闭包机制
函数是解决代码重复和隔离复杂度的核心手段。编写函数时,需要清晰定义入参契约与返回值:
- 参数传递机制: Python 仅支持“对象引用传递(Pass by assignment)”。如果传递不可变对象(如数值、字符串、元组),函数内修改不会影响外部;如果传递可变对象(如列表、字典),在函数内原地修改会直接影响外部对象。
- 不定长参数与解构:
*args将多余的位置参数打包为元组;**kwargs将多余的关键字参数打包为字典。在调用端,func(*lst)与func(**d)则执行逆向解构展开。 - LEGB 作用域查找链: Python 解析变量名时,严格按照局部作用域(Local)→ 嵌套闭包作用域(Enclosing)→ 模块全局作用域(Global)→ 内置作用域(Built-in)的顺序向上查找。若需在函数内部修改全局变量,必须显式声明
global;若在闭包中修改外层非全局变量,使用nonlocal。
5. 面向对象编程(OOP)与模块组织
当业务逻辑中“数据”与“对数据的操作方法”高度耦合时,面向对象提供了极佳的封装单元。在基础阶段,无需追求复杂的继承体系,掌握核心封装与组合模式即可:
class BankAccount:
    '''银行账户基类:展示状态封装与基础防御'''
    def __init__(self, owner: str, balance: float = 0.0):
        self.owner = owner
        self.balance = float(balance)

    def deposit(self, amount: float) -> float:
        if amount <= 0:
            raise ValueError("存款金额必须大于 0")
        self.balance += amount
        return self.balance

    def withdraw(self, amount: float) -> float:
        if amount > self.balance:
            raise ValueError("账户余额不足,提现被拒绝")
        self.balance -= amount
        return self.balance

    def __str__(self) -> str:
        return f"<BankAccount: owner={self.owner}, balance={self.balance:.2f}>"

acc = BankAccount("张三", 1000)
acc.deposit(500)
print(acc)关于模块组织,需要形成标准文件意识:
- 将可复用类或函数写入独立的
.py文件(如utils.py),在业务脚本中通过import utils或from utils import BankAccount引入。 - 在每个可执行脚本末尾使用
if __name__ == '__main__':保护主程序,确保当该脚本被其他模块导入时,测试逻辑不会被自动触发。
6. 异常工程与上下文管理器(with 规范)
真实环境中的代码必须具备应对错误的能力。文件不存在、网络中断、数值转换失败等都是不可避免的运行时异常,严禁使用裸写 except: pass 来静默掩盖错误。
# 推荐的异常捕获与文件读取模式
import os

def load_config_items(filepath: str) -> dict:
    if not os.path.exists(filepath):
        raise FileNotFoundError(f"配置文件缺失: {filepath}")

    result = {}
    try:
        # 使用 with 语句确保即使发生异常也能自动关闭文件句柄
        with open(filepath, "r", encoding="utf-8") as f:
            for line_no, raw_line in enumerate(f, start=1):
                line = raw_line.strip()
                if not line or line.startswith("#"):
                    continue
                if "=" not in line:
                    raise ValueError(f"第 {line_no} 行格式非法,缺少 '=': {line}")
                k, v = line.split("=", 1)
                result[k.strip()] = v.strip()
    except UnicodeDecodeError as err:
        print(f"文件编码解析失败,请确认为 UTF-8 编码: {err}")
        raise
    return result
三、深层原理:变量引用、内存可变性与避坑指南
Python 初学者在编写代码时遇到的很多奇怪 Bug,例如“为什么修改了 b,a 也跟着变了”或者“为什么多次调用同一个函数列表越来越长”,根源都来自对 变量引用机制 与 对象可变性(Mutability) 的误解。
在 Python 中,变量从来不是“盛放数值的盒子”,而是贴在堆内存对象上的标签名。赋值语句 a = b 只是把 a 这个标签贴到了 b 当前指向的同一个内存对象上,并没有在内存中开辟新的独立副本。
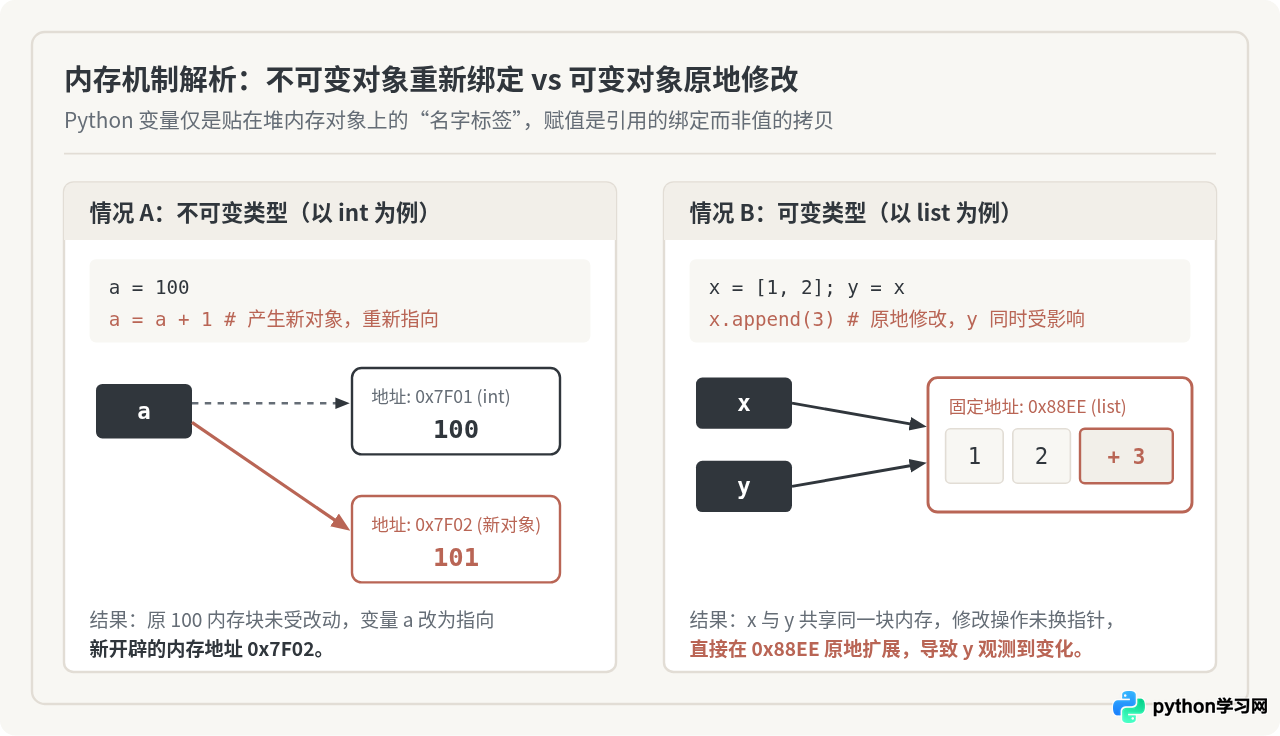
- 不可变对象(int, float, str, tuple, frozenset): 内存中一旦创建,其内部内容永远无法被修改。任何针对不可变对象的运算(如
+=、字符串拼接、元组替换),本质上都是在内存中开辟了一个全新的对象,并将变量名重新指向新对象。 - 可变对象(list, dict, set): 对象占据的堆内存块可以通过其内部方法(如
append(),pop(),update())直接进行原地(in-place)变更,对象的物理内存地址保持不变。
最为致命的代码陷阱:默认参数为可变对象
在函数定义中,默认参数的值是在模块加载、函数被定义的那一刻创建并评估的,而不是在每次函数被调用时创建。如果在默认参数中指定了可变对象(如 def add_item(val, target=[])),那么所有的调用都会共享同一个列表实例:
# 错误示范:可变默认参数跨调用状态污染
def append_bad(val, container=[]):
    container.append(val)
    return container

print(append_bad("A"))  # 输出: ['A']
print(append_bad("B"))  # 输出: ['A', 'B'] —— 状态发生了串扰!

# 正确标准实践:使用 None 作为哨兵值,在函数体内部动态创建
def append_good(val, container=None):
    if container is None:
        container = []
    container.append(val)
    return container

print(append_good("A"))  # 输出: ['A']
print(append_good("B"))  # 输出: ['B'] —— 符合独立调用预期
四、高效学习与代码实践建议
掌握知识清单并不等同于能够自如地编写程序。很多学习者在看完教程后面对空白编辑器依然无从下手,这是典型的“输入过多、输出过少”导致的阻抗。以下给出四条针对基础阶段的具体实操建议:
1. 坚持“单点验证 → 脚本拼装”的递进编写法
不要尝试一开始就从第一行直接写出几百行的复杂程序。合理的工作流是:
- 在 Python 交互式命令行(REPL)或简单的单文件草稿中,先验证一个具体的语法点。例如:测试一个字符串切片是否正确截取了目标文本,或者测试一个正则表达式是否能够匹配目标键值。
- 验证确认无误后,再将这段经过验证的代码抽象为一个具备明确输入输出的函数,放入主脚本中。
- 通过这种方式积累代码,每一步都处于可掌控的确定状态中。
2. 学会阅读 Traceback 报错信息
Python 的异常回溯信息(Traceback)是最高效的调试帮手。遇到报错时,严禁看到一堆英文就慌张地关闭终端:
- 直接看最后一行: 最后一行的异常类型和描述(例如
IndexError: list index out of range或KeyError: 'user_id')清晰地说明了问题的性质。 - 看倒数第二段的文件与行号: 定位到自己编写的业务代码所在的具体行号,回溯当前行参与运算的变量到底处于什么状态。
- 通过断点或打印排查: 在问题代码前加入
print(f"DEBUG: {var=}, {type(var)=}"),或者在代码中加入breakpoint()唤出交互式调试器,直接查看现场变量内存。
3. 严格遵循 PEP 8 编码规范
代码不仅是写给解释器运行的,更是写给人阅读和维护的。从写下第一行 Python 代码开始,就应当建立规范意识:
- 缩进统一使用 4 个空格,严禁混用 Tab 与空格。
- 变量名、函数名统一采用蛇形命名法(
snake_case,如user_account_list);类名采用大驼峰命名法(PascalCase,如DataProcessor);全局常量全部大写(如MAX_BUFFER_SIZE = 1024)。 - 二元运算符两侧保留一个空格,逗号后面保留一个空格。
4. 摒弃无意义的刷题,聚焦于“完整微型项目”
做十道脱离业务背景的纯算法题,往往不如完整写一个具备实际用途的微型项目。推荐的三个基础阶段练手题目:
- 本地日志关键词统计工具: 读取本地 Nginx/应用日志文本,统计每小时 404 或 500 报错频次,将排名前 10 的异常 IP 输出到新文本中(综合运用文件 I/O、异常处理、字典计数、排序)。
- 命令行待办事项清单(CLI Todo): 支持通过终端参数输入 add/list/done 命令,将任务存储为本地 JSON 文件,支持持久化读写与状态标记(综合运用
sys.argv、列表/字典操作、JSON 序列化、面向对象)。 - 简易学生成绩与档案管理系统: 支持按学号录入、计算各科均分与中位数、导出格式化成绩单(综合运用函数拆分、模块导入、类属性封装、推导式与排序)。
五、基础掌握度自测复盘模型
怎样才算“Python 基础已经学扎实,可以进入进阶方向”?可以通过以下四个维度进行全方位自测。若能够在不依赖外部 AI 逐行辅助、仅查阅官方语法文档的前提下独立完成下列判定,说明基础已经完全过关。
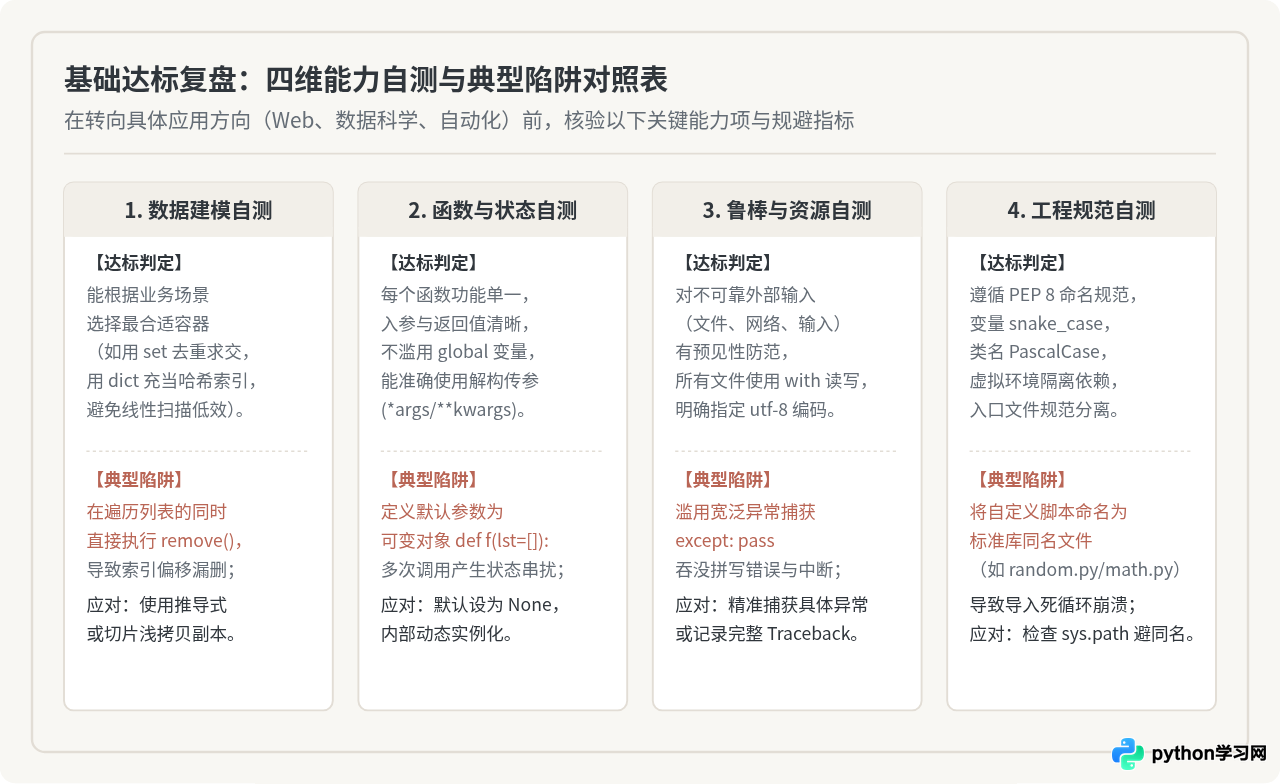
四维达标验收清单
- 【维度一:数据建模与容器掌控度】
面对一组具有复杂关联的数据(例如用户、订单、交易流水),能否自如地设计出嵌套数据结构(如字典内嵌列表,列表中包含元组或对象)?在处理海量查重或关联计算时,能否下意识选择
set/dict将时间复杂度从 O(n) 降为 O(1)? - 【维度二:函数边界与代码解耦度】
写出的函数是否做到了“单一职责”?函数的入参、返回值是否干净透明,杜绝了无意的全局变量读写?是否理解解构传参(
*args/**kwargs)并能正确避开可变默认参数陷阱? - 【维度三:环境适应性与资源鲁棒性】
对于外部不可控输入(文件缺失、格式损坏、网络超时、用户非法字符输入),程序是否能够优雅捕获特定异常并给出友好提示,而不是直接让整个程序崩溃退出?所有文件和网络句柄是否均使用了
with语句保证及时关闭? - 【维度四:工程模块化与规范意识】
是否掌握了
venv虚拟环境的创建与隔离操作?能否将超过 300 行的代码合理拆分到 2~3 个独立的模块中并规范组织import引用?代码排版是否整体符合 PEP 8 规范?
一旦能够顺利通过上述四个维度的自测核验,便不必继续在基础语法中重复打转。此时应当立即根据自己的实际目标,选择一个明确的应用方向深入实践:
- Web 后端开发: 开始接触 HTTP 协议原理,学习主流轻量框架(如 FastAPI、Flask),进而深入数据库 ORM(SQLAlchemy)与接口设计。
- 自动化运维与办公自动化: 学习标准库
subprocess、第三方自动化库(如requests,playwright,openpyxl),将重复性手工劳动自动化。 - 数据分析与科学计算: 学习核心三方库 NumPy、Pandas 的向量化数据清洗方法,掌握 Matplotlib/Seaborn 的数据可视化。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









