

python必背源代码字典转DataFrame代码
详细讲解 Python 中将字典转换为 pandas DataFrame 的核心必背源代码,覆盖列表字典、标量字典、嵌套字典及常见报错解决全流程。
一、最常用基础形态:列表型字典直接转 DataFrame
在日常数据清洗中,最标准的字典结构是“键为字段名称,值为等长列表或元组”。针对这种列对齐格式,直接调用 pandas.DataFrame() 构造器即可完成转换,这也是数据分析人员必须熟记的核心语法。
import pandas as pd

# 键为列名,值为等长数据列表的标准字典
data = {
    'name': ['张三', '李四', '王五'],
    'age': [24, 28, 22],
    'city': ['北京', '上海', '广州']
}

# 核心代码:直接转为 DataFrame
df = pd.DataFrame(data)

print(df)name age city 0 张三 24 北京 1 李四 28 上海 2 王五 22 广州
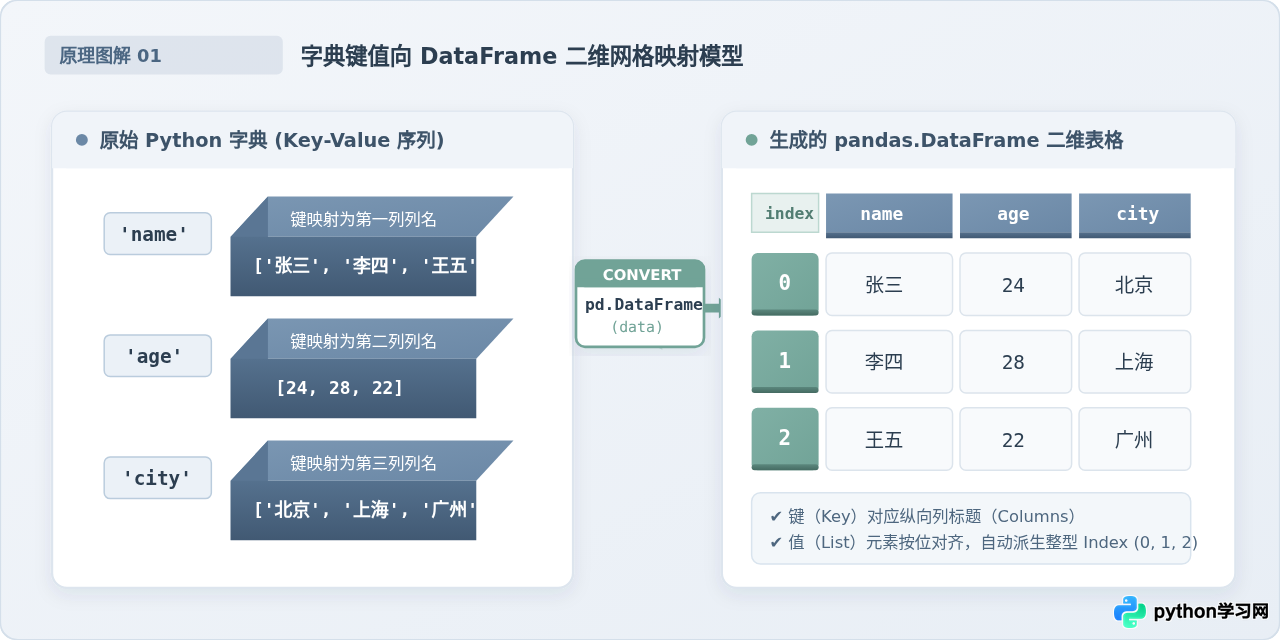
这段代码中,字典的每一个键(Key)会自动成为 DataFrame 的列头(Columns),而列表中按顺序排列的元素则纵向填充为各行的单元格值。若未额外指定行索引,pandas 会自动生成从 0 开始递增的整型索引。
二、核心操作路径:字典转换四步操作法
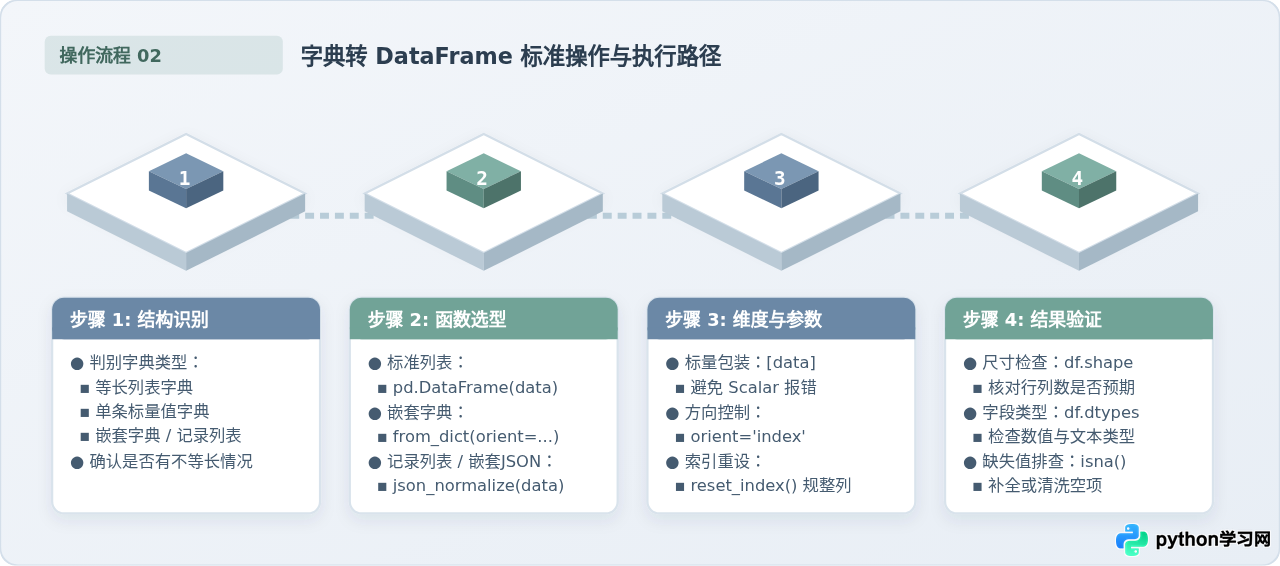
面对来源多样的字典数据,不加判断直接调用转换函数常常会遇到语法报错或行列倒置的问题。建议遵循标准的数据规整流程,先确认数据维度,再确定方法与参数。
- 结构识别:检查待转换的字典是标量值键值对、等长列表字典,还是嵌套字典。
- 函数选型:根据数据结构选择直接构造
pd.DataFrame()、调用工厂方法pd.DataFrame.from_dict()还是扁平化工具pd.json_normalize()。 - 维度与参数对齐:对单条记录包裹列表,对嵌套字典根据业务需求设定
orient='index'或orient='columns'。 - 结果校验:使用
df.shape检查行数列数,通过df.dtypes确认列数据类型,防止类型被推导为混合对象(object)。
三、必背典型场景与核心源代码
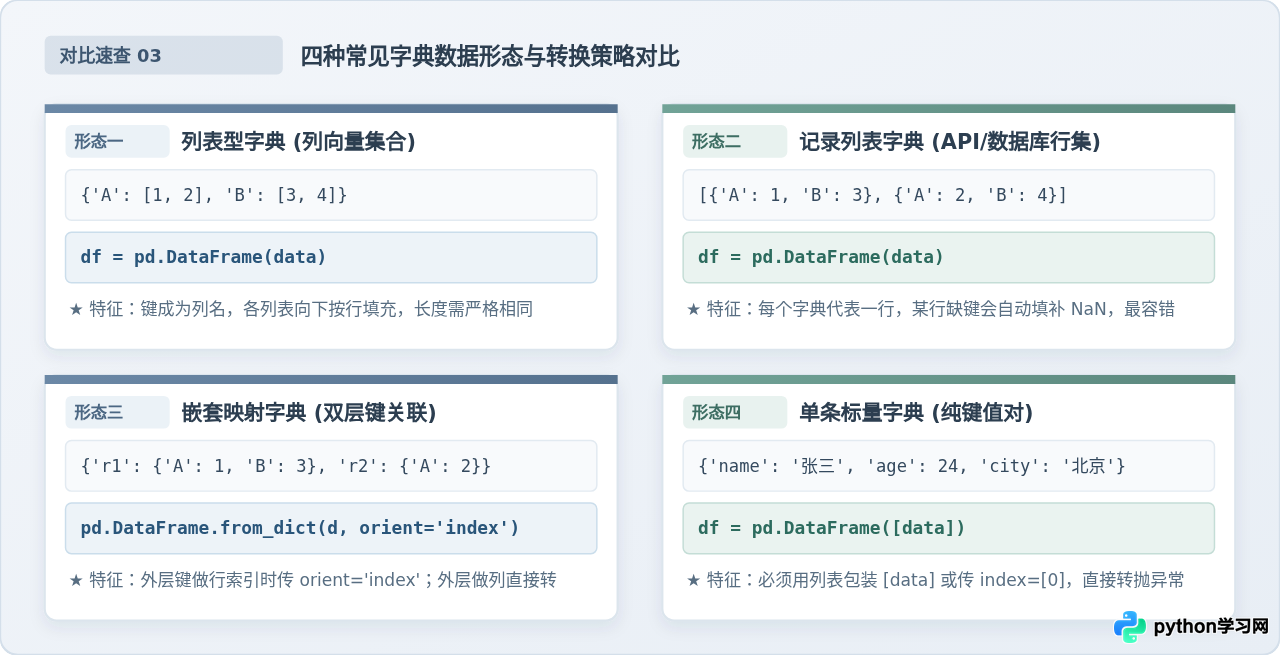
除了标准的列向量字典外,实际开发中还会频繁遇到四类特殊字典形态。针对不同形态,需背记对应的正确写法。
1. 单条标量字典转换(避免 ValueError 报错)
当字典中的值全部为单个标量(例如数字、字符串)时,直接执行 pd.DataFrame(data) 会抛出经典报错:ValueError: If using all scalar values, you must pass an index。这是因为 pandas 无法从纯标量中推断数据行数。
import pandas as pd

user_info = {'name': '张三', 'age': 24, 'city': '北京'}

# 推荐解法:将字典置于列表中,作为单条记录传入
df_single = pd.DataFrame([user_info])

print(df_single)name age city 0 张三 24 北京
pd.DataFrame(user_info, index=[0]);若目标是将键和值分别作为两列展示,则可使用 pd.DataFrame(list(user_info.items()), columns=['Field', 'Value'])。
2. 记录列表型字典转换(API 返回标准格式)
多数 RESTful API 返回的 JSON 列表形态为“由多个字典组成的列表”,每个字典代表数据库的一条记录。pandas 原生直接支持这种格式解析。
import pandas as pd

# 列表内每个元素为一个字典行记录
records = [
    {'id': 101, 'product': '键盘', 'price': 299},
    {'id': 102, 'product': '鼠标', 'price': 129},
    {'id': 103, 'product': '显示器', 'price': 1499}
]

# 直接转换,也可以显式调用 pd.DataFrame.from_records(records)
df_records = pd.DataFrame(records)

print(df_records)id product price 0 101 键盘 299 1 102 鼠标 129 2 103 显示器 1499
3. 嵌套字典转换与方向控制(orient 参数)
当字典内部还包含子字典时,若直接使用 pd.DataFrame(nested_dict),默认会将外层字典的键解析为“列名”,内层字典的键解析为“行索引”。若需要将外层键作为行记录(行名),必须借助 from_dict 并显式指定 orient='index'。
import pandas as pd

# 嵌套字典:外层键为用户,内层键为指标
scores = {
    '张三': {'语文': 88, '数学': 95, '英语': 90},
    '李四': {'语文': 92, '数学': 85, '英语': 89}
}

# 外层键作为行索引
df_scores = pd.DataFrame.from_dict(scores, orient='index')

# 可选:若希望将外层键转为常规数据列,使用 reset_index
df_scores_clean = df_scores.reset_index().rename(columns={'index': '姓名'})

print("--- 默认行索引模式 ---")
print(df_scores)
print("\n--- 重设索引转为数据列 ---")
print(df_scores_clean)--- 默认行索引模式 ---
语文 数学 英语
张三 88 95 90
李四 92 85 89
--- 重设索引转为数据列 ---
姓名 语文 数学 英语
0 张三 88 95 90
1 李四 92 85 89
4. 列表长度不一致时的容错转换
如果字典中的列表长度不相等,直接调用构造器会抛出 ValueError: All arrays must be of the same length。此时需借助 pandas.Series 进行对齐包装,自动将缺失项填充为 NaN。
import pandas as pd

# 各列列表长度不同
data_uneven = {
    'team': ['A组', 'B组', 'C组'],
    'member_count': [15, 20]  # 缺少第三个元素
}

# 必背解决方案:将每个列表转为 Series,利用 Series 自动索引对齐补齐 NaN
df_uneven = pd.DataFrame({k: pd.Series(v) for k, v in data_uneven.items()})

print(df_uneven)team member_count 0 A组 15.0 1 B组 20.0 2 C组 NaN
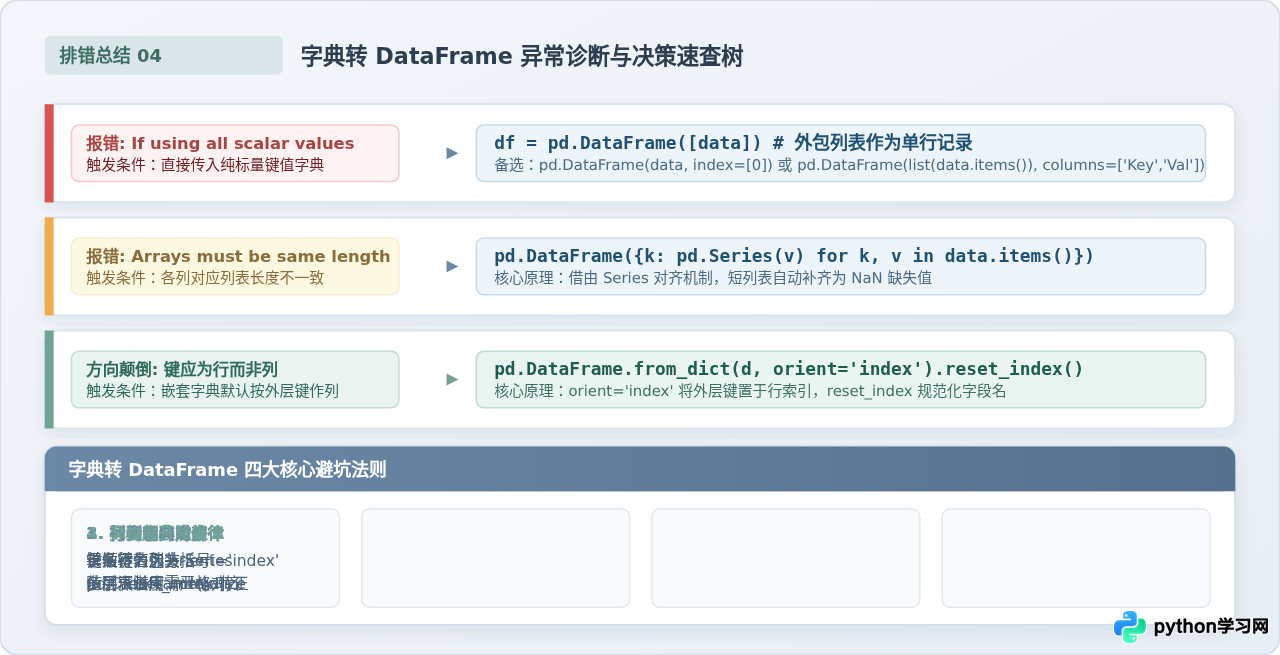
四、常见报错排查与全景速查
在转换过程中,绝大多数问题由以下两类报错引发。理清成因即可在几秒钟内定位并修改代码:
- 报错提示:
ValueError: If using all scalar values, you must pass an index
原因分析:字典内部的值全部都是基础数据类型(如 int, float, str),没有列表或容器结构包裹,pandas 无法推断行数。
解决方法:给字典外套列表,写成pd.DataFrame([data])。 - 报错提示:
ValueError: All arrays must be of the same length
原因分析:键对应的多个列表中,部分列表的元素个数与其他列表不相等。
解决方法:遍历字典将每个 value 转换为pd.Series,由 Series 自动对齐并补全空值。 - 显示效果颠倒:原本期望作为行数据的键被排成了表头列名。
解决方法:改用pd.DataFrame.from_dict(d, orient='index')显式指定行索引。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









