

Python注释中文乱码怎么办
深入解答Python注释中文乱码与报错的完整排查及解决方法。涵盖PEP 263编码声明规范、UTF-8无BOM转换、主流IDE编码配置及Windows终端乱码适配,提供四步排查流程与避坑指南。
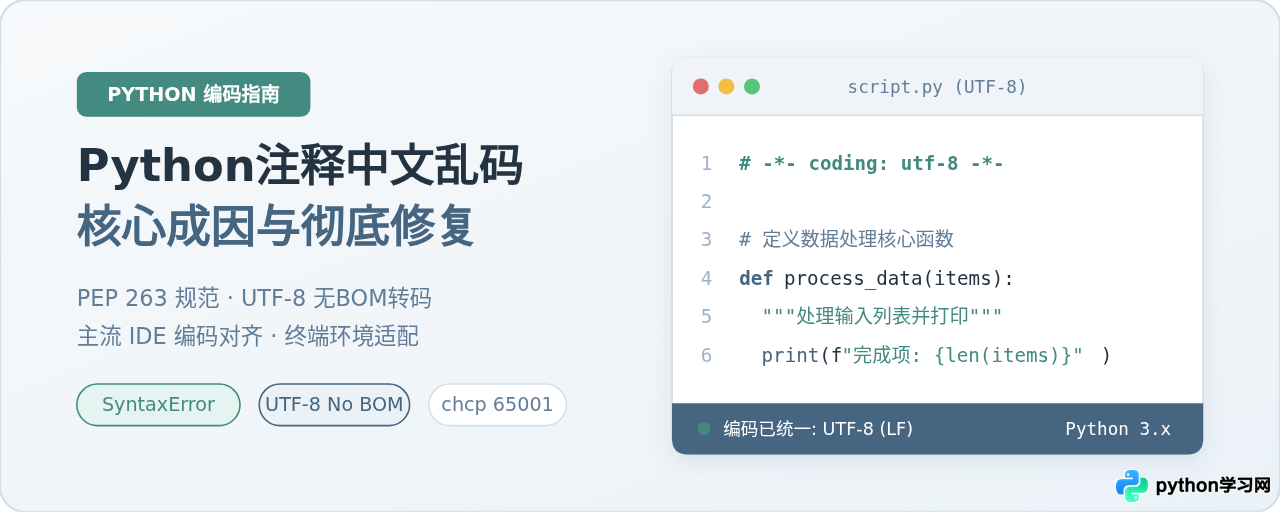
# -*- coding: utf-8 -*- 声明,并在编辑器中将文件另存为“UTF-8 无 BOM”格式。
一、中文注释乱码与报错的典型表现及成因
在日常编写或运行 Python 脚本时,中文注释相关的问题主要分为三类具体现象。搞清楚当前遇到的具体表现,是精准排查问题的前提。
1. 运行时抛出 SyntaxError 异常
最常见的故障是脚本原本运行正常,一旦添加中文注释,执行时控制台便立即报错并终止。典型报错信息如下:
SyntaxError: Non-ASCII character '\xe4' in file test.py on line 3, but no encoding declared; see https://peps.python.org/pep-0263/ for details该错误主要出现在 Python 2 环境,或某些严格限制字符集的运行容器中。Python 解释器在读取脚本文件时,默认将源码视为 ASCII 字符集。由于中文字符的字节编码超出了 ASCII(0~127)的范围,解释器在词法分析阶段就会将其判定为非法字符而抛出语法错误。
2. 编辑器打开时中文显示为“锟斤拷”或菱形问号
脚本运行可能并不报错,但在使用 VS Code、PyCharm 或记事本打开他人编写的代码时,注释中的中文全部变成了火星文、生僻字(如 文档)或带有问号的菱形符号(�)。
这通常发生在跨平台协作场景下:Windows 系统默认使用 GBK/ANSI 编码保存文件,而现代代码编辑器默认以 UTF-8 方式读取文件;或者相反,文件实际是 UTF-8 编码,编辑器却以系统的 GBK 编码进行解码。字节切分错位直接导致汉字显示完全失真。
3. 控制台打印异常信息时中文注释乱码
当 Python 脚本抛出异常回溯(Traceback)或交互式打印包含中文注释的代码行时,在 Windows CMD 或 PowerShell 控制台中显示为一连串不可读字符。这是由于 Windows 控制台代码页(默认 936 为 GBK)与 Python 运行时的标准输出流编码不匹配所致。
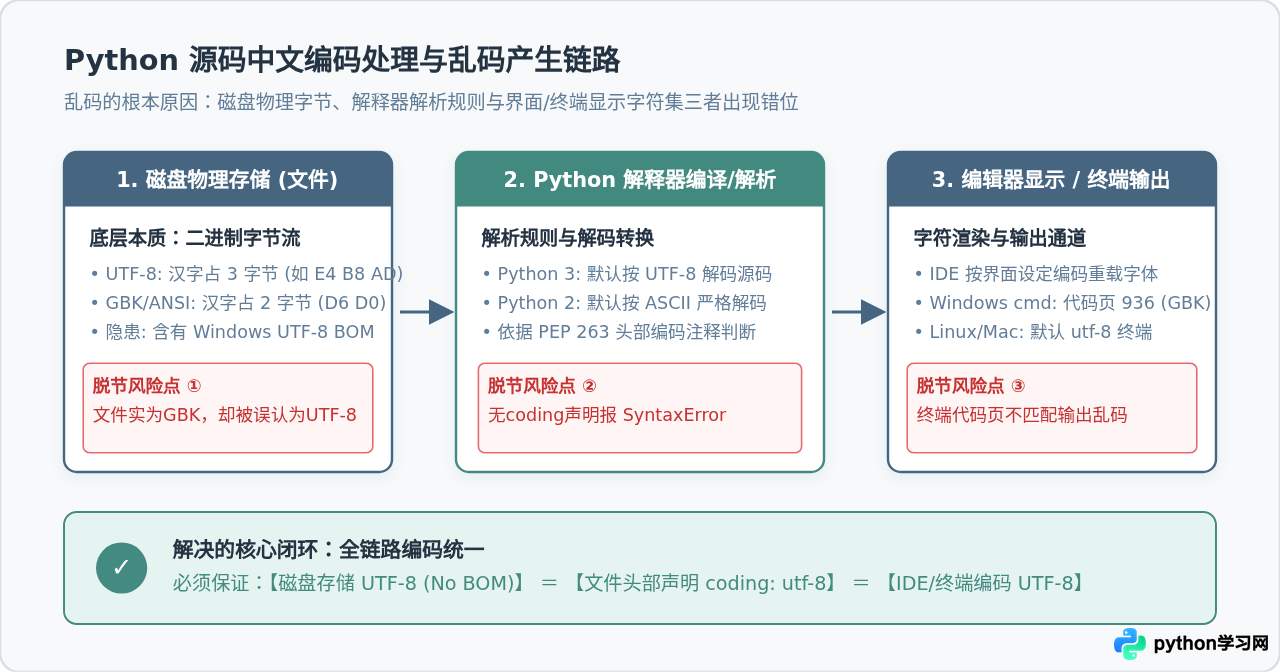
E4 B8 AD),在 GBK 下是 2 个字节(D6 D0)。只要读取方与写入方使用的编码字典不一致,就会产生不可逆的错位乱码。
二、四步标准排查与修复流程
要彻底解决中文注释引起的乱码或报错,请按照以下标准顺序排查并修复:
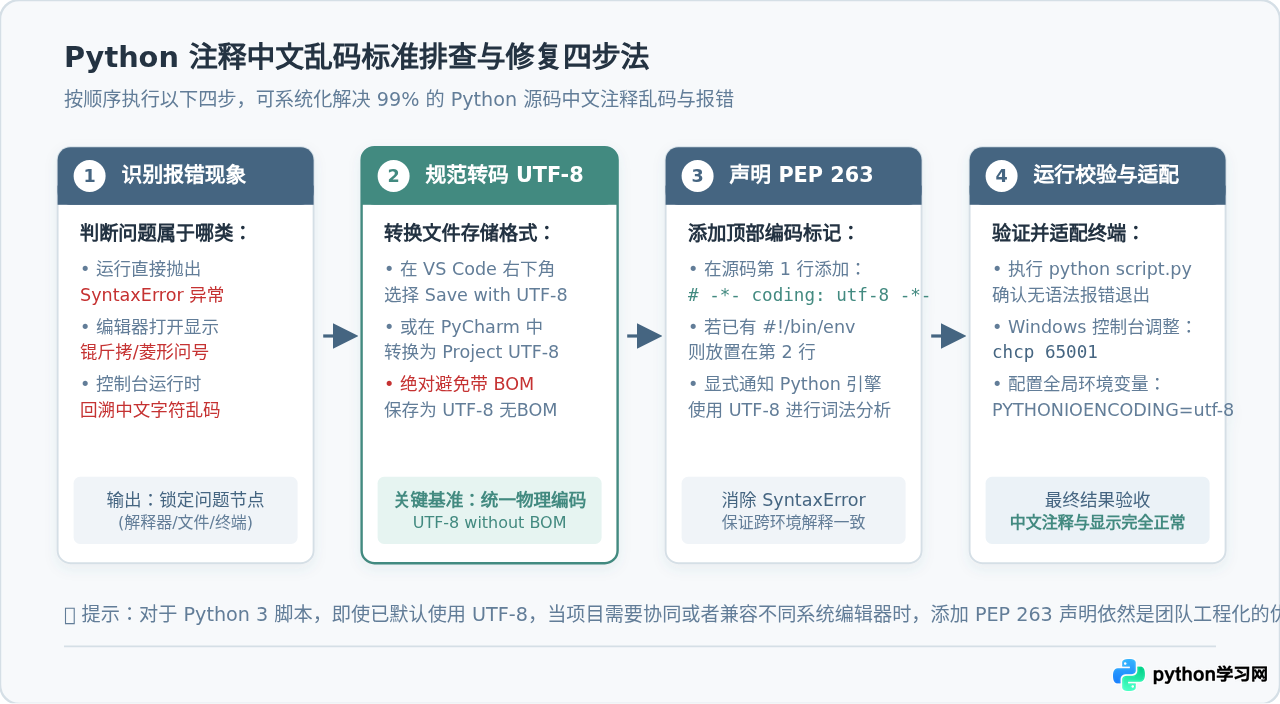
步骤一:在源码文件顶部规范声明编码(PEP 263)
根据 Python 官方规范 PEP 263,如果源文件中包含非 ASCII 字符(如中文注释、中文 docstring 等),必须在文件的第一行或第二行显式声明文件编码。标准写法如下:
# -*- coding: utf-8 -*-如果脚本首行已经指定了解释器路径(Shebang),则将编码声明放在第二行:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-

# 这里书写中文注释:计算圆面积
def calculate_area(radius):
    """计算并返回半径为 radius 的圆面积"""
    pi = 3.1415926
    return pi * (radius ** 2)
注意:虽然 # coding=utf-8 或 # coding: utf-8 也是合法写法,但 # -*- coding: utf-8 -*- 是兼顾 GNU Emacs 与各类 IDE 识别的最稳妥格式。
步骤二:转换文件磁盘存储格式为“UTF-8 无 BOM”
仅仅在代码头部写上 # -*- coding: utf-8 -*- 并不会自动改变文件本身的磁盘存储格式。如果文件原本是 GBK 编码保存的,头部却声明是 UTF-8,Python 3 解释器在编译时反而会直接抛出致命错误:
SyntaxError: (unicode error) 'utf-8' codec can't decode byte 0xd6 in position 12: invalid continuation byte因此,必须确保文件在磁盘上的真实存储格式与头部声明完全一致。在编辑器中将文件另存为 UTF-8,且必须选择 无 BOM(without BOM) 格式。
步骤三:检查并统一开发工具的默认编码
如果在编辑器里看到中文已经是乱码,切勿直接点击保存,否则会把破坏后的乱码字节永久写回磁盘。正确做法是:先让编辑器以原本的编码重新读取,确认中文显示恢复正常后,再通过“另存为 / 转换编码”保存为 UTF-8。
步骤四:适配 Windows 终端与运行环境
若在 Windows 控制台(CMD / PowerShell)中运行脚本时回溯或输出依然出现中文乱码,可在运行脚本前调整控制台活动代码页:
chcp 65001
执行 chcp 65001 会将当前控制台切换为 UTF-8 编码。另外,可在系统环境变量中添加 PYTHONIOENCODING=utf-8,强制 Python 在控制台重定向和管道输入输出时全部采用 UTF-8 编码。
三、主流编辑器具体配置指南
不同编辑器的编码操作位置各不相同。下表与示意图详细对比了主流工具的配置方法:
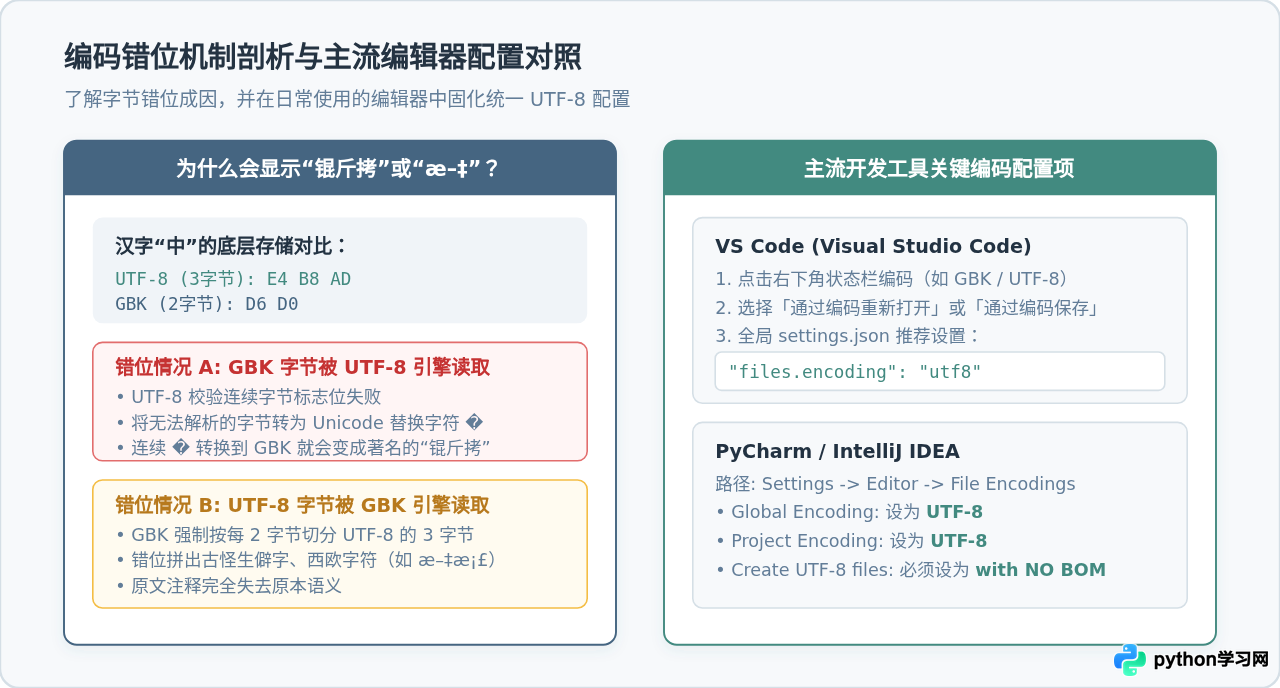
1. Visual Studio Code (VS Code)
- 查看当前编码:观察 VS Code 窗口右下角状态栏,会显示当前文件的编码(例如
UTF-8或GBK)。 - 修复乱码文件:如果文件打开即乱码,点击右下角编码文字,在上方命令面板中选择 「通过编码重新打开」(Reopen with Encoding),选择
GBK或Simplified Chinese (GB2312),直到中文正常显示。 - 转为 UTF-8 保存:再次点击右下角编码,选择 「通过编码保存」(Save with Encoding),选择
UTF-8。 - 全局默认设置:打开设置(快捷键
Ctrl + ,/Cmd + ,),搜索files.encoding,将其设为utf8;同时可开启"files.autoGuessEncoding": true让编辑器自动识别旧文件编码。
2. PyCharm / IntelliJ IDEA
- 打开菜单 File -> Settings (macOS 上为 Preferences)。
- 展开 Editor -> 点击 File Encodings。
- 将 Global Encoding 设为
UTF-8。 - 将 Project Encoding 设为
UTF-8。 - 在下方 Create UTF-8 files 下拉框中,选择 with NO BOM。
- 对于已存在单文件的编码修复,在编辑窗口右下角点击当前编码进行
Reload in GBK/Convert to UTF-8切换。
3. Windows 记事本与 Notepad++
Windows 记事本在另存为时,编码下拉框务必选择 UTF-8(Windows 10/11 的记事本默认即为无BOM的UTF-8)。在 Notepad++ 中,点击顶部菜单 编码 -> 选择 转为 UTF-8 编码(注意不要误选为“转为 UTF-8-BOM 编码”),然后保存即可。
四、常见陷阱与避坑指南
在排查中文注释乱码时,以下三个容易被忽略的细节往往会导致反复排查失败:
微软早期软件在保存 UTF-8 时,喜欢在文件最开头加入 3 个不可见字节(
0xEF, 0xBB, 0xBF,即 Byte Order Mark)。Python 3.0-3.3 以及老版本工具在解析带 BOM 的源码时,会将这三个不可见字节当作非法字符,抛出 SyntaxError: invalid character in identifier。务必确认保存格式为 UTF-8 without BOM。
有的开发者复制了
# -*- coding: utf-8 -*- 粘贴到代码里,但没有通过编辑器重新保存编码,文件底层依旧是 ANSI/GBK。这会直接导致 Python 解释器在用 UTF-8 引擎强行解码 GBK 汉字时崩溃。牢记:声明是给解释器看的,文件转换是底层物理操作,两者必须配套。
团队协作时,Windows 开发者新创建的文件容易继承系统默认的 ANSI 格式。建议在项目根目录下创建
.editorconfig 文件,强制所有团队成员的 IDE 统一行为:
# .editorconfig 示例
root = true

[*]
charset = utf-8
end_of_line = lf
insert_final_newline = true
indent_style = space
indent_size = 4
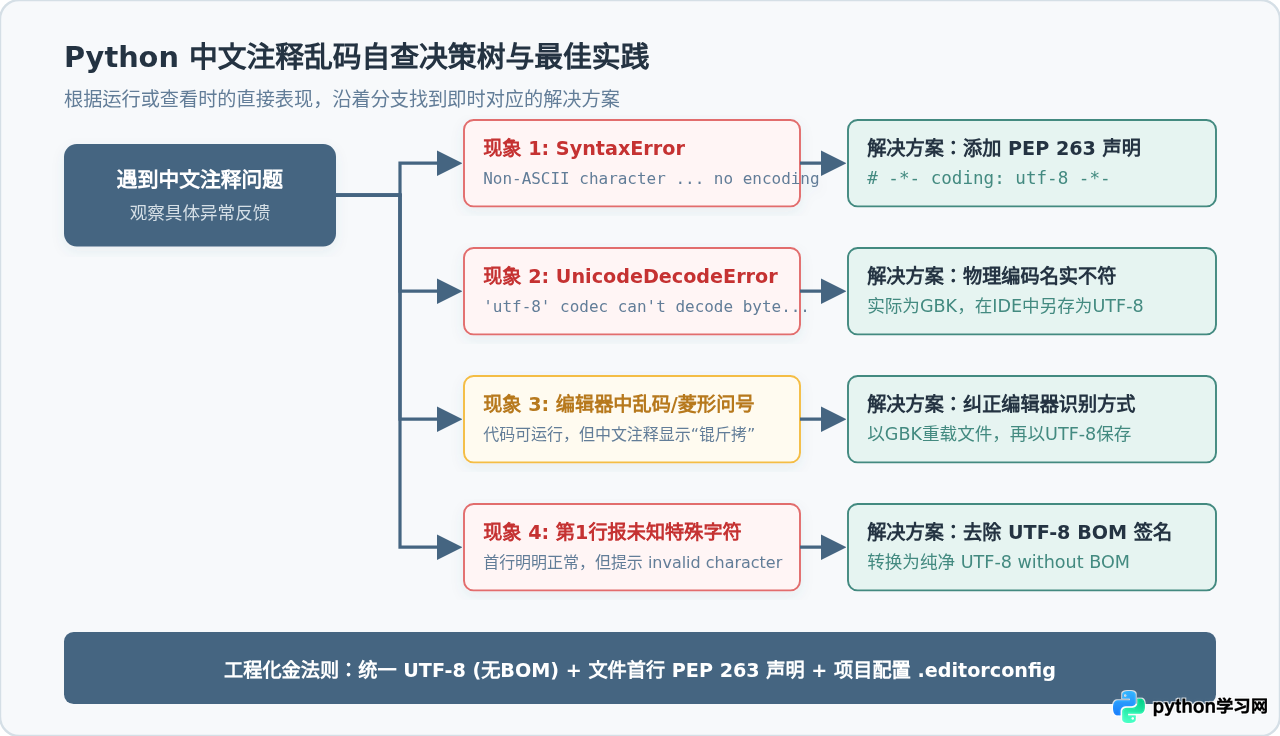
五、自查总结清单
遇到 Python 中文注释乱码或报错时,对照以下清单逐项勾选,即可在 1 分钟内完成诊断:
| 检查项 | 标准状态 | 未达标时的异常现象 |
|---|---|---|
| 1. 首行编码声明 | 包含 # -*- coding: utf-8 -*- |
Python 2 报 SyntaxError: Non-ASCII character |
| 2. 磁盘物理编码 | UTF-8 无 BOM (without BOM) | Python 3 报 UnicodeDecodeError 或开头非法字符 |
| 3. 编辑器打开模式 | UTF-8 解码模式 | 编辑器内中文显示为 锟斤拷 或乱码字符 |
| 4. Windows 控制台 | 代码页 65001 (chcp 65001) |
终端打印报错回溯时中文出现乱码 |
只要在项目启动之初养成“首行声明编码、编辑器默认 UTF-8 无BOM、纳入 .editorconfig 配置”的工程化习惯,即可彻底杜绝 Python 中文注释乱码问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









