

Python中文字符串排序乱码或顺序不对怎么办
针对Python中文字符串排序时出现的乱码、生僻字位置异常或未按拼音字母顺序排列等问题,本文深入解析Unicode码点排序与GBK编码排序机制,提供基于pypinyin库、标准库locale与PyICU的三种解决方案与工程避坑实践。
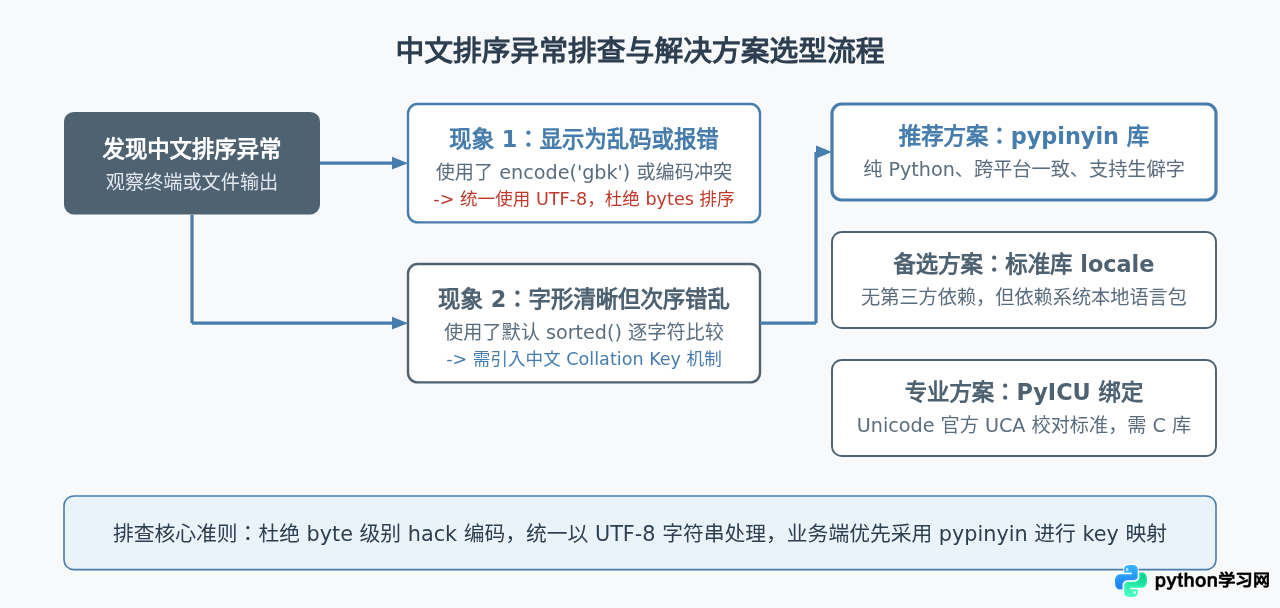
在 Python 中对包含中文的列表使用 sorted() 或 list.sort() 时,程序默认按照字符的 Unicode 码点(Code Point)数值进行升序排列,而不是中文拼音字母序。因此常会出现“张三”排在“李四”前面、多音字顺序错乱等“顺序不对”的现象;而若试图采用历史遗留的 x.encode('gbk') 方案,又极易在遇到生僻字、特殊标点或未指定输出编码时引发 UnicodeEncodeError 或终端与文件中的“乱码”。解决该问题的标准做法是使用 pypinyin 库显式提取拼音序列作为排序键(key),或在系统环境完备时调用标准库 locale 模块配置本地化校对规则。
一、原因解析:为什么默认排序既不按拼音又容易出问题
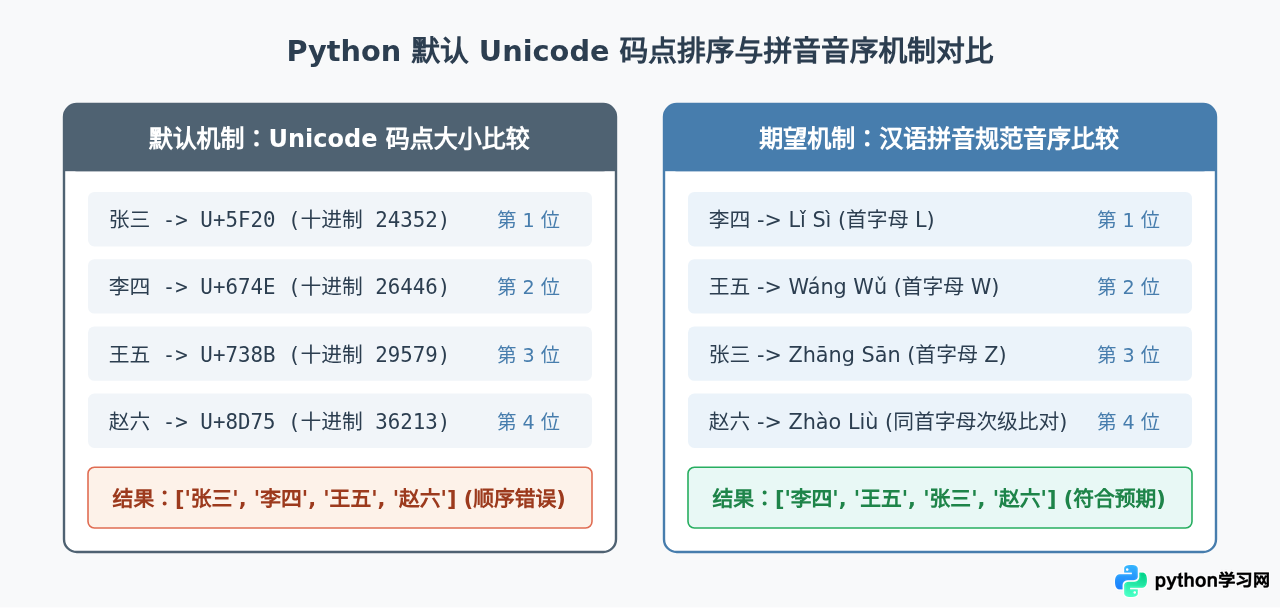
Python 3 内置的字符串对象(str)基于 Unicode 标准实现。当直接调用 sorted(['张三', '李四', '王五', '赵六']) 时,Python 会逐字符比对每个字符的 Unicode 十六进制编码大小:
- “张”:Unicode 码点为
U+5F20(十进制 24352) - “李”:Unicode 码点为
U+674E(十进制 26446) - “王”:Unicode 码点为
U+738B(十进制 29579) - “赵”:Unicode 码点为
U+8D75(十进制 36213)
由于 0x5F20 < 0x674E < 0x738B < 0x8D75,Python 输出的排序结果为 ['张三', '李四', '王五', '赵六']。但在常规汉语言交流与档案管理中,人们普遍期望按拼音首字母排序:李(Lǐ)应该排在王(Wáng)、张(Zhāng)、赵(Zhào)之前。Unicode 汉字区域按照《康熙字典》部首与笔画等历史文献方式统合编排,本身并不具备单语言的拼音音序属性。
二、为什么有的排序方法会导致“乱码”或生僻字异常
部分早期教程或网络片段会建议使用以下写法:
# 存在隐患的旧式写法,切勿直接在生产环境使用
names = ['张三', '李四', '王五', '赵六']
names.sort(key=lambda x: x.encode('gbk'))
该写法的出发点是利用中国国家标准 GB2312 编码表的特性:GB2312 收录的 3755 个常用一级汉字(从 0xB0A1 到 0xD7F9)在制定时确实严格按照汉语拼音字母顺序排布。然而,将其套用在现代 Python 3 场景中存在严重的隐患:
- 二级汉字与人名生僻字次序错乱:GB2312 的 3008 个二级汉字(如“婷”、“睿”、“鑫”、“怡”等常见人名字符)是按部首和笔画排列的,且编码数值全部位于一级汉字之后。若采用
encode('gbk')排序,“赵睿”会被排到“赵六”乃至所有常用字之后,完全破坏拼音排序次序。 - 编码不支持与异常崩溃:遇到 GBK 编码表未覆盖的特殊汉字、emoji 或冷僻字符时,
x.encode('gbk')会直接抛出UnicodeEncodeError。 - 输出乱码现象:如果误将编码后的字节序列(
bytes)保存回文件或打印至终端,而在后续读取时没有正确配对解码(例如在 Windows 默认环境或无 BOM 的 UTF-8 终端中混淆),字符串就会呈现类似\xb0\xa1...或锟斤拷的乱码形态。
排查前请先在交互式命令行中执行 print([repr(s) for s in data])。如果打印出的字符本身包含形如 b'\xc0\xee...',说明数据被误转换成了 bytes;如果显示正常汉字但前后次序不合拼音规则,属于排序键策略问题;如果显示为替代字符,需核查读取源文件时是否显式指定了 open(..., encoding='utf-8')。
三、推荐方案一:使用 pypinyin 实现跨平台音序排序(首选)
pypinyin 是 Python 生态中广泛使用的高质量中文拼音转换库。它的核心优势是纯 Python 实现、零系统本地化依赖、在 Windows、macOS、Linux 以及 Docker 容器环境中行为完全一致,且能正确解析多音字与生僻字。
1. 安装环境
pip install pypinyin2. 基础列表排序
通过 sorted() 的 key 参数指定 lazy_pinyin 函数,Python 会为每个中文字符串生成一个拼音列表(例如 ['li', 'si']),并基于字母表依次比对:
import pypinyin

names = ['张三', '李四', '王五', '赵六', '赵睿']

# 使用 pypinyin.lazy_pinyin 提取无声调拼音列表作为排序键
sorted_names = sorted(names, key=pypinyin.lazy_pinyin)

print("排序结果示例:", sorted_names)
# 示例输出:['李四', '王五', '张三', '赵六', '赵睿']
在此结果中,“李四”(L)位于最前,“王五”(W)居中,“张三”与“赵六”(Z)在后;二级汉字“赵睿”(zhào ruì)紧随“赵六”(zhào liù)之后,完全符合汉语拼音音序。
3. 复杂结构排序(字典或对象列表)
在日常开发中,排序目标通常是字典列表或包含姓名属性的 ORM 对象。此时只需结合 lambda 函数即可:
import pypinyin

user_records = [
    {'id': 101, 'name': '王五', 'score': 92},
    {'id': 102, 'name': '张三', 'score': 88},
    {'id': 103, 'name': '李四', 'score': 95},
    {'id': 104, 'name': '赵六', 'score': 85},
]

# 按照字典中 'name' 字段的拼音排序
sorted_records = sorted(user_records, key=lambda item: pypinyin.lazy_pinyin(item['name']))

# 示例输出列表验证
for record in sorted_records:
    print(f"ID: {record['id']} | 姓名: {record['name']} | 分数: {record['score']}")
4. 进阶处理:声调敏感与同音字精细排序
lazy_pinyin 默认不带声调。如果需要对同音但不同声调的汉字进行严格排序(如“妈 mā”、“麻 má”、“马 mǎ”、“骂 mà”),可以使用带数字声调标识的风格 Style.TONE3:
from pypinyin import pinyin, Style

chars = ['骂', '妈', '马', '麻']

# Style.TONE3 将声调转换为数字后缀:ma4, ma1, ma3, ma2
sorted_chars = sorted(chars, key=lambda s: pinyin(s, style=Style.TONE3))

print("声调排序结果示例:", sorted_chars)
# 示例输出:['妈', '麻', '马', '骂'] (按 ma1, ma2, ma3, ma4 严格升序)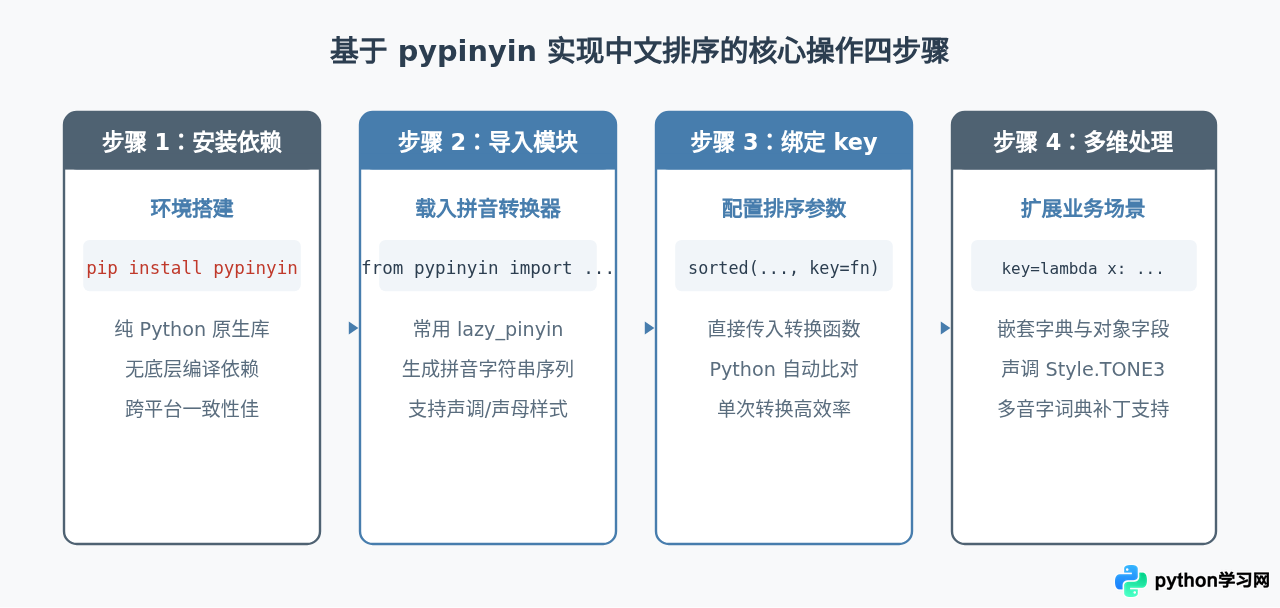
四、备选方案二:使用标准库 locale(无外部依赖环境)
如果运行环境受限,无法通过 pip 安装第三方库,可以利用 Python 标准库自带的 locale 模块配合 functools.cmp_to_key 实现中文本地化比对规则(Collation)。
import locale
import functools

names = ['张三', '李四', '王五', '赵六']

# 针对不同操作系统的 locale 名称进行兼容设置
try:
    # Linux / macOS 常见的 UTF-8 中文区域设置
    locale.setlocale(locale.LC_COLLATE, 'zh_CN.UTF-8')
except locale.Error:
    try:
        # Windows 常见的中文区域设置名称
        locale.setlocale(locale.LC_COLLATE, 'Chinese_China.936')
    except locale.Error:
        # 降级为系统默认环境
        locale.setlocale(locale.LC_COLLATE, '')

# 使用 locale.strcoll 比较函数构造排序 key
sorted_names = sorted(names, key=functools.cmp_to_key(locale.strcoll))

print("locale 排序结果示例:", sorted_names)- 系统本地化包缺失:在精简版的 Linux 发行版(如 Alpine Linux 或轻量 Docker 基础镜像)中,默认不包含
zh_CN.UTF-8语言支持文件,执行locale.setlocale会抛出locale.Error: unsupported locale setting。 - 全局线程安全问题:
locale.setlocale改变的是整个 Python 进程全局的 C 库本地化状态,会影响其他线程的数值格式化、时间解析等操作。
五、高级方案:使用 PyICU 实现标准 UCA 排序
对于对排序有极致严谨要求、涉及大型多语言国际化系统(如国际化搜索索引、多语种档案归档)的项目,推荐使用基于 Unicode Collation Algorithm(UCA)的 PyICU 库:
# 需预先安装底层 ICU 库及 PyICU:pip install PyICU
import icu

names = ['张三', '李四', '王五', '赵六', '赵睿']

# 创建针对中文(zh_CN)的校对器
collator = icu.Collator.createInstance(icu.Locale('zh_CN'))

# 使用 collator.getSortKey 作为排序键
sorted_names = sorted(names, key=collator.getSortKey)
print("PyICU 排序结果示例:", sorted_names)
PyICU 遵循国际 Unicode 联盟最新标准的归约规则,在处理多语种混合、音标变形以及重音符号时具有最高的规范性,但由于需要底层 C++ ICU 库支持,编译安装门槛高于纯 Python 库。
六、常见边界问题与避坑清单
1. 文件保存后用其他程序打开依然显示乱码怎么办?
当 Python 排序逻辑执行完成后,若写入文件时未明确指定编码,Python 会回退到操作系统的默认编码(Windows 上常为 GBK/CP936)。现代工程规范要求全链路显式使用 UTF-8:
# 规范的文件读写模版
with open('input.txt', 'r', encoding='utf-8') as f:
    lines = [line.strip() for line in f if line.strip()]

sorted_lines = sorted(lines, key=pypinyin.lazy_pinyin)

with open('output.txt', 'w', encoding='utf-8') as f:
    for item in sorted_lines:
        f.write(item + '\n')
2. 多音字姓氏(如“单”、“区”、“查”)排序不准怎么办?
在中文人名中,部分姓氏读音与常用字音不同(如“单”作姓氏读 Shàn 而非 Dān,“区”作姓氏读 Ōu 而非 Qū)。pypinyin 支持通过内置词典补丁或自定义词典进行修正:
import pypinyin
from pypinyin import load_phrases_dict

# 针对特殊姓氏进行多音字修正
custom_dict = {
    '单老师': [['shàn'], ['lǎo'], ['shī']],
    '区同学': [['ōu'], ['tóng'], ['xué']]
}
load_phrases_dict(custom_dict)
3. 中文、英文、数字混合字符串如何稳定排序?
混合字符串场景下,通常期望“数字优先、英文次之、中文按拼音排在最后”。使用 pypinyin.lazy_pinyin 会自动保留英文字符与数字原形,将其无缝转换为统一的小写 ASCII 序列,从而自然实现混合字符串的平滑排列。
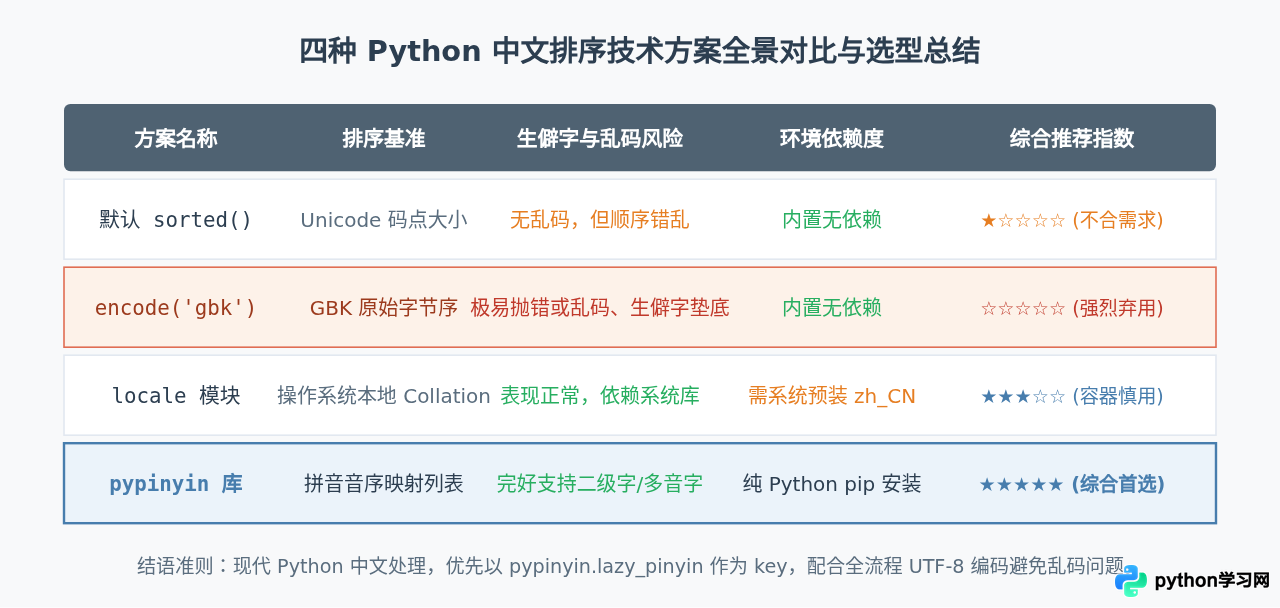
七、总结
解决 Python 中文字符串排序问题的关键在于两点:一是理解数据模型,明确 Python 默认排序依据的是字符的 Unicode 码点而非人类感知的语言习惯;二是选择现代可靠的排序键转换方案。避免使用容易产生乱码和破坏二级汉字次序的 encode('gbk') 历史黑魔法,在常规业务开发中直接采用 sorted(data, key=pypinyin.lazy_pinyin),在确保跨平台一致性的同时,以最简洁的代码彻底解决中文排序错乱的难题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









