

Python数据类型有哪些?内置基础类型与容器结构详解
深入详解Python内置基础数据类型(int、float、bool、str、bytes、NoneType)与四大核心容器结构(list、tuple、dict、set)。全面剖析底层存储原理、可变与不可变机制、类型检查规范以及实际业务选型指南。
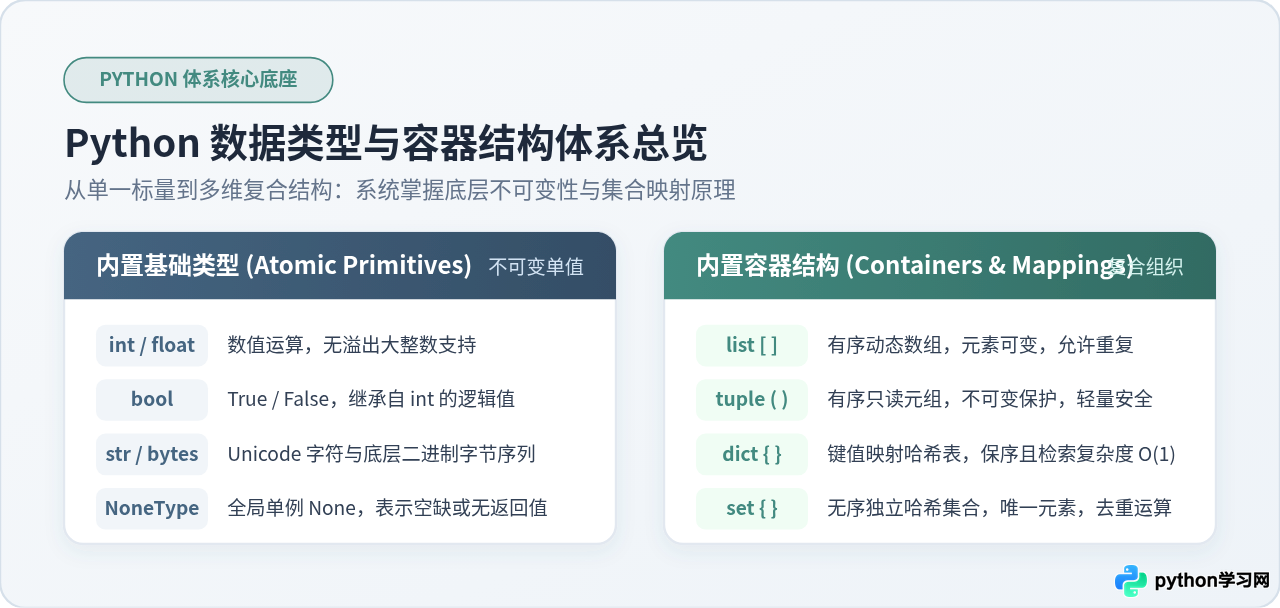
一、内置基础数据类型(单值不可变对象)
基础数据类型通常负责承载单一维度的标量信息。Python 的基础类型具备一个根本特征:对象一旦在内存中创建,其内部状态便不可更改(Immutable)。对变量重新赋值或进行数学运算,并非修改原有对象的值,而是在内存中生成新对象,并将变量指针指向新的内存地址。
1. 数值类型家族(int、float、complex)
Python 原生内置了三种数值形态,分别满足离散计数、高精度连续测量与工程复数计算:
- 整型(
int):Python 3 将历史版本中的整型与长整型整合。现代 Python 的int拥有任意精度支持,只受限于可用物理内存大小,在处理极大数字(如阶乘、密码学大质数)时不会出现整型溢出。 - 浮点型(
float):采用 IEEE 754 标准的双精度 64 位表示(53 位有效数字,约 15 至 17 位十进制有效精度)。使用浮点数时必须警惕二进制表示带来的微小精度误差。 - 复数(
complex):由实部和虚部构成(如z = 3 + 4j),支持通过z.real和z.imag访问分量,广泛应用于科学计算与信号处理。
# 数值计算与大整数示例
a = 2 ** 100
print("2 的 100 次方:", a)  # 正常输出极大数值,无溢出风险

# 浮点数比较陷阱与推荐做法
x = 0.1 + 0.2
print("0.1 + 0.2 == 0.3:", x == 0.3)  # 输出: False,因底层二进制存储尾差 (0.30000000000000004)

import math
print("安全近似比对:", math.isclose(x, 0.3))  # 输出: True
2. 布尔类型(bool)与单例空值(NoneType)
bool 是 int 的直接子类,仅包含两个全局唯一常量:True 与 False。在数值上下文中,True 的数值等价于 1,False 等价于 0。Python 允许任何对象进行真值测试(Truthy/Falsy):数值 0、空字符串 ""、空容器 []、()、{} 以及 None 在条件判断中均被视作假值。
NoneType 只有一个全局单例实例——None,用于代表空缺、未定义或函数的缺省返回。因为 None 在全局内存中唯一存在,比对时必须使用身份运算符 is None,而不是相等运算符 == None。
3. 文本与二进制序列(str、bytes)
str 是不可变的 Unicode 字符序列,支持基于字符位置的正负双向索引和分段切片。而 bytes 是不可变的原始 8 位字节序列(取值范围 0~255)。两者构成了 Python 严格的文本与二进制边界,杜绝了隐式类型混淆。
# 文本与字节流相互转换的标准化写法
text = "Python类型解析"
encoded_bytes = text.encode('utf-8')    # 转换为 bytes 二进制序列
restored_text = encoded_bytes.decode('utf-8')  # 还原为 str 文本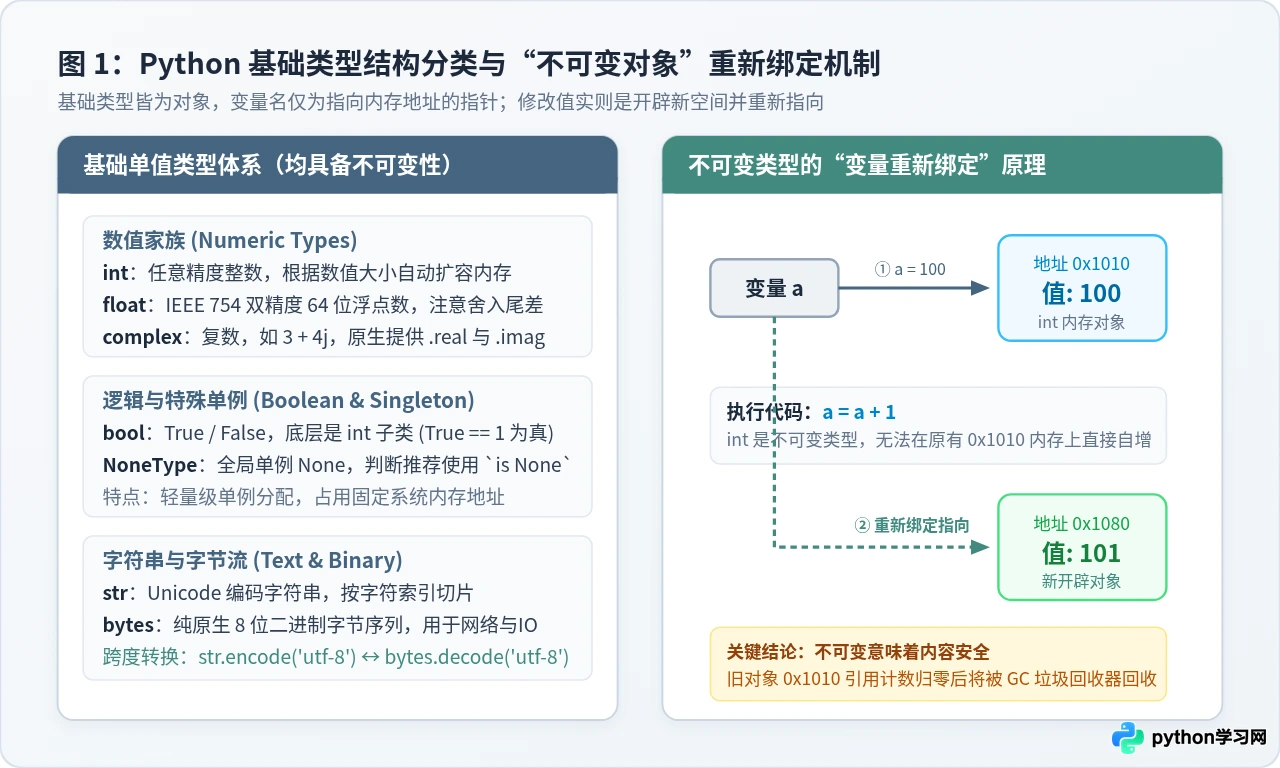
二、内置容器数据结构(多维组织与映射)
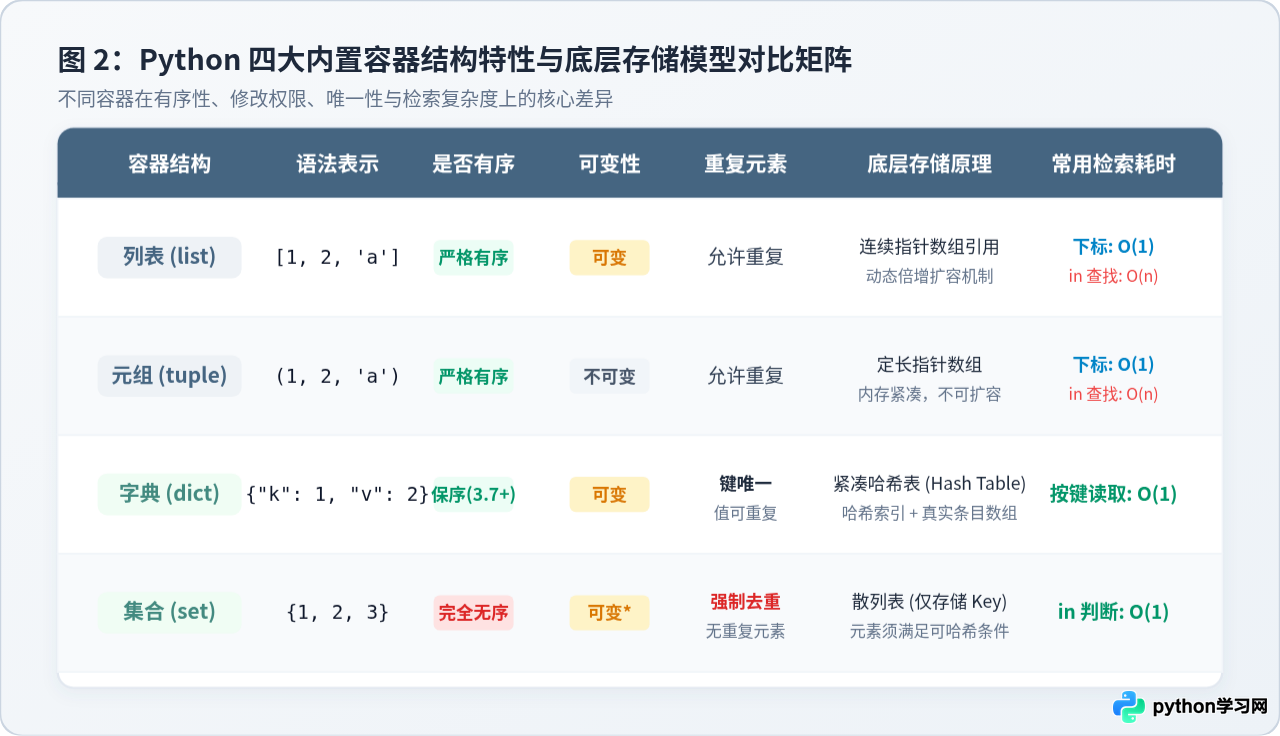
与基础类型不同,容器数据结构用于将多个数据元素组织为一个整体。根据元素有序性、可变性与底层检索模型的不同,Python 提供了四种基石级容器结构:
1. 列表(list):有序动态数组
列表是使用方括号 [] 声明的可变序列。列表在底层由连续的引用指针数组构成,支持通过整数索引以 O(1) 时间复杂度快速读取元素。由于列表长度可变,Python 采用了动态过度分配(Over-allocation)扩容机制:当追加元素超出容量时,底层数组会以倍增系数自动重分配并整体迁移指针,从而保证平均追加操作的时间复杂度为摊销 O(1)。
# 列表常见操作与原地修改
fruits = ["apple", "banana"]
fruits.append("orange")  # 原地追加单个元素
fruits.extend(["pear", "grape"])  # 原地展开合并可迭代对象
fruits[1] = "blueberry"  # 原地更新元素,列表自身内存 id 不发生变化
2. 元组(tuple):有序不可变序列
元组使用圆括号 () 声明。一旦创建,其内部元素序列的指针引用便固定不可变。元组相较于列表更轻量:没有动态扩容的冗余空间开销,创建速度更快。由于具备不可变性,只要元组内部的所有元素全部都是不可变对象,该元组自身便具备可哈希性(Hashable),能够作为字典的键或集合的元素。
t = (1,)。若只写 t = (1),括号会被识别为数学运算括号,变量 t 的实际类型为 int。此外,若元组内部包含可变对象(如
t = (1, [2, 3])),虽然外层元组指针不可篡改,但内部列表的内容仍可被原地修改,此时该元组不可哈希。
3. 字典(dict):键值映射哈希表
字典使用大括号 {"key": "value"} 声明,是 Python 核心业务逻辑中应用最广泛的结构。自 Python 3.7 起,内置字典在语言规范层级保证维护键值对插入的先后顺序。字典底层基于紧凑哈希表实现,键(Key)必须是可哈希对象。
字典在平均情况下提供 O(1) 的根据键查询、更新和删除性能。在日常代码中,推荐优先使用 .get() 方法规避直接索引可能引发的 KeyError:
config = {"host": "127.0.0.1", "port": 8080}

# 安全访问模式:提供缺省默认值
timeout = config.get("timeout", 30)  # key 不存在时返回 30,程序不中断

# 字典初始化分组模式:setdefault()
groups = {}
groups.setdefault("admins", []).append("Alice")
4. 集合(set 与 frozenset):无序独立去重哈希集
集合同样基于哈希表实现,但其哈希表只存储键而不关联值。因此,集合内部元素完全无序、强制唯一。集合最核心的优势在于两点:
- 成员存在性判断(
in操作):平均耗时为 O(1),效率远高于列表线性搜索的 O(n)。 - 高效集合代数运算:原生支持并集(
|)、交集(&)、差集(-)和对称差集(^)。
除可变集合 set 外,Python 还提供了不可变版本 frozenset。frozenset 支持哈希计算,可作为字典键或放入其他集合中。
三、核心机制:可变性、可哈希性与类型判断
理解 Python 类型的进阶运用,关键在于掌握可变性与引用的交互逻辑。
1. 可变性(Mutability)与函数默认参数陷阱
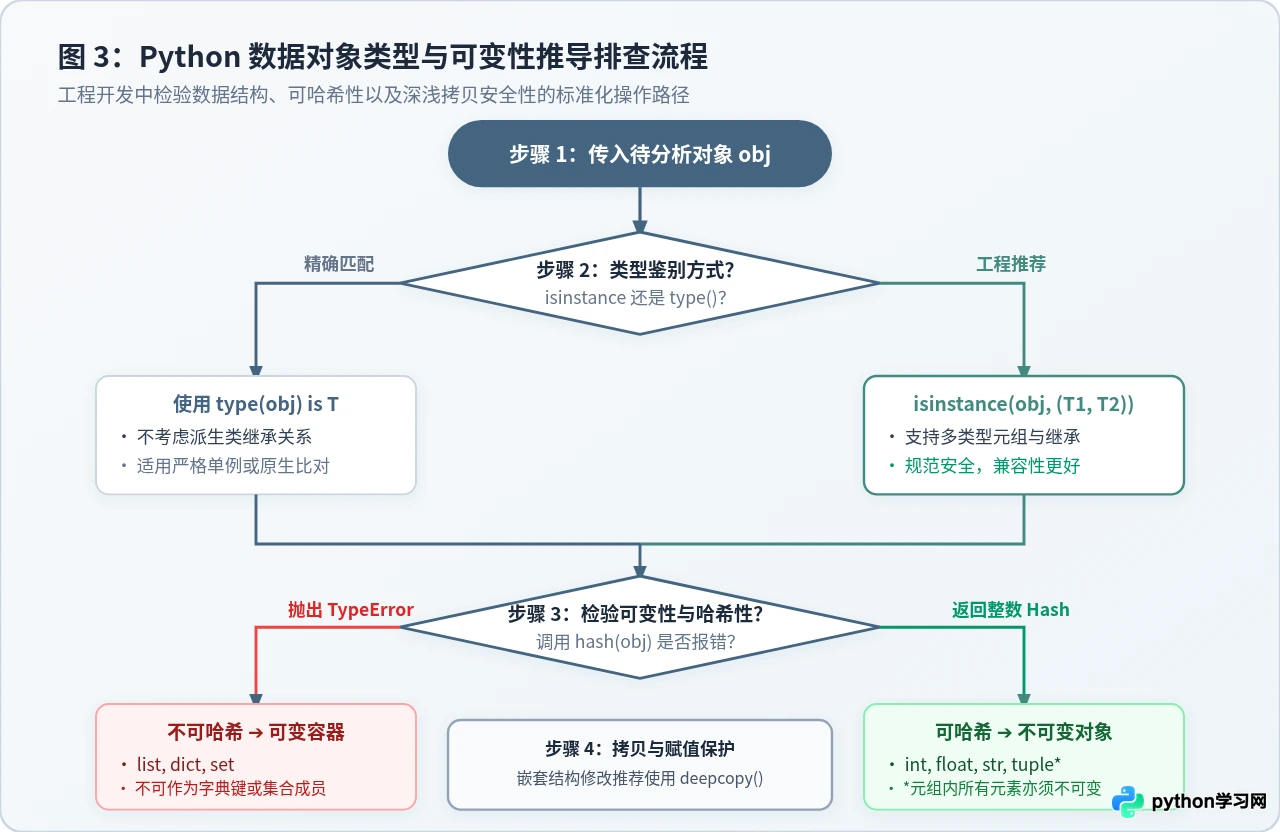
在定义函数时,如果将可变容器(如空列表 [] 或字典 {})作为默认参数,该容器对象仅在函数定义被解释器加载时创建一次。多次调用该函数且未传实参时,所有调用都将共享同一个容器引用,导致意料之外的数据残留污染。
# 错误写法:共享默认可变对象
def append_item(item, target_list=[]):
    target_list.append(item)
    return target_list

# 推荐写法:使用 None 并在函数体内动态惰性初始化
def safe_append_item(item, target_list=None):
    if target_list is None:
        target_list = []
    target_list.append(item)
    return target_list
2. 浅拷贝(Shallow Copy)与深拷贝(Deep Copy)
对列表或字典使用切片 lst[:] 或 .copy() 方法时,执行的均为浅拷贝:外层新建了一个新容器,但容器内部存储的各元素指针依然指向原有对象的内存地址。一旦容器中包含嵌套的列表或字典,修改内层容器依然会同步影响拷贝源。
若要彻底隔离层级嵌套数据,必须引入 copy.deepcopy() 进行递归深拷贝,以保证每一层引用都被独立复制。
3. 类型判断推荐:isinstance() 优于 type()
在业务代码中检验变量类型时,推荐使用 isinstance(obj, ClassInfo)。相比于 type(obj) is Class,isinstance 能够正确识别子类派生关系(例如 isinstance(True, int) 为 True,因为 bool 继承自 int),且支持传入包含多个备选类型的元组进行批量匹配。
四、场景驱动的容器选型指南与全景总结
在实际工程开发中,合理选用数据结构能够直接决定系统的运行性能与代码稳健度。下表归纳了典型业务需求下的匹配法则:
| 业务场景 / 数据处理诉求 | 推荐使用的数据结构 | 选型依据与性能收益 |
|---|---|---|
| 海量 ID 列表比对、过滤黑名单 | set |
id in blacklist 具有 O(1) 时间复杂度,大幅避免列表 O(n) 带来的嵌套循环卡顿。 |
| 用户信息、配置项、网络请求报文体 | dict |
直观的 Key-Value 映射,保持字段插入顺序,属性读取耗时极低。 |
| 动态日志队列、分页渲染列表 | list |
末尾追加 append() 高效,方便按正向或反向索引访问与切片。 |
| 函数多返回值打包、固定坐标、常量配置 | tuple |
数据只读,防止下游函数意外修改;内存布局紧凑,内存占用低于列表。 |
作为复合字典键(如网格坐标 (x, y)) |
tuple(元素均为不可变) |
满足可哈希条件,不可变性保证哈希值在生命周期内恒定。 |
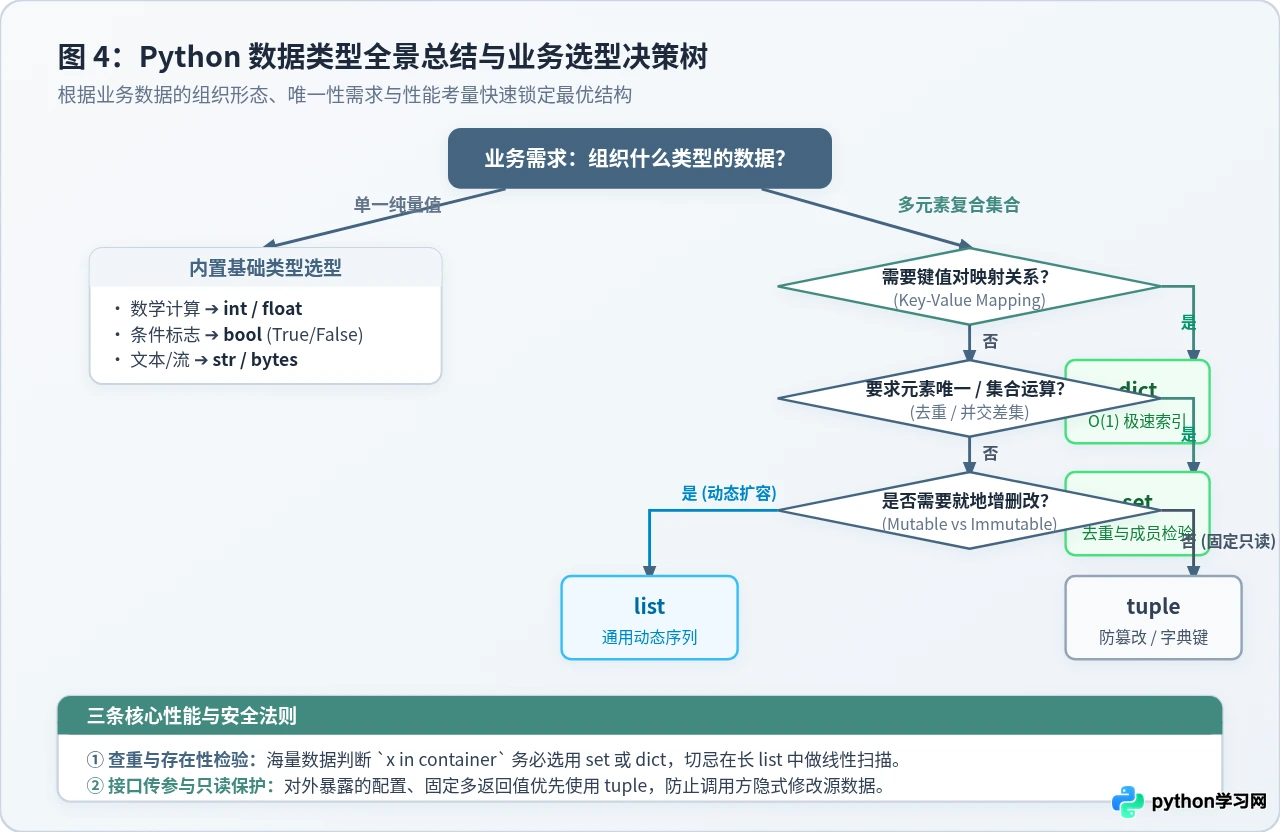
x in data),第一时间将序列转换为 set。2. 传参重防篡:函数内部向外提供固定属性元组时,使用
tuple 避免外部代码无意间修改内部状态。3. 浮点慎等值:不可在业务判断中使用
float_a == float_b,应当设定绝对/相对容差或使用 math.isclose()。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









