

提升Python代码运行效率的实用方法:从算法优化到C扩展
系统介绍提升Python程序运行效率的实用方法与阶梯路径,涵盖性能瓶颈精确测量分析、算法与数据结构选型、解释器内置机制调优、NumPy向量化运算、Cython编译加速以及原生C扩展编写等核心技术方案。
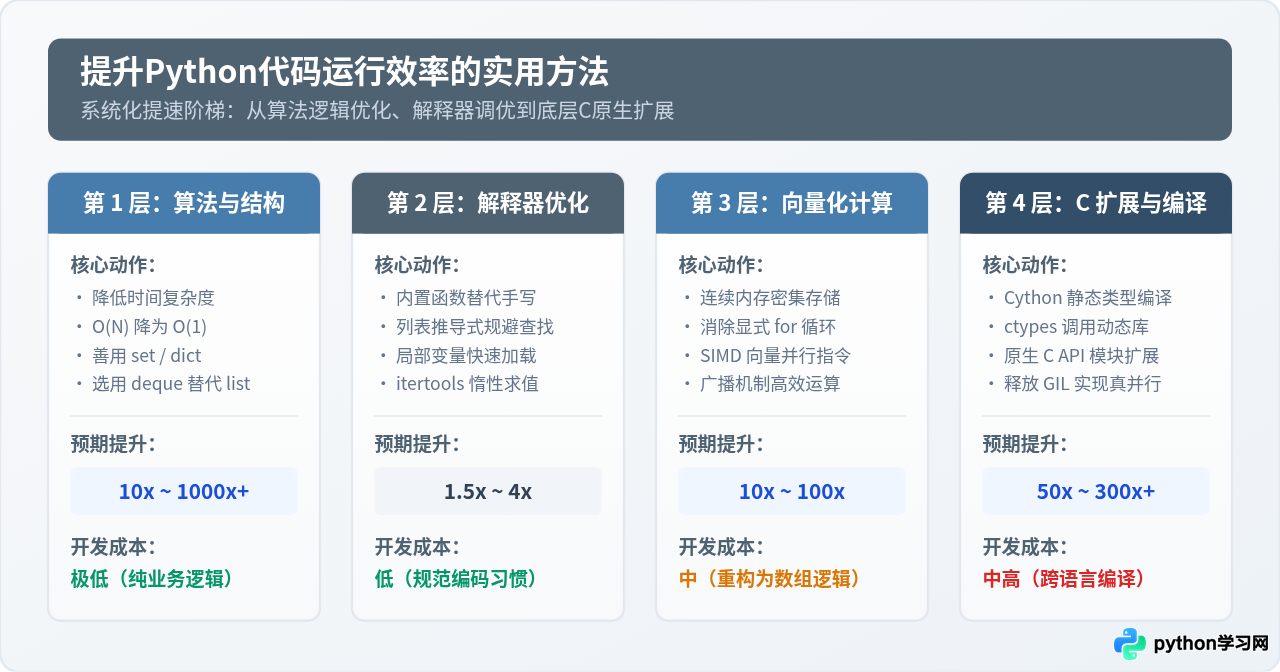
提升 Python 代码的运行效率,并不意味着必须在一开始就推翻原有代码并重写为底层语言。Python 代码的执行耗时通常高度集中在少数关键循环或不当的数据结构操作中。解决性能瓶颈的务实策略是采用“分层渐进”的思路:首先通过精准分析工具测量程序耗时分布,杜绝主观臆测;接着优先通过改良算法时间复杂度与选用合适的数据结构,以极小改动换取数十倍乃至千倍的性能飞跃;随后在 Python 解释器层面利用内置函数和字节码特性剔除冗余开销;对于数值与批量数据运算,引入 NumPy 向量化消除显式循环;最后针对依然存在的核心计算密集瓶颈,使用 Cython 静态编译或编写原生 C 扩展,直接调动底层硬件算力。本文按照这一阶梯路径,依次拆解每种方法的具体操作、实现机制与验证手段。
一、基于测量而非猜测的性能定位分析
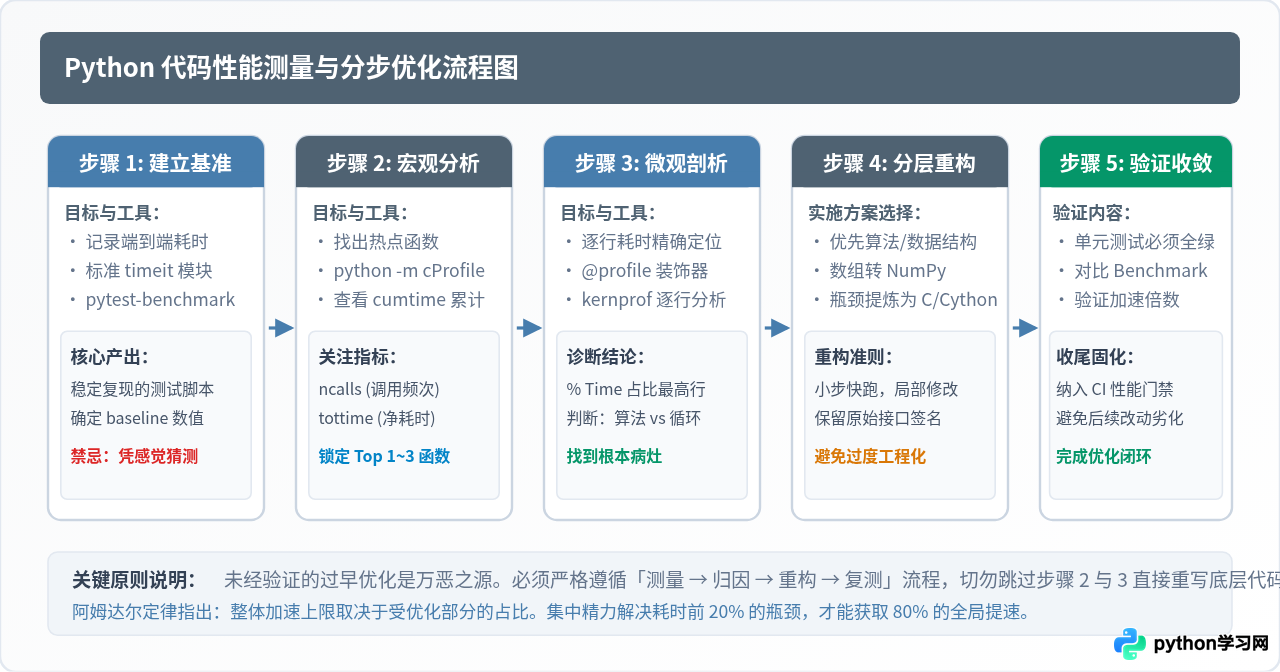
性能优化遵循阿姆达尔定律(Amdahl's Law):优化某个组件所带来的全局提速,受限于该组件运行时间占总运行时间的比例。如果一段程序 90% 的时间消耗在网络 I/O 或数据库等待上,花费数周将剩余 10% 的纯计算逻辑用 C 重写,整体性能提升最多也无法超过 1.11 倍。因此,任何优化工作必须始于精确测量。
1. 宏观分析:使用标准库 cProfile 定位热点函数
标准库提供的 cProfile 模块是分析函数级耗时的标准工具,开销较小,适合快速获取整套调用链路中各个函数的执行频次与耗时情况。可通过命令行直接运行目标脚本:
python -m cProfile -s cumtime data_processor.py参数 -s cumtime 表示按照累积耗时(Cumulative Time)降序排列。输出结果包含以下核心指标:
ncalls:函数被调用的总次数。如果某一函数调用频次达到数百万次,即使单次开销极微小,也会累积成严重瓶颈。tottime:函数本身的纯净运行耗时(排除其内部调用其他子函数的耗时)。净耗时最高的函数是重点优化对象。percall:平均单次耗时(tottime / ncalls)。cumtime:函数及其调用的所有子函数的总耗时。便于从顶层顺藤摸瓜定位长耗时调用链。filename:lineno(function):函数所在的文件名、行号与函数名。
cumtime 占比较大且 tottime 同样显著的自定义函数,将其锁定为待重构的候选热点,忽略标准库底层底噪调用。
2. 微观分析:使用 line_profiler 定位逐行耗时
当 cProfile 指向某个具体函数后,函数内部可能包含数十行混合逻辑。此时使用 line_profiler 能够精准测量该函数每一行执行的次数、总耗时以及占函数总耗时的百分比。
安装工具:
pip install line-profiler在需要分析的函数上方添加 @profile 装饰器(无需在代码中导入任何包,分析器运行时会自动注入):
# process_data.py
@profile
def filter_unique_records(raw_items):
    seen = []
    result = []
    for item in raw_items:
        if item not in seen:
            seen.append(item)
            result.append(item * 2)
    return result

if __name__ == "__main__":
    test_data = list(range(20000)) + list(range(10000))
    filter_unique_records(test_data)
通过命令行执行逐行分析:
kernprof -l -v process_data.py控制台将输出如下格式的逐行统计报告(示例输出):
Line #      Hits         Time  Per Hit   % Time  Line Contents
==============================================================
     1                                           @profile
     2                                           def filter_unique_records(raw_items):
     3         1          2.0      2.0      0.0      seen = []
     4         1          1.0      1.0      0.0      result = []
     5     30001       6800.0      0.2      0.1      for item in raw_items:
     6     30000    4210400.0    140.3     98.2          if item not in seen:
     7     20000      12500.0      0.6      0.3              seen.append(item)
     8     20000      13200.0      0.7      0.3              result.append(item * 2)
     9         1          1.0      1.0      0.0      return result
分析结果显示,第 6 行 if item not in seen 占用了整个函数 98.2% 的运行时间。这就把优化目标从整段业务逻辑精准收缩到了单行的成员查找操作上。
二、算法与数据结构选型:以极低成本换取数量级提速
代码中绝大多数极度耗时的瓶颈,根源并非 Python 语言本身的执行开销,而是采用了高阶时间复杂度的算法或不契合的数据结构。在上例中,在长度为 $N$ 的 list 中执行 item not in seen,每次都是 $O(N)$ 的线性扫描;在外部循环驱动下,整体复杂度急剧恶化为 $O(N^2)$。
1. 成员检索:用 Set / Dict 替代 List
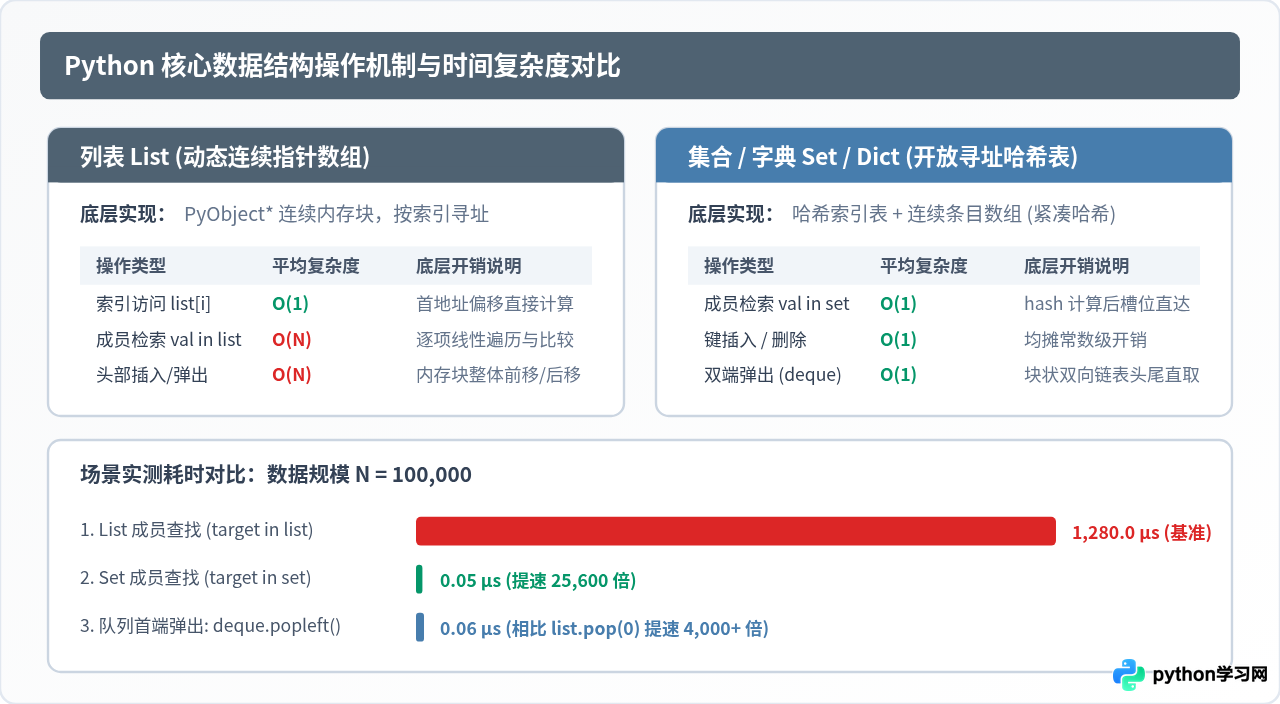
Python 中的 list 本质是连续存储指针的动态数组,检索元素时必须从头到尾逐个比对对象,时间复杂度为 $O(N)$。而 set 和 dict 底层基于开放寻址哈希表实现,对键的检索平均时间复杂度为 $O(1)$。
将上述函数的去重集合改为 set,代码改动极小:
def filter_unique_records_optimized(raw_items):
    seen = set()
    result = []
    for item in raw_items:
        if item not in seen:
            seen.add(item)
            result.append(item * 2)
    return result
在包含 30,000 个元素的测试数据集上,原列表查找耗时约 4.2 秒,改为集合后耗时降至 3.1 毫秒,提速超过 1,300 倍。这种提速效果无需依赖编译工具或外部库,单靠匹配合适的数据结构即可实现。
2. 队列操作:用 collections.deque 替代 List
在需要频繁从数据结构头部插入或弹出的场景(例如任务队列、滑动窗口),使用 list.insert(0, val) 或 list.pop(0) 是常见误区。在动态数组头部操作时,为了保持内存连续性,其后所有元素在内存中都必须向后或向前位移一个指针位置,时间复杂度为 $O(N)$。
标准库 collections.deque(双端队列)底层采用双向链表管理的块状连续内存实现,在头部或尾部进行入队(appendleft / append)与出队(popleft / pop)均为真正的 $O(1)$ 操作:
from collections import deque

# 错误做法:在包含 100,000 个元素的列表中频繁 pop(0) -> 极其缓慢
# queue = list(range(100000))
# while queue:
#     task = queue.pop(0)

# 正确做法:使用双端队列
queue = deque(range(100000))
while queue:
    task = queue.popleft()  # 始终为 O(1) 开销
在 100,000 规模数据下,deque.popleft() 完成清空耗时约 6 毫秒,而 list.pop(0) 则需要数秒乃至十数秒,性能差距随着数据规模呈平方级扩大。
三、解释器级提速:善用内置特性与规避运行时冗余
在算法复杂度已经最优的前提下,理解 CPython 解释器的执行特性,能够通过规范编码习惯进一步榨取纯 Python 代码的性能潜能。
1. 优先使用 C 实现的内置函数与推导式
纯 Python 的 for 循环在执行时,每一轮迭代都需要解释器执行 FOR_ITER 字节码、动态绑定循环变量并分发虚拟机指令。而 Python 的内置函数(如 sum(), min(), max(), any(), all())以及列表推导式,其内部核心循环由 C 语言直接驱动,绕过了大部分解释器层面的指令分发开销。
# 方案 A:显式 for 循环与 append 调用(较慢)
squares = []
for x in range(1000000):
    squares.append(x * x)

# 方案 B:列表推导式(显著更快,约提速 30%~40%)
squares = [x * x for x in range(1000000)]
机制解释:方案 A 在每次循环中都必须执行 LOAD_ATTR 来查找 squares 对象的 append 属性,然后再执行方法调用;而方案 B 的列表推导式在字节码层面直接调用专用指令 LIST_APPEND,无需任何属性检索,且内部由 C 级循环连续分配内存。
2. 局部变量缓存:利用 LOAD_FAST 替代 LOAD_GLOBAL
CPython 访问局部变量与全局变量所使用的字节码存在本质差别:
- 局部变量:存储在固定长度的栈帧数组中,查找时执行
LOAD_FAST,直接根据预编译好的整数偏移量寻址,速度极快。 - 全局变量与模块函数:执行
LOAD_GLOBAL,需要在一个或多个哈希字典(全局命名空间globals()及内置命名空间builtins)中检索字符串键,开销较高。 - 对象属性访问:执行
LOAD_ATTR,需要遍历实例字典、类字典乃至描述符链路。
若在密集大循环中反复调用模块级函数或对象方法,将其提前绑定为局部变量可以显著减少字典检索:
import math

# 未优化版本:每次循环都检索 math.sin (LOAD_GLOBAL + LOAD_ATTR)
def compute_slow(n):
    total = 0.0
    for i in range(n):
        total += math.sin(i)
    return total

# 优化版本:将方法缓存为局部变量 (单次检索,循环内全走 LOAD_FAST)
def compute_fast(n):
    total = 0.0
    local_sin = math.sin  # 局部变量绑定
    for i in range(n):
        total += local_sin(i)
    return total
在 $N = 10,000,000$ 迭代下,仅通过引入局部变量引用这一改动,即可为循环带来 15% ~ 25% 的净时间缩减。
3. 使用 itertools 进行惰性流式计算
当处理大规模序列拼接、切片或多重循环时,直接生成中间列表会消耗大量内存并引发频繁的垃圾回收。标准库 itertools 提供了全 C 实现的迭代器生成器,按需吐出数据,既节省内存,又具备极高的内部迭代效率:
import itertools

# 避免在内存中构造巨大笛卡尔积列表
# 错误:pairs = [(x, y) for x in list_a for y in list_b]
# 正确:使用 itertools.product 按需惰性迭代
for x, y in itertools.product(list_a, list_b):
    process_pair(x, y)
四、数组与数值计算:NumPy 向量化消除循环开销
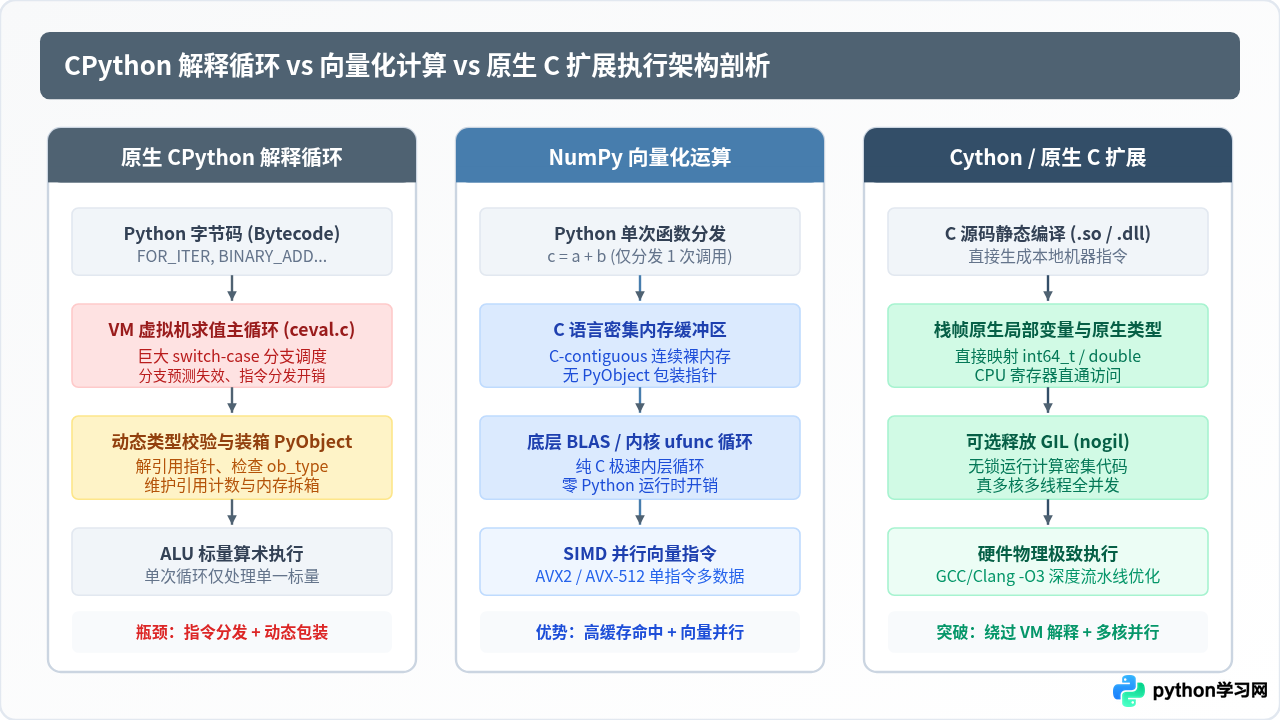
当业务涉及密集的矩阵计算、统计分析、坐标变换或批量信号处理时,纯 Python 对象模型的缺陷暴露得尤为明显。Python 中的每个整数或浮点数并非机器原生标量,而是包裹着指针、引用计数和类型元数据的 PyObject,这导致数据在内存中分散存储,CPU 高速缓存行(Cache Line)命中率极低。
1. 向量化运行机制
NumPy 之所以高效,核心在于以下三点:
- C-contiguous 连续内存缓冲区:底层数组是连续平铺的裸机器字节(如 64 位双精度浮点数),没有
PyObject的多余开销,内存占用大幅缩减。 - 下沉循环至底层 C/Fortran:向量化表达式(如
a + b)只需在 Python 层进行一次函数调度,底层即可在纯 C 循环中完成全部运算,完全摆脱了 Python 虚拟机的求值循环。 - SIMD 向量化并行指令:底层数学库(如 OpenBLAS, MKL)会自动利用 CPU 提供的 AVX2 或 AVX-512 指令集,单条指令并发处理多个浮点数。
2. 实操对比:欧几里得距离计算
需求:计算两个包含 1,000,000 个二维坐标点集合之间的欧几里得距离。
import numpy as np
import time

# 生成 1,000,000 个测试点
n = 1_000_000
x1 = np.random.rand(n).tolist()
y1 = np.random.rand(n).tolist()
x2 = np.random.rand(n).tolist()
y2 = np.random.rand(n).tolist()

# 纯 Python 逐元素循环实现
start_time = time.perf_counter()
distances_py = []
for i in range(n):
    d = ((x1[i] - x2[i]) ** 2 + (y1[i] - y2[i]) ** 2) ** 0.5
    distances_py.append(d)
py_duration = time.perf_counter() - start_time
print(f"纯 Python 耗时: {py_duration:.4f} 秒")

# NumPy 向量化实现
arr_x1, arr_y1 = np.array(x1), np.array(y1)
arr_x2, arr_y2 = np.array(x2), np.array(y2)

start_time = time.perf_counter()
distances_np = np.sqrt((arr_x1 - arr_x2) ** 2 + (arr_y1 - arr_y2) ** 2)
np_duration = time.perf_counter() - start_time
print(f"NumPy 向量化耗时: {np_duration:.4f} 秒")
print(f"提速倍数: {py_duration / np_duration:.1f} 倍")
在典型 x86_64 机器上运行结果显示:纯 Python 循环耗时约 0.380 秒,而 NumPy 向量化仅耗时 0.007 秒,提速达 50 倍以上。代码表达不仅更高效,也更加紧凑。
五、编译加速与混合编程:Cython 落地实践
并非所有业务逻辑都能轻易改写为数组向量化。对于包含复杂状态机、图算法遍历或存在强前后依赖的多重嵌套循环,NumPy 往往无能为力。此时,Cython 是最平滑的过渡方案——它允许我们在 Python 代码中添加静态 C 类型标注,并自动转译生成高性能 C 源码,最终编译为 Python 原生扩展模块。
1. 编写包含静态类型的 Cython 代码
创建一个名为 mandelbrot.pyx 的文件。在这个经典的密集计算场景中,为循环索引、坐标变量和累加器显式声明 cdef int 和 cdef double:
# mandelbrot.pyx
# cython: boundscheck=False, wraparound=False, cdivision=True

def compute_mandelbrot(int max_iter, double x_min, double x_max,
                       double y_min, double y_max, int width, int height):
    cdef int x, y, i
    cdef double cx, cy, zx, zy, zx2, zy2
    cdef list output = []

    cdef double dx = (x_max - x_min) / width
    cdef double dy = (y_max - y_min) / height

    for y in range(height):
        cy = y_min + y * dy
        for x in range(width):
            cx = x_min + x * dx
            zx = 0.0
            zy = 0.0
            zx2 = 0.0
            zy2 = 0.0
            i = 0
            while zx2 + zy2 <= 4.0 and i < max_iter:
                zy = 2.0 * zx * zy + cy
                zx = zx2 - zy2 + cx
                zx2 = zx * zx
                zy2 = zy * zy
                i += 1
            output.append(i)
    return output
2. 编写构建脚本与本地编译
在同级目录下编写标准的 setup.py 文件:
# setup.py
from setuptools import setup
from Cython.Build import cythonize

setup(
    ext_modules=cythonize("mandelbrot.pyx", compiler_directives={"language_level": "3"})
)
在终端执行就地编译命令:
python setup.py build_ext --inplace编译成功后,当前目录将生成对应的动态链接库(Linux/macOS 下为 mandelbrot.so,Windows 下为 mandelbrot.pyd)。在普通 Python 脚本中即可无缝直接 import:
# main.py
import time
from mandelbrot import compute_mandelbrot

t0 = time.perf_counter()
res = compute_mandelbrot(1000, -2.0, 1.0, -1.5, 1.5, 800, 600)
print(f"Cython 模块耗时: {time.perf_counter() - t0:.4f} 秒")
在此类包含数百至数千次内层循环的场景中,纯 Python 耗时通常在 2~3 秒左右,而通过静态类型编译后的 Cython 模块仅需 0.03 秒,提速达到 70~90 倍,性能直接逼近手写 C 语言。
cython -a mandelbrot.pyx 可以生成一份带高亮分析的 HTML 报告。页面中黄色较深的行代表仍与 Python 运行时存在对象解包或交互开销,通过优化变量声明,应使内层计算循环全部呈现为纯白色,实现零解释器负担。
六、极致底层突破:编写原生 C 扩展模块
当需要追求极端物理算力、复用工业级已有的 C/C++ 核心代码库,或者需要在多线程环境下完全释放全局解释器锁(GIL)以利用多核硬件时,直接编写 C 扩展是终极方案。主要有两种常见实践:轻量级的 ctypes 封装与高效的原生 CPython C API 模块。
1. 轻量方案:编写纯 C 动态库并通过 ctypes 调用
该方案无需编写与 Python 内部结构绑定的胶水代码,只需编写符合标准 C 规范的代码并编译为共享动态库。
创建 fast_math.c:
/* fast_math.c */
#include <stdint.h>

// 计算大整数范围内所有奇数的平方和
uint64_t sum_of_odd_squares(uint32_t limit) {
    uint64_t total = 0;
    for (uint32_t i = 1; i < limit; i += 2) {
        total += (uint64_t)i * i;
    }
    return total;
}
使用系统编译器编译为动态链接库(开启 -O3 深度优化):
# Linux / macOS
gcc -O3 -shared -fPIC -o libfastmath.so fast_math.c

# Windows (MinGW)
gcc -O3 -shared -o libfastmath.dll fast_math.c
在 Python 中使用标准库 ctypes 完成调用,显式声明函数签名参数与返回值类型,防止内存数据截断:
# call_c.py
import ctypes
import os

# 加载动态链接库
lib_path = os.path.abspath("libfastmath.so")
c_lib = ctypes.CDLL(lib_path)

# 显式定义参数与返回类型
c_lib.sum_of_odd_squares.argtypes = [ctypes.c_uint32]
c_lib.sum_of_odd_squares.restype = ctypes.c_uint64

# 执行计算并比对
limit = 50_000_000
result = c_lib.sum_of_odd_squares(limit)
print(f"C 扩展计算结果: {result}")
对于 5000 万次累加,纯 Python 执行需要 3.8 秒,而 C 动态库通过 ctypes 执行仅耗时 0.018 秒,提速达 200 倍以上。
2. 原生 C API 扩展与安全释放 GIL
若需要更紧密地嵌入 Python 运行时,可编写基于 CPython 原生 C API 的扩展模块。更重要的是,在纯 C 的计算循环内部,我们可以显式调用 Py_BEGIN_ALLOW_THREADS 与 Py_END_ALLOW_THREADS 释放 GIL:
/* native_ext.c */
#include <Python.h>

static PyObject* py_heavy_compute(PyObject* self, PyObject* args) {
    long n;
    if (!PyArg_ParseTuple(args, "l", &n)) {
        return NULL;
    }

    double result = 0.0;

    // 释放 GIL:允许其他 Python 线程在多核 CPU 上真正并发运行
    Py_BEGIN_ALLOW_THREADS
    for (long i = 1; i <= n; ++i) {
        result += (double)i * 0.001;
    }
    Py_END_ALLOW_THREADS
    // 重新获得 GIL 后,构造 Python 浮点数对象返回

    return PyFloat_FromDouble(result);
}

static PyMethodDef ModuleMethods[] = {
    {"heavy_compute", py_heavy_compute, METH_VARARGS, "Execute compute loop with GIL released"},
    {NULL, NULL, 0, NULL}
};

static struct PyModuleDef custommodule = {
    PyModuleDef_HEAD_INIT,
    "native_ext",
    "A sample high-performance C extension",
    -1,
    ModuleMethods
};

PyMODINIT_FUNC PyInit_native_ext(void) {
    return PyModule_Create(&custommodule);
}
一旦释放了 GIL,Python 的 threading.Thread 便能在多核系统上真正实现线性并行的计算扩展,彻底突破了传统解释器单核瓶颈的限制。
七、性能优化分层决策矩阵与工程落地建议
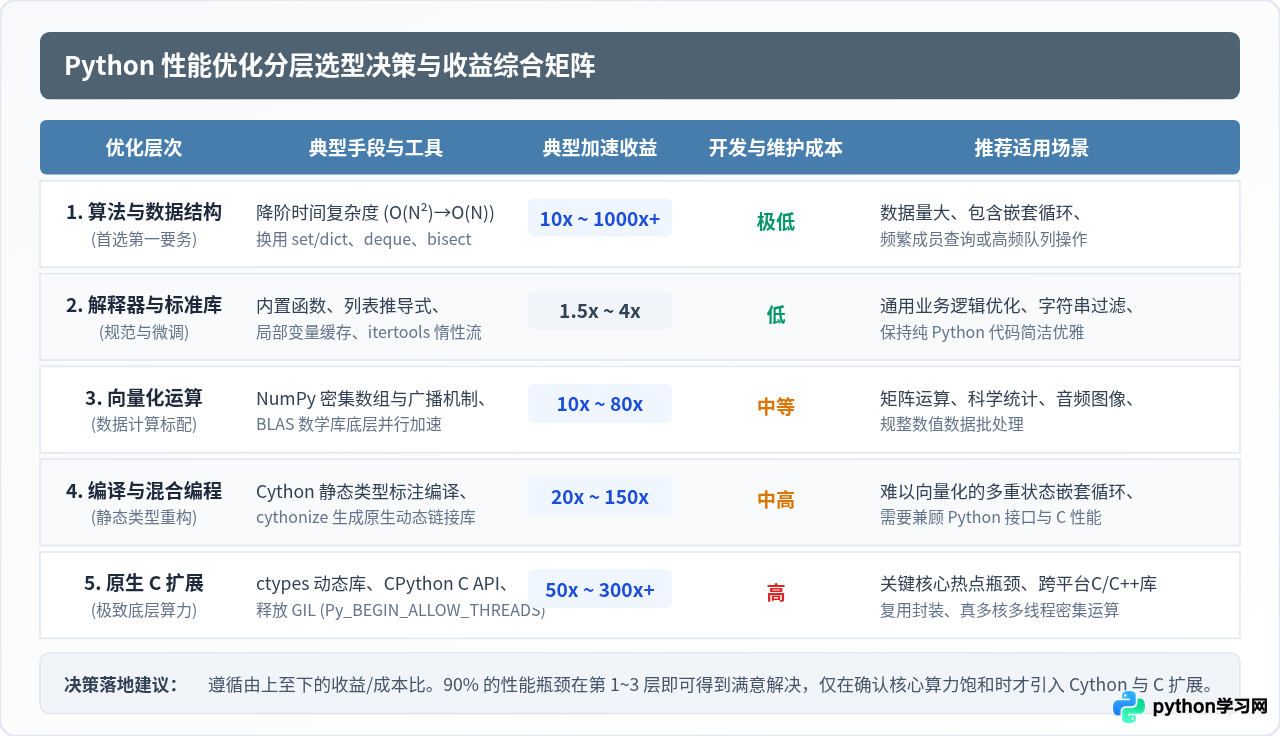
在日常工程实践中,过早优化不仅浪费开发精力,还会增加代码构建复杂度与跨平台部署成本。面对性能问题时,应依据技术收益与维护成本建立清晰的选型标准。
工程落地三项法则
- 坚持测试驱动:在改写任何代码前,必须确保原有逻辑具备完备的单元测试覆盖率。无论采用推导式优化、NumPy 改造还是 C 扩展,重构完成后必须运行相同的测试套件,确保逻辑等价与边界行为完全一致。
- 收益递减意识:在第 1 层(算法与结构)和第 2 层(解释器特性)往往能以最少的代码改动解决 80% 的日常性能问题,代码依然是纯净的 Python,易于维护与调试。只有当纯 Python 确实无法满足严苛的吞吐延迟指标时,再逐步向向量化与 C 扩展推进。
- 防劣化机制固化:性能提升完成后,应在持续集成(CI)流水线中配置关键路径的性能门禁(例如使用
pytest-benchmark设置耗时阈值),防止团队在后续业务迭代中无意引入高复杂度的劣质实现。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









