

Python“胶水语言”特性详解:怎么与其他语言交互
深入解析Python作为“胶水语言”的核心机制,系统讲解Python调用C/C++、Rust、Go、Java等语言的实现方式、步骤示例、内存管理注意事项及选型指南。
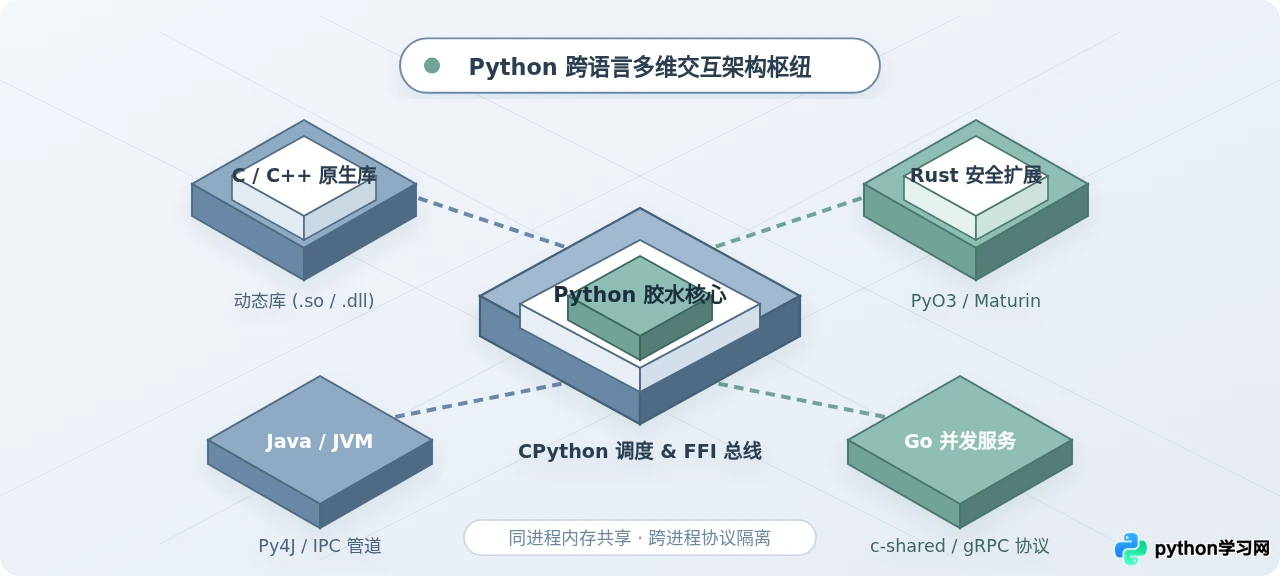
Python 之所以被称为“胶水语言”,核心原因在于其官方解释器 CPython 采用 C 语言编写,天然具备直接调用原生动态链接库、映射物理内存地址以及挂载外部语言运行时(如 C/C++、Rust、Go、Java)的能力。本文将系统拆解 Python 作为胶水层的核心解耦机制,详解标准库 ctypes、现代编译扩展(CFFI、Cython、Rust PyO3)以及跨进程通信等主流交互路径,并给出完整的操作步骤、避坑规则与工程选型依据。
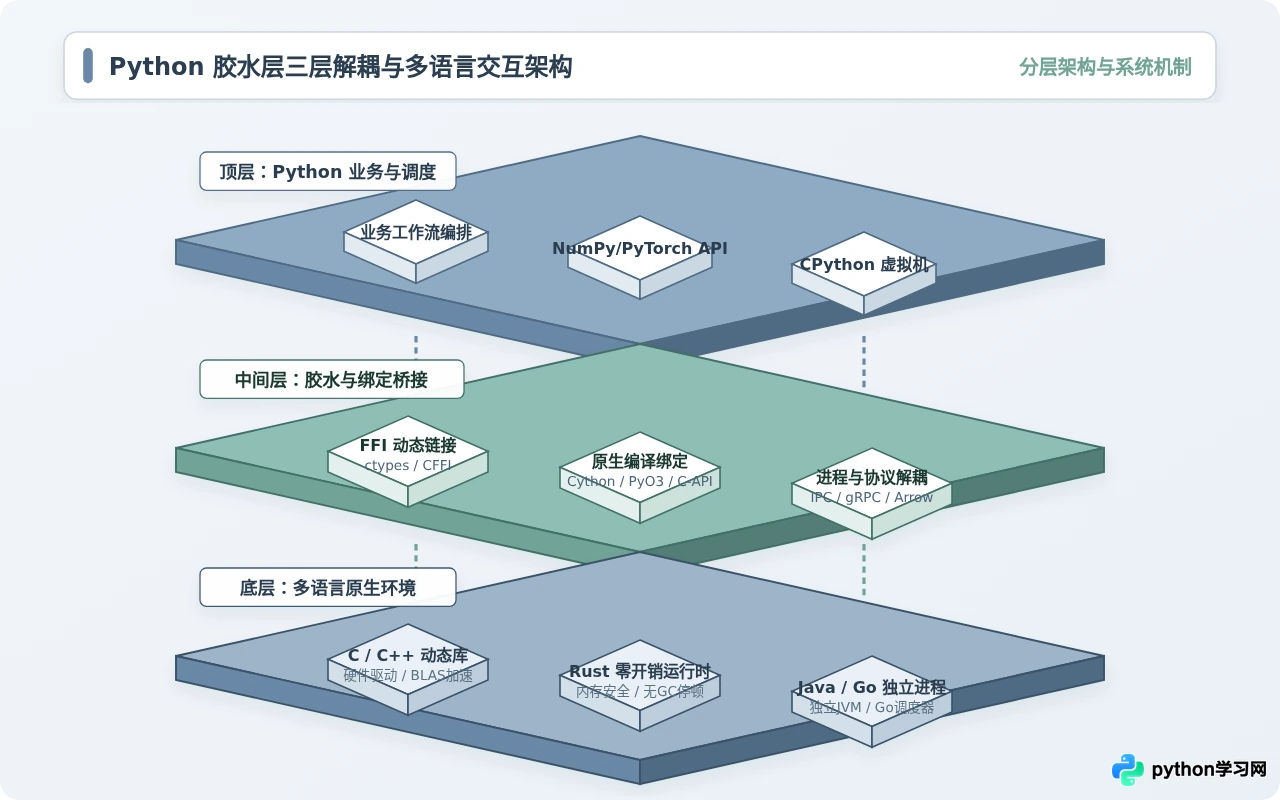
一、什么是“胶水”特性:底层机制与分层解耦
在软件工程中,“胶水语言(Glue Language)”并非贬义词,而是指一种擅长将不同组件、不同技术栈连接为一体的高阶黏合工具。Python 能够胜任这一角色的根本原因,在于其底层运行机制与设计哲学上的双重优势:
-
CPython 对象的原生 C 映射:
在 CPython 中,所有的 Python 对象底层都是一个
PyObject结构体指针。当 Python 需要与 C 代码交互时,无需通过重型的网络协议或进程管道,只要按照 C 语言的应用程序二进制接口(C-ABI)进行符号寻址,就能在同一内存空间内直接读取与写入数据。 - 高层逻辑与底层算力的职责分工: 日常业务开发更看重快速迭代、语法简洁和丰富的第三方库;而底层算法(如矩阵乘法、音视频解码、高频网络 I/O)则对纳秒级性能和硬件利用率有极致要求。Python 充当胶水层,负责上层工作流编排与逻辑组装,底层密集计算则下沉至 C、C++ 或 Rust。NumPy、PyTorch、TensorFlow 等顶级开源项目的底层内核皆遵循此架构。
-
完备的外部函数接口(FFI)生态:
Python 官方标准库直接内置了
ctypes,无需额外安装编译器或第三方工具链即可加载操作系统动态链接库;同时开源社区提供了从 CFFI、Cython 到新一代 Rust PyO3 的全链路绑定工具。
二、方案一:标准库直接对接——使用 ctypes 加载 C/C++ 动态库
如果手头已经有编译好的 C/C++ 共享动态库(Linux/macOS 下为 .so / .dylib,Windows 下为 .dll),或者需要直接调用操作系统原生 API,标准库自带的 ctypes 是最轻量、零依赖的交互手段。
以一个经典的数学计算与数组处理任务为例,下面演示从 C 源码编写、动态库编译到 Python 端类型封送与调用的完整五步操作流水线。
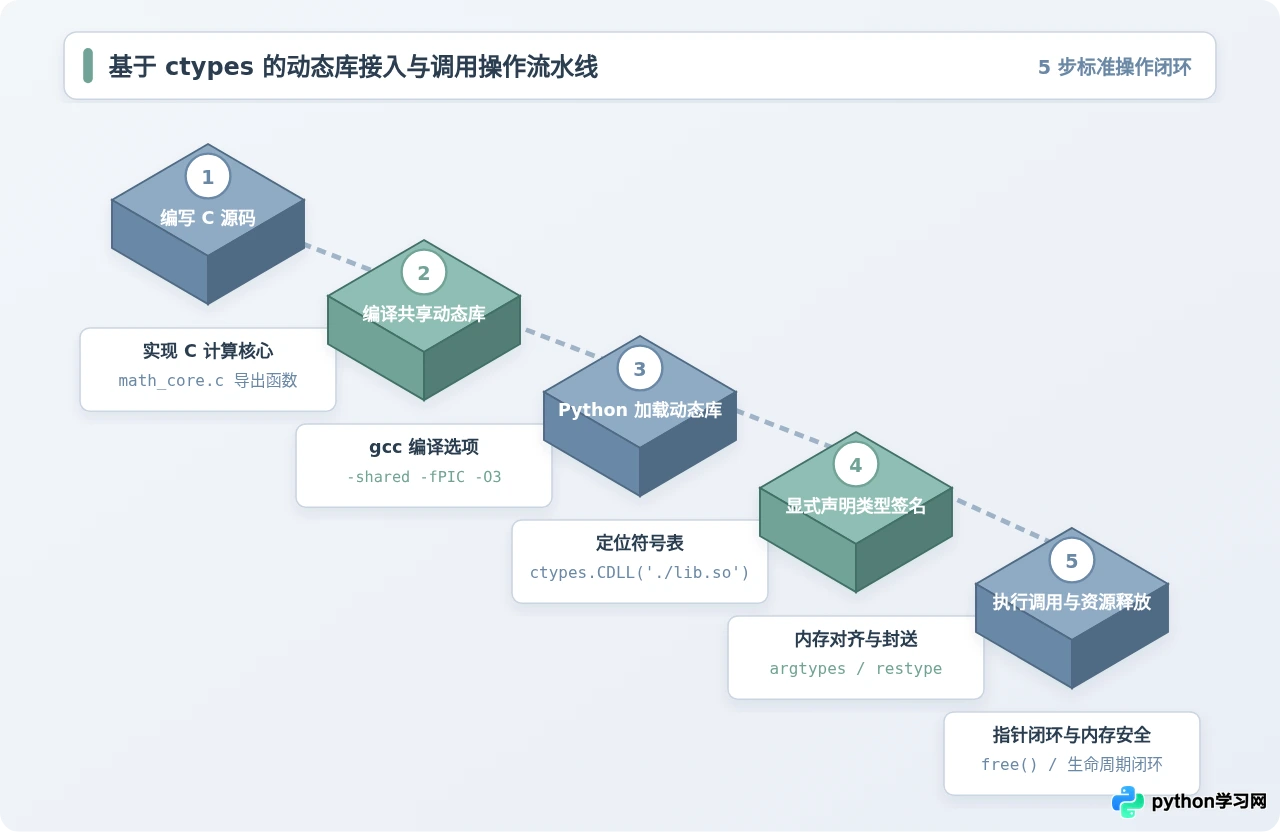
步骤 1:编写 C 核心源码并导出接口
创建名为 math_core.c 的源文件。为避免 C++ 编译器发生名字修饰(Name Mangling),如果使用 C++ 编写,务必加上 extern "C";这里采用纯 C 语法:
#include <stdio.h>
#include <stdlib.h>

// 1. 基础标量运算:双精度浮点数相乘
double multiply(double a, double b) {
    return a * b;
}

// 2. 指针与数组运算:对指定长度的 double 数组进行原地缩放
void scale_array(double* arr, int length, double factor) {
    if (!arr) return;
    for (int i = 0; i < length; i++) {
        arr[i] *= factor;
    }
}
步骤 2:编译生成共享动态链接库
在终端中使用 gcc 或 clang 编译动态库。必须指定 -fPIC(生成位置无关代码)与 -shared(生成共享库)参数:
# Linux 平台生成 .so 文件
gcc -shared -fPIC -O3 math_core.c -o libmath_core.so

# macOS 平台亦可生成 .dylib 文件(两者 ctypes 均可加载)
gcc -shared -fPIC -O3 math_core.c -o libmath_core.dylib
步骤 3 与步骤 4:Python 端加载动态库并显式绑定类型
关键注意事项:ctypes 默认会将未声明的函数返回值与入参视作 C 语言的 int。如果传递浮点数、指针或 64 位地址,若未显式配置 argtypes 与 restype,将导致严重的指针截断、内存错位或直接崩溃(Segmentation Fault)。
import ctypes
import os
import sys

# 1. 确定动态库路径并加载
lib_name = "libmath_core.dylib" if sys.platform == "darwin" else "libmath_core.so"
lib_path = os.path.abspath(lib_name)

if not os.path.exists(lib_path):
    raise FileNotFoundError(f"找不到动态库文件: {lib_path}")

lib = ctypes.CDLL(lib_path)

# 2. 严格声明 multiply 函数的签名
lib.multiply.argtypes = [ctypes.c_double, ctypes.c_double]
lib.multiply.restype = ctypes.c_double

# 3. 严格声明 scale_array 函数的签名(数组指针、整型长度、浮点因子)
lib.scale_array.argtypes = [ctypes.POINTER(ctypes.c_double), ctypes.c_int, ctypes.c_double]
lib.scale_array.restype = None  # void 返回值

# 4. 执行标量调用
res = lib.multiply(3.14, 2.0)
print(f"multiply 运行结果: {res}")  # 输出示例: 6.28

# 5. 执行指针与数组传递
py_data = [1.0, 2.5, 4.0, 8.5]
c_array_type = ctypes.c_double * len(py_data)
c_data = c_array_type(*py_data)

# 调用 C 原地修改内存
lib.scale_array(c_data, len(py_data), 2.0)

# 读取修改后的结果
scaled_result = list(c_data)
print(f"scale_array 处理结果: {scaled_result}") # 输出示例: [2.0, 5.0, 8.0, 17.0]ctypes 函数前,必须先写两行签名声明:func.argtypes = [...] 与 func.restype = ...。这是保障 Python 与 C 内存边界安全的绝对红线。
三、方案二:高性能与现代编译型绑定——CFFI、Cython 与 Rust (PyO3)
尽管 ctypes 方便即开即用,但其依赖运行时的动态符号解析与 Python-C 类型逐层封装,调用损耗较高;而且由于缺乏编译期类型安全检查,开发复杂数据结构时极易滋生内存越界隐患。为了追求微秒甚至纳秒级的吞吐性能,工程中广泛采用以下三种现代编译方案:
1. CFFI(C Foreign Function Interface)
CFFI 是 PyPy 项目催生的标准 FFI 工具,现已广泛用于 CPython。它支持 API 模式,允许开发者直接在 Python 脚本中内嵌完整的 C 语言头文件 cdef(...)。CFFI 在安装或预构建时会调用系统编译器生成专用的 C 扩展,提供与原生 C 几乎无差别的执行速度与编译期校验。著名的安全加密库 cryptography 便是 CFFI 的忠实拥趸。
2. Cython:C 与 Python 的混合编译
Cython 是一种支持静态类型声明的编程语言,其语法与 Python 高度相似。Cython 编译器能够直接将 .pyx 文件转译为高度优化的 C/C++ 代码,并编译成 CPython 可以直接 import 的二进制动态模块(.so / .pyd)。它不仅能轻松调用外部 C 库,还能让纯 Python 循环提速数十至数百倍。
3. 现代首选:Rust 与 PyO3 构建内存安全扩展
在近年的基础设施重构中,以 Rust + PyO3 + Maturin 为代表的技术栈正在快速替代传统 C/C++。Rust 拥有与 C 匹敌的零开销运行时性能,同时通过所有权系统在编译期彻底杜绝了空指针解引用、缓冲区溢出和数据竞争等内存隐患。新一代极速工具库如 Polars(高性能 DataFrame)、Ruff(超高速 Python 代码检查器)和 Pydantic V2 的核心验证引擎,均采用这一模式打造。
use pyo3::prelude::*;

/// 纯 Rust 实现的快速素数判断,暴露给 Python
#[pyfunction]
fn is_prime_fast(n: u64) -> bool {
    if n <= 1 { return false; }
    if n <= 3 { return true; }
    if n % 2 == 0 || n % 3 == 0 { return false; }

    let mut i = 5;
    while i * i <= n {
        if n % i == 0 || n % (i + 2) == 0 {
            return false;
        }
        i += 6;
    }
    true
}

/// 注册 Python 扩展模块
#[pymodule]
fn rust_math_core(_py: Python, m: &PyModule) -> PyResult<()> {
    m.add_function(wrap_pyfunction!(is_prime_fast, m)?)?;
    Ok(())
}# 经 maturin develop 编译后,Python 可以像普通内置模块一样直接导入
import rust_math_core
result = rust_math_core.is_prime_fast(982451653)
print(f"982451653 是否为素数: {result}") # 输出示例: True四、方案三:独立运行时的进程隔离与协议级交互——Java、Go 与网络微服务
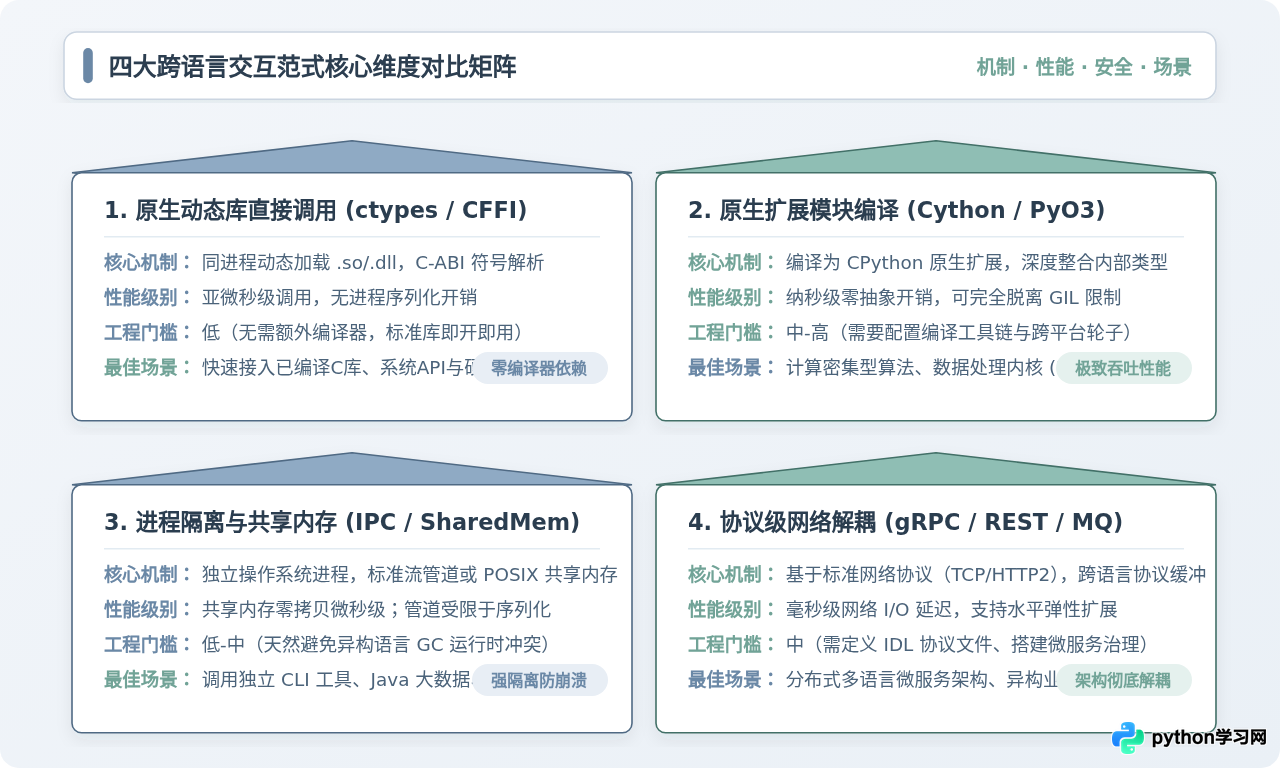
当目标语言拥有属于自己的独立垃圾回收器(GC)、复杂线程调度器或轻量级协程运行时(例如 Java 的 JVM 或 Go 的 Go Runtime)时,如果强行把它们编译成动态库并与 CPython 塞进同一个进程,往往会引发灾难性的运行时竞争、GC 内存抢占或不可预测的死锁。
针对此类语言,成熟的工程做法是采取进程隔离或协议解耦:
-
标准管道与 CLI 封装(subprocess 模式):
将 Go 或 Java 程序打包为独立的命令行可执行文件,Python 使用标准库
subprocess.Popen启动子进程,通过标准输入(stdin)和标准输出(stdout)传递 JSON 或二进制流。这种方式天然具备进程级容错,子进程崩溃绝不会导致主 Python 进程宕机。 -
零拷贝共享内存(SharedMemory / Apache Arrow):
对于需要在本地跨进程传递数百万行表格或超大图像帧的高吞吐场景,可使用 Python 3.8+ 标准库
multiprocessing.shared_memory,或基于 Apache Arrow 内存规范。Go/Java 进程与 Python 共同映射同一段 POSIX 共享内存区,实现纳秒级的跨语言零拷贝读取。 - 协议级 RPC 通信(gRPC / HTTP REST): 将异构语言编写的模块部署为独立微服务,通过 Protobuf 定义通用的跨语言接口描述文件(IDL),基于 gRPC 进行高并发远程过程调用。虽然引入了网络 I/O 开销,但系统解耦最为彻底,前后端可以完全独立维护、部署与弹性扩缩容。
五、跨语言交互的底层陷阱与关键边界
跨越语言边界不仅仅是调用一个函数,更是两种截然不同的内存模型与运行时规则的碰撞。在实际工程落地中,开发者必须重点防范以下三大陷阱:
1. GIL(全局解释器锁)与多核并发瓶颈
Python 原生线程受限于 CPython 的 GIL,同一时刻只能有一个线程执行 Python 字节码。但是,进入 C/C++ 或 Rust 代码执行时,并不受 GIL 的约束!
在 C 语言扩展中,如果执行长耗时的密集计算或系统 I/O,可以通过调用 Py_BEGIN_ALLOW_THREADS 显式释放 GIL,计算完毕后再通过 Py_END_ALLOW_THREADS 重新获取锁;在 Rust PyO3 中,可以使用 py.allow_threads(...) 闭包释放 GIL。这样其他 Python 线程便能真正并发执行,彻底激活多核 CPU 算力。
2. 内存所有权混乱(Who Allocates, Who Frees)
内存分配器必须对称。如果在 C 语言侧使用 malloc() 分配了一块内存并返回给 Python,切忌试图让 Python 的垃圾回收器(GC)去自动清理,这会导致不可预知的堆损坏(Heap Corruption)。
free_buffer() 函数显式销毁;由 Python 分配的对象,在传递给 C 异步使用期间必须保持 Python 端变量引用有效,防止 Python GC 提前将底层内存回收导致悬挂指针。
3. 跨语言异常与系统崩溃隔离
在纯 Python 中,错误会引发可以被 try...except 捕获的 Exception;但在 C/C++ 原生层,如果出现空指针解引用、数组越界或除以零,将触发操作系统的硬件异常信号(如 SIGSEGV、SIGFPE),导致整个 Python 进程瞬间无预警崩溃。
因此,原生层接口必须对所有入参进行前置防御性校验(Check for NULL),并在出错时通过 C-API 接口 PyErr_SetString(PyExc_RuntimeError, "error message") 设置异常并返回错误码,让 Python 端优雅地抛出标准异常。
六、工程选型决策路径与落地指南
面对繁多的跨语言交互方案,如何为具体工程项目做出最合理的架构抉择?可以依照以下决策路径进行推导:
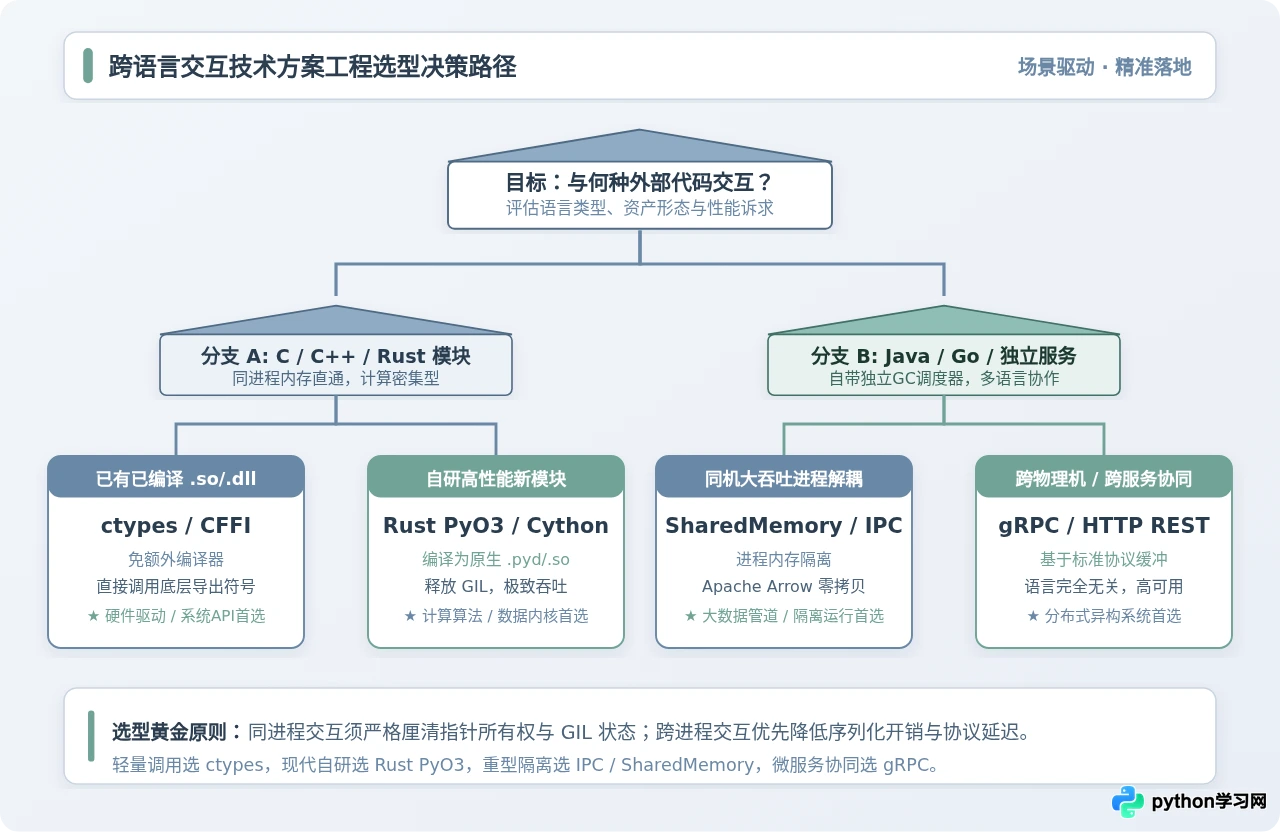
| 交互方案 | 性能级别 | 编译链依赖 | 内存安全性 | 最佳适用场景 |
|---|---|---|---|---|
| ctypes | 微秒级(较高) | 无需额外安装 | 需手动保障 | 轻量快速调用已有系统 C 动态库、硬件驱动测试 |
| CFFI (API模式) | 纳秒-微秒级(极高) | 需 C 编译器 | 支持类型检查 | 需要高稳定性与性能的底层 C 接口长期封装 |
| Rust + PyO3 | 纳秒级(最高) | 需 Rust 工具链 (cargo) | 编译期严格保证 | 自研高性能计算内核、数据解析引擎、替代传统 C 扩展 |
| Cython | 纳秒级(最高) | 需 C/C++ 编译器 | 视静态类型声明而定 | 重度重构已有 Python 计算密集函数、NumPy 算法加速 |
| IPC / 共享内存 | 纳秒-微秒级 | 无额外编译器 | 进程物理隔离 | 同机跨语言(Python + Java/Go)高吞吐传输大批数据 |
| gRPC / HTTP REST | 毫秒级(网络I/O) | 网络协议库 | 网络与系统强隔离 | 多团队多语言微服务协同、分布式系统构建 |
总的来看,Python 强大的生态生命力并不源自它自身的单一执行速度,而恰恰源于其开箱即用的胶水黏合能力。通过将 Python 极致的开发效率与 C/C++、Rust、Go 等底层系统语言的吞吐能力有机缝合,工程师既能享受到现代动态语言快速原型的敏捷,又能从容掌控高并发与计算密集的硬核性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









