

Python实战项目代码解析:简单爬虫与待办应用结构
深入拆解Python经典实战项目:控制台网络爬虫的流式I/O管线与待办事项CLI的分层架构,解析核心代码实现、异常防御逻辑、状态持久化与工程解耦方案。
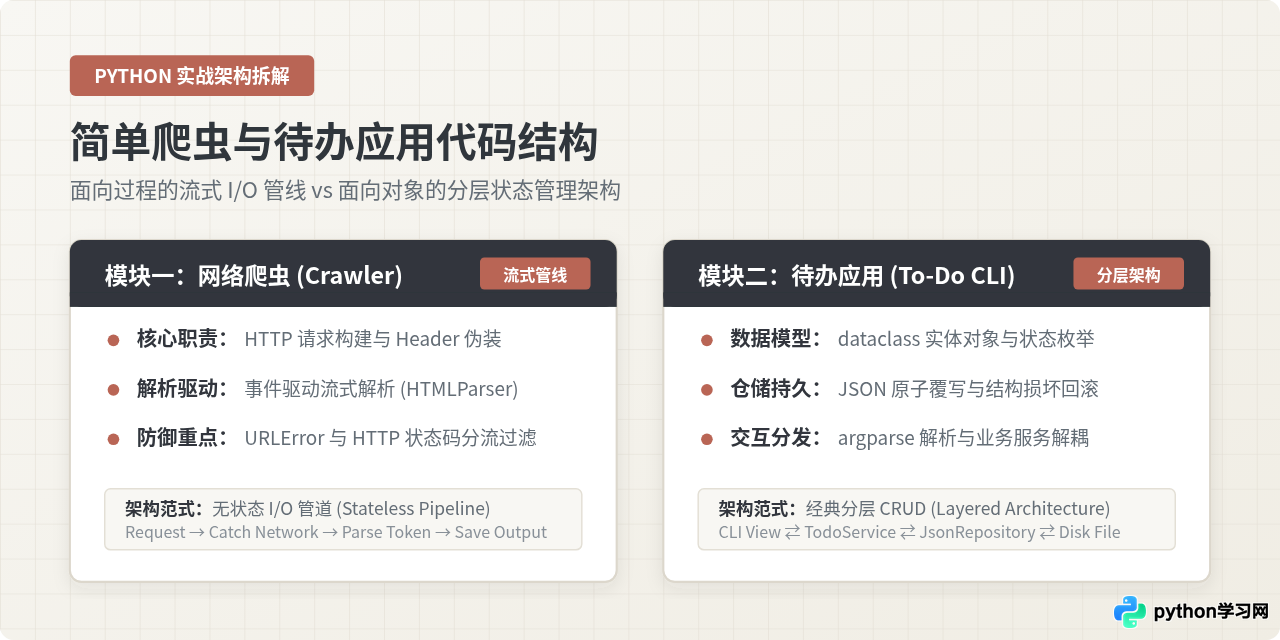
一、简单爬虫的项目定位与管线结构
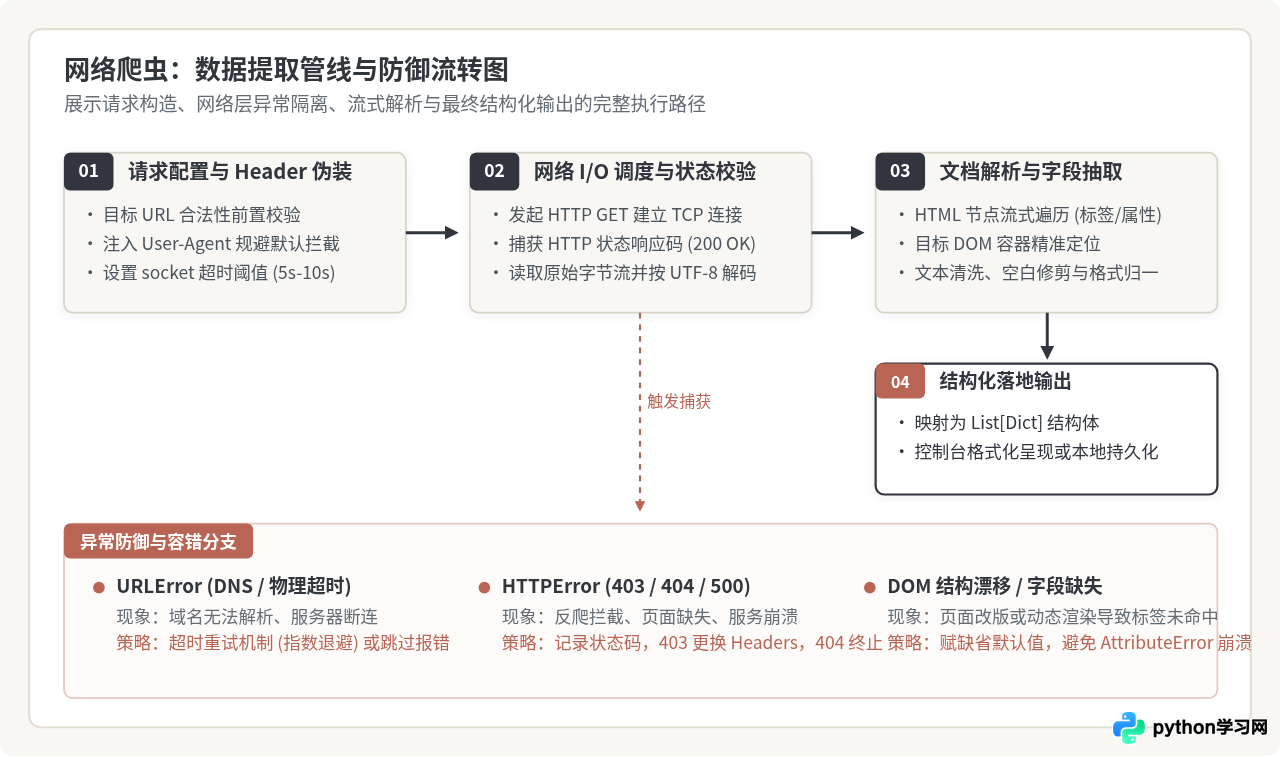
编写网络爬虫的核心任务是从不可控的外部网络服务中获取 HTML 文本,并将非结构化的标签转换为具备明确字段的字典或对象。这种任务本质上是“流式数据管线(Data Pipeline)”。它的执行特点是单向流动:从配置目标 URL 开始,经过网络 I/O、HTTP 响应校验、标签解析、字段归一化,最终输出或保存结果。
初学者在编写爬虫时常犯的错误是将网络请求、异常捕获、字符串提取和文件写入揉杂在一个庞大的循环里。一旦目标服务器发生超时或网页 DOM 结构调整,整个脚本便会直接抛出未捕获异常退出。合理的架构应当把“获取网页(Network Fetcher)”与“结构解析(Document Parser)”分离,并在网络边界建立清晰的错误防护罩。
1.1 简易网络爬虫完整代码实现
为了保证代码在任何标准 Python 3 环境下均可无缝运行,以下示例基于标准库 urllib.request 与 html.parser.HTMLParser 构建。该爬虫模拟抓取一个包含文章标题、超链接和阅读标签的网页片段,并将其规整为结构化数据:
# -*- coding: utf-8 -*-
# 文件名: simple_crawler.py
import urllib.request
import urllib.error
from html.parser import HTMLParser
from typing import List, Dict, Optional

class ArticleHTMLParser(HTMLParser):
    """
    继承自标准库 HTMLParser,负责事件驱动的流式 DOM 解析。
    分离解析逻辑与网络请求,便于单独使用静态文本进行单元测试。
    """
    def __init__(self):
        super().__init__()
        self.articles: List[Dict[str, str]] = []
        self._in_article = False
        self._in_title = False
        self._current_article: Dict[str, str] = {}

    def handle_starttag(self, tag: str, attrs: list):
        attr_dict = dict(attrs)
        # 识别文章容器节点 <article class="post-card">
        if tag == "article" and attr_dict.get("class") == "post-card":
            self._in_article = True
            self._current_article = {"title": "", "link": ""}

        # 识别文章内的超链接 <a href="..." class="post-title">
        if self._in_article and tag == "a" and "post-title" in attr_dict.get("class", ""):
            self._in_title = True
            self._current_article["link"] = attr_dict.get("href", "")

    def handle_data(self, data: str):
        # 抽取标题文本内容并清除多余空白字符
        if self._in_title:
            cleaned = data.strip()
            if cleaned:
                self._current_article["title"] += cleaned

    def handle_endtag(self, tag: str):
        if tag == "a" and self._in_title:
            self._in_title = False
        elif tag == "article" and self._in_article:
            self._in_article = False
            # 过滤缺损字段,仅保留有效数据项
            if self._current_article.get("title"):
                self.articles.append(self._current_article)

def fetch_html(url: str, timeout: int = 8) -> Optional[str]:
    """
    执行带防御机制的网络请求,隔离网络层异常。
    """
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36",
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8"
    }
    req = urllib.request.Request(url, headers=headers)

    try:
        with urllib.request.urlopen(req, timeout=timeout) as response:
            status_code = response.getcode()
            if status_code != 200:
                print(f"[告警] 响应非预期状态码: {status_code}")
                return None
            # 检测响应编码,缺省降级为 utf-8
            encoding = response.headers.get_content_charset() or "utf-8"
            return response.read().decode(encoding, errors="replace")
    except urllib.error.HTTPError as e:
        print(f"[网络错误] HTTP 错误: {e.code} {e.reason} (URL: {url})")
    except urllib.error.URLError as e:
        print(f"[连接失败] 无法连通服务器或超时: {e.reason}")
    except Exception as e:
        print(f"[未知异常] 请求过程中断: {type(e).__name__} - {e}")
    return None

def parse_articles(html_content: str) -> List[Dict[str, str]]:
    """调用解析器从原始 HTML 提取结构化数据"""
    parser = ArticleHTMLParser()
    parser.feed(html_content)
    return parser.articles

if __name__ == "__main__":
    # 演示用目标 HTML 片段(亦可替换为真实网站链接)
    sample_html = """
    <div class="content">
      <article class="post-card">
        <a href="/posts/python-gil" class="post-title">深入理解 Python GIL 与并发编程</a>
        <p class="summary">探讨全局解释器锁对多线程计算密集型应用的影响。</p>
      </article>
      <article class="post-card">
        <a href="/posts/sqlite-wal" class="post-title">SQLite WAL 模式高并发读写实践</a>
        <p class="summary">解析 Write-Ahead Logging 机制及参数调优。</p>
      </article>
    </div>
    """
    results = parse_articles(sample_html)
    print(f"成功抽取数据 {len(results)} 条:")
    for idx, item in enumerate(results, 1):
print(f" [{idx}] 标题: {item['title']} | 链接: {item['link']}")1.2 爬虫关键设计与易错点分析
-
请求头伪装(User-Agent 注入): 许多现代 Web 站点对于包含
Python-urllib/3.x特征的默认请求头会直接返回403 Forbidden。必须显式设置常见的浏览器 Header。 -
双层异常拦截策略: 在
urllib中,HTTPError是URLError的子类。代码必须优先捕获HTTPError读取状态码(如 404 或 500),再捕获更底层的URLError(如 DNS 解析失败或物理网络断开)。捕获顺序颠倒会导致状态码信息丢失。 -
解析层与网络层的零耦合: 将
fetch_html()和ArticleHTMLParser彻底分开。若需要将底层解析库切换为BeautifulSoup或lxml,只需改写parse_articles,而无需改动网络请求与重试调度代码。
二、待办应用(To-Do CLI)的分层架构与状态管理
与爬虫这种“无状态单向管道”截然不同,待办事项应用(To-Do Application)的核心是状态持久化与跨周期维护。用户今天录入的任务,明天启动命令行时必须依然存在;用户标记完成或删除某项任务,数据文件中的状态需要同步更新。
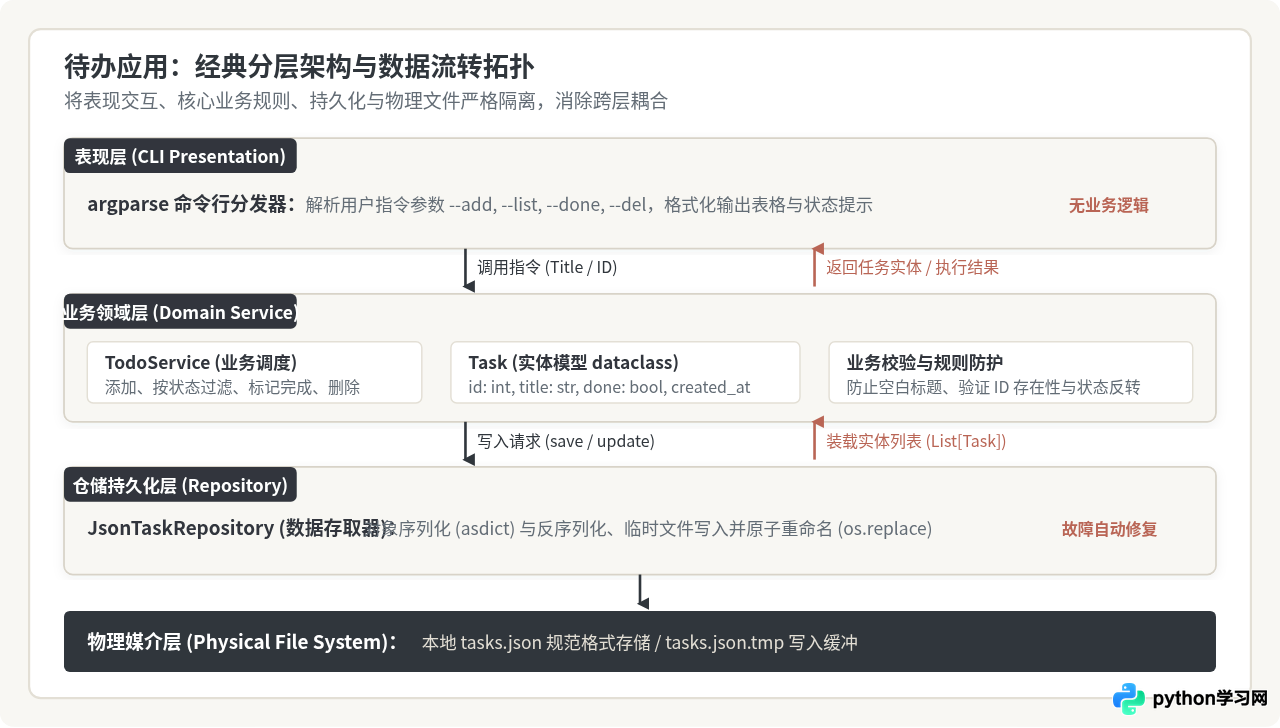
如果直接在命令行解析函数中打开并重写 JSON 文件,随着功能的增加(如添加优先级、到期时间、按标签筛选),代码会迅速陷入不可维护的混乱泥潭。编写这类应用的标准方式是采用经典三层架构(Three-Tier Architecture):表现层、业务服务层与持久化仓储层。
2.1 待办事项应用完整代码实现
该应用包含领域实体定义(Task)、安全持久化仓储(JsonTaskRepository)、核心业务逻辑(TodoService)和参数命令行交互器(main):
# -*- coding: utf-8 -*-
# 文件名: todo_app.py
import os
import json
import argparse
from dataclasses import dataclass, asdict
from datetime import datetime
from typing import List, Optional

# ==============================
# 1. 实体层 (Domain Model)
# ==============================
@dataclass
class Task:
    id: int
    title: str
    completed: bool = False
    created_at: str = ""

    def __post_init__(self):
        if not self.created_at:
            self.created_at = datetime.now().strftime("%Y-%m-%d %H:%M:%S")

# ==============================
# 2. 持久化层 (Repository)
# ==============================
class JsonTaskRepository:
    """负责本地 JSON 文件的装载、校验与原子安全写入"""
    def __init__(self, file_path: str = "tasks.json"):
        self.file_path = file_path

    def load_all(self) -> List[Task]:
        if not os.path.exists(self.file_path):
            return []
        try:
            with open(self.file_path, "r", encoding="utf-8") as f:
                data = json.load(f)
                return [Task(**item) for item in data]
        except (json.JSONDecodeError, TypeError) as e:
            # 容错降级:备份损坏文件,避免直接崩溃或静默清空
            backup_path = f"{self.file_path}.corrupt.{int(datetime.now().timestamp())}"
            try:
                os.rename(self.file_path, backup_path)
                print(f"[告警] tasks.json 数据损坏,已隔离至 {backup_path}")
            except OSError:
                pass
            return []

    def save_all(self, tasks: List[Task]) -> None:
        """利用临时文件与 os.replace 实现 POSIX 级别的原子写入"""
        temp_path = f"{self.file_path}.tmp"
        raw_data = [asdict(t) for t in tasks]

        with open(temp_path, "w", encoding="utf-8") as f:
            json.dump(raw_data, f, ensure_ascii=False, indent=2)
            f.flush()
            os.fsync(f.fileno())  # 确保数据真正刷入物理磁盘

        os.replace(temp_path, self.file_path)  # 原子替换,防止中途断电导致文件损坏

# ==============================
# 3. 业务服务层 (Service)
# ==============================
class TodoService:
    """封装核心业务规则,不依赖任何命令行打印与交互"""
    def __init__(self, repo: JsonTaskRepository):
        self.repo = repo
        self._tasks: List[Task] = self.repo.load_all()

    def add_task(self, title: str) -> Task:
        title = title.strip()
        if not title:
            raise ValueError("任务标题不能为空")

        # 计算自增主键 ID
        new_id = max([t.id for t in self._tasks], default=0) + 1
        task = Task(id=new_id, title=title)
        self._tasks.append(task)
        self.repo.save_all(self._tasks)
        return task

    def list_tasks(self, show_all: bool = True) -> List[Task]:
        if show_all:
            return list(self._tasks)
        return [t for t in self._tasks if not t.completed]

    def complete_task(self, task_id: int) -> bool:
        for task in self._tasks:
            if task.id == task_id:
                task.completed = True
                self.repo.save_all(self._tasks)
                return True
        return False

    def delete_task(self, task_id: int) -> bool:
        initial_len = len(self._tasks)
        self._tasks = [t for t in self._tasks if t.id != task_id]
        if len(self._tasks) < initial_len:
            self.repo.save_all(self._tasks)
            return True
        return False

# ==============================
# 4. 表现层 (CLI Interface)
# ==============================
def main():
    parser = argparse.ArgumentParser(description="极简待办事项应用 (To-Do CLI)")
    parser.add_argument("--add", type=str, metavar="TITLE", help="添加新任务")
    parser.add_argument("--list", action="store_true", help="查看任务清单")
    parser.add_argument("--done", type=int, metavar="ID", help="标记指定 ID 任务为已完成")
    parser.add_argument("--del", dest="delete_id", type=int, metavar="ID", help="删除指定 ID 任务")

    args = parser.parse_args()
    service = TodoService(JsonTaskRepository())

    if args.add:
        try:
            task = service.add_task(args.add)
            print(f"[成功] 新增任务 #{task.id}: {task.title}")
        except ValueError as e:
            print(f"[错误] {e}")
    elif args.done is not None:
        if service.complete_task(args.done):
            print(f"[完成] 任务 #{args.done} 状态已更新为已完成。")
        else:
            print(f"[提示] 未找到 ID 为 {args.done} 的任务。")
    elif args.delete_id is not None:
        if service.delete_task(args.delete_id):
            print(f"[删除] 任务 #{args.delete_id} 已从清单移除。")
        else:
            print(f"[提示] 未找到 ID 为 {args.delete_id} 的任务。")
    elif args.list or True:
        tasks = service.list_tasks()
        if not tasks:
            print("清单当前为空,可通过 --add \"任务名\" 添加。")
            return
        print("--- 待办任务清单 ---")
        for t in tasks:
            mark = "[x]" if t.completed else "[ ]"
            print(f"  {mark} #{t.id:02d} | {t.title} (创建于 {t.created_at})")

if __name__ == "__main__":
    main()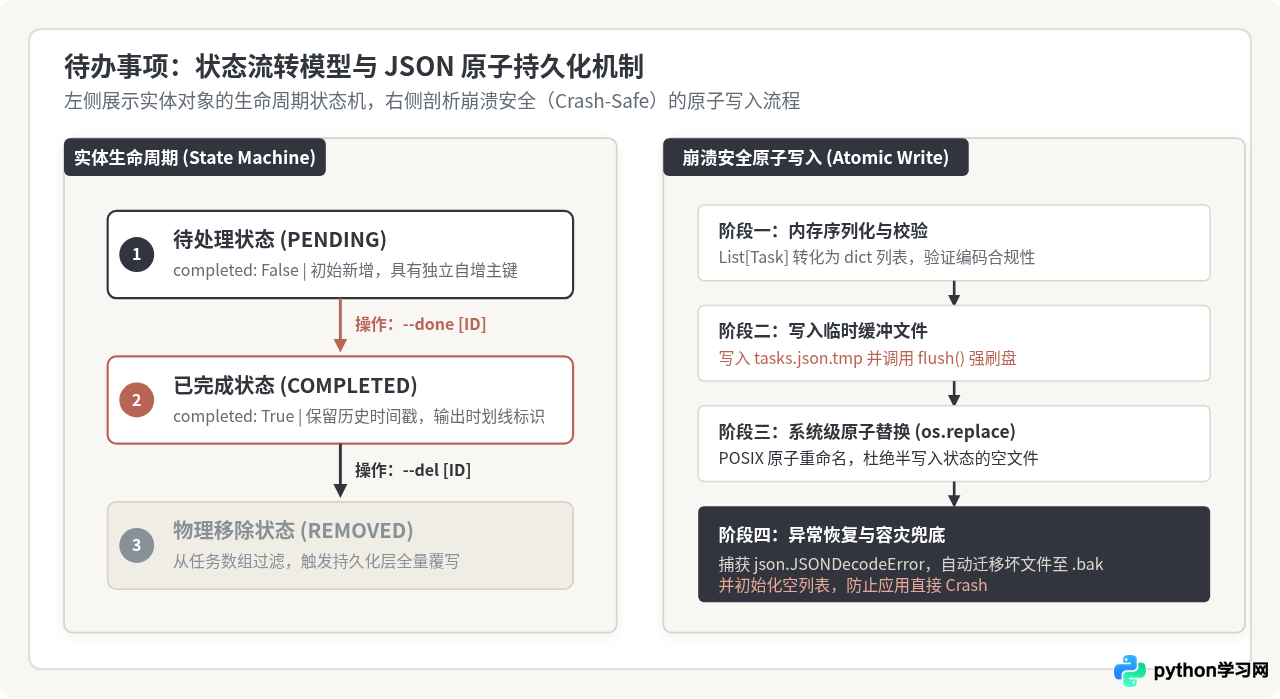
2.2 待办应用的关键架构考量
编写待办应用不仅是熟悉 json.dump 的用法,更体现了本地工具如何防范数据损坏和逻辑混乱:
-
原子写入(Atomic File Write): 如果采用普通的
open("tasks.json", "w"),当程序写入途中遭遇异常退出、强制终止(SIGINT)或断电时,原文件将被截断为 0 字节,导致所有待办历史丢失。先写入tasks.json.tmp并执行os.replace,由操作系统文件系统保障重命名操作的原子性。 -
无 UI 污染的业务服务(Service Decoupling):
TodoService的任何方法均不包含print(),而是通过返回值(如bool、Task)或抛出ValueError表达状态。当未来需要将该应用扩展为 Flask Web 接口或 PyQt 图形桌面端时,TodoService可以百分之百复用,无需重写任何逻辑。 -
主键 ID 的生成规则: 代码使用
max([t.id for t in self._tasks], default=0) + 1而不是单纯使用len(tasks) + 1。这保证了即使用户删除了中间的任务项,后续生成的新任务也不会与历史任务 ID 冲突。
三、两种实战架构模式的技术差异与选型总结
将简易爬虫与待办应用放在一起对比,能够清晰地展示 Python 编程中两类根本性不同的软件形态:事件驱动的 I/O 流水线与状态持久化的分层管理系统。
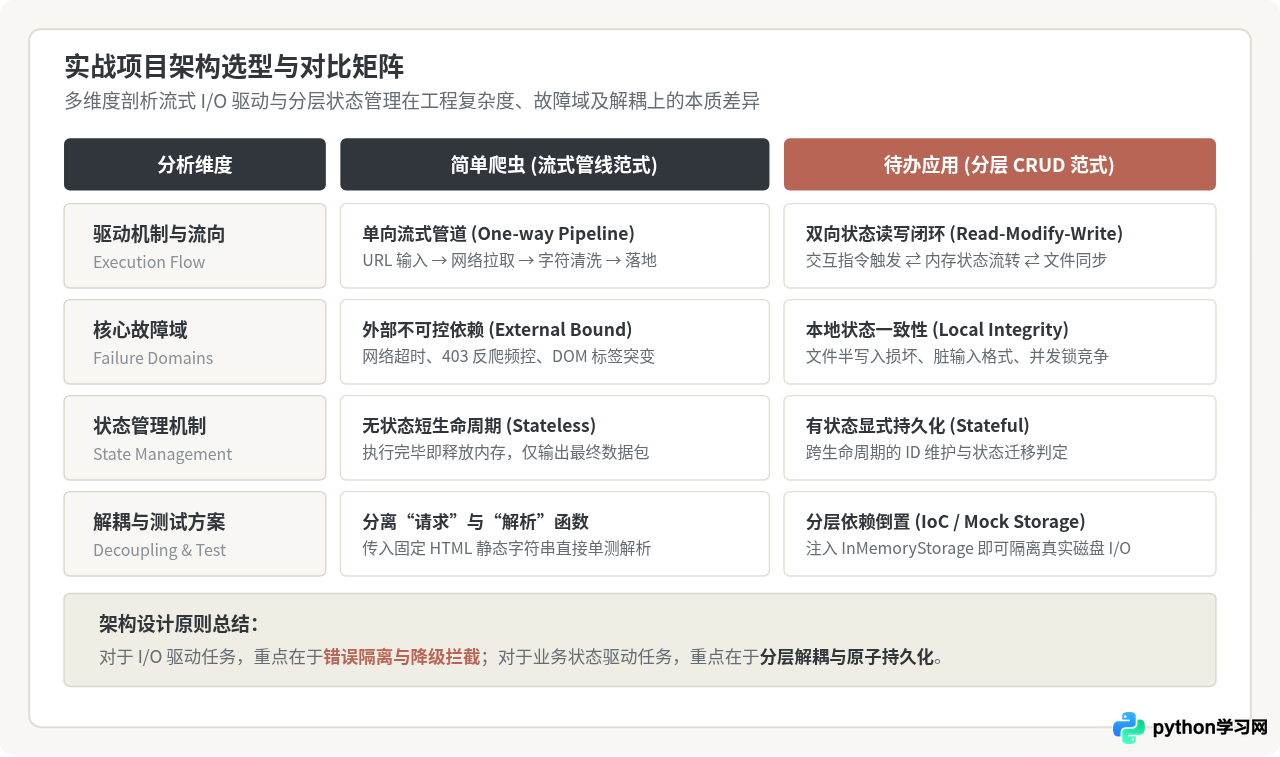
在实际工程开发中,开发者面临的场景往往是这两种形态的结合或演化。掌握它们的核心差异,能够帮助我们在面对新需求时迅速构思出清晰合理的模块边界:
| 设计考量 | 简单爬虫项目 (Web Crawler) | 待办应用项目 (To-Do CLI) |
|---|---|---|
| 数据流动方式 | 单向传递:网络请求 → 原始文本 → 过滤提取 → 落地输出 | 双向交互环:读取磁盘 → 内存修改 → 业务判定 → 覆写磁盘 |
| 主要外部约束 | 网络延迟、HTTP 错误码、对方站点反爬策略、DOM 结构变化 | 文件并发写入冲突、JSON 格式解析错误、用户无效输入参数 |
| 状态驻留特征 | 无状态(Stateless):程序终止即释放,不依赖上一次运行记忆 | 有状态(Stateful):强依赖持久化文件,需管理自增 ID 与更新标记 |
| 核心解耦要点 | 网络 I/O 函数与 DOM 解析器分离,方便对解析器进行静态 Mock 测试 | 业务逻辑(Service)与表现层(CLI)分离,业务层绝不耦合命令行打印 |
| 扩展演进方向 | 引入异步并发(asyncio/aiohttp)、多页面递归调度、IP 代理池 |
替换存储底层(换为 SQLite/ORM)、接入 Web/GUI 界面、多用户支持 |
无论是写爬虫还是写控制台工具,最普遍的缺陷就是将所有逻辑都平铺在全局作用域中。要写出整洁、健壮的 Python 代码,最有效的习惯是:在下笔写第一行代码前,先问清楚自己三个问题:哪些是易变且不可控的外部依赖?哪些是纯粹的数据转换逻辑?哪些是需要长期保存的状态?将这三者用不同的函数或类隔离开,系统的稳定性和可测试性就会自然建立起来。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









