

新手学Python常犯的语法错误及调试方法
深入拆解新手学习Python时最常犯的语法错误类型、报错回溯Traceback的阅读诀窍、以及系统化的四步调试定位方法与编辑器排查技巧。
SyntaxError 或 IndentationError。这类错误发生在 Python 将源代码编译为字节码的解析阶段,本质上是代码的书写规则违背了词法和语法的严谨约定。只要理清解释器的解析拦截机制、学会阅读 Traceback 报错回溯指示器,并建立标准排查步骤,便能在几秒钟内快速定位并解决绝大多数语法故障。
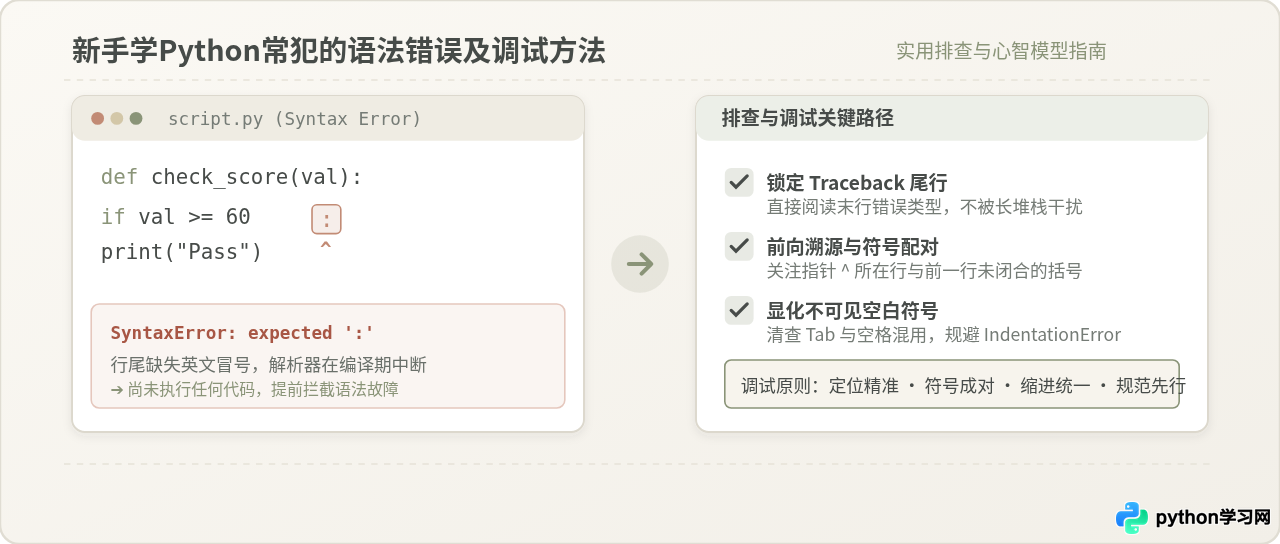
一、为什么代码一行都没执行就报错:理解编译期拦截机制
很多刚接触编程的读者常有这样一个困惑:“我在脚本的第一行明明写了 print('程序启动'),为什么一运行不仅没有打印出任何字,反而直接抛出第 20 行的语法错误?”
这个现象看似反直觉,其实源于 Python 解释器的工作方式。Python 虽然常被归类为解释型脚本语言,但它在真正执行代码之前,必须先经过一个完整的词法分析与语法解析(Lexing & Parsing)阶段。在此阶段,解释器将我们编写的 .py 文本流切分为 Token 词法单元,并尝试自顶向下构建 AST(抽象语法树)。
如果在这个静态扫描阶段发现缺少了括号、冒号遗漏或缩进混乱,语法解析器会立刻判定该文件为“非法语句”,直接抛出 SyntaxError 并全盘中止,根本不会进入虚拟机(PVM)的运行阶段。这也是为什么前面的任何业务代码都不会被触发。
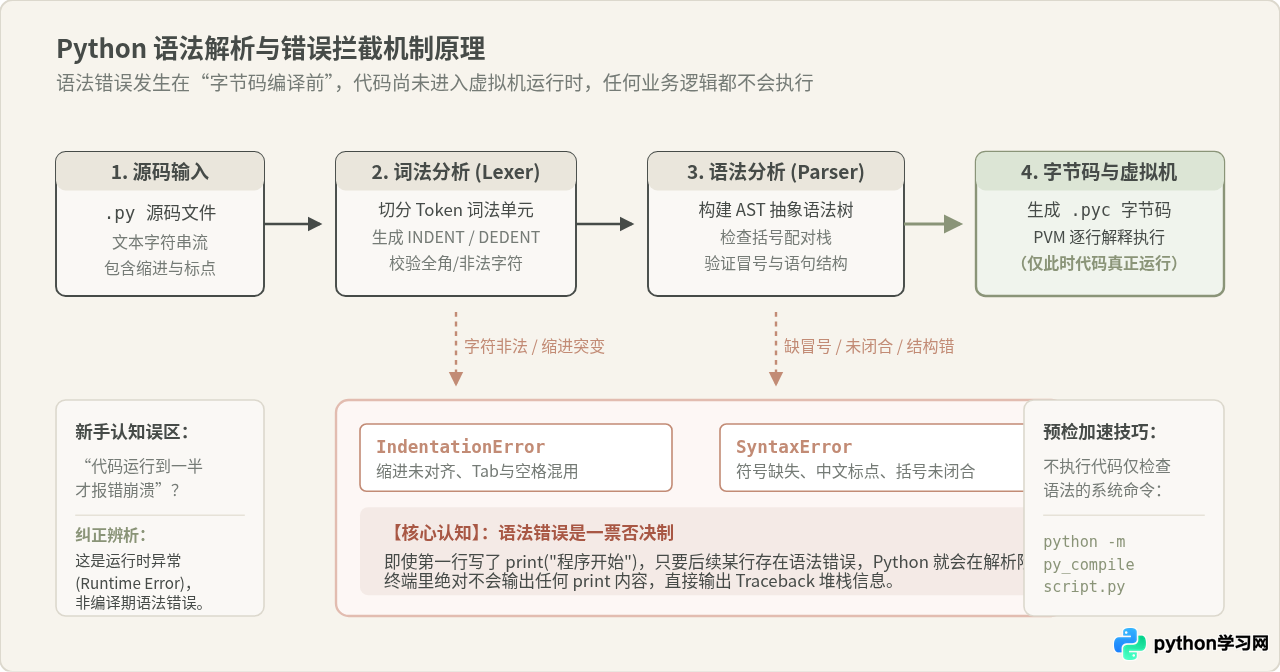
• 语法错误(Compile-time):代码语法结构不合规(如括号未闭合、缺冒号)。一票否决,代码一行都不会执行。
• 运行时异常(Runtime Exception):语法完全合规,但在执行逻辑中发生运算冲突(例如
ZeroDivisionError、IndexError 或 FileNotFoundError)。前面的代码会正常输出,直到执行到故障行才发生崩溃。
二、新手最常踩的五大语法错误及实际案例
语法错误看似千奇百怪,但归结起来,初学者在日常编码中 90% 以上的语法报错都集中在以下五个具体场景中。
1. 缩进错误:Tab 与空格混用或对齐缺失
Python 放弃了传统 C/Java 语言中的花括号 {},改用空格缩进来划定代码块层级。这让代码视觉上更加工整,但对缩进的一致性提出了绝对严苛的要求。
最隐蔽的缩进陷阱发生在同时使用 Tab 键和空格键。在许多文本编辑器中,1 个 Tab 键与 4 个空格在视觉宽度上完全一样,但对于 Python 词法分析器来说,它们是完全不同的 Token 符号。在 Python 3 中,混用 Tab 与空格会直接触发致命报错:
示例代码:Tab 与空格混编def calculate_area(width, height):
# 下一行用 4 个空格缩进
area = width * height
# 下一行若无意按了 Tab 键进行缩进
return areaTabError: inconsistent use of tabs and spaces in indentationSpaces: 4,并执行 Convert Indentation to Spaces 命令,彻底将历史 Tab 字符替换为纯空格。
2. 控制语句行尾遗漏英文冒号
在 Python 语法规则中,所有开启代码块的复合语句(包括 if、elif、else、for、while、def、class、try、except)在条件或定义声明完毕后,必须以一个半角冒号 : 结尾。
user_role = "admin"
if user_role == "admin"
print("欢迎进入管理后台") File "auth.py", line 2
if user_role == "admin"
^
SyntaxError: expected ':'在 Python 3.10 及以上版本中,错误信息已经非常友好,明确给出了 expected ':'(期望冒号)的提示,并且指针 ^ 正好指向行尾。
3. 中英文全角符号混淆
在编写中文注释、中文提示字符串时,输入法若未及时切回半角英文状态,就会将中文全角的逗号 ,、括号 ()、冒号 : 或引号 “” 敲入代码中。除了字符串字面量内部可以包含中文字符,所有代码控制符号都必须是标准 ASCII 字符。
scores = [88,92, 95]  # 此处88后面是中文全角逗号
if scores[0] >= 90:    # 此处结尾是中文全角冒号
print("优秀") File "grade.py", line 1
scores = [88,92, 95]
^
SyntaxError: invalid character ',' (U+FF0C)提示中的 invalid character ',' (U+FF0C) 直接标出了非法字符的 Unicode 编码,此时只需将其切换为半角英文逗号 , 即可。
4. 括号与引号未成对闭合(EOF 陷阱)
在编写长字典、复合列表或嵌套函数调用时,常常写了左括号 ( 却忘记补全右括号 )。此时 Python 解释器在读完当前行后,会认为当前语句尚未结束,进而继续吞噬下一行内容,直到读到文件末尾(End of File)仍未闭合,便会抛出极其迷惑新手的 unexpected EOF while parsing。
# 第 5 行:print 函数左括号开启,但未在行尾闭合
total_amount = sum([12.5, 34.0, 50.0]
print("计算完成,总额为:", total_amount) File "summary.py", line 6
print("计算完成,总额为:", total_amount)
^^^^^
SyntaxError: invalid syntax很多新手会反复检查第 6 行的 print 是不是拼写错误,却百思不得其解。实际上,第 6 行本身完全没有问题,病根在于第 5 行的 sum(...) 外部漏掉了右半括号!
5. 条件分支中混淆赋值符号(=)与相等比较(==)
在数学表达中,“等号”既代表相等,又可代表赋值。但在 Python 语法中,单等号 = 是赋值运算符,用于给变量赋予新对象;双等号 == 才是判断两侧值是否相等的比较运算符。在 if 条件中误写单等号会直接触发语法拦截:
status_code = 200
if status_code = 200:
print("请求成功") File "network.py", line 2
if status_code = 200:
^^^^^^^^^^^^^^^^^
SyntaxError: invalid syntax. Maybe you meant '==' or ':=' instead of '='?现代 Python 解释器已经具备高度智能的提示能力,直接询问是否意图使用 ==(或海象运算符 :=),只需将单等号修正为双等号即可。
三、读懂 Traceback:语法报错信息深度拆解
面对终端打印的一长串红色或白色英文报错,不少新手容易产生挫败感,甚至下意识地关闭终端去代码里凭感觉碰运气。事实上,Python 的错误堆栈(Traceback)是极其精简且规范的诊断书,只要掌握其固定格式,定位时间不会超过 5 秒。
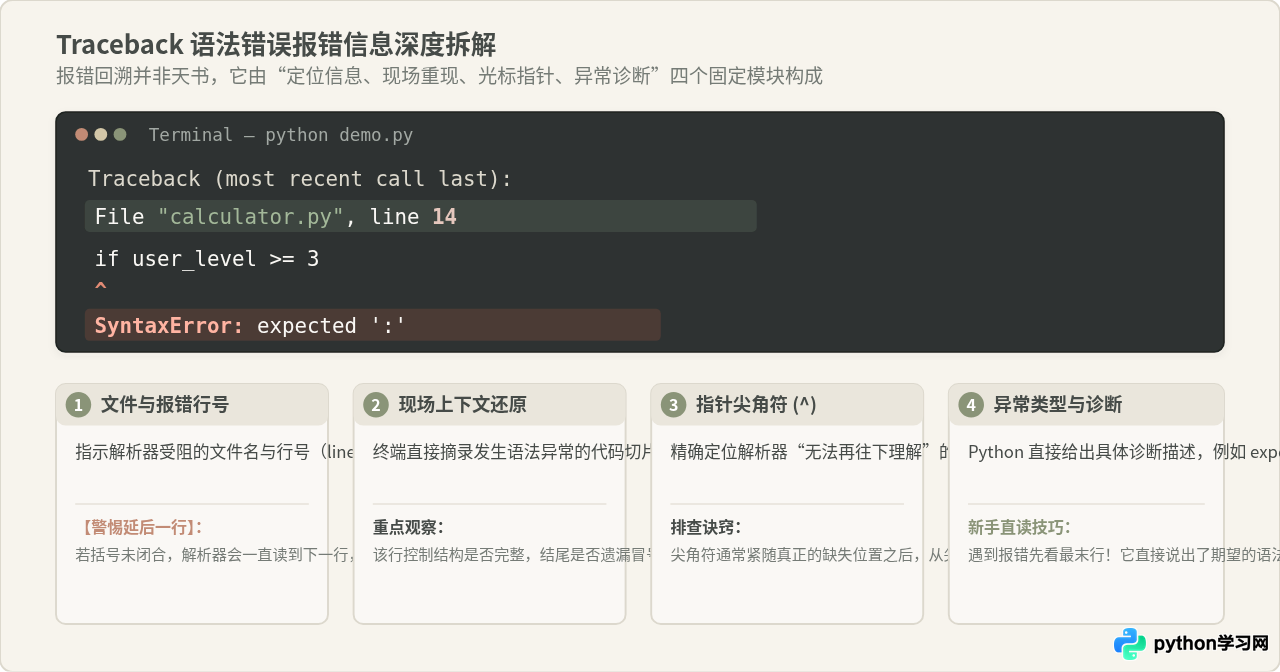
如上图所示,一个标准的语法错误回溯包含四个核心层级:
- 文件与行号定位区(File & Line):指明出现语法中断的源码文件名及物理行号(如
line 14)。这是调试排查的第一着陆点。 - 代码切片现场(Code Context):解释器从源码中截取的可疑代码行,方便开发者快速对照上下文。
- 字符定位指针(Caret
^):尖角符精准指示了解析器“再也无法继续合法解析下去”的字符位置。通常错误就发生在尖角符所指字符或其前紧邻的字符上。 - 异常类型与描述(Error Name & Message):最末尾的一行直接给出异常分类(如
SyntaxError)及具体原因(如expected ':'、unterminated string literal)。
许多初学者常问:“为什么报错指向第 18 行,但我仔细看第 18 行代码完全合规?”
原因在于语法解析器的向前预读机制(Lookahead Parsing):当我们在第 17 行开启了一个括号
(、中括号 [ 或三引号,但在该行末尾忘记关闭时,Python 解释器并不知道你是忘记闭合,还是打算在下一行继续书写多行表达式。因此,解析器会把第 18 行作为括号内部的代码继续合并解析,直到遇到完全不合语法的标识符或者下一级结构时才“猛然察觉错误”。因此,当报错行语法看似无懈可击时,第一反应必须是往上看上一行!
四、语法错误排查的四步标准流程
为了避免在大型代码文件中盲目巡检,建立标准化的四步排查流程能够大幅提升调试效率。
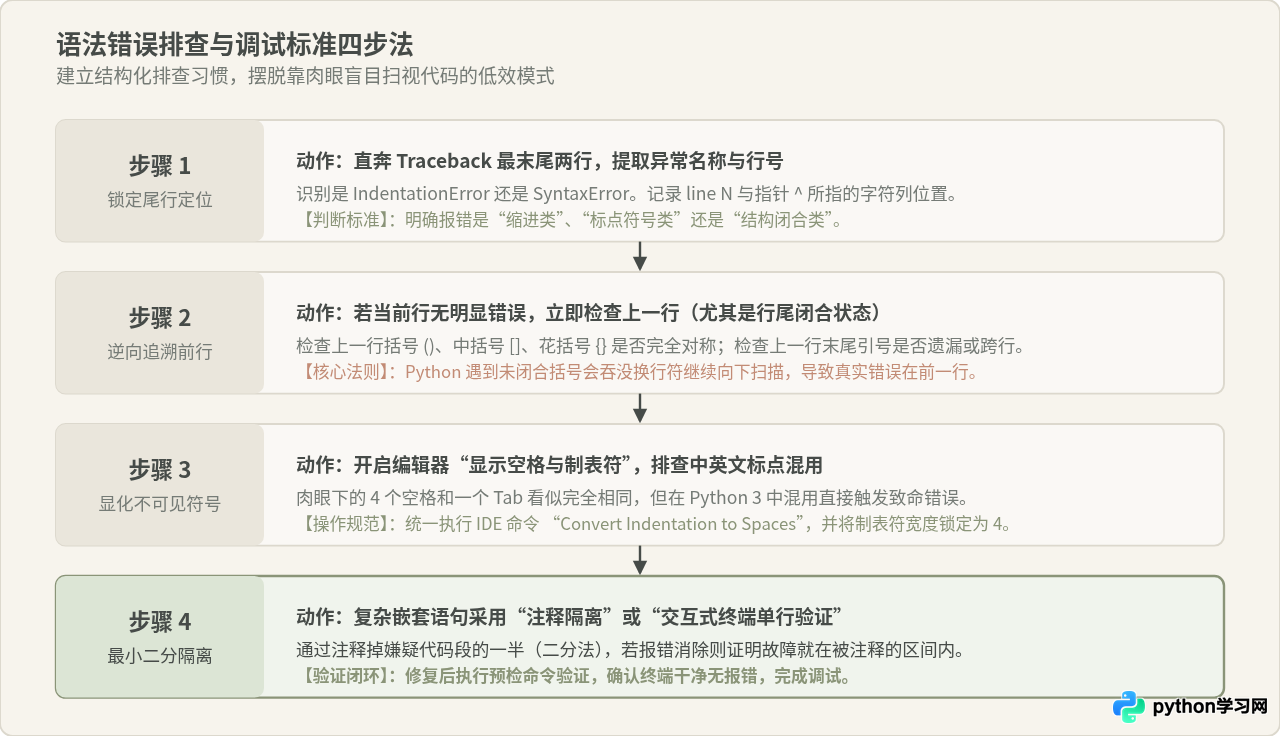
步骤 1:锁定回溯末行,提取关键异常信息
调试的第一个动作是把视线直接移到终端最底部两行。先辨认错误属于哪一种:是 IndentationError(缩进问题),还是 SyntaxError(符号/结构问题)。接着记录报错行号(Line N)与尖角符指针(^)的位置。切忌从最上层的大段调用栈开始肉眼阅读。
步骤 2:逆向追溯前行,检查符号闭合三要素
依据定位的行号,跳转到对应代码位置。首先检查当前行末尾是否有冒号,是否存在中文标点;如果当前行一切正常,立即向上检查前一行(Line N-1)的行尾闭合状态:
- 所有圆括号
()、方括号[]、花括号{}是否数量对称? - 单引号
'与双引号"是否成对,是否存在未转义的特殊字符? - 跨行多行文本是否规范使用了三引号
"""或'''?
步骤 3:显化不可见字符,统一排查缩进规范
若报错属于 IndentationError,不要试图用键盘空格键一点一点对齐。在开发工具中开启“显示所有空白字符”(Whitespace Render),观察行首点号(代表空格)与箭头(代表制表符 Tab)。
如果发现同级代码块中有的行是 4 个点,有的行是 1 个箭头,或者缩进层级前后错位,直接删除行首所有空白,使用 Tab 键重新排版(确保编辑器已开启 Tab 自动转 4 空格功能)。
步骤 4:最小隔离法验证(注释二分法)
当一段复杂的嵌套逻辑持续报错且难以一眼看出问题时,切忌不断添加新代码尝试修补。此时应使用“最小隔离法”:
- 使用
#将报错代码段中可疑的后半部分注释掉,或者将复杂表达式拆解为单行中间变量。 - 重新运行脚本或使用测试命令检查报错是否消失。
- 通过这种“二分注释法”,可以在 1~2 次尝试中将问题精确缩小到具体的某一个表达式或变量命名上。
五、善用工具:让编辑器成为第一道防线
在实际开发中,成熟的开发者极少依赖运行脚本后再去终端查看语法错误,因为现代开发工具能够在代码键入的瞬间完成语法静态检测并标红波浪线。
1. 编辑器必要参数配置
以广泛使用的 VS Code 为例,只需调整以下三个核心配置,就能在根源上消灭大部分缩进与符号失误:
editor.renderWhitespace: "all":始终显示空格与制表符,让代码缩进形态一览无余。editor.insertSpaces: true搭配editor.tabSize: 4:按下 Tab 键时自动输出 4 个空格,杜绝 Tab 与空格混用。editor.bracketPairColorization.enabled: true:启用彩虹括号着色,不同嵌套深度的括号自动呈现不同色彩,配对闭合一目了然。
2. 静态语法检查工具(Linter)
在编辑器中启用如 Flake8 或极其快速的 Ruff 插件。这类工具会在我们敲完代码但尚未保存运行之时,就在语法错误下方画出红色波浪线,并在悬浮窗中直接给出修正建议。
3. 不运行业务代码的预检命令
如果手头没有图形化 IDE,或者在服务器终端维护脚本,又不想让业务代码真正执行造成脏数据,可以使用 Python 原生自带的预编译模块进行纯语法检查:
语法预检命令(终端执行)python -m py_compile script.py该命令仅触发词法与语法解析并编译为字节码,不会真正调用任何函数或输出业务 print。若语法存在缺陷,终端会干净利落地报出语法错误;若语法完全合法,命令会静默结束并退出,是快速验货的实用利器。
六、全景总结与避坑自查清单
学习编程的过程本身就是与语法规则磨合的必经之路。面对语法错误,不必产生挫败感,因为每一次报错都是语法解析器在阻止潜在的不确定性逻辑蔓延到生产环境中。
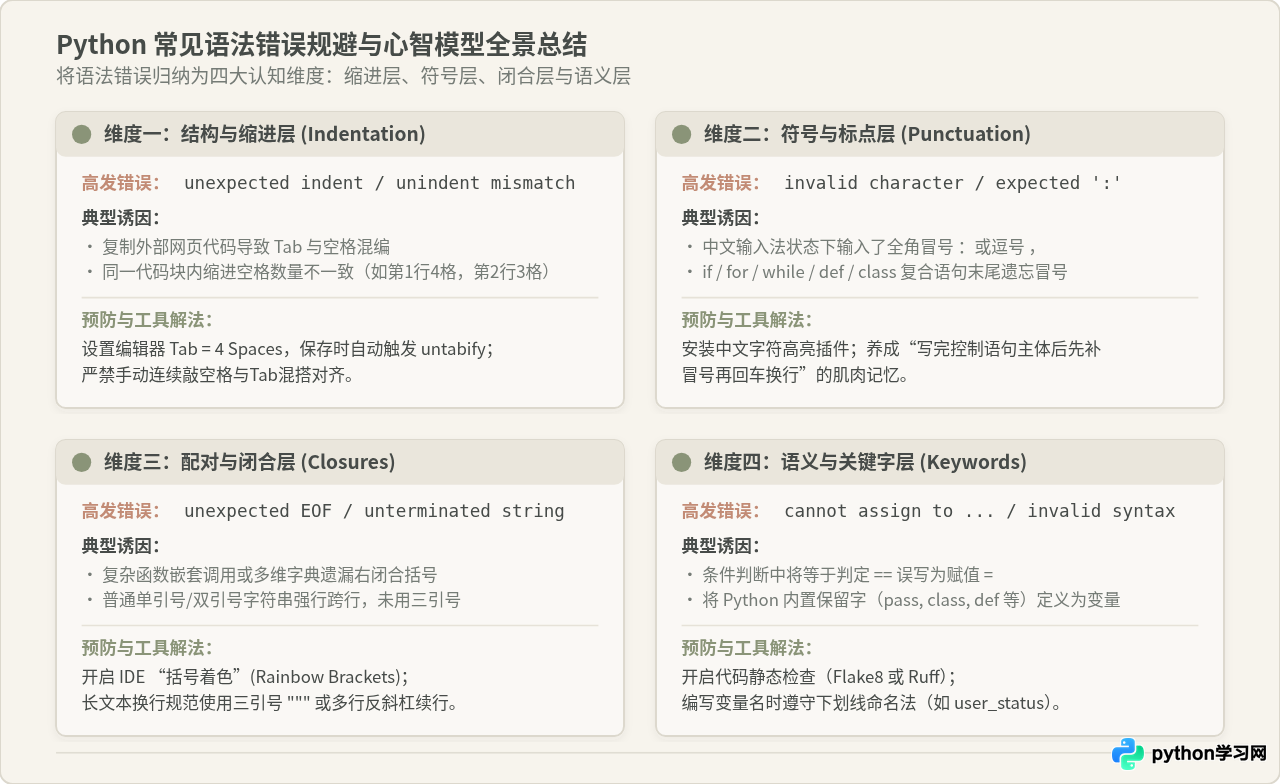
日常排查 6 点自查清单(Checklist)
- 冒号自查:
if、for、while、def、class、try、else所在行结尾是否都带上了半角英文冒号:? - 闭合自查:所有括号
()、中括号[]、花括号{}是否成双成对?上一行末尾是否遗漏闭合符号? - 输入法自查:代码中的逗号、引号、冒号是否误用了中文全角符号?
- 缩进自查:同一代码块内部的缩进空格数是否完全对齐?是否存在 Tab 与空格混用?
- 比较自查:条件判断语句中比较大小或状态时,是否误把双等号
==写成了单等号赋值=? - 追溯原则:当报错行看起来毫无毛病时,是否已经向上回溯了前一行的语句完整性?
掌握了这一套认知结构与调试手法后,遇到语法报错即可做到心中有数、手下不慌,将宝贵的精力和时间聚焦于核心业务逻辑与算法实现之中。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









