

解决Python 2中常见的UnicodeDecodeError编码错误
深入剖析Python 2中常见的UnicodeDecodeError: 'ascii' codec can't decode byte报错原因,提供基于Unicode Sandwich模型的标准解决步骤、代码示例、场景修复及避坑指南。
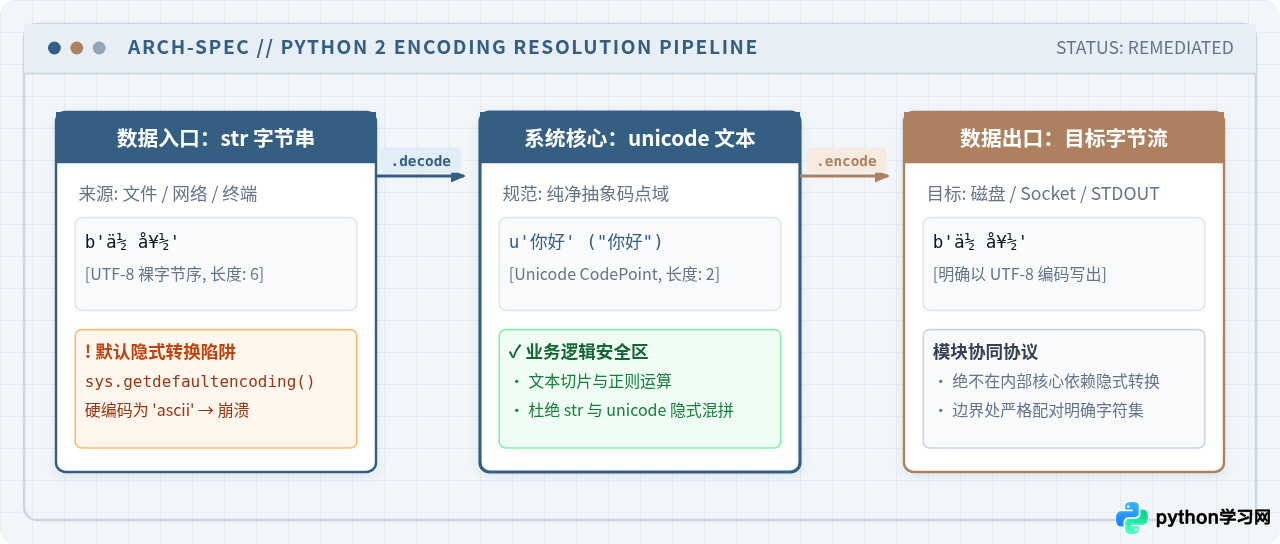
在 Python 2 运行环境中,当控制台或日志出现 UnicodeDecodeError: 'ascii' codec can't decode byte ... 时,根本原因是程序在未显式指明字符集的情况下,尝试将包含非 ASCII 字符(如中文 UTF-8 编码字节)的裸字节串(str)隐式转换为统一码(unicode)。Python 2 解释器默认采用 ASCII 解码器执行隐式转换,一旦在待处理字节流中扫描到数值大于等于 128 的字节(如 ä 对应的十进制 228),便会立刻中断并抛出异常。彻底解决该问题的工程规范是实施“Unicode 三明治”(Unicode Sandwich)模型:在数据入口边界显式解码为 unicode,在系统核心内部统一使用 unicode 处理业务逻辑,在数据出口边界显式编码为目标字节串,严禁依赖解释器的隐式转换机制。
一、典型报错现场与错误触发形式
在日常开发与维护遗留 Python 2 服务时,该错误通常以如下异常堆栈形式爆发:
Traceback (most recent call last):
  File "process_text.py", line 14, in <module>
    result = prefix + raw_name
UnicodeDecodeError: 'ascii' codec can't decode byte 0xe4 in position 0: ordinal not in range(128)
分析报错信息中的几个核心要素,有助于快速定位现场:
'ascii' codec:表示 Python 2 正在调用的解码算法是 ASCII。由于开发者没有显式调用.decode('utf-8'),解释器启用了系统默认的 ASCII 编解码器。can't decode byte 0xe4:表示触发崩溃的具体字节是十六进制0xe4。在 UTF-8 编码体系中,常用汉字通常占用 3 个字节,其中高频汉字首字节往往在0xe4到0xe9区间(例如汉字“你”的 UTF-8 编码为ä½)。ordinal not in range(128):ASCII 编码标准仅定义了 0 到 127 号字符。当遇到0xe4(十进制 228)时,超出了 ASCII 码表的有效范围,解码直接失败。
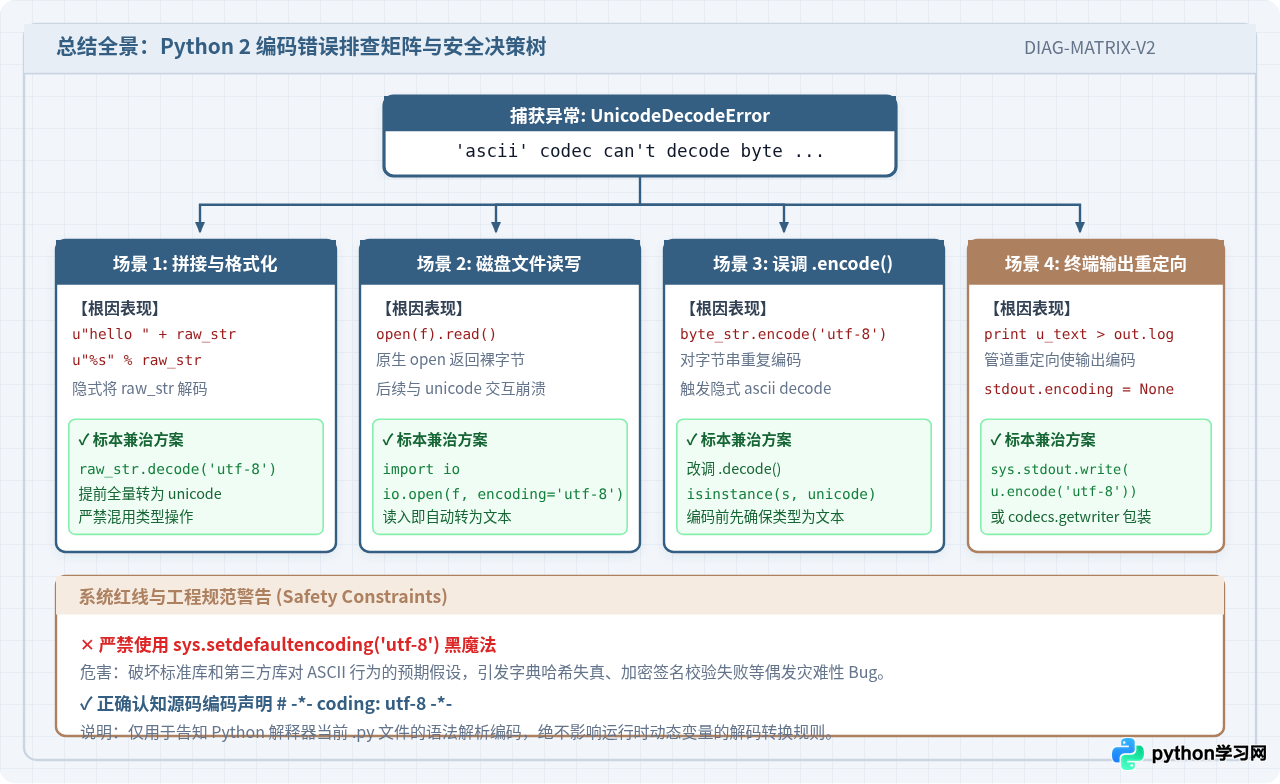
在实际项目中,该错误最容易在以下四类场景中静默潜伏:
- 字符串拼接或格式化:一个
unicode对象与一个包含非 ASCII 字符的str对象进行+连接或%模板插值。 - 磁盘文件读写:使用内置
open()直接读取文件,返回的是未经解码的str裸字节,后续将其作为纯文本处理。 - 误调
.encode():对已经是str类型的变量再次调用.encode('utf-8'),触发隐式反向解码。 - 终端标准输出重定向:通过管道将含有
unicode的输出重定向到日志文件时,环境未配置有效字符集,引发隐式 ASCII 编码失败。
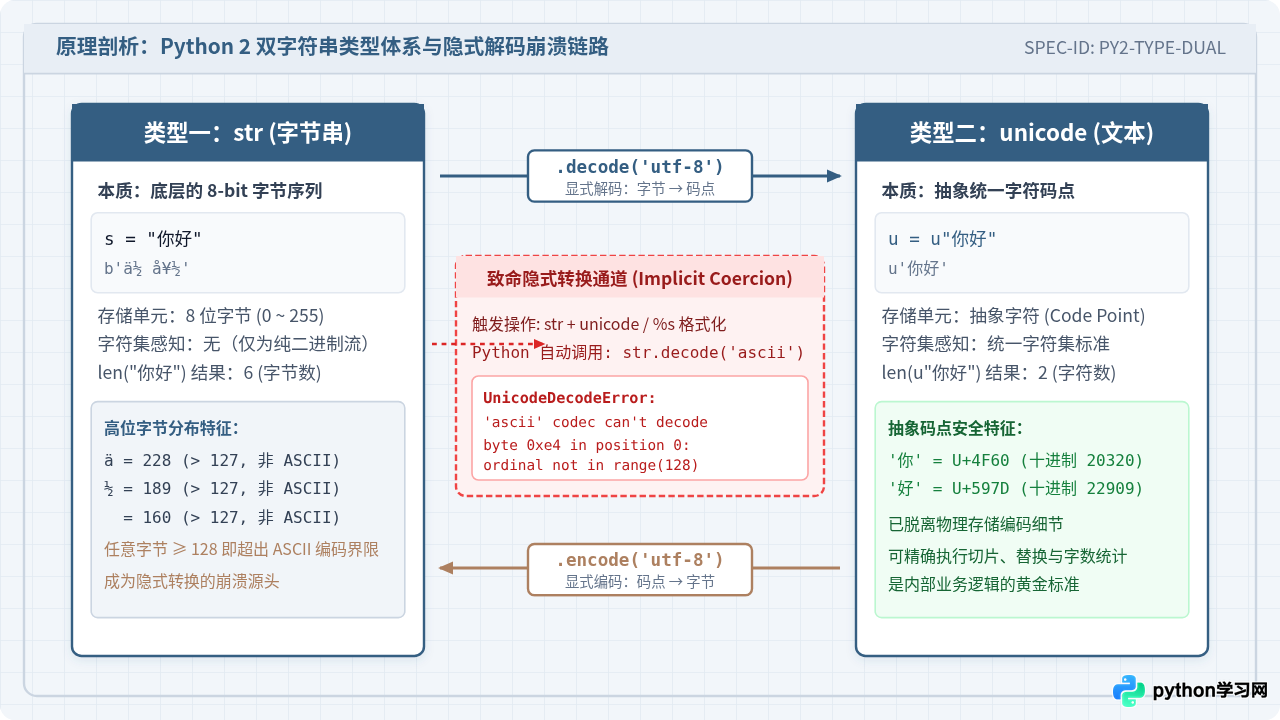
二、根本原因剖析:Python 2 的双字符串类型与隐式升级机制
Python 2 设计之初,计算机系统对多语言字符集的处理尚未完全标准化。这导致 Python 2 内存中并存两种本质不同的字符串类型:
| 对比维度 | str 类型(字节串) |
unicode 类型(文本) |
|---|---|---|
| 底层本质 | 8 位裸字节序列(Bytes),无语义编码 | 统一码抽象码点序列(Code Points) |
| 字面量表示 | s = "你好" |
u = u"你好" |
UTF-8 下长度 len() |
len("你好") == 6(计算物理字节数) |
len(u"你好") == 2(计算逻辑字符数) |
| 合法数值区间 | 单字节 0x00 ~ 0xFF(0 ~ 255) |
U+0000 ~ U+10FFFF |
当执行跨类型混合运算(例如 u"用户:" + "张三")时,Python 2 遵循所谓的“自动类型提升”(Coercion)机制:解释器强制将 str 提升为 unicode,以便与另一侧的 unicode 对齐。但在提升时,解释器必须将字节翻译为字符,此时它会自动调用内部的默认解码逻辑:
# 开发者书写的代码:
result = u"用户: " + name_str

# 解释器在虚拟机层面实际执行的等价转换:
result = u"用户: " + name_str.decode(sys.getdefaultencoding())
在未经修改的 Python 2 环境中,sys.getdefaultencoding() 返回的永远是 'ascii'。只要 name_str 中包含任何中文字符或非 ASCII 符号,该隐式 .decode('ascii') 便必定在毫秒级内崩溃。
三、标本兼治:Unicode Sandwich 标准处置四步流程
要彻底杜绝 UnicodeDecodeError,必须在代码架构层面落实 Unicode Sandwich(Unicode 三明治) 设计模式。该模式要求将程序划分为三层清晰的边界:入口层将外来字节全量解码为 Unicode;核心层全量处理 Unicode;出口层将 Unicode 编码为目标字节写出。
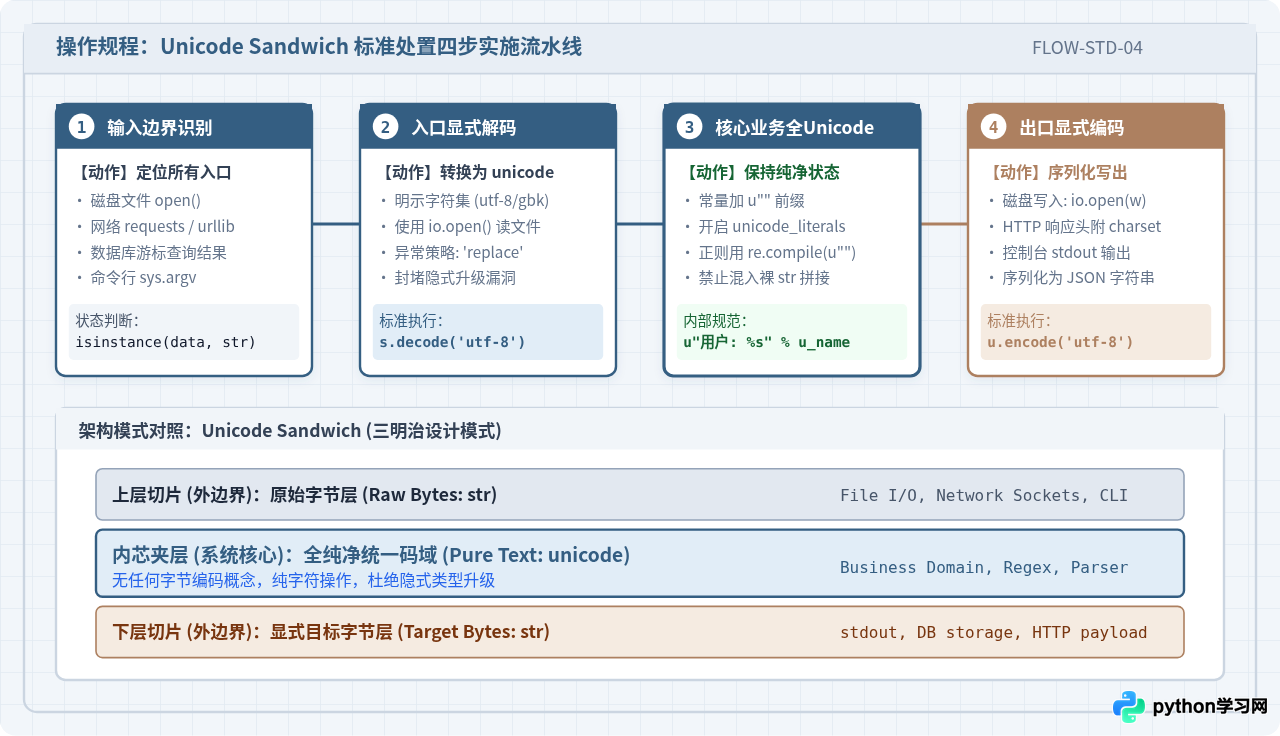
步骤 1:输入边界识别与捕获
所有来自程序外部的数据,在 Python 2 中默认都是 str 字节串。排查程序中所有 I/O 边界:
- 从磁盘文件读取的数据(
file.read()); - 通过网络接收的请求载荷(
urllib2、socket、requests.content); - 命令行参数(
sys.argv)与环境变量(os.environ); - 数据库驱动查询返回的非 Unicode 字段。
步骤 2:在边界处显式解码为 unicode
一旦获取字节数据,必须在其进入业务逻辑的第一行代码处,显式调用 .decode(encoding),明确指定其原始编码(国内系统通常为 utf-8 或 gbk)。如果不确定输入是否存在坏字节,可指定容错策略:
# 严格模式:遇到非法字节直接显式报错,便于及早排查源头脏数据
clean_text = raw_bytes.decode('utf-8', 'strict')

# 容错模式:遇到非法字节替换为 Unicode 替换字符 U+FFFD(),保证主进程不中断
safe_text = raw_bytes.decode('utf-8', 'replace')

# 忽略模式:直接丢弃非法字节(按需谨慎使用)
stripped_text = raw_bytes.decode('utf-8', 'ignore')
步骤 3:核心业务逻辑全流程纯 Unicode 运行
在模块内部的函数调用、数据处理、正则表达式匹配和字符串拼接中,所有变量必须且只能是 unicode 类型。
- 在源文件顶部引入
from __future__ import unicode_literals,使得当前模块中所有不带前缀的字符串字面量"hello"自动被解析为unicode; - 若未引入该未来特性,所有中文常量必须严格加上
u前缀,例如u"处理成功"; - 严禁在核心算法层将
str与unicode混合放置在同一列表、字典或拼接语句中。
步骤 4:在输出边界显式编码为目标字节流
当数据需要输出到外部介质(磁盘、网络响应、日志系统、终端)时,统一在出口处调用 .encode(target_encoding) 转换为字节流:
# 写入文件或网络 Socket
output_bytes = u_result.encode('utf-8')
socket.sendall(output_bytes)
四、常见故障场景与完整修复代码对照
场景 1:字符串拼接与格式化报错
错误代码现场:
# -*- coding: utf-8 -*-
name = "张三"            # 未加 u 前缀,类型为 str(UTF-8 字节串)
template = u"当前用户: %s" # 加了 u 前缀,类型为 unicode

# 尝试拼接,触发隐式 name.decode('ascii') -> 崩溃!
message = template % name
规范修复方案:
保证占位符两端类型完全对齐,将字节串显式转换为 unicode 后再执行格式化:
# -*- coding: utf-8 -*-
name_bytes = "张三"

# 方案 A:显式解码对齐
name_unicode = name_bytes.decode('utf-8')
message = u"当前用户: %s" % name_unicode

# 方案 B:统一声明为 unicode 字面量
name_clean = u"张三"
message = u"当前用户: %s" % name_clean
场景 2:原生 open() 读取文件与跨模块处理
错误代码现场:
Python 2 内置的 open() 函数缺乏编码感知能力,读入的每一行都是 str 裸字节。
# 错误示范:读入后直接参与 unicode 比较或拼接
with open("data.txt", "r") as f:
    for line in f:
        # line 为 str,若与 u"关键字" 匹配或拼接则极易报错
        if u"北京" in line:  # line 被隐式用 ASCII 解码 -> 崩溃!
            print line
规范修复方案:
使用标准库 io.open 代替内置 open。io.open 是 Python 3 文件操作的向后兼容移植版本,能够在 I/O 边界自动完成编码与解码:
# -*- coding: utf-8 -*-
import io

# 读文件:指定 encoding,读取出来的对象天然是 unicode
with io.open("data.txt", mode="r", encoding="utf-8") as f:
    for line in f:
        # line 为 unicode 对象,完全兼容各种中文处理
        if u"北京" in line:
            print line.strip()

# 写文件:接收 unicode 对象,在写入物理磁盘时自动编码为 UTF-8
with io.open("output.txt", mode="w", encoding="utf-8") as f:
    f.write(u"汇总结果:完成
")
场景 3:误用 str.encode() 导致的“二次隐式解码陷阱”
许多初学者在遇到编码报错时,会凭直觉写出 s.encode('utf-8'),期望将变量“转成 UTF-8”。然而,如果该变量本身已经是 str 类型,这行代码反而会必定引发 UnicodeDecodeError!
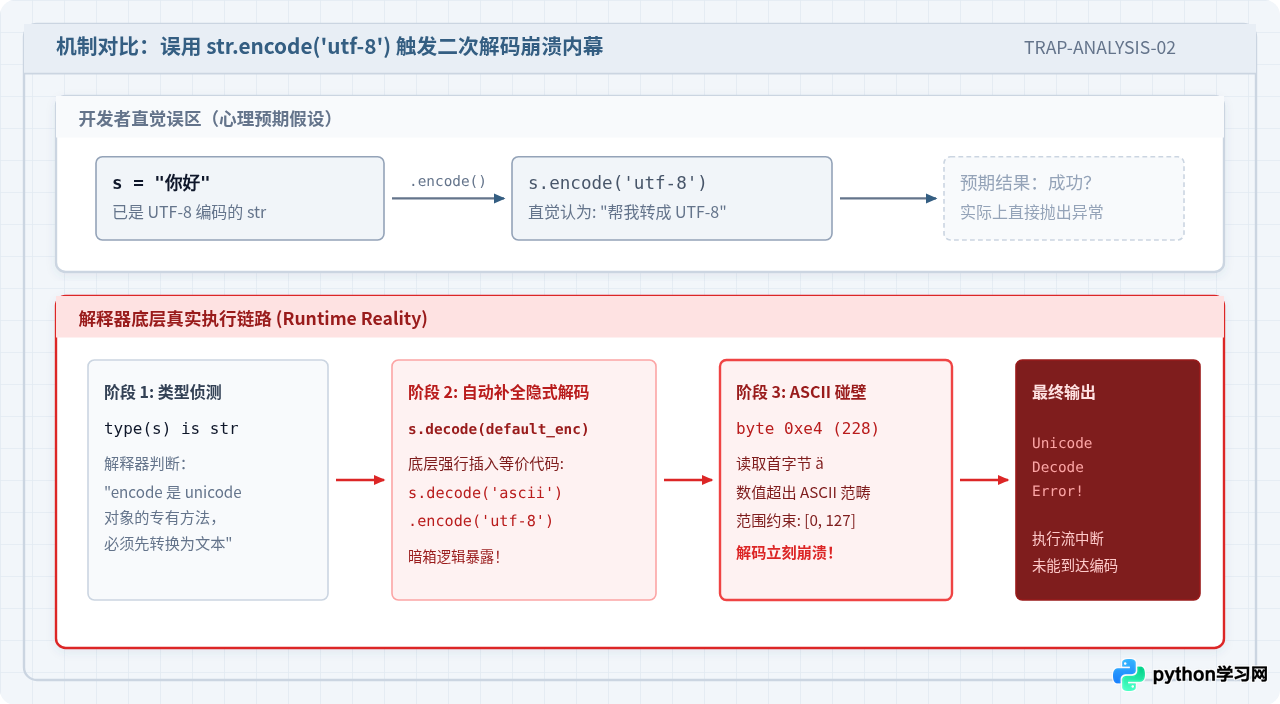
这是因为在 Python 2 虚拟机中,encode 的语义是“将抽象文本编码为物理字节”。当对一个已经是 str(物理字节)的对象调用 .encode() 时,解释器认定该对象需要先还原成抽象文本,因而自动注入了 .decode('ascii')。
规范防御模式:
在不确定变量是 str 还是 unicode 时,编写类型守卫函数进行安全收敛:
# -*- coding: utf-8 -*-

def ensure_unicode(text, encoding='utf-8'):
    """将任意字符串输入安全规范化为 unicode 对象"""
    if isinstance(text, str):
        return text.decode(encoding, 'replace')
    elif isinstance(text, unicode):
        return text
    else:
        return unicode(text)

def ensure_bytes(text, encoding='utf-8'):
    """将任意字符串输入安全规范化为目标编码的 str 字节串"""
    if isinstance(text, unicode):
        return text.encode(encoding)
    elif isinstance(text, str):
        return text
    else:
        return str(text)
场景 4:控制台输出与重定向管道报错
一段包含 print u"测试文本" 的代码在直接连接终端时运行正常,但通过后台脚本重定向(例如 python app.py > run.log)时却突然崩溃。
原因在于终端前台运行时,sys.stdout.encoding 会自动探测终端环境并绑定编码(如 UTF-8)。而一旦通过管道重定向到文件或交由 cron 调度,Python 2 无法探测目标终端类型,会将 sys.stdout.encoding 置为 None,此时 print 会退化为使用默认的 ASCII 编码。
规范修复方案:
在入口处通过 codecs.getwriter 包装标准输出,或显式编码输出:
# -*- coding: utf-8 -*-
import sys
import codecs

# 方案 A:包装 stdout,重定向时自动以 UTF-8 输出
sys.stdout = codecs.getwriter('utf-8')(sys.stdout)
print u"中文输出正常,即使重定向也不会报错"

# 方案 B:显式编码写入字节流
sys.stdout.write((u"执行日志: 任务启动
").encode('utf-8'))
五、生产环境避坑指南与反模式警示
在互联网旧教程中,广泛流传一段所谓“一劳永逸”的代码:
import sys; reload(sys); sys.setdefaultencoding('utf-8')
在生产环境中绝不应当使用此方案。
深入原因:site.py 在 Python 初始化完成后故意将 setdefaultencoding 从 sys 模块命名空间中删除,正是为了防止开发者随意更改它。许多经过严格验证的标准库与第三方库(例如 pickle、csv、网络底层解析库)都显式依赖“默认编码为 ASCII”这一底层假设。强制修改全局默认编码会导致:
- 字典键查找异常:同样内容的
str与unicode在特定哈希计算中产生冲突; - 掩盖业务代码的架构缺陷,导致隐藏的转码 Bug 传递到下游数据库或第三方 API;
- 在 C 扩展模块调用中引发偶发内存段错误(Segmentation Fault)。
文件开头的 # -*- coding: utf-8 -*- 仅仅是告诉 Python 解释器在读取当前 .py 文本文件时采用何种编码来解析源码中的字符。
它绝对不会改变运行期动态数据的类型,也不会让 "你好" 变成 unicode。如果你在声明了 UTF-8 的代码里写 s = "你好",s 依然是一个 6 字节长度的 str。要获得真正文本对象,依然必须显式声明 u"你好" 或执行 .decode('utf-8')。
六、解决效果验证与排查自检清单
在完成代码修复后,可通过以下诊断矩阵确认环境与逻辑的健康度:
| 排查层级 | 检查操作与验证方法 | 健康状态判定 | 异常处理方案 |
|---|---|---|---|
| 输入边界 | 在数据入口打印 type(data) 与内容 repr |
进入核心逻辑前全为 unicode |
显式补充 .decode(source_enc) |
| 文件读写 | 检查是否仍有原生 open() |
所有文本 I/O 均使用 io.open(..., encoding=...) |
批量替换为 io.open |
| 字符串拼接 | 排查 + 与 % 操作两侧操作数类型 |
两侧均为 unicode,无 str 混杂 |
将非 Unicode 变量统一转换 |
| 系统默认编码 | 运行 sys.getdefaultencoding() |
返回 'ascii'(说明未被黑魔法篡改) |
移除任何篡改默认编码的代码 |
| 终端与日志 | 执行测试 python app.py > /tmp/test.log |
无 UnicodeEncodeError 或解码中断 |
使用 codecs.getwriter 包装 |
七、总结
解决 Python 2 中的 UnicodeDecodeError,关键不在于寻找某个神奇的全局参数,而在于建立严谨的数据边界意识:
- 牢记 Python 2 内存中
str是纯字节序列,unicode才是抽象字符; - 坚决落实 Unicode Sandwich 模式:入口处解码,核心区只用
unicode,出口处按需编码; - 文件操作使用
io.open,避免混用str与unicode; - 远离
sys.setdefaultencoding带来的全局副作用。
遵循上述标准工程规范,不仅能彻底消除遗留系统中的编码崩溃隐患,还能使代码逻辑与 Python 3 的纯 Unicode 文本模型自然对齐,为后续向现代 Python 版本的平滑迁移奠定坚实基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









