

Python中copy.copy与copy.deepcopy的区别及用法
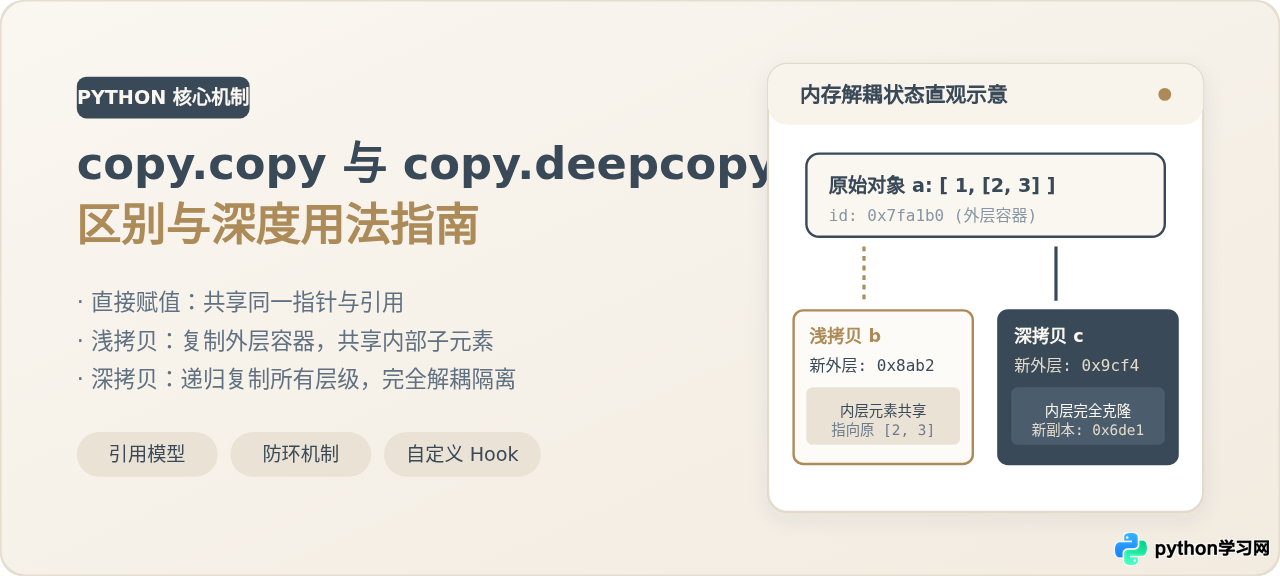
深入解析Python中直接赋值、copy.copy浅拷贝与copy.deepcopy深拷贝的本质区别、内存指针模型、底层memo防环机制以及在工程实践中的具体用法与选型指南。
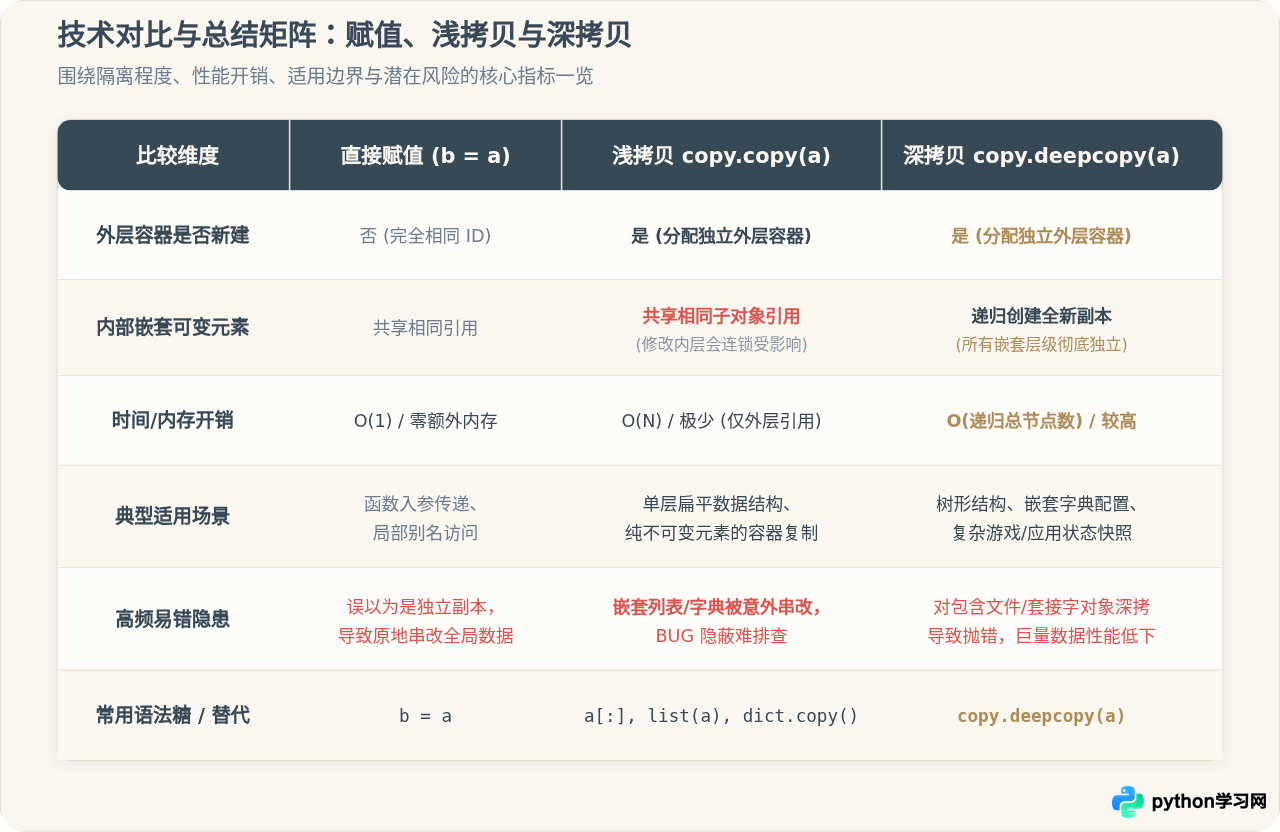
b = a)仅仅是增加了一个指向同一内存地址的对象引用;copy.copy()(浅拷贝)会创建一个全新的外层容器对象,但内部元素仍保持对原对象子元素的引用;而 copy.deepcopy()(深拷贝)则会沿着数据结构递归遍历,将所有层级的可变子对象全部克隆一份全新的副本。当对象内部包含嵌套列表、字典或自定义对象时,修改浅拷贝的子元素会导致原对象同步改变,只有使用深拷贝才能实现彻底的数据隔离与完全独立。
一、变量赋值与拷贝的底层本质
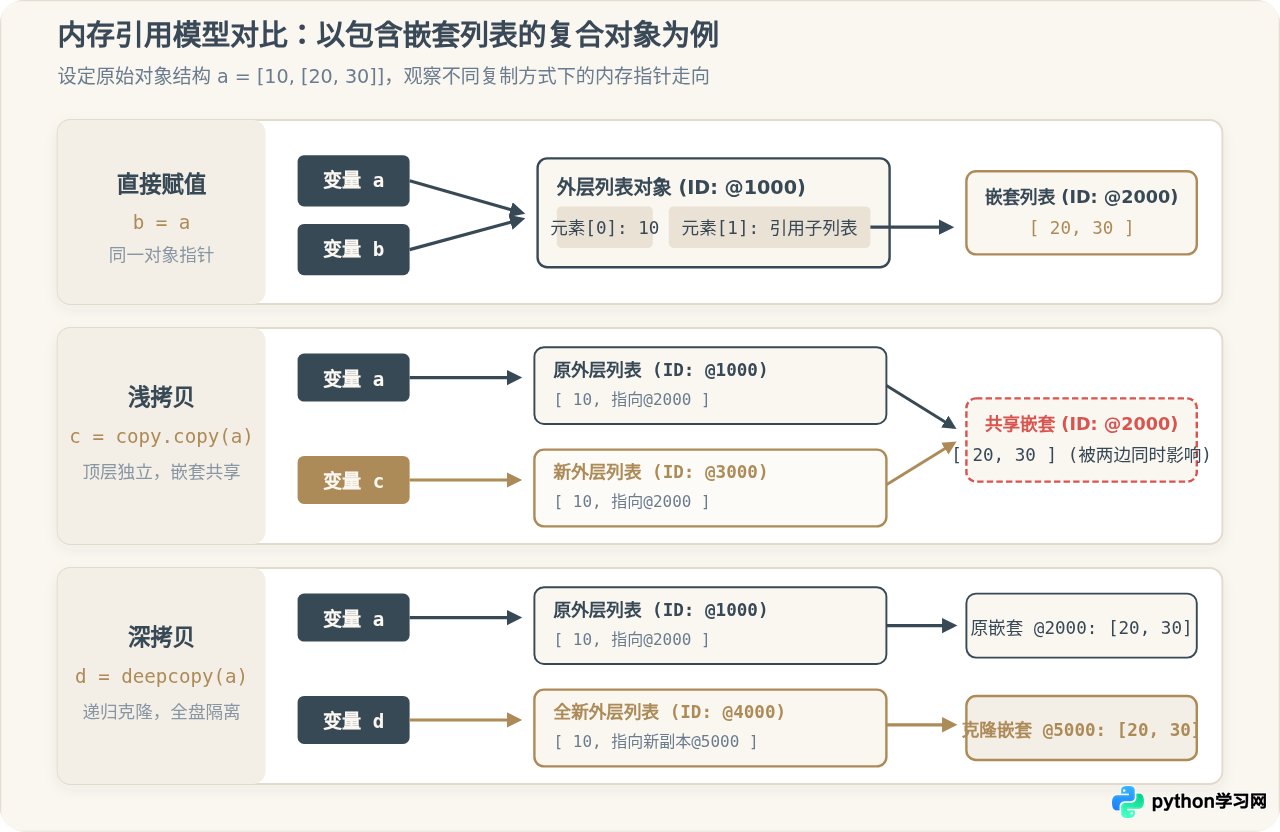
要透彻理解 copy.copy 与 copy.deepcopy,首先需要明确 Python 中“变量名”与“对象”的对应关系。在 Python 的运行时模型中,变量名本质上是一个指向堆内存中对象的“标签”或“指针”。当我们执行 b = a 时,Python 并没有在内存中为 b 重新开辟存储数据的空间,只是把标签 b 贴到了 a 所指向的同一个对象上。
可以通过 Python 内置的 id() 函数获取对象的唯一内存地址标识,从而直观验证这一行为:
# 示例代码:直接赋值的行为
a = [10, [20, 30]]
b = a

print(f"a 的内存地址: {id(a)}")
print(f"b 的内存地址: {id(b)}")
print(f"a 与 b 是否为同一对象: {a is b}")

# 修改 b 的第 0 个元素
b[0] = 99
print(f"修改 b[0] 后,a 的值为: {a}")
运行结果表明,a 和 b 的内存地址完全相同。修改 b,原始变量 a 也会同步变更。如果程序需要修改副本而不污染原数据,直接赋值就无法胜任,必须借助标准库中的 copy 模块进行拷贝操作。
二、copy.copy(浅拷贝)的具体用法与行为边界
浅拷贝的作用是“新建最外层容器,复用内部所有元素的引用”。调用 copy.copy(x) 时,Python 会开辟一块新的内存创建外层对象,并将原对象各个元素的引用复制给新容器。
1. 常见的浅拷贝触发途径
在实际编写 Python 代码时,浅拷贝除了显式调用 copy.copy() 之外,还有很多内置语法糖和工厂方法具有完全相同的浅拷贝效果:
- 标准库函数:
copy.copy(lst) - 切片操作:
lst[:](仅针对列表等可切片序列) - 工厂函数:
list(lst)、dict(d)、set(s) - 内置 copy 方法:
d.copy()、s.copy()
2. 浅拷贝在单层扁平数据结构中的安全表现
如果一个列表或容器内部存放的全是不可变对象(如数字、字符串、布尔值或仅含不可变对象的元组),浅拷贝就能提供足够的隔离保护:
import copy

# 内部全为不可变类型
original = [1, 2, "hello", (3, 4)]
copied = copy.copy(original)

copied[0] = 100
copied[2] = "world"

print(f"原列表 original: {original}")
print(f"副本 copied:     {copied}")
print(f"外层容器地址对比: id(original)={id(original)}, id(copied)={id(copied)}")3. 浅拷贝在嵌套可变对象中的“串改”陷阱
一旦容器内嵌套了可变子对象(如子列表、子字典、自定义类实例),浅拷贝由于只复制了一层指针,两个外层容器的子元素指针仍然指向相同的堆内存块。修改其中一个容器的子对象,会引发隐蔽的数据串改:
import copy

# 包含嵌套子列表
source = ["北京", ["海淀", "朝阳"]]
shallow = copy.copy(source)

# 仅修改外层元素,互不干扰
shallow[0] = "上海"

# 修改嵌套的可变子列表,产生连锁影响!
shallow[1].append("昌平")

print(f"原数据 source:  {source}")
print(f"副本 shallow:   {shallow}")
print(f"嵌套列表内存地址比对: {id(source[1]) == id(shallow[1])}")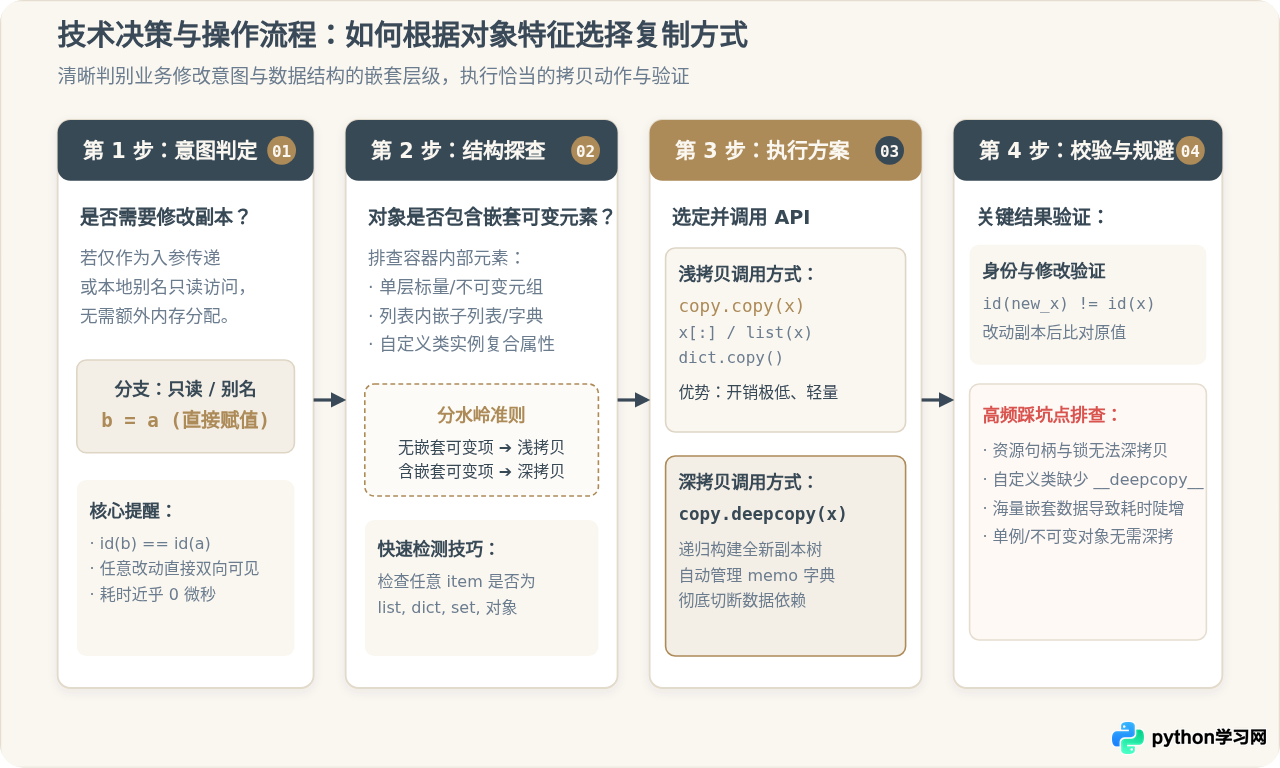
三、copy.deepcopy(深拷贝)的具体用法与底层机制
为了彻底切断所有层级的关联,Python 提供了 copy.deepcopy()。深拷贝通过递归遍历输入对象,将其本身及所有子对象、孙对象一律克隆一份新的堆内存实体,从而使新旧两个对象达到完全解耦的状态。
1. 嵌套对象的深拷贝实践
调用方式非常简单,只需引入 copy 模块并调用 copy.deepcopy() 即可:
import copy

source = ["北京", ["海淀", "朝阳"]]
deep = copy.deepcopy(source)

# 对深拷贝对象的内层与外层进行全面修改
deep[0] = "广州"
deep[1].append("天河")

print(f"原数据 source: {source}")
print(f"副本 deep:    {deep}")
print(f"内层列表是否为同一对象: {source[1] is deep[1]}")2. 深拷贝如何防止自引用与循环引用死循环(memo 备忘录)
在复杂数据结构(例如双向链表、图结构、相互引用的字典树)中,经常存在对象指向自身或形成环路的情况。如果是简单的递归复制,遇到环形引用会无限递归直至栈溢出(RecursionError: maximum recursion depth exceeded)。
Python 官方标准库 copy.py 通过内部维护的 memo 字典巧妙化解了这一难题:
- 在执行
deepcopy(x, memo)时,函数首先检查id(x)是否已经登记在memo映射表中; - 如果已存在,说明该对象在之前的递归中已经被克隆过,直接返回
memo[id(x)],立刻阻断重复遍历; - 如果未存在,则创建目标空对象,并在递归克隆子元素之前就将该映射存入
memo[id(x)] = y。这样当子元素反向引用父节点时,就能安全地在memo中取到对应的父节点副本。
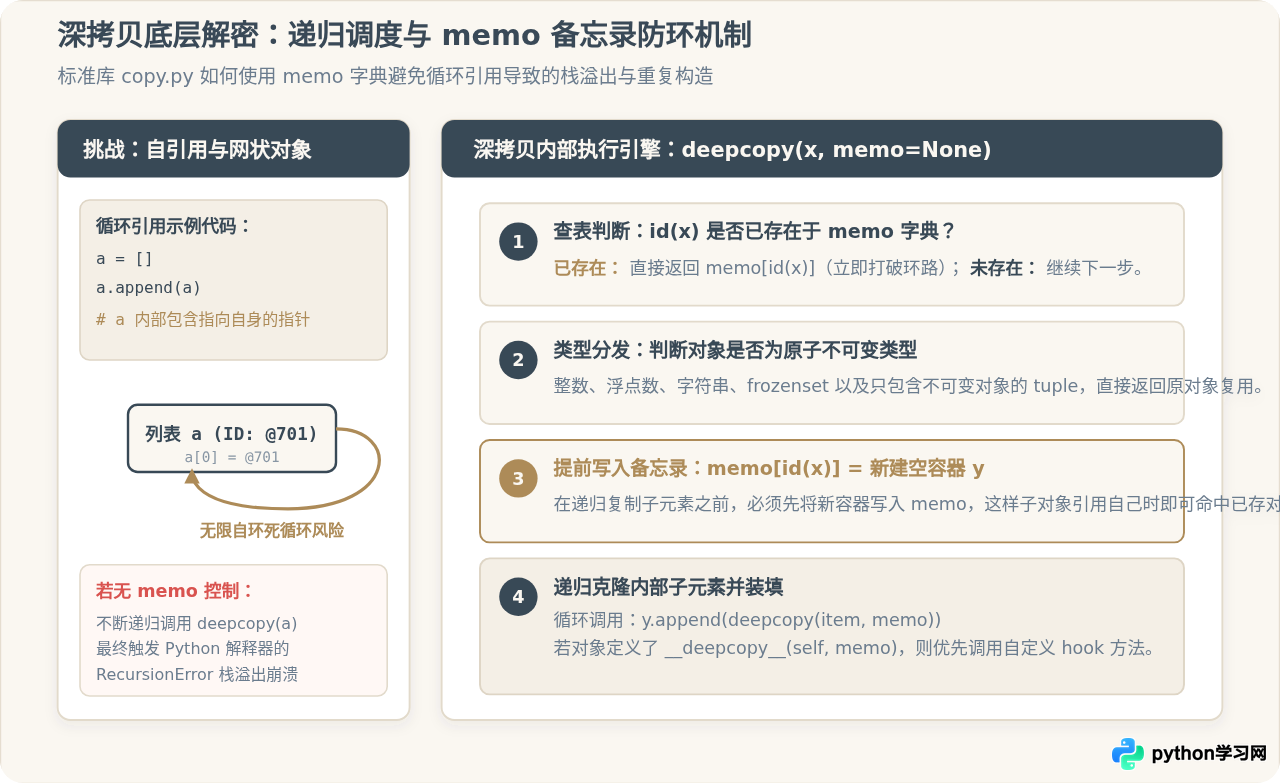
验证循环引用下深拷贝的代码如下:
import copy

# 构建一个自引用的列表结构
loop_list = [1, 2]
loop_list.append(loop_list)  # 列表第三个元素指向自身

# 执行深拷贝
cloned = copy.deepcopy(loop_list)

print(f"原列表 loop_list 长度: {len(loop_list)}")
print(f"克隆后 cloned 长度:   {len(cloned)}")
print(f"克隆列表的自引用是否指向新列表本身: {cloned[2] is cloned}")
print(f"克隆列表的自引用是否脱离了原列表: {cloned[2] is not loop_list}")3. 自定义类中的拷贝 Hook:__copy__ 与 __deepcopy__
Python 允许在自定义类中通过定义特殊方法接管拷贝逻辑。当调用 copy.copy() 或 copy.deepcopy() 时,解释器会优先检测并调用类中的以下魔术方法:
import copy

class TaskSession:
    def __init__(self, name, tasks, shared_channel=None):
        self.name = name
        self.tasks = tasks  # 可变任务列表
        self.shared_channel = shared_channel  # 系统通信信道(不应深拷贝)

    def __copy__(self):
        # 自定义浅拷贝:直接传入属性原引用构造新实例
        return TaskSession(self.name, self.tasks, self.shared_channel)

    def __deepcopy__(self, memo):
        # 必须接收 memo 字典并在调用子属性 deepcopy 时显式透传
        cls = self.__class__
        new_instance = cls.__new__(cls)
        # 提前登记 memo,防止复合属性内部产生相互引用导致环路
        memo[id(self)] = new_instance

        # 逐属性定制深拷贝规则
        for k, v in self.__dict__.items():
            if k == "shared_channel":
                # 保持通信信道单例共享
                setattr(new_instance, k, self.shared_channel)
            else:
                setattr(new_instance, k, copy.deepcopy(v, memo))

        return new_instance

session = TaskSession("Worker-1", ["task_a", "task_b"], shared_channel="SOCKET_001")
cloned_session = copy.deepcopy(session)
cloned_session.tasks.append("task_c")

print(f"原 session 任务列表: {session.tasks}")
print(f"副本 session 任务列表: {cloned_session.tasks}")
print(f"通信信道是否共享: {session.shared_channel is cloned_session.shared_channel}")四、性能开销、资源边界与生产避坑指南
深拷贝虽然提供了极致的隔离性,但在生产环境中滥用 deepcopy 会引发显著的性能损耗甚至运行时异常。理解其边界有助于在工程中做出最佳权衡。
1. 性能开销测试对比
由于 deepcopy 涉及类型反射分发、递归树遍历、哈希字典写入(memo)等一系列系统调用,其开销远高于 copy.copy。以下是对 100,000 个元素的单层列表进行复制的时间耗时对比示例:
import copy
import time

data = list(range(100000))

t0 = time.perf_counter()
shallow_copy = copy.copy(data)
t1 = time.perf_counter()
deep_copy = copy.deepcopy(data)
t2 = time.perf_counter()

print(f"copy.copy 耗时:     {(t1 - t0) * 1000:.3f} ms")
print(f"copy.deepcopy 耗时: {(t2 - t1) * 1000:.3f} ms")
print(f"深拷贝相对浅拷贝倍率: {((t2 - t1) / (t1 - t0)):.1f} 倍")
在上述十万规模的数据下,深拷贝耗时通常是浅拷贝的数十倍。如果在网络 API 请求处理或高频循环中无节制使用 copy.deepcopy,极易成为系统的计算瓶颈。
2. 哪些对象不应或不能进行深拷贝
并非所有 Python 对象都能被安全克隆。以下几类包含底层操作系统句柄或运行时状态的对象,在深拷贝时会抛出异常或产生逻辑错误:
- 文件句柄与网络连接:如
open("data.txt")打开的_io.TextIOWrapper、套接字连接socket。对其执行 deepcopy 会抛出TypeError: cannot pickle或类似异常; - 并发同步原语:如
threading.Lock、threading.Event,其底层绑定操作系统互斥量,复制新的互斥量会导致锁失效; - 生成器与迭代器:如
generator对象,其内部包含当前的栈帧指针与执行状态,无法轻易重制一份全新的独立运行副本。
五、选型准则与实践总结
在实际工程开发中,遵循以下三条准则可以帮助我们精准选择最适合的数据复制策略:
- 仅传递数据或局部只读访问:优先使用直接赋值
b = a,无任何额外时间与内存开销; - 单层扁平数据结构(如一维列表、无嵌套配置项字典):优先使用浅拷贝
copy.copy(x)或切片语法x[:],兼具数据隔离性与轻量性能; - 多层嵌套复合数据、递归树或需要生成隔离状态快照时:必须使用
copy.deepcopy(x),若包含系统资源句柄或特殊缓存,应在类中通过实现__deepcopy__(self, memo)明确定义忽略或共享字段。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









