

Python中修改列表变量为何会影响其他引用

在Python中,当你把一个已存在的列表变量赋值给新变量(例如 b = a),随后对 b 进行添加或修改元素操作时,会发现 a 的内容也同步发生了改变。造成这种现象的核心原因在于:Python中的变量并非存放具体数值的物理容器,而是指向堆内存中对象的引用标签;赋值操作仅仅是传递了对象的内存地址,并没有复制底层数据。当多个变量绑定到同一个可变对象(Mutable Object)时,任何通过其中一个变量发起的地内修改,都会直接反映在该对象本身上。
一、变量机制:是“标签”而非“盒子”
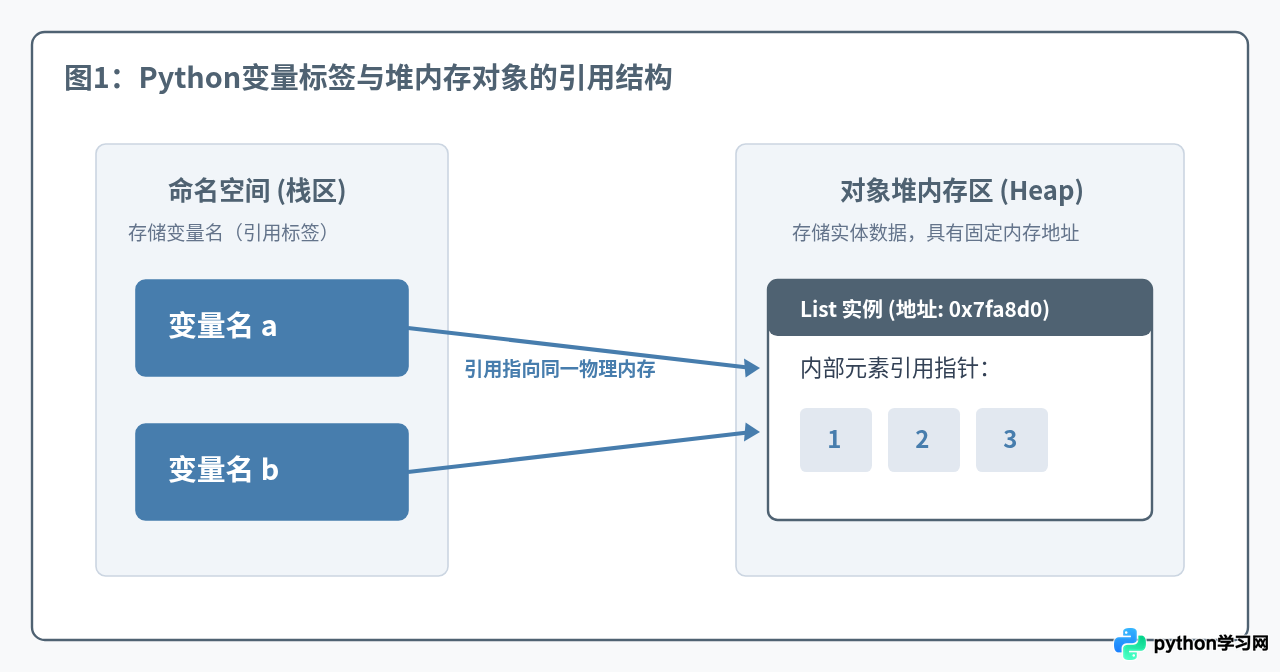
许多初学者习惯将变量想象成一个写有变量名的“盒子”,认为把 a 赋给 b 就是把盒子里面的数据复印一份装入新的盒子中。但在Python的对象模型中,所有数据(无论是整数、字符串还是列表)都以对象形式存在于内存堆区,变量仅仅是贴在对象上的“名字标签”。
执行 a = [1, 2, 3] 时,Python首先在内存中开辟空间创建列表对象 [1, 2, 3],然后将标签 a 贴到该对象上。执行 b = a 时,Python并没有开辟新空间复制列表,而是直接把标签 b 也贴到了同一个列表对象上。此时 a 与 b 拥有完全相同的内存地址。
a = [1, 2, 3]
b = a

print(f"a 的内存地址: {id(a)}")
print(f"b 的内存地址: {id(b)}")
print(f"a 与 b 是否指向同一对象: {a is b}")a 的内存地址: 140428519632448
b 的内存地址: 140428519632448
a 与 b 是否指向同一对象: True
通过内置函数 id() 和身份比较运算符 is 可以清晰地验证这一点:两个变量标识符完全指向同一个内存实体。
二、原地修改与重新赋值的执行差异
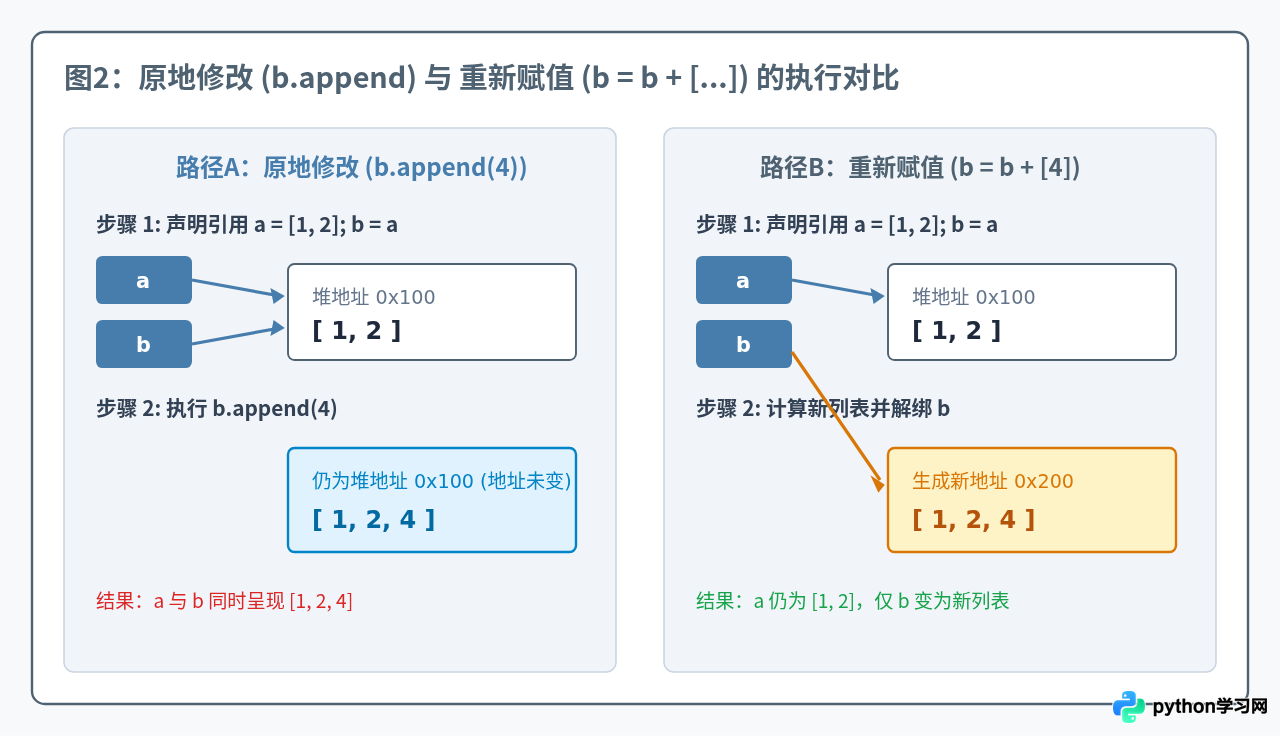
理解该现象的第二关键是区分“原地修改(In-Place Mutation)”与“重新赋值(Reassignment)”。列表作为Python中的可变类型(Mutable Type),其内部内容可以在不改变自身内存地址的前提下直接扩充或变更。
1. 原地修改:对象内部发生改变
当调用 b.append(4)、b.extend([4, 5])、b.pop() 或者通过索引 b[0] = 99 赋值时,是在已有列表对象占据的连续内存空间中直接操作。因为没有创建新对象,对象的 id 保持不变。此时持有相同引用的 a 访问该对象时,读取到的自然是已经修改后的数据。
a = [1, 2, 3]
b = a
b.append(4)

print("a 的内容:", a)
print("b 的内容:", b)
print("原地修改后地址是否改变:", id(a) == id(b))a 的内容: [1, 2, 3, 4]
b 的内容: [1, 2, 3, 4]
原地修改后地址是否改变: True
2. 重新赋值:解绑旧对象并绑定新对象
与之相对,如果编写的是 b = b + [4],情况则完全不同。加号运算符连接两个列表会生成一个全新的列表对象,随后等号赋值将变量标签 b 从原本的对象上撕下,重新贴到新生成的列表对象上。此时 a 仍然指向原有的 [1, 2, 3],二者的引用关系在赋值瞬间被切断。
a = [1, 2, 3]
b = a
b = b + [4]  # 创建新对象并重新赋值

print("a 的内容:", a)
print("b 的内容:", b)
print("重新赋值后是否仍指向同一对象:", a is b)a 的内容: [1, 2, 3]
b 的内容: [1, 2, 3, 4]
重新赋值后是否仍指向同一对象: False
+= 的特殊行为:在处理列表时,b += [4] 调用的是列表底层的 __iadd__ 方法,属于原地修改(相当于 b.extend([4])),依然会影响 a;而 b = b + [4] 则是显式创建新对象。这是Python初学者极易混淆的细节。
三、嵌套结构下的深浅拷贝陷阱
如果业务中确实需要将列表复制给另一个变量独立操作,常见做法是使用浅拷贝(Shallow Copy)。但在存在嵌套可变对象(如列表中包含子列表)的场景下,浅拷贝依然会带来隐蔽的“联动修改”Bug。
1. 浅拷贝的边界
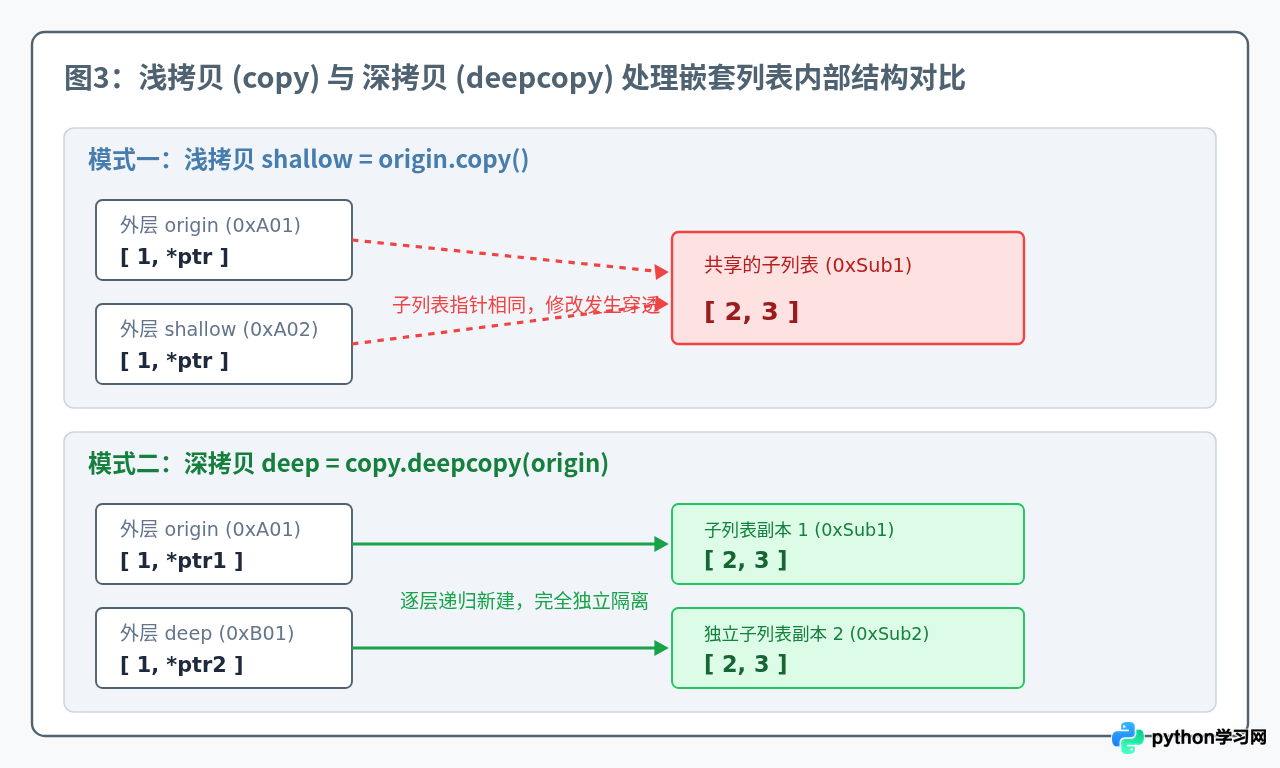
浅拷贝可以通过切片语法 b = a[:]、内置方法 b = a.copy() 或类型构造器 b = list(a) 实现。浅拷贝会创建一个新的最外层列表容器(外层 id 不同)。但对于列表中包含的子列表或字典等可变元素,浅拷贝仅复制了子元素的引用指针,并没有递归复制子对象。
import copy

origin = [1, [2, 3]]
shallow = origin.copy()

# 修改外层元素:互不影响
shallow[0] = 99
print("修改外层后 origin:", origin)  # [1, [2, 3]]
print("修改外层后 shallow:", shallow) # [99, [2, 3]]

# 修改内层子列表:再次发生联动影响
shallow[1].append(4)
print("修改内层后 origin:", origin)  # [1, [2, 3, 4]]
print("修改内层后 shallow:", shallow) # [99, [2, 3, 4]]
2. 深拷贝实现彻底隔离
当需要多层复杂嵌套数据完全独立时,必须借助标准库中的 copy.deepcopy()。深拷贝会递归遍历所有层级,遇到可变对象时全部新建副本,实现内存物理层面的完全隔离。
四、工程实战中的高频衍生场景
引用共享不仅发生在直接的变量赋值语句中,在日常函数定义和类属性设计中更为普遍,尤其体现在以下两个常见问题中:
1. 函数默认参数为可变列表
在Python中,函数定义语句 def 在模块加载时仅执行一次,默认参数的默认对象也是在定义阶段创建且唯一存在的。如果将默认参数指定为列表 def append_item(val, item_list=[]),后续每次不传参数调用该函数时,使用的都是同一个列表对象。
def append_item(val, item_list=[]):
    item_list.append(val)
    return item_list

print(append_item("A"))  # 输出 ['A']
print(append_item("B")) # 意外输出 ['A', 'B'],而非预期 ['B']推荐修复方式:将默认参数设置为不可变单例 None,在函数体内部动态判定并初始化新列表:
def append_item(val, item_list=None):
    if item_list is None:
        item_list = []
    item_list.append(val)
    return item_list
2. 函数传参时的引用副作用
Python的传参机制是“按对象引用传递(Pass by Object Reference)”。将外部列表作为参数传入函数后,函数内部形参和外部实参本质上指向同一个列表对象。如果在函数内进行了原地修改,调用方外部的作用域变量也会被直接修改。
def process_data(data):
    data.pop()  # 原地修改传入的实参列表

my_list = [10, 20, 30]
process_data(my_list)
print("外部列表已被函数内部修改:", my_list)  # [10, 20]
五、如何根据需求选择合适的操作手段
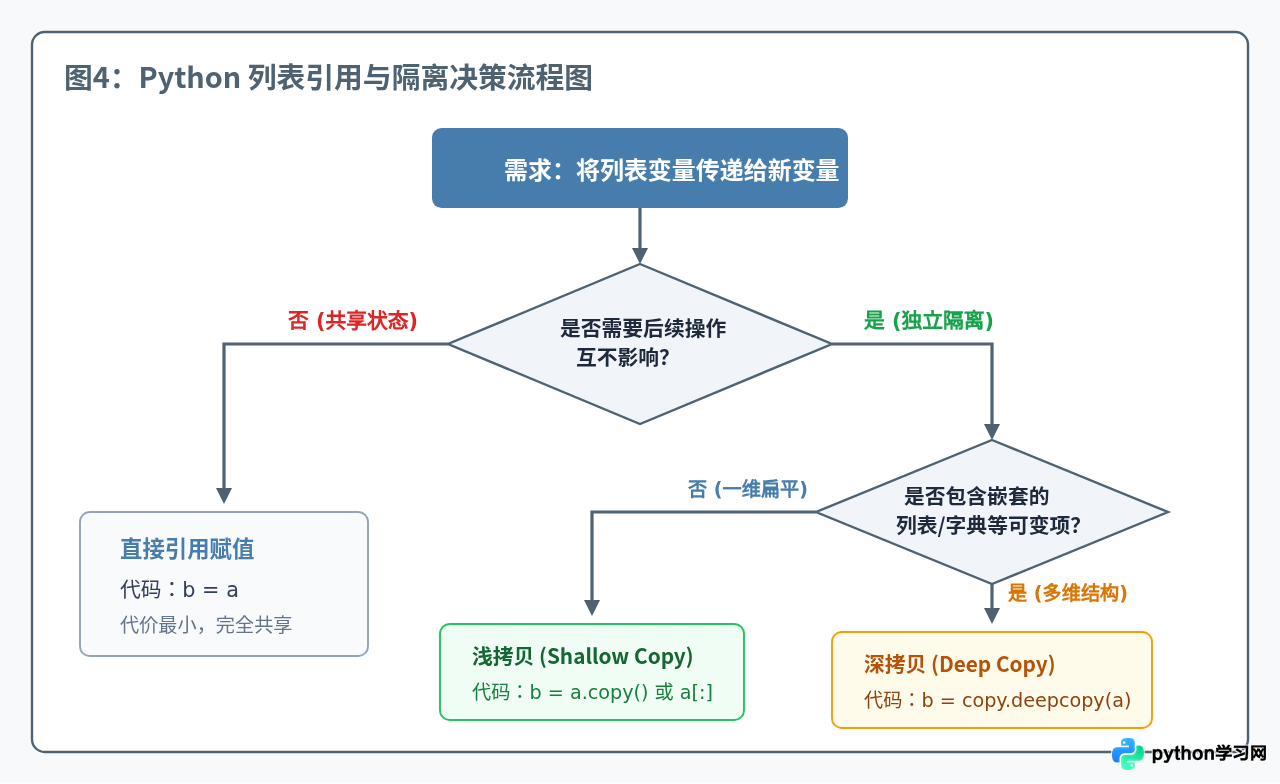
在面对列表处理时,应根据业务是否需要共享数据、是否包含多层嵌套以及对性能的要求,选择对应的操作范式:
| 操作方式 | 语法示例 | 内存行为 | 适用场景 |
|---|---|---|---|
| 直接别名引用 | b = a |
不创建新对象,仅增加一个引用标签 | 明确需要共享状态、作为别名使用 |
| 单层浅拷贝 | b = a.copy() 或 b = a[:] |
创建新的外层列表,子元素仍保持引用 | 一维扁平列表的数据隔离(最高效) |
| 递归深拷贝 | b = copy.deepcopy(a) |
递归复制所有层级对象,完全物理隔离 | 多维矩阵、嵌套JSON字典树等复合结构 |
| 不可变转换 | b = tuple(a) |
将列表转换为元组,阻止任何原地写入 | 配置项传递、字典键值或防篡改场景 |
总结
Python中“修改一个列表变量会连带影响其他变量”的本质,是引用传递与可变对象的物理机制共同作用的结果。记住以下三条核心准则即可彻底规避此类Bug:
- 变量即指针:
b = a只是增加了别名标签,从未克隆数据。 - 修改分路径:
b.append()、b[0] = x以及+=属于原地变更,地址不变;而b = b + [x]会产生新对象并解除绑定。 - 拷贝看层级:一维数据使用
a.copy()或a[:],嵌套复合数据必须使用copy.deepcopy(a)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









